
Kursus
Aljabar Linear untuk Data Science di R
4 jam
21.8K
Dekomposisi QR adalah teknik faktorisasi matriks yang mendasar dan banyak digunakan di berbagai bidang data science dan machine learning. Kemampuannya untuk memecah matriks kompleks menjadi bagian-bagian yang lebih sederhana menjadikannya metode penting untuk menyelesaikan persoalan aljabar linear dan meningkatkan stabilitas algoritma.
Baik Anda melakukan regresi linear ordinary least squares atau membangun mesin rekomendasi di Python atau PySpark, memahami dekomposisi QR dapat secara signifikan meningkatkan kemampuan Anda bekerja dengan dataset besar dan model matematis yang kompleks.
Saat Anda memfaktorkan, atau mendekomposisi, sebuah matriks, Anda mengekspresikan matriks tersebut sebagai hasil kali dari dua matriks atau lebih. Dengan kata lain, faktorisasi matriks memungkinkan Anda memecah sebuah matriks menjadi komponen yang lebih sederhana yang, ketika dikalikan kembali menggunakan perkalian matriks, akan merekonstruksi matriks asal. Kita peduli terhadap faktorisasi matriks karena hal ini menyederhanakan banyak persoalan aljabar linear, sehingga lebih mudah diselesaikan.
Dekomposisi QR adalah jenis teknik faktorisasi matriks tertentu yang digunakan untuk memfaktorkan sebuah matriks menjadi hasil kali dari matriks ortogonal Q dan matriks segitiga atas R. Persamaan yang umum kita lihat adalah A = QR.
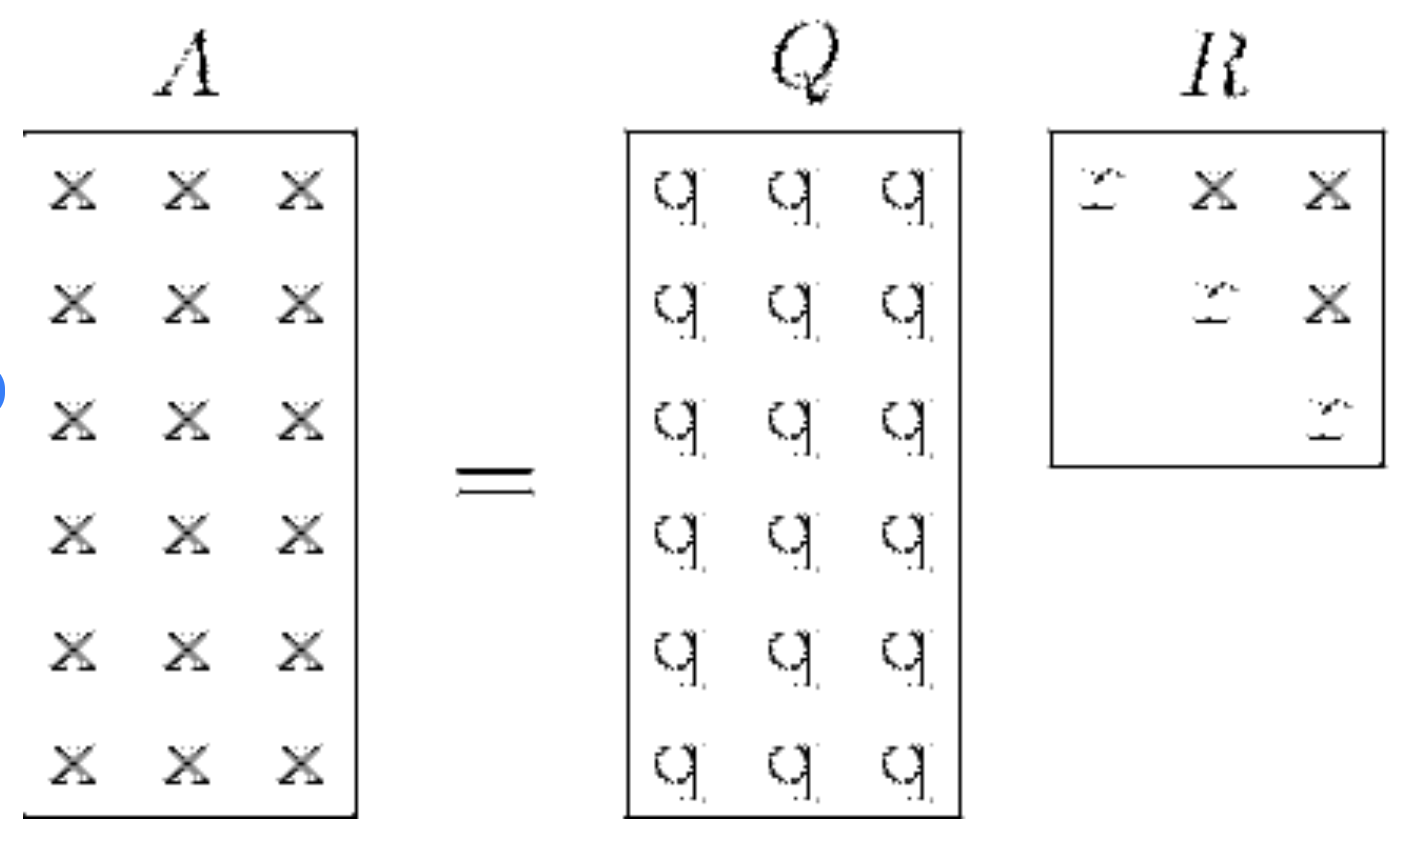
Visualisasi dekomposisi QR. Sumber: ResearchGate
Untuk memahami dekomposisi QR, Anda perlu menyadari bahwa dalam aljabar linear, perkalian matriks tidak mengikuti kaidah intuitif seperti perkalian skalar. Secara spesifik, perkalian matriks tidak komutatif, artinya secara umum AB ≠ BA, sehingga gagasan tentang "kebalikan" menjadi lebih kompleks.
Mari kita lihat dua matriks penting, yaitu Q dan R.
Matriks ortogonal Q dicirikan oleh sifat bahwa transposenya juga merupakan inversenya, yang direpresentasikan secara matematis sebagai QTQ = QQT = I, dengan I adalah matriks identitas. Transpos, sebagai konteks, berarti membalik matriks terhadap diagonalnya.
Matriks ortogonal juga dicirikan oleh kolom-kolomnya yang membentuk basis ortonormal. Ini berarti dua hal: Pertama, kolom-kolomnya saling ortogonal, yaitu hasil kali dot dari sepasang kolom berbeda pada matriks bernilai nol. Kedua, setiap kolom memiliki magnitudo, atau panjang satuan, sama dengan satu.
Matriks ortogonal nyaman digunakan karena mempertahankan panjang vektor dan hasil kali dot-nya. Jadi, jika Anda memiliki sebuah vektor dan mengalikannya dengan matriks ortogonal, panjang vektor tersebut tetap sama. Juga, jika Anda memiliki dua vektor dan mengalikan keduanya dengan matriks ortogonal yang sama, hasil kali dot di antara keduanya juga tetap sama. Terakhir, karena matriks ortogonal mempertahankan panjang dan hasil kali dot, ia tidak mendistorsi sifat geometris vektor-vektor setelah transformasi. Artinya, jika dua vektor saling tegak lurus sebelum transformasi, keduanya akan tetap tegak lurus setelah menerapkan matriks ortogonal.
Matriks segitiga atas R adalah jenis matriks di mana semua elemen di bawah diagonal utama bernilai nol. Bentuk ini menyederhanakan persamaan matriks dan sangat berguna untuk menyelesaikan sistem persamaan linear melalui substitusi mundur atau metode lainnya. Kita juga dapat mengatakan bahwa, dalam dekomposisi QR, R merepresentasikan komponen yang menangkap magnitudo dan orientasi matriks asal.
Mari kita lihat secara singkat beberapa cara berbeda untuk melakukan dekomposisi QR.
Proses Gram-Schmidt adalah algoritme yang digunakan untuk secara sistematis mengonversi sekumpulan vektor saling bebas linear menjadi himpunan ortonormal. Proses ini secara khusus digunakan untuk membangun matriks Q dalam dekomposisi QR kita, dan setelah kita memiliki Q, kita dapat menurunkan R.
Rotasi Givens adalah metode lain yang membantu dekomposisi QR. Dengan rotasi Givens, serangkaian rotasi bidang diterapkan untuk memasukkan nol di bawah diagonal matriks A. Setiap rotasi bekerja pada sepasang koordinat, mempertahankan panjang vektor sambil mentransformasikan matriks ke bentuk segitiga atas. Metode ini efisien untuk matriks jarang (sparse), karena hanya memodifikasi sebagian kecil matriks pada setiap langkah.
Refleksi Householder adalah teknik yang lebih umum yang menggunakan matriks refleksi, dikenal sebagai matriks Householder, untuk secara sistematis menghilangkan elemen-elemen sub-diagonal dari matriks A. Setiap matriks Householder merefleksikan sebuah vektor terhadap bidang yang ortogonal terhadap vektor yang dipilih untuk men-nol-kan sebuah kolom di bawah diagonal. Hasilnya adalah matriks ortogonal Q dan matriks segitiga atas R. Refleksi Householder sangat baik untuk matriks rapat (dense) karena stabilitas numeriknya.
Pada bagian ini, kita akan mempraktikkan dekomposisi QR di R dengan memanfaatkan fungsi bawaan qr() untuk implementasi cepat dan kemudian menelusuri proses dari awal menggunakan proses Gram-Schmidt untuk membangun intuisi. Mari mulai dengan membuat matrix_A, yang akan kita gunakan di kedua bagian.
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")Kita dapat melakukan faktorisasi ini dalam satu langkah dengan fungsi qr(). Kita menugaskan hasilnya ke objek qr_decomp, yang merupakan list yang memuat dekomposisi QR.
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
Saat kita mengakses komponen rank dari objek dekomposisi QR, kita dapat melihat jumlah kolom yang saling bebas linear dalam matriks terdekomposisi. Output menunjukkan bahwa matriks memiliki rank tiga, yang berarti ada tiga kolom saling bebas linear, sesuai perkiraan kita. Saat kita mengakses komponen pivot, kita melihat informasi tentang permutasi kolom yang digunakan selama proses dekomposisi. Output menunjukkan bahwa kolom-kolom matriks tidak dipermutasi selama dekomposisi, karena indeks pivot sama dengan urutan kolom asal.
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3Langkah berikutnya, kita dapat mengakses matriks Q dan matriks R masing-masing menggunakan fungsi qr.Q() dan qr.R(). Kita dapat melihat pada output bahwa matriks Q berbentuk persegi panjang dan matriks R berbentuk bujur sangkar dengan nol di bawah diagonalnya.
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369Sebagai langkah terakhir, karena kita penasaran, kita dapat mengecek metode apa yang digunakan fungsi qr() untuk dekomposisi.
?qrKita dapat melihat hal berikut sebagai bagian dari output:
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.Jika kita mengecek dokumentasi FORTRAN, kita akan melihat bahwa dgeqrf adalah rutin LAPACK yang menggunakan transformasi Householder.
Mari mencoba memahami apa yang terjadi dengan fungsi qr() dengan merekonstruksi bukan implementasi yang sama, tetapi gagasan serupa oleh kita sendiri dengan mengikuti proses Gram-Schmidt dan penalaran. Tujuan latihan ini bukan untuk menduplikasi metode secara persis, melainkan untuk membangun pemahaman kita.
Untuk mulai membuat matriks Q kita menggunakan proses Gram-Schmidt, kita perlu menormalisasi kolom pertama dari data subset untuk memperoleh kolom pertama Q. Tujuannya di sini adalah mentransformasikan himpunan vektor pada matriks A menjadi himpunan vektor baru dengan panjang satuan, dan memastikan vektor-vektor tersebut saling ortogonal.
Untuk menemukan kolom pertama Q, kita mengekstrak kolom pertama A, menghitung norma Euclidean, lalu melakukan normalisasi.
Sebagai ulasan, norma Euclidean adalah ukuran panjang atau magnitudo vektor dalam ruang Euclidean. Kita mempertimbangkan jarak dari titik asal ke ujung vektor ketika tiap elemen vektor dipandang sebagai koordinat dalam ruang multi-dimensi. Untuk vektor v = [v1,v2,…,vn], norma Euclidean dihitung dengan cara berikut:
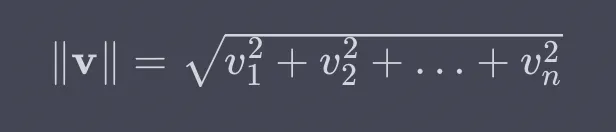
Jadi, untuk mengimplementasikannya di R, kita menguadratkan tiap kolom, mengambil jumlahnya, lalu akar kuadrat, dan akhirnya melakukan normalisasi.
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
Hal kedua yang perlu kita ulas dari aljabar linear adalah konsep proyeksi. Proyeksi mengacu pada operasi matematis yang memproyeksikan sebuah vektor ke sebuah subruang. Subruang dapat dipandang sebagai ruang berdimensi lebih rendah di dalam ruang vektor yang lebih besar. Hasil proyeksi adalah vektor yang terletak dalam subruang dan paling dekat dengan vektor asal yang diproyeksikan, yang juga ortogonal terhadap subruang tersebut.
Mari mencoba memvisualisasikan dengan grafik berikut, di mana proyeksi p adalah titik terdekat ke a dari b, yang harus tegak lurus terhadap b.
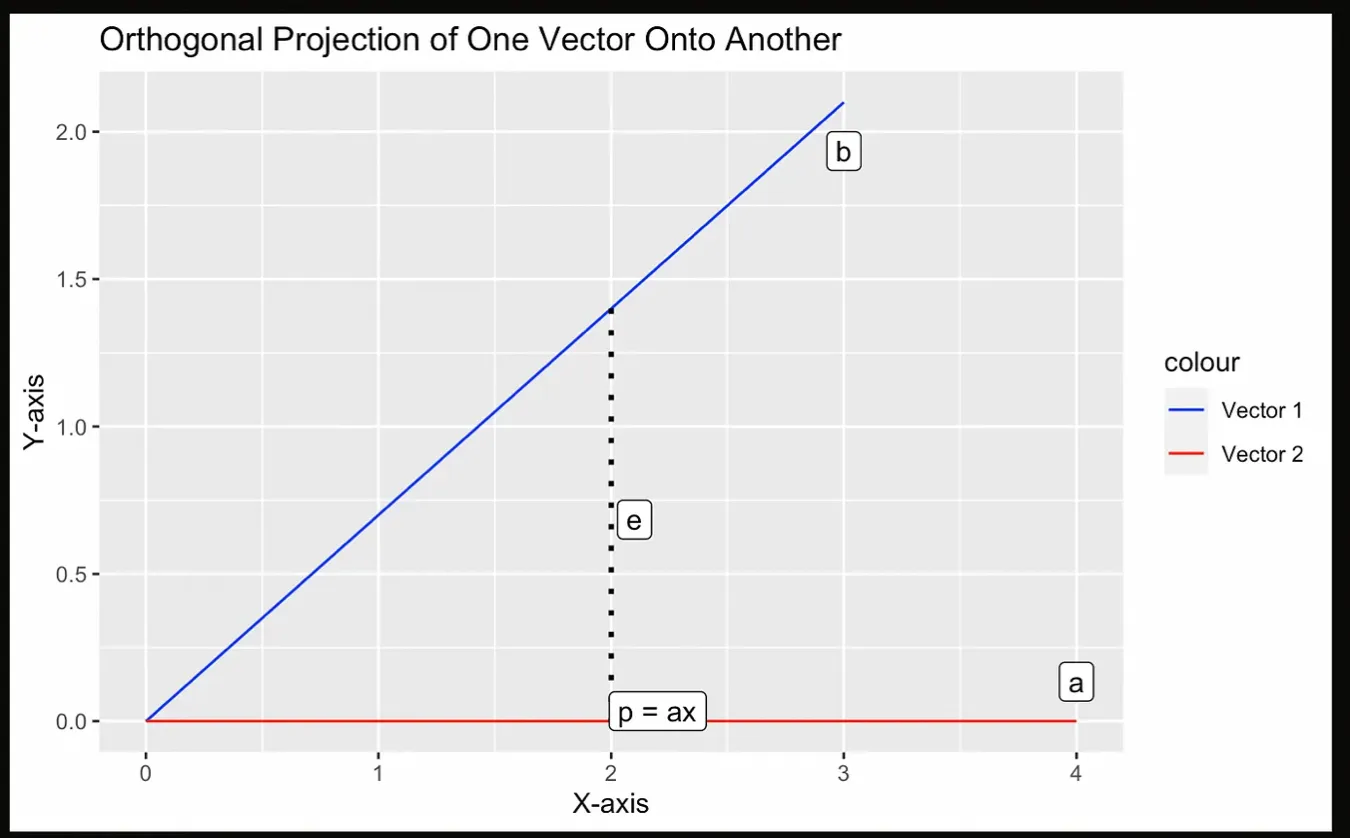
Ilustrasi proyeksi. Gambar oleh Penulis.
Pada langkah berikut dekomposisi QR, kita menghitung vektor ortogonal kedua dengan terlebih dulu menghitung proyeksi kolom kedua A ke kolom pertama Q, lalu mengurangkan hasil tersebut dari kolom kedua A. Vektor yang dihasilkan akan ortogonal terhadap vektor pertama. Sebagai langkah akhir, kita menormalkan vektor ini untuk memperoleh kolom kedua Q.
Mari meninjau kembali persamaan untuk sebuah proyeksi. Proyeksi adalah matriks yang merupakan a kali a-transpose dibagi skalar a-transpose kali a, dikalikan dengan b.
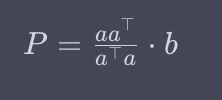
Atau, alternatifnya:
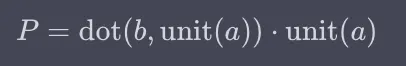
Kita mungkin bertanya-tanya: Bagaimana kedua metode ini sama? Ketika kita melihat persamaan pertama di atas, bagian di kiri b menghitung sebuah matriks yang pada dasarnya menangkap arah yang didefinisikan oleh vektor a dan faktor penskalaan untuk arah tersebut. Ini serupa dengan menghitung vektor satuan dari a pada metode hasil kali dot.
Kode R berikut menghitung proyeksi vektor col_2 ke vektor q1 menggunakan metode hasil kali dot.
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
Seperti terlihat pada kode di atas, menyusun vektor ortogonal kedua dan kolom yang bersesuaian pada matriks Q melibatkan proses proyeksi, pengurangan, dan normalisasi. Langkah-langkah dasarnya mirip dengan pembuatan kolom pertama Q, tetapi sedikit berbeda dan lebih panjang: Kita terlebih dulu mengekstrak kolom kedua A; kemudian membuat proyeksi ke vektor pertama Q; lalu mengurangkan proyeksi dari kolom kedua A; selanjutnya melakukan normalisasi; dan akhirnya membentuk kolom kedua Q.
Kita dapat mengulangi langkah kedua ini untuk q3 hingga kolom terakhir. Dalam kasus kita, vektor-vektor ortogonal q1, q2, dan q3 membentuk basis dari matriks ortogonal Q. Vektor-vektor ini penting karena menjadi fondasi untuk mengekspresikan data asal dalam sistem koordinat baru.
Di sini, kita melihat bahwa proses Gram-Schmidt adalah proses iteratif yang memastikan setiap vektor berikutnya ortogonal terhadap vektor sebelumnya. Kita juga ingat bahwa ortogonalitas berarti hasil kali dot dari dua vektor bernilai nol, yang menunjukkan bahwa keduanya saling tegak lurus dalam ruang vektor. Mari konfirmasi ortogonalitas q1 dan q2 menggunakan hasil kali dot keduanya:
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16Sekarang setelah kita memiliki matriks Q, kita perlu menyusun matriks R. Matriks R dalam dekomposisi QR memuat informasi tentang hubungan antara kolom-kolom matriks ortogonal Q dan dataset asal. Ini adalah matriks segitiga atas, dan setiap elemen pada bagian segitiga atas R diperoleh dengan menghitung hasil kali dot dari kolom-kolom bersesuaian pada Q dan data asal.
Untuk menyusun matriks segitiga atas R, kita perlu menghitung hasil kali dot setiap kolom Q dengan setiap kolom dari dataset asal. Ini akan menghasilkan sebuah matriks yang memiliki jumlah baris sama dengan jumlah kolom pada Q, dan akan berbentuk segitiga atas karena proses sebelumnya.
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
Kita melihat bahwa output matriks R kita kali ini terlihat sedikit berbeda. Alasannya adalah karena fungsi qr() menggunakan refleksi Householder dengan stabilitas numerik yang lebih baik daripada proses ala Gram-Schmidt yang kita buat sendiri.
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
Kita dapat memverifikasi rekonstruksi dengan mengalikan Q dan R dan melihat bahwa kita memperoleh kembali matrix_A. Di sini, %*% adalah untuk perkalian matriks di R.
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109Belajar bersama DataCamp
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



