
Last chance! 50% off DataCamp Premium
Sale ends in
QR डीकंपोज़ीशन डेटा साइंस और मशीन लर्निंग के विभिन्न क्षेत्रों में व्यापक रूप से प्रयुक्त एक बुनियादी मैट्रिक्स फैक्टराइज़ेशन तकनीक है। जटिल मैट्रिसों को सरल हिस्सों में तोड़ने की इसकी क्षमता रैखिक बीजगणित की समस्याओं को हल करने और एल्गोरिदम की स्थिरता में सुधार करने के लिए इसे अत्यंत उपयोगी बनाती है।
चाहे आप ऑर्डिनरी लीस्ट स्क्वेयर्स लीनियर रिग्रेशन कर रहे हों या Python में रिकमेंडेशन इंजन बना रहे हों या PySpark में, QR डीकंपोज़ीशन को समझना बड़े डेटासेट और जटिल गणितीय मॉडलों के साथ काम करने की आपकी क्षमता को काफी बढ़ा सकता है।
जब आप किसी मैट्रिक्स का फैक्टराइज़ेशन या डीकंपोज़ीशन करते हैं, तो आप उस मैट्रिक्स को दो या अधिक मैट्रिसों के गुणनफल के रूप में व्यक्त करते हैं। दूसरे शब्दों में, मैट्रिक्स फैक्टराइज़ेशन से आप किसी मैट्रिक्स को सरल अवयवों में तोड़ सकते हैं, जो मैट्रिक्स गुणा के माध्यम से एक साथ गुणा होने पर मूल मैट्रिक्स का पुनर्निर्माण करते हैं। हम मैट्रिक्स फैक्टराइज़ेशन की परवाह इसलिए करते हैं क्योंकि यह कई रैखिक बीजगणित समस्याओं को सरल बना देता है, जिससे उन्हें हल करना आसान हो जाता है।
QR डीकंपोज़ीशन एक विशेष प्रकार की मैट्रिक्स फैक्टराइज़ेशन तकनीक है, जिसका उपयोग किसी मैट्रिक्स को एक ऑर्थोगोनल मैट्रिक्स Q और एक अपर ट्रायएंगुलर मैट्रिक्स R के गुणनफल में विघटित करने के लिए किया जाता है। आमतौर पर हम जो समीकरण देखते हैं वह है A = QR.
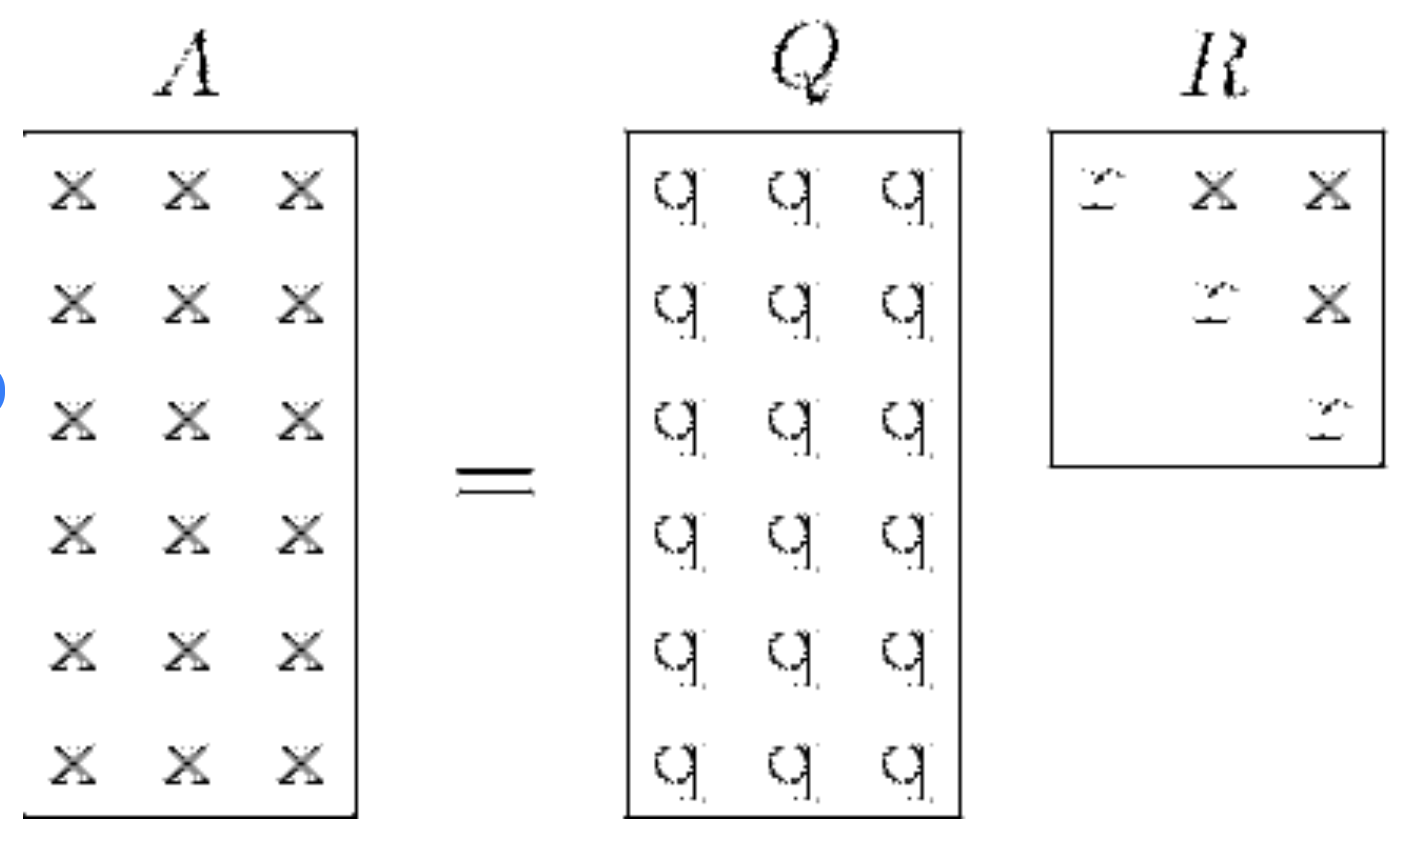
QR डीकंपोज़ीशन का दृश्य। स्रोत: ResearchGate
QR डीकंपोज़ीशन को समझने के लिए यह सराहना करना जरूरी है कि रैखिक बीजगणित में, मैट्रिसों का गुणन स्केलर गुणन जैसे सहज नियमों का पालन नहीं करता। विशेष रूप से, मैट्रिसों का गुणन कम्यूटेटिव नहीं होता, अर्थात सामान्यतः AB ≠ BA, और इसलिए, "रिवर्स" की धारणा अधिक जटिल हो जाती है।
आइए दो महत्वपूर्ण मैट्रिसों, Q और R, पर नज़र डालें।
एक ऑर्थोगोनल मैट्रिक्स Q की विशेषता यह है कि उसका ट्रांसपोज़ उसका इनवर्स भी होता है, जिसे गणितीय रूप से इस प्रकार दर्शाया जाता है: QTQ = QQT = I, जहाँ I पहचान मैट्रिक्स है। संदर्भ के लिए, ट्रांसपोज़ करने का अर्थ है मैट्रिक्स को उसकी विकर्ण रेखा के सापेक्ष पलटना।
एक ऑर्थोगोनल मैट्रिक्स की यह भी विशेषता है कि उसकी कॉलम एक ऑर्थोनॉर्मल बेसिस बनाते हैं। इसका मतलब दो बातें हैं: पहली, कॉलम आपस में ऑर्थोगोनल होते हैं, यानी मैट्रिक्स में किसी भी भिन्न कॉलम-युग्म का डॉट प्रोडक्ट शून्य होता है। और दूसरी, प्रत्येक कॉलम का परिमाण या यूनिट लंबाई एक होती है।
ऑर्थोगोनल मैट्रिसों के साथ काम करना अच्छा होता है क्योंकि वे वेक्टरों की लंबाइयों और उनके डॉट प्रोडक्ट को संरक्षित रखते हैं। तो, यदि आपके पास एक वेक्टर है और आप उसे किसी ऑर्थोगोनल मैट्रिक्स से गुणा करते हैं, तो उस वेक्टर की लंबाई वही रहती है। इसी तरह, यदि आपके पास दो वेक्टर हैं और आप दोनों को एक ही ऑर्थोगोनल मैट्रिक्स से गुणा करते हैं, तो उनके बीच का डॉट प्रोडक्ट भी वही रहता है। अंततः, क्योंकि ऑर्थोगोनल मैट्रिसें लंबाइयों और डॉट प्रोडक्ट को संरक्षित रखती हैं, वे ट्रांसफॉर्मेशन के बाद वेक्टरों के ज्यामितीय गुणों को विकृत नहीं करतीं। यानी, यदि ट्रांसफॉर्मेशन से पहले दो वेक्टर परस्पर लंब थे, तो ऑर्थोगोनल मैट्रिक्स लगाने के बाद भी वे लंब ही रहेंगे।
एक अपर ट्रायएंगुलर मैट्रिक्स R वह मैट्रिक्स है जिसमें मुख्य विकर्ण के नीचे के सभी अवयव शून्य होते हैं। यह रूप मैट्रिक्स समीकरणों को सरल बनाता है और विशेष रूप से बैक सब्सटीट्यूशन या किसी अन्य विधि से रैखिक समीकरणों के तंत्र को हल करने में उपयोगी है। हम यह भी कह सकते हैं कि QR डीकंपोज़ीशन में, R वह घटक है जो मूल मैट्रिक्स की परिमाण और अभिविन्यास को पकड़ता है।
चलिए QR डीकंपोज़ीशन करने के कुछ अलग-अलग तरीकों पर संक्षेप में नज़र डालते हैं।
ग्राम–श्मिट प्रक्रिया एक एल्गोरिदम है जिसका उपयोग रैखिक रूप से स्वतंत्र वेक्टरों के सेट को व्यवस्थित रूप से एक ऑर्थोनॉर्मल सेट में बदलने के लिए किया जाता है। इस प्रक्रिया का उपयोग विशेष रूप से हमारे QR डीकंपोज़ीशन में Q मैट्रिक्स के निर्माण के लिए किया जाता है, और Q प्राप्त होने के बाद हम R व्युत्पन्न कर सकते हैं।
गिवेन्स रोटेशन QR डीकंपोज़ीशन में मदद करने की एक और विधि है। गिवेन्स रोटेशन के साथ, विमान रोटेशनों की एक श्रृंखला लागू की जाती है ताकि मैट्रिक्स A की विकर्ण रेखा के नीचे शून्य प्रस्तुत किए जा सकें। प्रत्येक रोटेशन निर्देशांक की एक जोड़ी पर कार्य करता है, वेक्टर की लंबाई को संरक्षित रखते हुए मैट्रिक्स को अपर ट्रायएंगुलर रूप में बदलता है। यह विधि स्पार्स मैट्रिसों के लिए कुशल है, क्योंकि यह प्रत्येक चरण में मैट्रिक्स के केवल एक छोटे हिस्से को संशोधित करती है।
हाउसहोल्डर रिफ्लेक्शंस एक अधिक सामान्य तकनीक है जो रिफ्लेक्शन मैट्रिसों, जिन्हें हाउसहोल्डर मैट्रिस कहा जाता है, का उपयोग करके मैट्रिक्स A के सब-डायगोनल अवयवों को व्यवस्थित रूप से समाप्त करती है। प्रत्येक हाउसहोल्डर मैट्रिक्स किसी वेक्टर को उस समतल के सापेक्ष परावर्तित करता है जो उस वेक्टर के लम्बवत होता है जिसे विकर्ण के नीचे किसी कॉलम को शून्य करने के लिए चुना गया है। परिणामस्वरूप एक ऑर्थोगोनल मैट्रिक्स Q और एक अपर ट्रायएंगुलर मैट्रिक्स R प्राप्त होते हैं। हाउसहोल्डर रिफ्लेक्शंस विशेष रूप से डेंस मैट्रिसों के लिए अच्छी होती हैं क्योंकि उनकी संख्यात्मक स्थिरता अधिक होती है।
इस खंड में, हम R में QR डीकंपोज़ीशन का अभ्यास करेंगे—पहले त्वरित इम्प्लिमेंटेशन के लिए इनबिल्ट qr() फ़ंक्शन का उपयोग करके, और फिर ग्राम–श्मिट प्रक्रिया का सहारा लेकर शून्य से प्रक्रिया को समझते हुए अपनी सहज समझ विकसित करेंगे। चलिए matrix_A बनाकर शुरू करते हैं, जिसका उपयोग हम दोनों भागों में करेंगे।
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")हम इस फैक्टराइज़ेशन को एक ही चरण में qr() फ़ंक्शन से कर सकते हैं। हम परिणाम को qr_decomp ऑब्जेक्ट में असाइन करते हैं, जो QR डीकंपोज़ीशन वाली एक लिस्ट होती है।
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
जब हम QR डीकंपोज़ीशन ऑब्जेक्ट के रैंक घटक को एक्सेस करते हैं, तो हम अपनी विघटित मैट्रिक्स में रैखिक रूप से स्वतंत्र कॉलमों की संख्या देख सकते हैं। आउटपुट से पता चलता है कि मैट्रिक्स का रैंक तीन है, यानी तीन रैखिक रूप से स्वतंत्र कॉलम हैं, जो अपेक्षित है। जब हम पिवट घटक को एक्सेस करते हैं, तो हम डीकंपोज़ीशन प्रक्रिया के दौरान उपयोग की गई कॉलम परमीटेशन के बारे में जानकारी देखते हैं। आउटपुट इंगित करता है कि डीकंपोज़ीशन के दौरान मैट्रिक्स के कॉलमों का परमीटेशन नहीं किया गया, क्योंकि पिवट इंडेक्स मूल कॉलम क्रम से मेल खाते हैं।
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3अगले चरण में, हम क्रमशः qr.Q() और qr.R() फ़ंक्शनों का उपयोग करके Q मैट्रिक्स और R मैट्रिक्स को एक्सेस कर सकते हैं। आउटपुट में हम देख सकते हैं कि Q मैट्रिक्स आयताकार है और R मैट्रिक्स वर्गाकार है, जिसकी विकर्ण रेखा के नीचे शून्य हैं।
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369अंतिम चरण के रूप में, जिज्ञासा वश, हम यह देख सकते हैं कि डीकंपोज़ीशन के लिए qr() फ़ंक्शन कौन-सी विधि का उपयोग करता है।
?qrहम आउटपुट में निम्नलिखित देख सकते हैं:
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.यदि हम FORTRAN दस्तावेज़ देखें, तो पाएंगे कि dgeqrf एक LAPACK रूटीन है जो हाउसहोल्डर ट्रांसफॉर्मेशन का उपयोग करता है।
आइए qr() फ़ंक्शन में क्या हो रहा है, यह समझने की कोशिश करें—उसी इम्प्लिमेंटेशन को नहीं, बल्कि ग्राम–श्मिट प्रक्रिया का अनुसरण करते हुए मिलती-जुलती धारणा को स्वयं बनाकर और सोचकर। इस अभ्यास का उद्देश्य किसी सटीक विधि को दोहराना नहीं, बल्कि अपनी समझ का निर्माण करना है।
ग्राम–श्मिट प्रक्रिया का उपयोग करके अपना Q मैट्रिक्स बनाना शुरू करने के लिए, हमें उपसमुच्चय डेटा के पहले कॉलम को नार्मलाइज़ करना होगा ताकि Q का पहला कॉलम प्राप्त हो। यहाँ लक्ष्य यह है कि मैट्रिक्स A में हमारे वेक्टरों के सेट को नए वेक्टर सेट में बदलें जिनकी यूनिट लंबाई एक हो, और यह सुनिश्चित करें कि ये वेक्टर एक-दूसरे के ऑर्थोगोनल हों।
Q का पहला कॉलम खोजने के लिए, हम A का पहला कॉलम निकालते हैं, यूक्लिडियन नॉर्म की गणना करते हैं, फिर नार्मलाइज़ेशन करते हैं।
दोहराएँ: यूक्लिडियन नॉर्म यूक्लिडियन स्पेस में किसी वेक्टर की लंबाई या परिमाण का माप है। हम प्रत्येक वेक्टर अवयव को बहुआयामी स्पेस में निर्देशांक मानते हुए वेक्टर के आरंभ से अंत तक की दूरी पर विचार करते हैं। किसी वेक्टर v = [v1, v2, …, vn] के लिए, उसका यूक्लिडियन नॉर्म इस प्रकार निकाला जाता है:
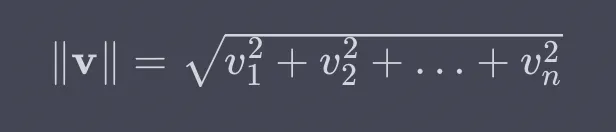
तो, R में लागू करने के लिए, हम प्रत्येक कॉलम का स्क्वेयर करते हैं, सम लेते हैं, फिर स्क्वेयर रूट लेते हैं, और अंत में नार्मलाइज़ करते हैं।
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
रैखिक बीजगणित से हमें दूसरी जो बात दोहरानी है, वह है प्रोजेक्शन की अवधारणा। प्रोजेक्शन उस गणितीय क्रिया को संदर्भित करता है जो किसी वेक्टर को किसी उपस्थल पर प्रोजेक्ट करती है। उपस्थल को बड़े वेक्टर स्पेस के भीतर निम्न-आयामी स्पेस के रूप में समझा जा सकता है। परिणामी प्रोजेक्शन वह वेक्टर होता है जो उपस्थल के भीतर स्थित होता है और मूल वेक्टर के सबसे निकट होता है, जो उपस्थल के लम्बवत भी होता है।
आइए निम्न ग्राफ़ के साथ इसे कल्पित करें, जहाँ प्रोजेक्शन p बिंदु a से b पर सबसे निकट बिंदु है, जो b के लम्बवत होना चाहिए।
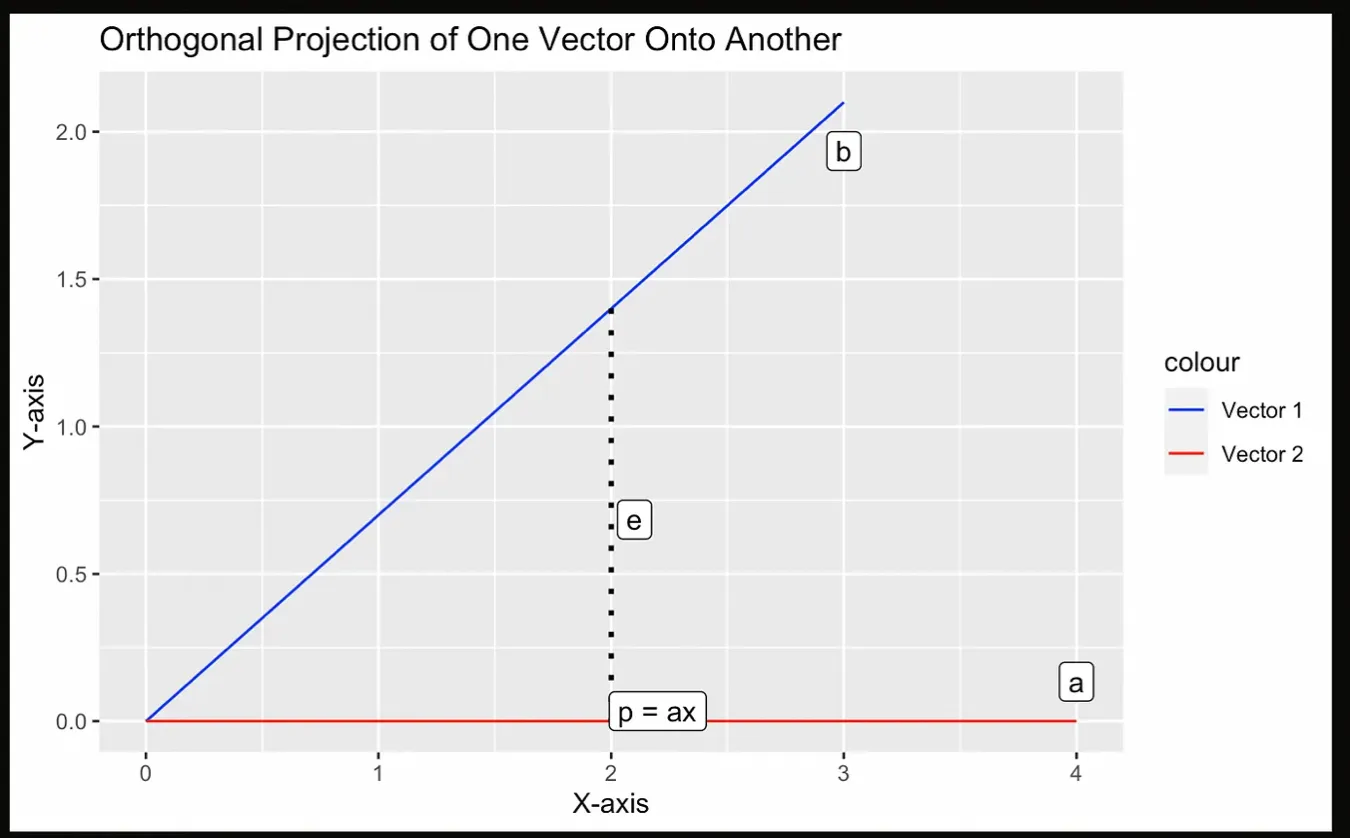
प्रोजेक्शन का चित्रण। छवि: लेखक द्वारा।
QR फैक्टराइज़ेशन के अगले चरण में, हम पहले A के दूसरे कॉलम का प्रोजेक्शन Q के पहले कॉलम पर गणना करते हैं, और फिर उस परिणाम को A के दूसरे कॉलम से घटाते हैं, जिससे दूसरा ऑर्थोगोनल वेक्टर मिलता है। अंतिम चरण में, हम इस वेक्टर को नार्मलाइज़ करते हैं ताकि Q का दूसरा कॉलम प्राप्त हो।
आइए प्रोजेक्शन का समीकरण देखें। प्रोजेक्शन वह मैट्रिक्स है जो a गुना a-ट्रांसपोज़ को स्केलर a-ट्रांसपोज़ गुना a के ऊपर लेकर, फिर b से गुणा करता है।
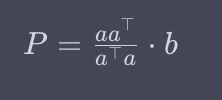
या, वैकल्पिक रूप से:
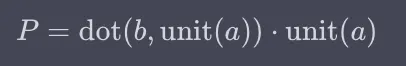
हम सोच सकते हैं: ये दोनों तरीके एक जैसे कैसे हैं? जब हम ऊपर दिया पहला समीकरण देखते हैं, तो b के बाईं ओर का भाग एक ऐसा मैट्रिक्स निकालता है जो मूल रूप से वेक्टर a द्वारा परिभाषित दिशा और उस दिशा के लिए स्केलिंग फैक्टर को पकड़ता है। यह डॉट प्रोडक्ट विधि में a के यूनिट वेक्टर की गणना के समान है।
निम्न R कोड डॉट प्रोडक्ट विधि का उपयोग करते हुए वेक्टर col_2 का q1 पर प्रोजेक्शन गणना करता है।
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
जैसा कि ऊपर के कोड में दिखता है, दूसरे ऑर्थोगोनल वेक्टर और मैट्रिक्स Q के अनुरूप कॉलम का निर्माण प्रोजेक्शन, घटाव और नार्मलाइज़ेशन की प्रक्रिया से होता है। बुनियादी चरण Q के पहले कॉलम बनाने जैसे हैं, लेकिन थोड़े भिन्न और अधिक शामिल: हम पहले A का दूसरा कॉलम निकालते हैं; फिर Q के पहले वेक्टर पर प्रोजेक्शन बनाते हैं; फिर प्रोजेक्शन को A के दूसरे कॉलम से घटाते हैं; फिर नार्मलाइज़ेशन करते हैं; अंततः, Q का दूसरा कॉलम बनाते हैं।
हम इस दूसरे चरण को q3 के लिए आखिरी कॉलम तक दोहरा सकते हैं। हमारे मामले में, ऑर्थोगोनल वेक्टर q1, q2, और q3 ऑर्थोगोनल मैट्रिक्स Q का आधार बनाते हैं। ये वेक्टर आवश्यक हैं क्योंकि वे मूल डेटा को एक नए कोऑर्डिनेट सिस्टम में व्यक्त करने की नींव प्रदान करते हैं।
यहाँ, हम देखते हैं कि ग्राम–श्मिट प्रक्रिया एक आवर्ती (इटरेटिव) प्रक्रिया है जो सुनिश्चित करती है कि प्रत्येक क्रमिक वेक्टर पिछले वेक्टरों के ऑर्थोगोनल हो। हमें यह भी याद है कि ऑर्थोगोनैलिटी का अर्थ है कि दो वेक्टरों का डॉट प्रोडक्ट शून्य है, जो दर्शाता है कि वे वेक्टर स्पेस में एक-दूसरे के लंबवत हैं। आइए q1 और q2 की ऑर्थोगोनैलिटी को उनके डॉट प्रोडक्ट से सत्यापित करें:
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16अब जबकि हमारे पास Q मैट्रिक्स है, हमें R मैट्रिक्स का निर्माण करना है। QR डीकंपोज़ीशन में R मैट्रिक्स में ऑर्थोगोनल मैट्रिक्स Q के कॉलमों और मूल डेटासेट के बीच के संबंधों की जानकारी होती है। यह एक अपर ट्रायएंगुलर मैट्रिक्स है, और R के अपर ट्रायएंगुलर भाग का प्रत्येक अवयव Q के संबंधित कॉलमों और मूल डेटा के डॉट प्रोडक्ट की गणना करके प्राप्त किया जाता है।
अपर ट्रायएंगुलर मैट्रिक्स R बनाने के लिए, हमें Q के प्रत्येक कॉलम का मूल डेटासेट के प्रत्येक कॉलम के साथ डॉट प्रोडक्ट निकालना होगा। परिणामस्वरूप एक ऐसा मैट्रिक्स मिलेगा जिसकी पंक्तियों की संख्या Q के कॉलमों की संख्या के बराबर होगी, और हमारी पूर्ववर्ती प्रक्रिया के कारण यह अपर ट्रायएंगुलर होगा।
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
हम देखते हैं कि इस बार हमारे R मैट्रिक्स का आउटपुट थोड़ा अलग दिखता है। इसका कारण यह है कि qr() फ़ंक्शन हाउसहोल्डर रिफ्लेक्शंस का उपयोग करता है, जिनकी संख्यात्मक स्थिरता हमारी ग्राम–श्मिट-प्रेरित प्रक्रिया की तुलना में अधिक है जिसे हमने खुद बनाया था।
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
हम Q और R को गुणा करके और यह देखकर पुनर्निर्माण सत्यापित कर सकते हैं कि हमें matrix_A वापस मिलती है। यहाँ %*% R में मैट्रिक्स गुणा के लिए है।
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109DataCamp के साथ सीखें
कोर्स
कोर्स
लर्निंग पाथ
