
Cours
Algèbre linéaire pour la data science en R
4 h
21.6K
La décomposition QR est une technique fondamentale de factorisation matricielle, largement utilisée en science des données et en apprentissage automatique. Sa capacité à décomposer des matrices complexes en éléments plus simples en fait une méthode incontournable pour résoudre des problèmes d’algèbre linéaire et améliorer la stabilité des algorithmes.
Que vous réalisiez une régression linéaire aux moindres carrés ordinaires ou que vous construisiez des moteurs de recommandation en Python ou en PySpark, comprendre la décomposition QR peut considérablement renforcer votre capacité à traiter de grands jeux de données et des modèles mathématiques complexes.
Factoriser, ou décomposer, une matrice consiste à exprimer cette matrice comme le produit de deux matrices (ou plus). Autrement dit, la factorisation matricielle permet de scinder une matrice en composants plus simples qui, multipliés entre eux, reconstituent la matrice d’origine. La factorisation matricielle nous intéresse car elle simplifie de nombreux problèmes d’algèbre linéaire et facilite leur résolution.
La décomposition QR est un type spécifique de factorisation qui décompose une matrice en le produit d’une matrice orthogonale Q et d’une matrice triangulaire supérieure R. L’équation courante est A = QR.
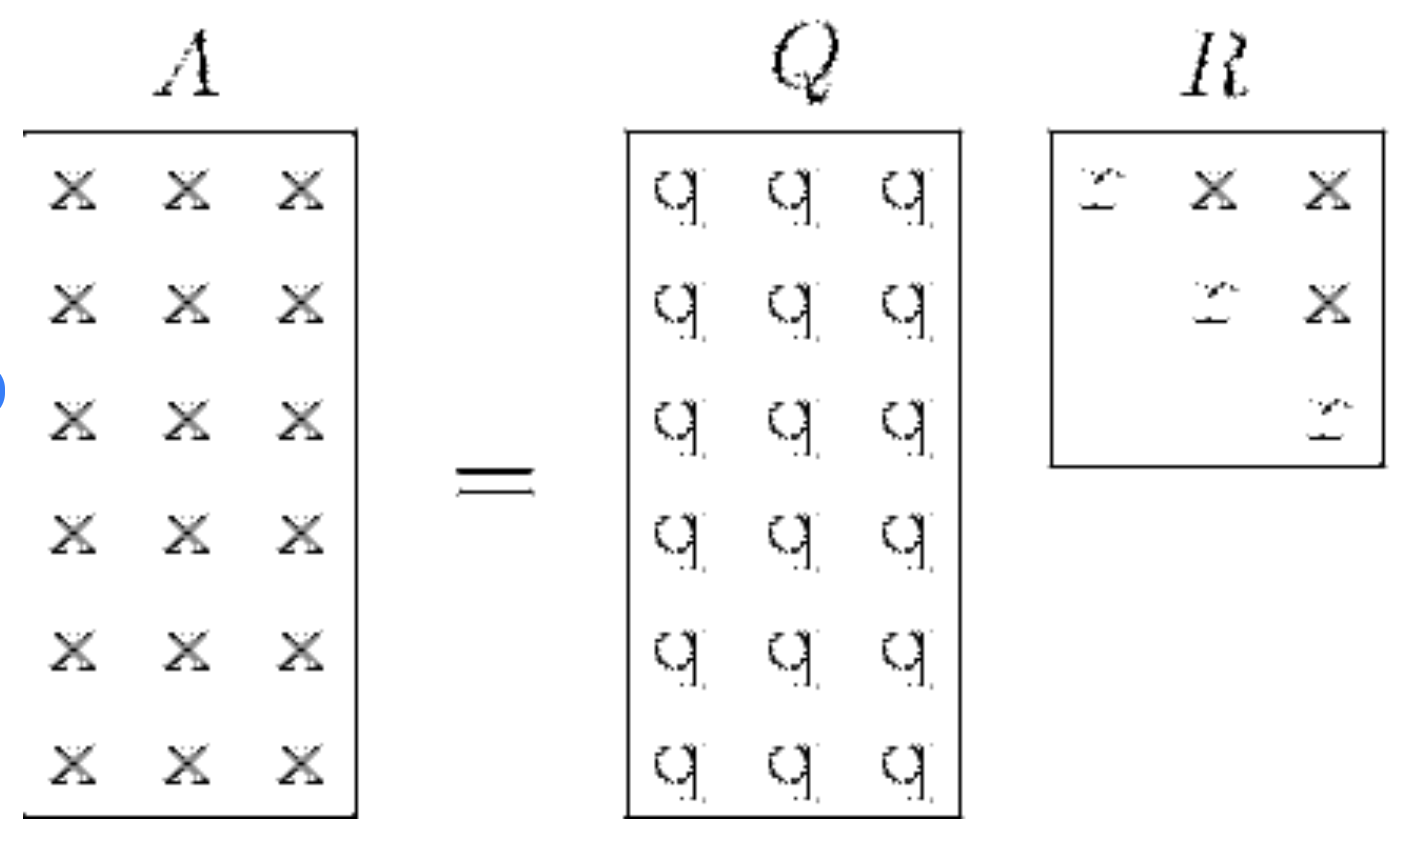
Décomposition QR visualisée. Source : ResearchGate
Pour comprendre la décomposition QR, il faut garder à l’esprit qu’en algèbre linéaire, la multiplication de matrices ne suit pas les mêmes règles intuitives que la multiplication de scalaires. En particulier, la multiplication de matrices n’est pas commutative : en général, AB ≠ BA, et la notion d’« inverse » s’en trouve plus subtile.
Regardons de plus près les deux matrices clés, Q et R.
Une matrice orthogonale Q est caractérisée par le fait que sa transposée est aussi son inverse : mathématiquement, QTQ = QQT = I, où I est la matrice identité. Transposer, pour rappel, revient à « retourner » la matrice par rapport à sa diagonale.
Une matrice orthogonale se caractérise aussi par le fait que ses colonnes forment une base orthonormée. Cela signifie deux choses : d’une part, les colonnes sont orthogonales, c’est-à-dire que le produit scalaire de deux colonnes distinctes est nul ; d’autre part, chaque colonne est de norme unitaire.
Les matrices orthogonales sont agréables à manipuler car elles préservent les longueurs des vecteurs et leurs produits scalaires. Ainsi, si vous multipliez un vecteur par une matrice orthogonale, sa longueur reste inchangée. De même, si vous multipliez deux vecteurs par la même matrice orthogonale, leur produit scalaire reste inchangé. Enfin, comme elles préservent longueurs et produits scalaires, elles ne déforment pas les propriétés géométriques après transformation : deux vecteurs perpendiculaires avant la transformation le resteront après application de la matrice orthogonale.
Une matrice triangulaire supérieure R est une matrice dont tous les éléments situés sous la diagonale principale sont nuls. Cette forme simplifie les équations matricielles et s’avère particulièrement utile pour résoudre des systèmes linéaires via la substitution arrière, entre autres. On peut aussi dire que, dans la décomposition QR, R représente la composante qui capture l’« amplitude » et l’orientation de la matrice d’origine.
Passons en revue quelques méthodes courantes pour effectuer une décomposition QR.
Le procédé de Gram–Schmidt est un algorithme qui convertit systématiquement un ensemble de vecteurs linéairement indépendants en un ensemble orthonormé. Il sert spécifiquement à construire la matrice Q dans la décomposition QR et, une fois Q obtenue, on peut en déduire R.
Les rotations de Givens constituent une autre approche de la décomposition QR. Elles appliquent une série de rotations planes pour introduire des zéros sous la diagonale de la matrice A. Chaque rotation agit sur une paire de coordonnées, en préservant la norme du vecteur tout en transformant la matrice en forme triangulaire supérieure. Cette méthode est efficace pour les matrices creuses, car elle ne modifie qu’une petite portion de la matrice à chaque étape.
Les réflexions de Householder forment une technique plus générale qui utilise des matrices de réflexion, dites matrices de Householder, pour annuler systématiquement les éléments sous-diagonaux de la matrice A. Chaque matrice de Householder reflète un vecteur par rapport à un hyperplan orthogonal au vecteur choisi pour annuler une colonne sous la diagonale. On obtient ainsi une matrice orthogonale Q et une matrice triangulaire supérieure R. Les réflexions de Householder sont particulièrement indiquées pour les matrices denses grâce à leur stabilité numérique.
Dans cette section, nous allons pratiquer la décomposition QR en R : d’abord avec la fonction intégrée qr() pour une mise en œuvre rapide, puis en reprenant le raisonnement depuis zéro via le procédé de Gram–Schmidt afin de développer l’intuition. Commençons par créer matrix_A, que nous utiliserons dans les deux parties.
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")On peut effectuer cette factorisation en une seule étape avec qr(). On assigne le résultat à un objet qr_decomp, qui est une liste contenant la décomposition QR.
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
En accédant au composant rank de l’objet, on obtient le nombre de colonnes linéairement indépendantes dans la matrice décomposée. La sortie indique un rang de trois, soit trois colonnes linéairement indépendantes, comme attendu. En consultant le composant pivot, on voit la permutation des colonnes utilisée pendant la décomposition. Ici, les indices correspondent à l’ordre d’origine : il n’y a pas eu de permutation.
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3Ensuite, on peut extraire les matrices Q et R via qr.Q() et qr.R(). On constate que Q est rectangulaire et R carrée, avec des zéros sous la diagonale.
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369Par curiosité, vérifions quelle méthode la fonction qr() utilise pour la décomposition.
?qrOn peut lire notamment ceci dans la documentation :
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.En consultant la documentation FORTRAN, on voit que dgeqrf est une routine LAPACK qui s’appuie sur des transformations de Householder.
Essayons de comprendre ce qui se passe avec qr() en recréant non pas la même implémentation, mais une idée similaire en suivant le procédé de Gram–Schmidt. L’objectif n’est pas de reproduire exactement la méthode, mais d’enrichir notre compréhension.
Pour commencer la construction de Q avec Gram–Schmidt, nous normalisons la première colonne des données pour obtenir la première colonne de Q. Le but est de transformer l’ensemble de vecteurs de la matrice A en un nouvel ensemble de vecteurs de norme unitaire, mutuellement orthogonaux.
Pour trouver la première colonne de Q, on extrait la première colonne de A, on calcule la norme euclidienne, puis on normalise.
Rappel : la norme euclidienne mesure la longueur (ou amplitude) d’un vecteur dans l’espace euclidien. Elle correspond à la distance entre l’origine et l’extrémité du vecteur, en considérant chaque élément comme une coordonnée en espace multidimensionnel. Pour un vecteur v = [v1, v2, …, vn], sa norme euclidienne se calcule ainsi :
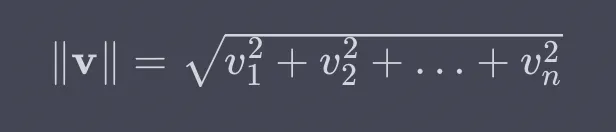
En R, on élève chaque colonne au carré, on somme, on prend la racine carrée, puis on normalise.
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
Deuxième rappel d’algèbre linéaire : la projection. Une projection est l’opération qui projette un vecteur sur un sous-espace (un espace de dimension inférieure inclus dans l’espace vectoriel). Le résultat est un vecteur du sous-espace, le plus proche possible du vecteur initial projeté, et orthogonal au complémentaire.
Visualisons cela avec le graphique suivant, où la projection p est le point de a le plus proche de b, et elle doit être perpendiculaire à b.
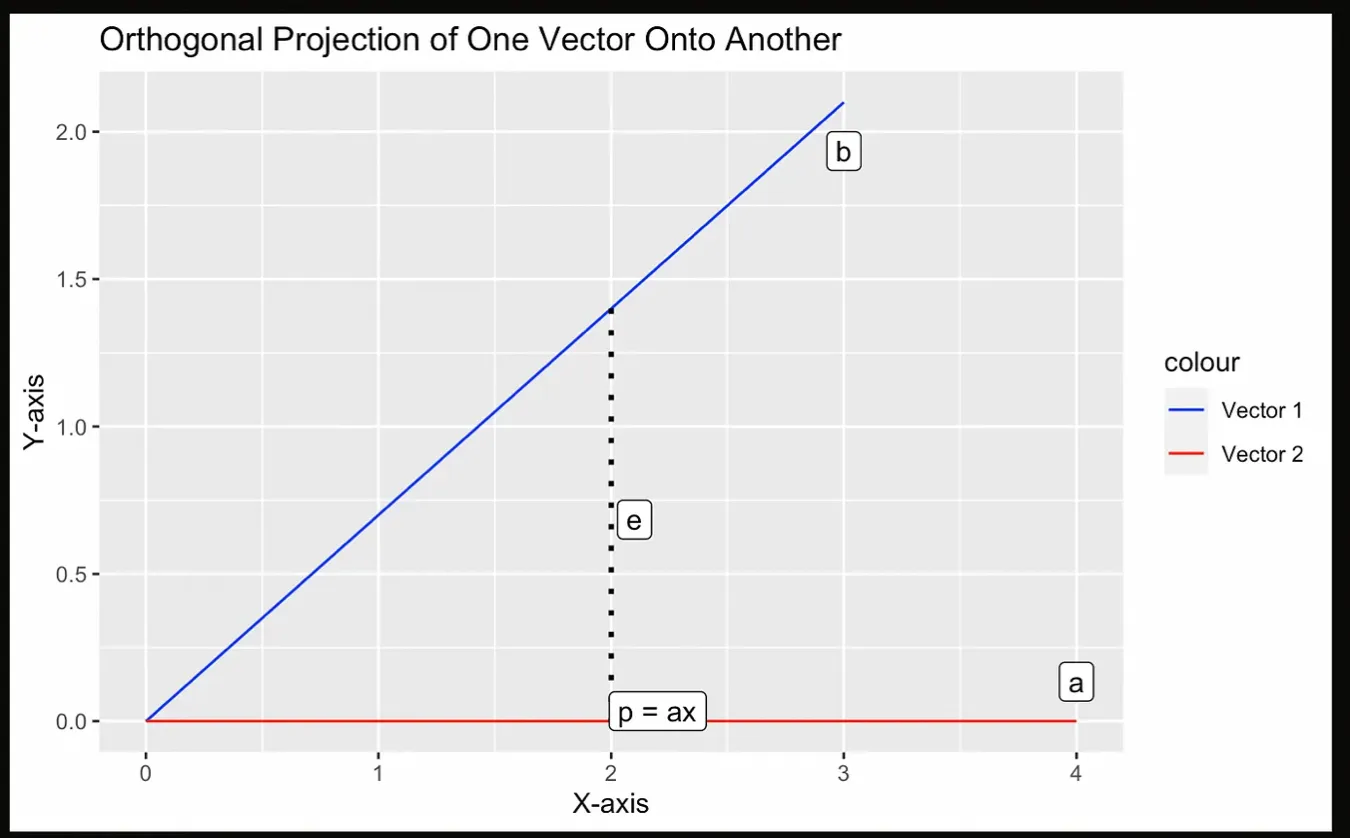
Illustration d’une projection. Image par l’auteur.
À l’étape suivante de la factorisation QR, nous calculons le deuxième vecteur orthogonal en projetant d’abord la deuxième colonne de A sur la première colonne de Q, puis en soustrayant ce résultat de la deuxième colonne de A. Le vecteur obtenu est orthogonal au premier. Enfin, nous le normalisons pour obtenir la deuxième colonne de Q.
Revenons à l’équation d’une projection. La matrice de projection s’écrit comme a fois a-transposé, divisé par le scalaire a-transposé fois a, puis multiplié par b.
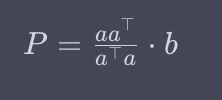
Ou, de manière équivalente :
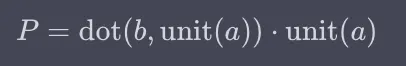
Vous vous demandez peut‑être : en quoi ces deux formulations sont‑elles équivalentes ? Dans la première, la partie à gauche de b calcule une matrice qui capture la direction définie par a et son facteur d’échelle. C’est analogue au calcul du vecteur unitaire de a dans la méthode par produit scalaire.
Le code R suivant calcule la projection du vecteur col_2 sur le vecteur q1 via le produit scalaire.
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
Comme on le voit ci‑dessus, construire le deuxième vecteur orthogonal (et donc la deuxième colonne de Q) implique projection, soustraction, puis normalisation. Les étapes sont proches de celles de la première colonne, mais un peu plus impliquées : extraire la deuxième colonne de A ; projeter sur le premier vecteur de Q ; soustraire la projection à la deuxième colonne de A ; normaliser ; former la deuxième colonne de Q.
On peut répéter cette étape pour q3 jusqu’à la dernière colonne. Dans notre cas, les vecteurs orthogonaux q1, q2 et q3 forment la base de la matrice orthogonale Q. Ces vecteurs sont essentiels car ils fournissent le nouveau système de coordonnées pour exprimer les données d’origine.
On voit que Gram–Schmidt est un processus itératif qui garantit que chaque nouveau vecteur est orthogonal aux précédents. Rappelons que l’orthogonalité signifie que le produit scalaire de deux vecteurs est nul, ce qui indique leur perpendicularité dans l’espace vectoriel. Vérifions l’orthogonalité de q1 et q2 avec leur produit scalaire :
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16Maintenant que nous avons la matrice Q, construisons la matrice R. Dans la décomposition QR, R encode les relations entre les colonnes de la matrice orthogonale Q et les données d’origine. C’est une matrice triangulaire supérieure ; chaque élément de sa partie supérieure s’obtient par le produit scalaire entre la colonne correspondante de Q et la colonne d’origine.
Pour construire R, on calcule donc les produits scalaires de chaque colonne de Q avec chaque colonne du jeu de données initial. On obtient une matrice dont le nombre de lignes correspond au nombre de colonnes de Q, et qui est triangulaire supérieure du fait du processus précédent.
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
La sortie de R diffère ici un peu de la précédente. C’est parce que qr() utilise les réflexions de Householder, plus stables numériquement, contrairement à notre version inspirée de Gram–Schmidt.
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
Nous pouvons vérifier la reconstruction en multipliant Q et R pour retrouver matrix_A. Ici, %*% correspond à la multiplication matricielle en R.
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109Validez vos compétences professionnelles de data scientist.

Learn with DataCamp
Cours
Cours
Cursus