
Corso
Algebra lineare per la Data Science in R
4 ore
21.8K
La decomposizione QR è una tecnica fondamentale di fattorizzazione delle matrici, ampiamente utilizzata in vari ambiti della data science e del machine learning. La sua capacità di scomporre matrici complesse in parti più semplici la rende un metodo indispensabile per risolvere problemi di algebra lineare e migliorare la stabilità degli algoritmi.
Che tu stia eseguendo una regressione lineare OLS o sviluppando motori di raccomandazione in Python o PySpark, capire la decomposizione QR può aumentare in modo significativo la tua capacità di lavorare con dataset di grandi dimensioni e modelli matematici complessi.
Quando fattorizzi, o decomponi, una matrice, esprimi quella matrice come il prodotto di due o più matrici. In altre parole, la fattorizzazione di matrici ti permette di scomporre una matrice in componenti più semplici che, quando moltiplicate tra loro tramite moltiplicazione tra matrici, ricostruiscono la matrice originale. La fattorizzazione di matrici è utile perché semplifica molti problemi di algebra lineare, rendendoli più facili da risolvere.
La decomposizione QR è un particolare tipo di fattorizzazione che scompone una matrice nel prodotto di una matrice ortogonale Q e di una matrice triangolare superiore R. L'equazione che vediamo più spesso è A = QR.
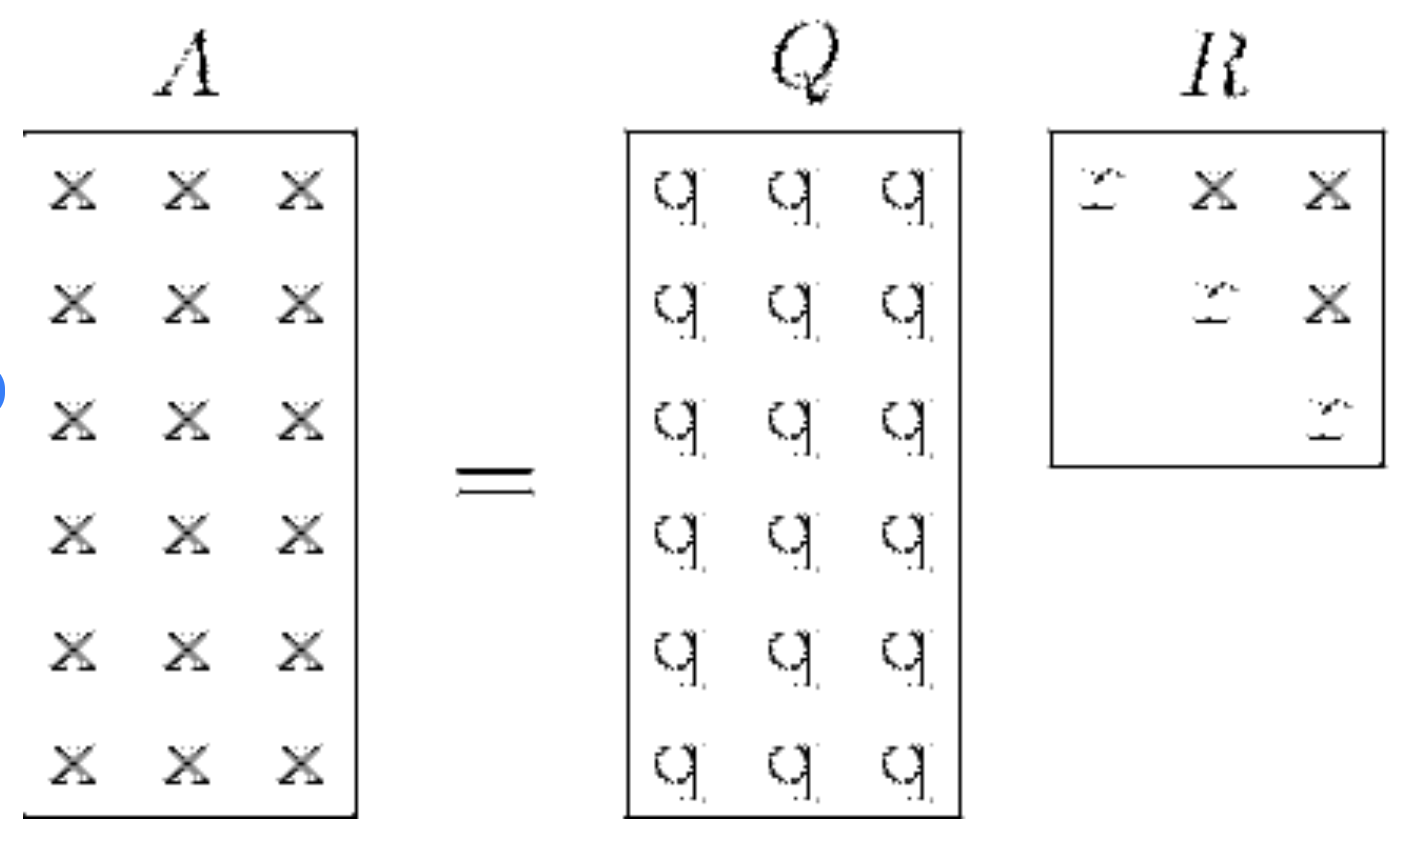
Decomposizione QR visualizzata. Fonte: ResearchGate
Per capire la decomposizione QR, è importante ricordare che in algebra lineare la moltiplicazione tra matrici non segue le stesse regole intuitive della moltiplicazione tra scalari. In particolare, la moltiplicazione tra matrici non è commutativa, cioè in generale AB ≠ BA, e quindi la nozione di "inverso" è più complessa.
Vediamo le due matrici importanti, Q e R.
Una matrice ortogonale Q è caratterizzata dalla proprietà per cui la sua trasposta è anche la sua inversa, rappresentata matematicamente come QTQ = QQT = I, dove I è la matrice identità. Trasporre, in questo contesto, significa ribaltare la matrice rispetto alla sua diagonale.
Una matrice ortogonale è anche caratterizzata dal fatto che le sue colonne formano una base ortonormale. Questo significa due cose: primo, le colonne sono ortogonali, cioè il prodotto scalare di qualsiasi coppia di colonne distinte è zero. Secondo, ogni colonna ha una lunghezza unitaria, pari a uno.
Le matrici ortogonali sono comode da usare perché preservano le lunghezze dei vettori e i loro prodotti scalari. Quindi, se hai un vettore e lo moltiplichi per una matrice ortogonale, la lunghezza di quel vettore rimane la stessa. Inoltre, se hai due vettori e li moltiplichi entrambi per la stessa matrice ortogonale, anche il prodotto scalare tra loro rimane invariato. Infine, poiché le matrici ortogonali preservano lunghezze e prodotti scalari, non distorcono le proprietà geometriche dei vettori dopo la trasformazione. Cioè, se due vettori sono perpendicolari prima della trasformazione, rimarranno perpendicolari anche dopo aver applicato la matrice ortogonale.
Una matrice triangolare superiore R è un tipo di matrice in cui tutti gli elementi al di sotto della diagonale principale sono zero. Questa forma semplifica le equazioni tra matrici ed è particolarmente utile per risolvere sistemi di equazioni lineari tramite sostituzione all'indietro o altri metodi. Possiamo anche dire che, nella decomposizione QR, R rappresenta la componente che cattura la magnitudine e l'orientamento della matrice originale.
Diamo un'occhiata rapida ad alcuni modi diversi per eseguire la decomposizione QR.
Il processo di Gram-Schmidt è un algoritmo usato per convertire in modo sistematico un insieme di vettori linearmente indipendenti in un insieme ortonormale. Questo processo è usato in particolare per costruire la matrice Q nella nostra decomposizione QR e, una volta ottenuta Q, possiamo ricavare R.
Le rotazioni di Givens sono un altro metodo utile per la decomposizione QR. Con le rotazioni di Givens, si applica una serie di rotazioni piane per introdurre zeri sotto la diagonale della matrice A. Ogni rotazione agisce su una coppia di coordinate, preservando la lunghezza del vettore mentre trasforma la matrice in una forma triangolare superiore. Questo metodo è efficiente per matrici sparse, poiché a ogni passo modifica solo una piccola porzione della matrice.
Le riflessioni di Householder sono una tecnica più generale che utilizza matrici di riflessione, note come matrici di Householder, per eliminare sistematicamente gli elementi sotto-diagonali della matrice A. Ogni matrice di Householder riflette un vettore rispetto a un piano ortogonale al vettore scelto per azzerare una colonna sotto la diagonale. Il risultato è una matrice ortogonale Q e una matrice triangolare superiore R. Le riflessioni di Householder sono particolarmente adatte per matrici dense grazie alla loro stabilità numerica.
In questa sezione, praticheremo la decomposizione QR in R usando sia la funzione integrata qr() per un'implementazione rapida, sia ricostruendo il processo da zero con il metodo di Gram-Schmidt per costruire intuizione. Iniziamo creando matrix_A, che useremo in entrambe le sezioni.
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")Possiamo eseguire questa fattorizzazione in un solo passaggio con la funzione qr(). Assegniamo il risultato a un oggetto qr_decomp, che è una lista contenente la decomposizione QR.
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
Accedendo alla componente rank dell'oggetto di decomposizione QR possiamo vedere il numero di colonne linearmente indipendenti nella nostra matrice decomposta. L'output indica che la matrice ha rango tre, ossia tre colonne linearmente indipendenti, come ci aspettiamo. Accedendo invece alla componente pivot, possiamo vedere informazioni sulla permutazione delle colonne usata durante la decomposizione. L'output indica che le colonne della matrice non sono state permutate durante la decomposizione, poiché gli indici di pivot corrispondono all'ordine originale delle colonne.
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3Come passo successivo, possiamo accedere alla matrice Q e alla matrice R usando rispettivamente le funzioni qr.Q() e qr.R(). Dall'output vediamo che la matrice Q è rettangolare e la matrice R è quadrata con zeri sotto la diagonale.
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369Come passo finale, per curiosità, possiamo verificare quale metodo usa la funzione qr() per la decomposizione.
?qrNell'output possiamo leggere quanto segue:
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.Se consultassimo la documentazione FORTRAN, vedremmo che dgeqrf è una routine di LAPACK che usa trasformazioni di Householder.
Cerchiamo di capire cosa accade con la funzione qr() ricreando non la stessa implementazione ma un'idea simile, seguendo il processo di Gram-Schmidt e ragionandoci. Lo scopo di questo esercizio non è replicare un metodo identico, ma piuttosto costruire comprensione.
Per iniziare a creare la nostra matrice Q con il processo di Gram-Schmidt, dobbiamo normalizzare la prima colonna dei dati per ottenere la prima colonna di Q. L'obiettivo è trasformare il nostro insieme di vettori nella matrice A in un nuovo insieme di vettori con lunghezza unitaria pari a uno, assicurandoci che questi vettori siano ortogonali tra loro.
Per trovare la prima colonna di Q, estraiamo la prima colonna di A, calcoliamo la norma euclidea e poi eseguiamo la normalizzazione.
Per ricordare, la norma euclidea è una misura della lunghezza o magnitudine di un vettore nello spazio euclideo. Consideriamo la distanza dall'origine alla punta del vettore, trattando ciascun elemento del vettore come una coordinata in uno spazio multidimensionale. Per un vettore v = [v1,v2,…,vn], la sua norma euclidea si calcola nel modo seguente:
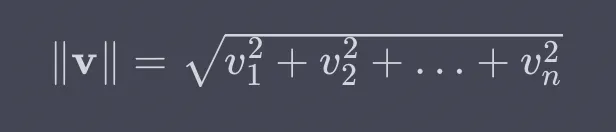
Quindi, per implementarla in R, eleviamo al quadrato ciascuna colonna, facciamo la somma, poi la radice quadrata e, infine, normalizziamo.
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
La seconda cosa da ripassare dall'algebra lineare è il concetto di proiezione. Una proiezione è un'operazione matematica che proietta un vettore su un sottospazio. Il sottospazio può essere inteso come uno spazio di dimensioni inferiori all'interno dello spazio vettoriale più grande. Il risultato della proiezione è un vettore che giace nel sottospazio ed è il più vicino possibile al vettore originale proiettato, ed è anche ortogonale al sottospazio.
Proviamo a visualizzare con il seguente grafico, dove la proiezione p è il punto più vicino ad a lungo b, che deve essere perpendicolare a b.
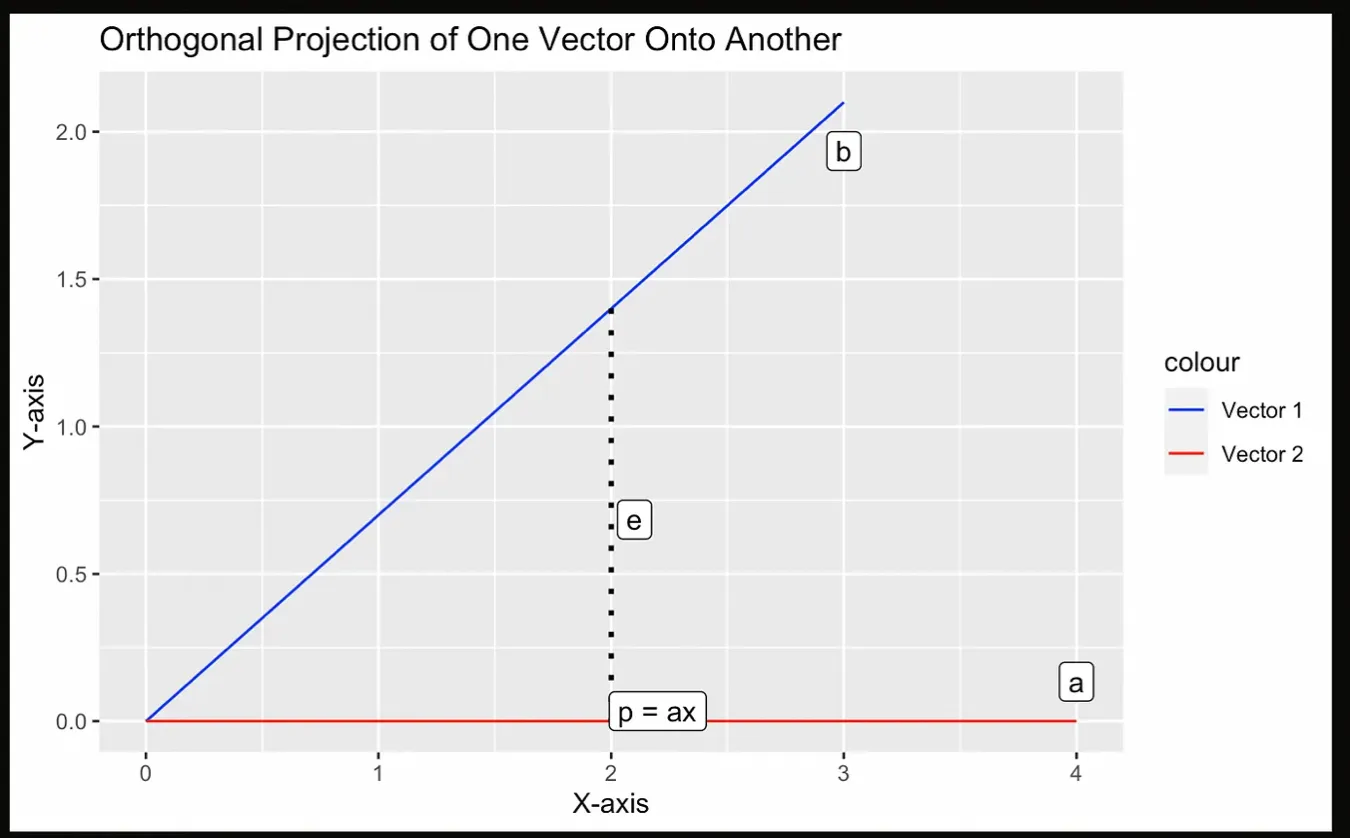
Illustrazione di una proiezione. Immagine dell'autore.
Nel passo successivo della fattorizzazione QR calcoliamo il secondo vettore ortogonale, prima calcolando la proiezione della seconda colonna di A sulla prima colonna di Q, e poi sottraendo quel risultato dalla seconda colonna di A. Il vettore risultante sarà ortogonale al primo vettore. Come passo finale, normalizziamo questo vettore per ottenere la seconda colonna di Q.
Ripassiamo l'equazione di una proiezione. La proiezione è la matrice data da a per a-trasposta divisa per lo scalare a-trasposta per a, moltiplicata per b.
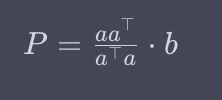
Oppure, in alternativa:
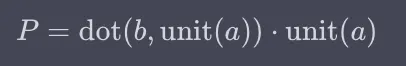
Potremmo chiederci: come fanno questi due metodi a essere equivalenti? Ebbene, guardando la prima equazione sopra, la parte a sinistra di b calcola una matrice che cattura essenzialmente la direzione definita dal vettore a e il fattore di scala per quella direzione. Questo è analogo al calcolo del vettore unitario di a nel metodo basato sul prodotto scalare.
Il seguente codice R calcola la proiezione del vettore col_2 sul vettore q1 usando il metodo del prodotto scalare.
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
Come si vede nel codice sopra, costruire il secondo vettore ortogonale e la colonna corrispondente della matrice Q comporta un processo di proiezione, sottrazione e normalizzazione. I passaggi di base sono simili a quelli per creare la prima colonna di Q, ma sono un po' diversi e leggermente più articolati: prima estraiamo la seconda colonna di A; poi creiamo una proiezione sul primo vettore di Q; quindi sottraiamo la proiezione dalla seconda colonna di A; successivamente eseguiamo la normalizzazione; infine creiamo la seconda colonna di Q.
Possiamo ripetere questo secondo passo per q3 fino all'ultima colonna. Nel nostro caso, i vettori ortogonali q1, q2 e q3 formano la base della matrice ortogonale Q. Questi vettori sono fondamentali perché forniscono le basi per esprimere i dati originali in un nuovo sistema di coordinate.
Qui vediamo che il processo di Gram-Schmidt è iterativo e garantisce che ogni vettore successivo sia ortogonale ai precedenti. Ricordiamo anche che ortogonalità significa che il prodotto scalare di due vettori è zero, il che indica che sono perpendicolari tra loro nello spazio vettoriale. Confermiamo l'ortogonalità di q1 e q2 usando il loro prodotto scalare:
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16Ora che abbiamo la nostra matrice Q, dobbiamo costruire la matrice R. Nella decomposizione QR, la matrice R contiene informazioni sulle relazioni tra le colonne della matrice ortogonale Q e il dataset originale. È una matrice triangolare superiore e ciascun elemento della sua parte superiore si ottiene calcolando il prodotto scalare tra le colonne corrispondenti di Q e dei dati originali.
Per costruire la matrice triangolare superiore R, dobbiamo calcolare i prodotti scalari di ciascuna colonna di Q con ciascuna colonna del dataset originale. Questo produrrà una matrice che ha lo stesso numero di righe del numero di colonne di Q e sarà triangolare superiore grazie al processo precedente.
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
Notiamo che questa volta l'output della nostra matrice R sembra un po' diverso. Il motivo è che la funzione qr() usa riflessioni di Householder con una stabilità numerica maggiore rispetto al processo ispirato a Gram-Schmidt che abbiamo creato noi stessi.
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
Possiamo verificare la ricostruzione moltiplicando Q e R e controllando di ottenere di nuovo matrix_A. Qui, %*% indica la moltiplicazione tra matrici in R.
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109Impara con DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



