Cursus
Lineaire algebra voor data science in R
4 uur
21.9K
QR-decompositie is een fundamentele matrixfactorisatietechniek die veel wordt gebruikt in verschillende gebieden van data science en machine learning. Doordat je complexe matrices kunt opsplitsen in eenvoudigere componenten, is het een onmisbare methode voor het oplossen van lineaire-algebraproblemen en het verbeteren van de stabiliteit van algoritmen.
Of je nu ordinary least squares lineaire regressie uitvoert of aanbevelingssystemen bouwt in Python of PySpark, inzicht in QR-decompositie kan je vermogen om met grote datasets en complexe wiskundige modellen te werken aanzienlijk vergroten.
Als je een matrix factoriseert, of decomponeert, druk je die matrix uit als het product van twee of meer matrices. Met andere woorden: matrixfactorisatie stelt je in staat een matrix op te splitsen in eenvoudigere componenten die, wanneer ze met matrixvermenigvuldiging met elkaar worden vermenigvuldigd, de oorspronkelijke matrix reconstrueren. Matrixfactorisatie is belangrijk omdat het veel lineaire-algebraproblemen vereenvoudigt en daardoor beter oplosbaar maakt.
Een QR-decompositie is een specifieke vorm van matrixfactorisatie die wordt gebruikt om een matrix te ontbinden in het product van een orthogonale matrix Q en een bovendriehoeksmatrix R. De vergelijking die we vaak zien is A = QR.
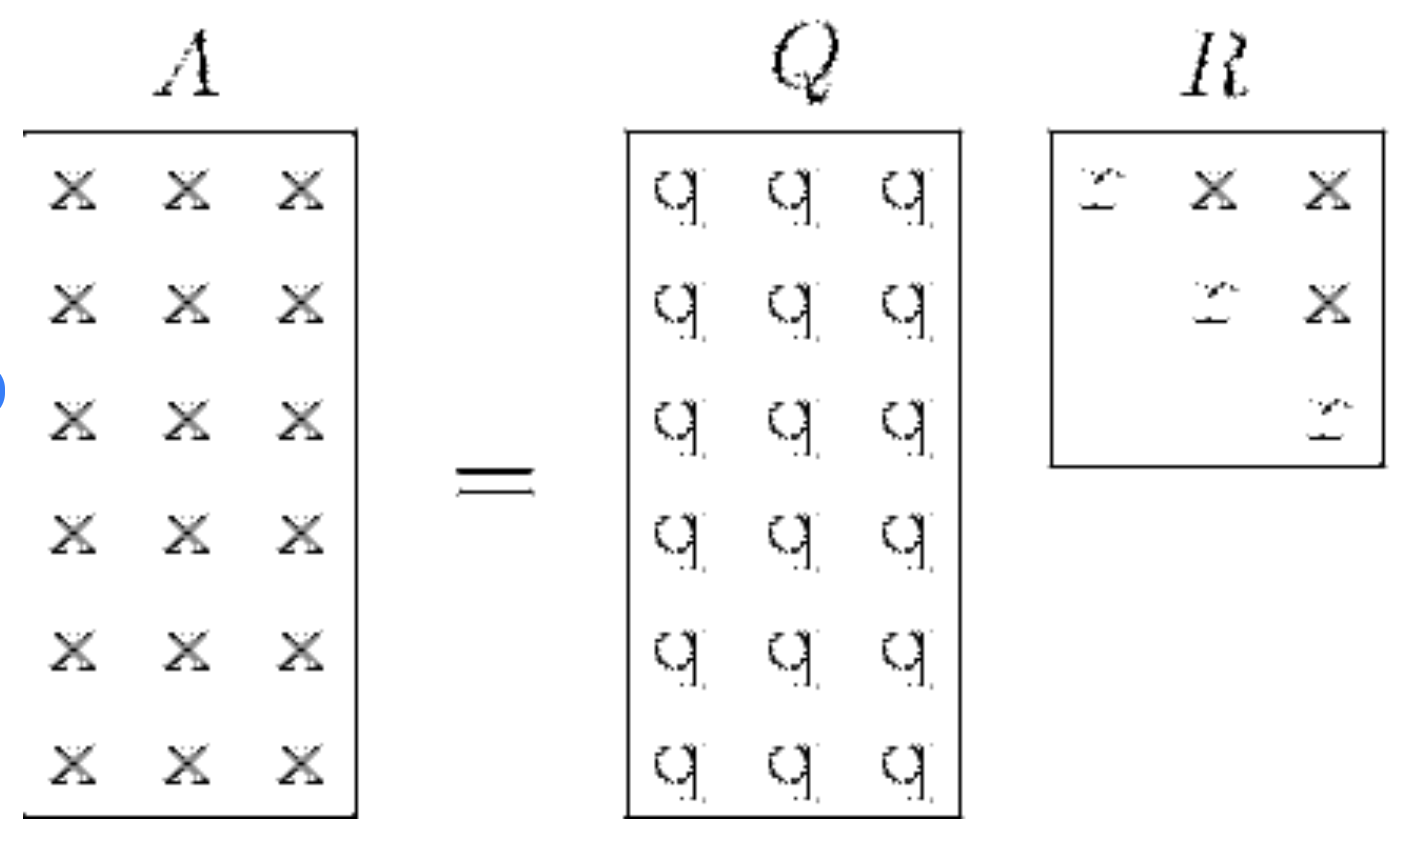
QR-decompositie gevisualiseerd. Bron: ResearchGate
Om QR-decompositie te begrijpen, moet je waarderen dat matrixvermenigvuldiging in lineaire algebra niet dezelfde intuïtieve regels volgt als scalaire vermenigvuldiging. Concreet: matrices vermenigvuldigen is niet commutatief, wat betekent dat AB ≠ BA in het algemeen, en daarom is het idee van een "omgekeerde volgorde" complexer.
Laten we kijken naar de twee belangrijke matrices, Q en R.
Een orthogonale matrix Q wordt gekenmerkt door de eigenschap dat de getransponeerde ook de inverse is, wat wiskundig wordt weergegeven als QTQ = QQT = I, waarbij I de identiteitsmatrix is. Transponeren betekent, ter context, de matrix spiegelen over de diagonaal.
Een orthogonale matrix wordt ook gekenmerkt door het feit dat de kolommen een orthonormale basis vormen. Dit betekent twee dingen: ten eerste zijn de kolommen orthogonaal, oftewel het inproduct van elk paar verschillende kolommen in de matrix is nul. Ten tweede heeft elke kolom een lengte, of eenheidsnorm, van één.
Orthogonale matrices zijn prettig om mee te werken omdat ze de lengtes van vectoren en hun inproducten behouden. Als je dus een vector hebt en je vermenigvuldigt die met een orthogonale matrix, blijft de lengte van die vector hetzelfde. En als je twee vectoren hebt en je vermenigvuldigt ze beide met dezelfde orthogonale matrix, blijft ook hun inproduct gelijk. Tot slot, omdat orthogonale matrices lengtes en inproducten behouden, vervormen ze de geometrische eigenschappen van de vectoren na onze transformatie niet. Dat wil zeggen: als twee vectoren vóór de transformatie loodrecht op elkaar staan, blijven ze dat ook na toepassing van de orthogonale matrix.
Een bovendriehoeksmatrix R is een type matrix waarbij alle elementen onder de hoofddiagonaal nul zijn. Deze vorm vereenvoudigt matrixvergelijkingen en is bijzonder nuttig bij het oplossen van stelsels lineaire vergelijkingen via achterwaartse substitutie of een andere methode. We kunnen ook zeggen dat in QR-decompositie R het deel vertegenwoordigt dat de grootte en oriëntatie van de oorspronkelijke matrix vastlegt.
Laten we kort kijken naar een paar manieren om QR-decompositie uit te voeren.
Het Gram-Schmidt-proces is een algoritme dat wordt gebruikt om een set lineair onafhankelijke vectoren systematisch om te zetten in een orthonormale set. Dit proces wordt specifiek gebruikt voor het construeren van de Q-matrix in onze QR-decompositie en, zodra we Q hebben, kunnen we R afleiden.
Givens-rotaties is een andere methode die helpt bij QR-decompositie. Met Givens-rotaties wordt een reeks vlakrotaties toegepast om nullen onder de diagonaal van matrix A te introduceren. Elke rotatie werkt op een paar coördinaten en behoudt de lengte van de vector, terwijl de matrix wordt omgevormd tot een bovendriehoeksvorm. Deze methode is efficiënt voor sparse matrices, omdat bij elke stap slechts een klein deel van de matrix wordt aangepast.
Householder-reflecties zijn een algemenere techniek die reflectiematrices, bekend als Householder-matrices, gebruiken om de subdiagonale elementen van matrix A systematisch te elimineren. Elke Householder-matrix reflecteert een vector ten opzichte van een vlak dat orthogonaal staat op de vector die is gekozen om een kolom onder de diagonaal op nul te zetten. Het resultaat is een orthogonale matrix Q en een bovendriehoeksmatrix R. Householder-reflecties zijn vooral geschikt voor dichte matrices vanwege hun numerieke stabiliteit.
In deze sectie oefenen we met QR-decompositie in R door zowel de ingebouwde qr()-functie te gebruiken voor een snelle implementatie als vervolgens het proces vanaf nul te doorlopen met het Gram-Schmidt-proces om onze intuïtie op te bouwen. Laten we beginnen met het maken van matrix_A, die we in beide secties gebruiken.
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")We kunnen deze factorisatie in één stap doen met de functie qr(). We wijzen het resultaat toe aan een qr_decomp-object, een lijst die de QR-decompositie bevat.
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
Als we de rankcomponent van het QR-decompositieobject opvragen, zien we het aantal lineair onafhankelijke kolommen in onze ontbonden matrix. De uitvoer geeft aan dat de matrix een rang van drie heeft, wat betekent dat er drie lineair onafhankelijke kolommen zijn, precies zoals we verwachten. Wanneer we de pivotcomponent opvragen, zien we informatie over de permutatie van kolommen die tijdens het decompositieproces is gebruikt. De uitvoer geeft aan dat de kolommen van de matrix niet zijn gepermuterd tijdens de decompositie, omdat de pivotindices overeenkomen met de oorspronkelijke kolomvolgorde.
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3Vervolgens kunnen we respectievelijk de Q-matrix en de R-matrix opvragen met de functies qr.Q() en qr.R(). In de uitvoer zien we dat de Q-matrix rechthoekig is en de R-matrix vierkant met nullen onder de diagonaal.
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369Omdat we nieuwsgierig zijn, kunnen we als laatste stap controleren welke methode de functie qr() gebruikt voor decompositie.
?qrWe zien het volgende als onderdeel van de uitvoer:
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.Als we de FORTRAN-documentatie zouden raadplegen, zouden we zien dat dgeqrf een LAPACK-routine is die Householder-transformaties gebruikt.
Laten we proberen te begrijpen wat er gebeurt met de functie qr() door niet dezelfde implementatie, maar wel een vergelijkbaar idee zelf na te bouwen door het Gram-Schmidt-proces te volgen en erbij stil te staan. Het doel van deze oefening is niet om een exacte methode te recreëren, maar om ons begrip te vergroten.
Om te beginnen met het maken van onze Q-matrix met het Gram-Schmidt-proces, moeten we de eerste kolom van de subsetgegevens normaliseren om de eerste kolom van Q te verkrijgen. Het doel hier is om onze set vectoren in matrix A te transformeren naar een nieuwe set vectoren met een eenheidslengte van één, en ervoor te zorgen dat deze vectoren orthogonaal aan elkaar zijn.
Om de eerste kolom van Q te vinden, halen we de eerste kolom van A op, berekenen we de Euclidische norm en voeren we vervolgens normalisatie uit.
Ter herinnering: de Euclidische norm is een maat voor de lengte of grootte van een vector in de Euclidische ruimte. We beschouwen de afstand van de oorsprong tot het uiteinde van de vector, waarbij we elk vectorelement zien als een coördinaat in een multidimensionale ruimte. Voor een vector v = [v1,v2,…,vn] wordt de Euclidische norm als volgt berekend:
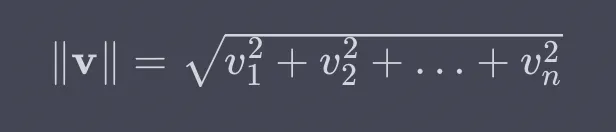
Dus, om dit in R te implementeren, kwadrateren we elke kolom, nemen we de som, vervolgens de wortel, en normaliseren we tenslotte.
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
Het tweede concept dat we uit de lineaire algebra moeten herzien, is dat van een projectie. Een projectie verwijst naar een wiskundige bewerking die een vector projecteert op een deelruimte. Die deelruimte kun je zien als een laag-dimensionale ruimte binnen de grotere vectorruimte. De resulterende projectie is een vector die binnen de deelruimte ligt en het dichtst bij de oorspronkelijke geprojecteerde vector, en die ook orthogonaal staat op de deelruimte.
Laten we dit proberen te visualiseren met de volgende grafiek, waar de projectie p het punt is dat het dichtst bij a ligt vanuit b, en dat loodrecht op b moet staan.
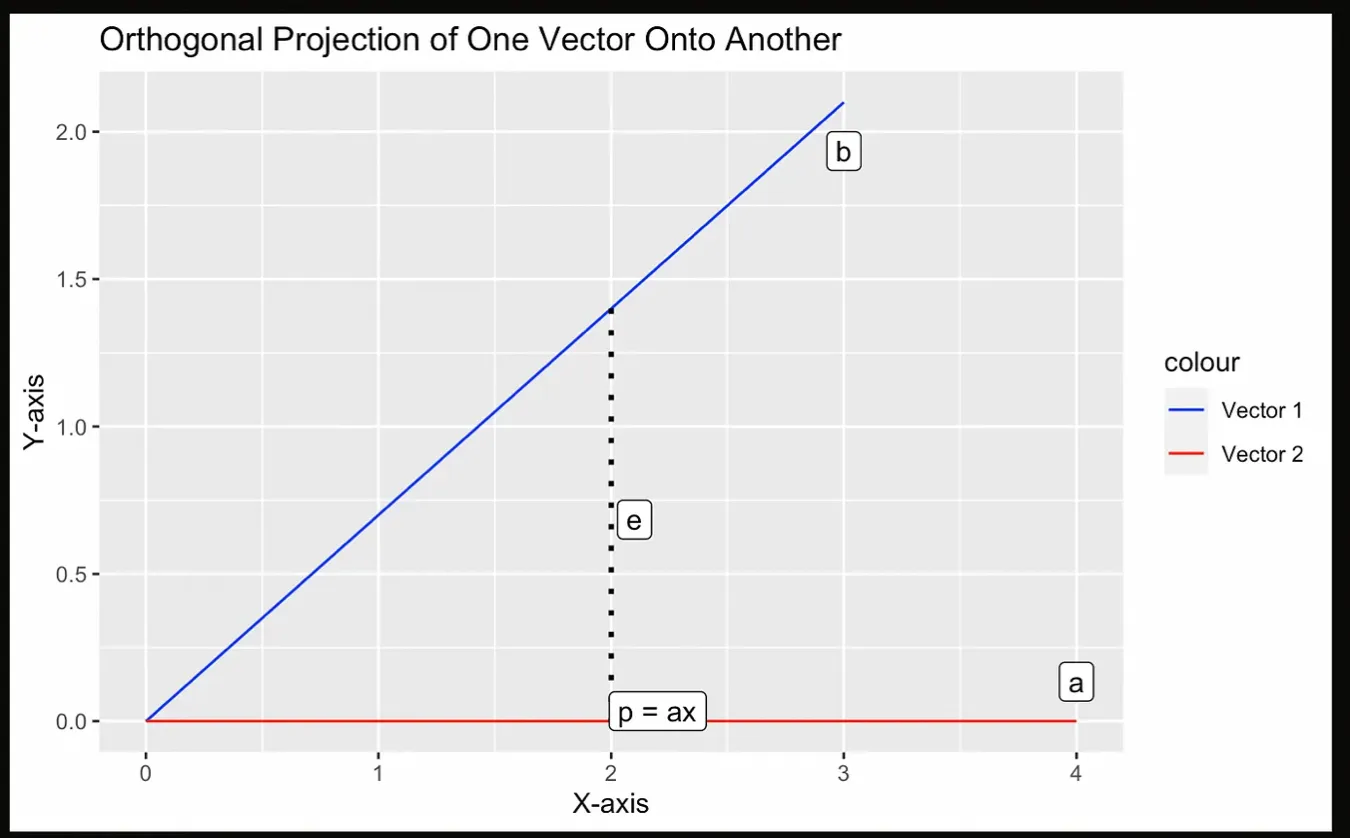
Illustratie van een projectie. Afbeelding door de auteur.
In de volgende stap van QR-factorisatie berekenen we de tweede orthogonale vector door eerst de projectie van de tweede kolom van A op de eerste kolom van Q te berekenen en vervolgens dat resultaat af te trekken van de tweede kolom van A. De resulterende vector zal orthogonaal zijn aan de eerste vector. Als laatste stap normaliseren we deze vector om de tweede kolom van Q te verkrijgen.
Laten we de vergelijking voor een projectie bekijken. De projectie is de matrix die a maal a-transpose is gedeeld door de scalair a-transpose maal a, vermenigvuldigd met b.
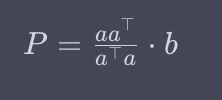
Of, alternatief:
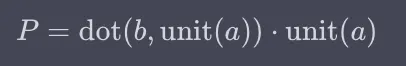
We vragen ons misschien af: hoe zijn deze twee methoden hetzelfde? Als we naar de eerste vergelijking hierboven kijken, berekent het deel links van b een matrix die in essentie de richting vastlegt die wordt gedefinieerd door vector a en de schaalfactor voor die richting. Dit lijkt op het berekenen van de eenheidsvector van a in de inproductmethode.
De volgende R-code berekent de projectie van de vector col_2 op de vector q1 met behulp van de inproductmethode.
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
Zoals we in de bovenstaande code zien, omvat het construeren van de tweede orthogonale vector en de bijbehorende kolom van de matrix Q een proces van projectie, aftrekking en normalisatie. De basisstappen lijken op het maken van de eerste kolom van Q, maar ze zijn net anders en iets uitgebreider: we halen eerst de tweede kolom van A op; we maken vervolgens een projectie op de eerste vector van Q; daarna trekken we de projectie af van de tweede kolom van A; vervolgens voeren we normalisatie uit; en tot slot creëren we de tweede kolom van Q.
We kunnen deze tweede stap voor q3 herhalen tot en met de laatste kolom. In ons geval vormen de orthogonale vectoren q1, q2 en q3 de basis van de orthogonale matrix Q. Deze vectoren zijn essentieel omdat ze de basis vormen om de oorspronkelijke gegevens in een nieuw coördinatenstelsel uit te drukken.
Hier zien we dat het Gram-Schmidt-proces iteratief is en ervoor zorgt dat elke opeenvolgende vector orthogonaal is aan de voorgaande. We herinneren ons ook dat orthogonaliteit betekent dat het inproduct van twee vectoren nul is, wat aangeeft dat ze loodrecht op elkaar staan in de vectorruimte. Laten we de orthogonaliteit van q1 en q2 bevestigen met hun inproduct:
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16Nu we onze Q-matrix hebben, moeten we de R-matrix construeren. De R-matrix in QR-decompositie bevat informatie over de relaties tussen de kolommen van de orthogonale matrix Q en de oorspronkelijke dataset. Het is een bovendriehoeksmatrix en elk element van het bovendriehoekige deel van R wordt verkregen door het inproduct te berekenen van de overeenkomstige kolommen van Q en de oorspronkelijke data.
Om de bovendriehoeksmatrix R te construeren, moeten we de inproducten berekenen van elke kolom van Q met elke kolom van de oorspronkelijke dataset. Dit resulteert in een matrix met evenveel rijen als het aantal kolommen in Q, en die bovendriehoekig is dankzij ons eerdere proces.
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
We zien dat de uitvoer van onze R-matrix er dit keer wat anders uitziet. Dat komt doordat de functie qr() Householder-reflecties gebruikt met meer numerieke stabiliteit dan het door onszelf geïnspireerde Gram-Schmidt-proces.
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
We kunnen de reconstructie verifiëren door Q en R te vermenigvuldigen en te zien dat we matrix_A terugkrijgen. Hier staat %*% voor matrixvermenigvuldiging in R.
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109Leren met DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

