
Kurs
Lineare Algebra für Data Science in R
4 Std.
21.6K
Die QR-Zerlegung ist eine grundlegende Matrixfaktorisierung, die in vielen Bereichen der Data Science und des Machine Learnings eingesetzt wird. Weil sie komplexe Matrizen in einfachere Bestandteile zerlegt, ist sie unverzichtbar, um Probleme der Linearen Algebra zu lösen und die Stabilität von Algorithmen zu verbessern.
Egal, ob du eine lineare Regression mit Ordinary Least Squares durchführst oder Recommendation Engines in Python oder PySpark baust – ein solides Verständnis der QR-Zerlegung erweitert deine Möglichkeiten im Umgang mit großen Datensätzen und komplexen mathematischen Modellen spürbar.
Bei der Faktorisierung, also Zerlegung, einer Matrix wird diese als Produkt aus zwei oder mehr Matrizen dargestellt. Anders ausgedrückt: Durch Matrixfaktorisierung zerlegst du eine Matrix in einfachere Komponenten, die bei der Matrixmultiplikation wieder die ursprüngliche Matrix ergeben. Wir interessieren uns dafür, weil sie viele Probleme der Linearen Algebra vereinfacht und dadurch leichter lösbar macht.
Die QR-Zerlegung ist eine spezielle Form der Matrixfaktorisierung, bei der eine Matrix als Produkt aus einer orthogonalen Matrix Q und einer oberen Dreiecksmatrix R dargestellt wird. Üblich ist die Gleichung A = QR.
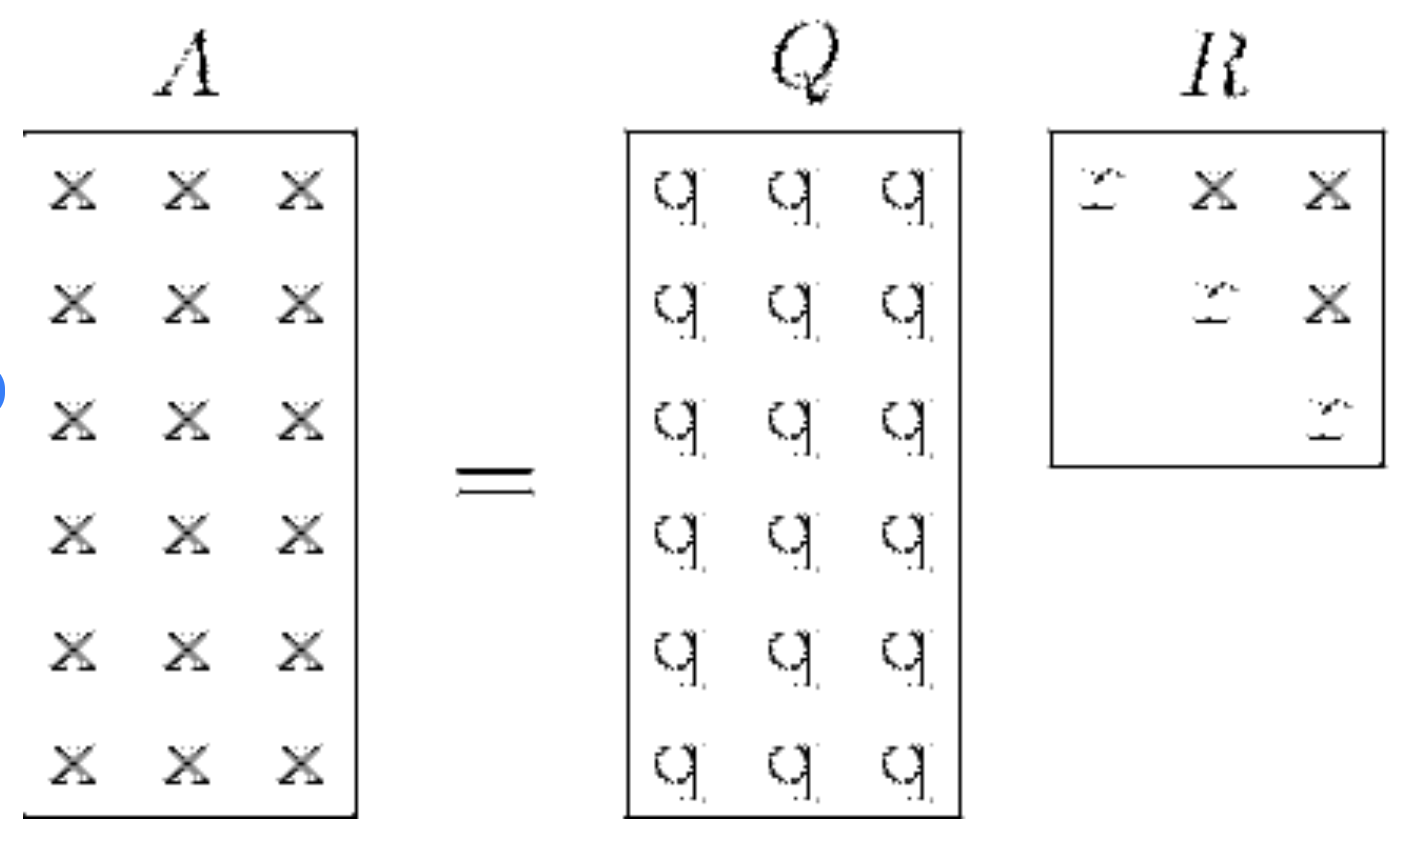
QR-Zerlegung visualisiert. Quelle: ResearchGate
Um die QR-Zerlegung zu verstehen, ist wichtig zu wissen, dass die Multiplikation von Matrizen in der Linearen Algebra nicht den intuitiven Regeln der Skalarmultiplikation folgt. Insbesondere ist die Matrizenmultiplikation nicht kommutativ, das heißt, AB ≠ BA gilt im Allgemeinen – „Umkehren“ ist daher deutlich komplexer.
Schauen wir uns die beiden wichtigen Matrizen Q und R an.
Eine orthogonale Matrix Q ist dadurch gekennzeichnet, dass ihre Transponierte zugleich ihre Inverse ist: mathematisch QTQ = QQT = I, wobei I die Einheitsmatrix ist. Transponieren bedeutet hier, die Matrix an ihrer Diagonalen zu spiegeln.
Außerdem bilden die Spalten einer orthogonalen Matrix eine Orthonormalbasis. Das heißt: Erstens sind die Spalten orthogonal, also ist das Skalarprodukt zweier verschiedener Spalten gleich Null. Zweitens hat jede Spalte die Länge eins (Einheitslänge).
Mit orthogonalen Matrizen arbeitet es sich gut, weil sie Vektorlängen und Skalarprodukte erhalten. Multiplizierst du einen Vektor mit einer orthogonalen Matrix, bleibt seine Länge gleich. Multiplizierst du zwei Vektoren mit derselben orthogonalen Matrix, bleibt auch ihr Skalarprodukt gleich. Da orthogonale Matrizen Längen und Skalarprodukte erhalten, verzerren sie die Geometrie der Vektoren nicht: Sind zwei Vektoren vor der Transformation rechtwinklig, bleiben sie es auch danach.
Eine obere Dreiecksmatrix R ist eine Matrix, bei der alle Elemente unterhalb der Hauptdiagonalen Null sind. Diese Form vereinfacht Matrixgleichungen und ist besonders nützlich, um lineare Gleichungssysteme per Rückwärtssubstitution oder ähnlichen Verfahren zu lösen. In der QR-Zerlegung repräsentiert R gewissermaßen den Anteil, der Größe und Ausrichtung der ursprünglichen Matrix einfängt.
Werfen wir kurz einen Blick auf gängige Verfahren für die QR-Zerlegung.
Das Gram-Schmidt-Verfahren wandelt eine Menge linear unabhängiger Vektoren systematisch in eine orthonormale Menge um. Es dient speziell dazu, die Matrix Q in der QR-Zerlegung zu konstruieren; daraus lässt sich anschließend R ableiten.
Givens-Rotationen sind ein weiteres Verfahren für die QR-Zerlegung. Dabei wird eine Folge von Ebenenrotationen angewandt, um Nullen unterhalb der Diagonalen von A zu erzeugen. Jede Rotation wirkt auf ein Koordinatenpaar, erhält die Vektorlänge und transformiert die Matrix schrittweise in eine obere Dreiecksform. Für dünn besetzte Matrizen ist das effizient, da pro Schritt nur wenige Elemente verändert werden.
Householder-Reflexionen verwenden Reflexionsmatrizen (Householder-Matrizen), um systematisch die Elemente unterhalb der Diagonalen von A zu eliminieren. Jede Householder-Matrix spiegelt an einer Ebene, die orthogonal zu einem Vektor steht, mit dem die jeweilige Spalte unterhalb der Diagonalen auf Null gesetzt wird. Das Ergebnis sind eine orthogonale Matrix Q und eine obere Dreiecksmatrix R. Für dicht besetzte Matrizen sind Householder-Reflexionen besonders gut geeignet, weil sie numerisch stabil sind.
In diesem Abschnitt üben wir die QR-Zerlegung in R: Zuerst nutzen wir die eingebaute Funktion qr() für eine schnelle Implementierung und gehen danach den Prozess mit dem Gram-Schmidt-Verfahren von Grund auf durch, um das Verständnis zu vertiefen. Beginnen wir mit der Erstellung von matrix_A, die wir in beiden Teilen verwenden.
matrix_A <- matrix(c(21, 21, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19.2, 17.8, 16.4, 17.3, 15.2, 10.4, 10.4, 14.7, 32.4, 30.4, 33.9, 21.5, 15.5, 15.2, 13.3, 19.2, 27.3, 26, 30.4, 15.8, 19.7, 15, 21.4,
              2.62, 2.875, 2.32, 3.215, 3.44, 3.46, 3.57, 3.19, 3.15, 3.44, 3.44, 4.07, 3.73, 3.78, 5.25, 5.424, 5.345, 2.2, 1.615, 1.835, 2.465, 3.52, 3.435, 3.84, 3.845, 1.935, 2.14, 1.513, 3.17, 2.77, 3.57, 2.78,
              110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, 180, 180, 205, 215, 230, 66, 52, 65, 97, 150, 150, 245, 175, 66, 91, 113, 264, 175, 335, 109),
            nrow = 32, ncol = 3, byrow = FALSE)

# Add column names
colnames(matrix_A) <- c("column_1", "column_2", "column_3")Die Faktorisierung lässt sich in einem Schritt mit qr() durchführen. Wir weisen das Ergebnis einem Objekt qr_decomp zu – einer Liste, die die QR-Zerlegung enthält.
# Perform and Display the QR decomposition
(qr_decomp <- qr(matrix_A))
Greifen wir auf die Komponente rank des QR-Objekts zu, sehen wir die Anzahl linear unabhängiger Spalten der zerlegten Matrix. Die Ausgabe zeigt den Rang drei – es gibt also drei linear unabhängige Spalten, wie erwartet. Über die Komponente pivot sehen wir Informationen zur während der Zerlegung verwendeten Spaltenpermutation. Die Ausgabe zeigt, dass keine Permutation stattfand, da die Pivot-Indizes der ursprünglichen Spaltenreihenfolge entsprechen.
qr_decomp$rank
qr_decomp$pivot
[1] 3
[1] 1 2 3Als Nächstes können wir die Matrizen Q und R mit qr.Q() bzw. qr.R() extrahieren. In der Ausgabe sehen wir, dass Q rechteckig ist und R quadratisch mit Nullen unterhalb der Diagonalen.
# Extract and Display the Q and R matrices
(Q_matrix <- qr.Q(qr_decomp))
(R_matrix <- qr.R(qr_decomp))
[,1] [,2] [,3]
[1,] -0.17721481 0.023462372 -0.015872336
[2,] -0.17721481 -0.001889138 -0.060272525
[3,] -0.19240465 0.077625112 -0.019039920
[4,] -0.18059033 -0.030282834 -0.118470211
[5,] -0.15780557 -0.089157964 0.064671266
[6,] -0.15274229 -0.099258795 -0.187022354
[7,] -0.12067485 -0.161573766 0.277715036
[8,] -0.20590673 0.012764996 -0.275768785
[9,] -0.19240465 -0.004891570 -0.156509401
[10,] -0.16202497 -0.082397566 -0.117343880
[11,] -0.15021065 -0.101326680 -0.120852866
[12,] -0.13839633 -0.182888939 -0.033166125
[13,] -0.14599125 -0.136918208 0.028289904
[14,] -0.12826977 -0.170282764 0.014320506
[15,] -0.08776353 -0.381326588 -0.165554550
[16,] -0.08776353 -0.398625266 -0.160607236
[17,] -0.12405037 -0.332631845 -0.083208412
[18,] -0.27341714 0.219354877 -0.069242665
[19,] -0.25653954 0.250472633 -0.021737724
[20,] -0.28607534 0.275923528 -0.005454217
[21,] -0.18143421 0.045632512 -0.033447865
[22,] -0.13080141 -0.140377926 -0.045388530
[23,] -0.12826977 -0.135983661 -0.031340393
[24,] -0.11223605 -0.201937338 0.228196652
[25,] -0.16202497 -0.122661730 -0.004593473
[26,] -0.23037925 0.176744505 -0.035884026
[27,] -0.21940881 0.138786843 0.013273146
[28,] -0.25653954 0.260613237 0.211010230
[29,] -0.13333305 -0.101525496 0.418085457
[30,] -0.16624437 -0.009027316 0.183837006
[31,] -0.12658201 -0.152109209 0.596664759
[32,] -0.18059033 0.012963861 -0.046253102 column_1 column_2 column_3
[1,] -118.5003 -16.11602 -711.9200
[2,] 0.0000 -10.05857 -496.9319
[3,] 0.0000 0.00000 283.7369Zum Schluss können wir – aus Neugier – nachsehen, welches Verfahren qr() zur Zerlegung verwendet.
?qrIn der Hilfe steht unter anderem Folgendes:
The function computes the QR decomposition of a matrix using the LINPACK or LAPACK routine dgeqrf.Ein Blick in die FORTRAN-Dokumentation zeigt: dgeqrf ist eine LAPACK-Routine, die Householder-Transformationen verwendet.
Versuchen wir zu verstehen, was qr() tut, indem wir keine identische Implementierung, aber eine ähnliche Idee selbst nachbauen – entlang des Gram-Schmidt-Verfahrens. Ziel ist hier nicht, eine exakte Methode zu reproduzieren, sondern unser Verständnis zu schärfen.
Um mit dem Gram-Schmidt-Verfahren unsere Q-Matrix zu erstellen, normalisieren wir zunächst die erste Spalte der Daten – das wird die erste Spalte von Q. Das Ziel ist, die Vektoren der Matrix A in neue Vektoren mit Einheitslänge umzuwandeln und sicherzustellen, dass diese Vektoren paarweise orthogonal sind.
Für die erste Spalte von Q extrahieren wir die erste Spalte von A, berechnen die euklidische Norm und normalisieren anschließend.
Zur Erinnerung: Die euklidische Norm misst die Länge bzw. den Betrag eines Vektors im euklidischen Raum. Man kann sie als Abstand vom Ursprung zur Vektorspitze verstehen, wenn die Vektorelemente als Koordinaten im mehrdimensionalen Raum betrachtet werden. Für einen Vektor v = [v1,v2,…,vn] berechnet sie sich wie folgt:
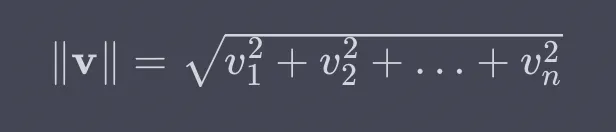
In R quadrieren wir dazu die Spalte, summieren, ziehen die Wurzel und normalisieren anschließend.
# Extract the first column of the subset data
col_1 <- matrix_A[, 1]

# Calculate the Euclidean norm of the first column
norm_col_1 <- sqrt(sum(col_1^2))

# Normalize and display the first column to get the first column of Q
(q1 <- col_1 / norm_col_1)
Als Zweites wiederholen wir aus der Linearen Algebra den Begriff der Projektion. Eine Projektion ist eine Abbildung, die einen Vektor auf einen Unterraum projiziert. Dieser Unterraum ist ein niedrigerdimensionaler Raum innerhalb des gesamten Vektorraums. Die Projektion ist derjenige Vektor im Unterraum, der dem ursprünglichen Vektor am nächsten liegt und zugleich orthogonal zum Unterraum ist.
Visualisieren wir das mit der folgenden Grafik: Die Projektion p ist der zu a nächstgelegene Punkt auf b und steht senkrecht auf b.
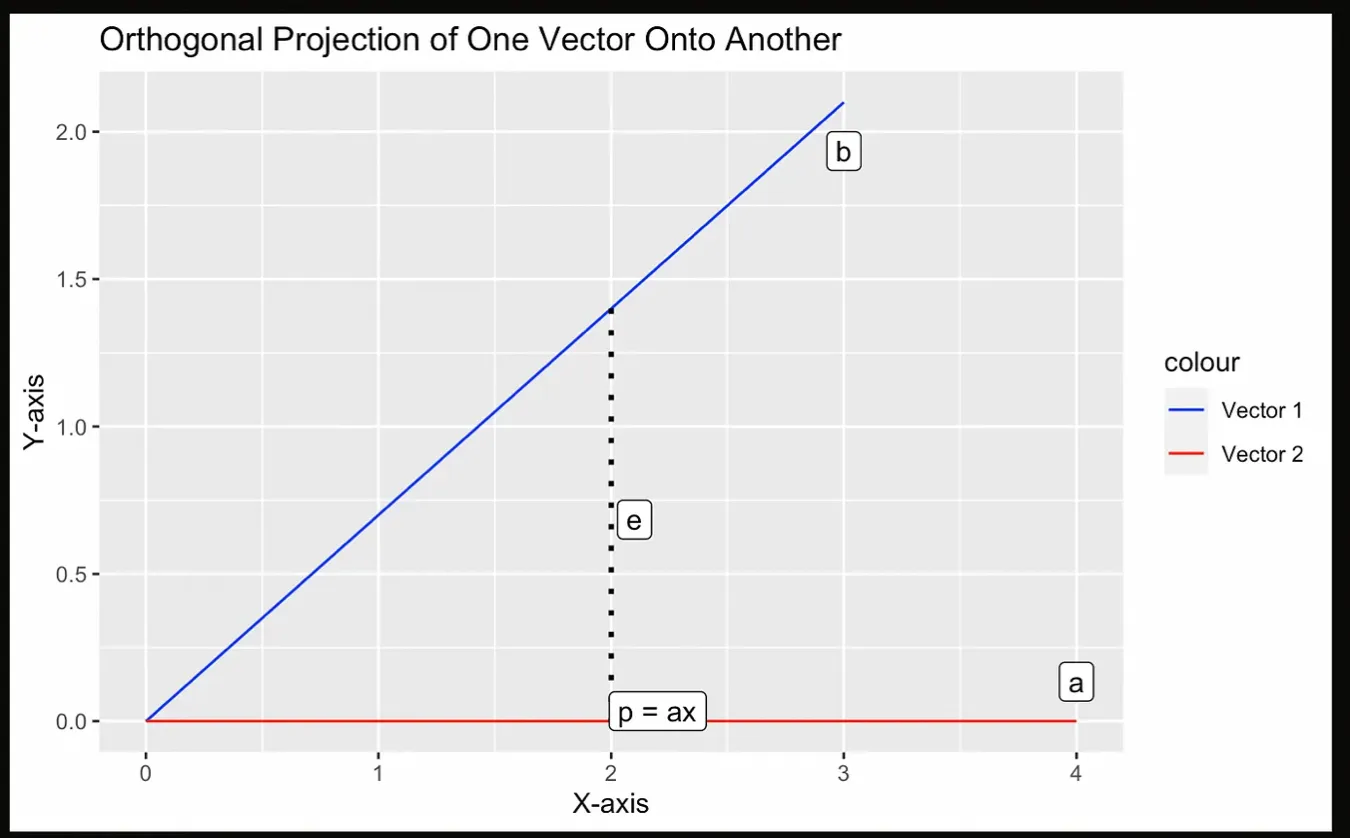
Illustration einer Projektion. Bild: Autorin/Autor.
Im nächsten Schritt der QR-Faktorisierung berechnen wir den zweiten orthogonalen Vektor: Zuerst projizieren wir die zweite Spalte von A auf die erste Spalte von Q und subtrahieren dieses Ergebnis von der zweiten Spalte von A. Der resultierende Vektor ist orthogonal zum ersten. Abschließend normalisieren wir ihn zur zweiten Spalte von Q.
Hier noch einmal die Gleichung für eine Projektion. Die Projektionsmatrix ist a mal a-Transponiert dividiert durch den Skalar a-Transponiert mal a, multipliziert mit b.
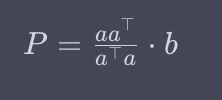
Oder alternativ:
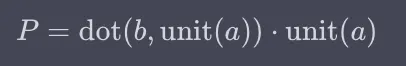
Wie sind beide Darstellungen äquivalent? In der ersten Gleichung berechnet der Teil links von b eine Matrix, die die von a definierte Richtung und deren Skalierung erfasst. Das entspricht in der Methode mit dem Skalarprodukt der Berechnung des Einheitsvektors von a.
Der folgende R-Code berechnet die Projektion des Vektors col_2 auf den Vektor q1 mithilfe des Skalarprodukts.
# Extract the second column of the subset data
col_2 <- matrix_A[, 2]

# Calculate the projection of col_2 onto q1
projection_col_2_q1 <- sum(col_2 * q1) * q1

# Calculate the second orthogonal vector
v2 <- col_2 - projection_col_2_q1

# Calculate the Euclidean norm of the second orthogonal vector
norm_v2 <- sqrt(sum(v2^2))

# Normalize the second orthogonal vector to get the second column of Q
q2 <- v2 / norm_v2
Wie du siehst, besteht die Konstruktion des zweiten orthogonalen Vektors und der entsprechenden Spalte von Q aus Projektion, Subtraktion und Normalisierung. Die Schritte ähneln der Erstellung der ersten Spalte – sind aber etwas aufwendiger: Wir extrahieren die zweite Spalte von A, projizieren auf den ersten Vektor von Q, subtrahieren die Projektion von der zweiten Spalte von A, normalisieren und erhalten so die zweite Spalte von Q.
Diesen zweiten Schritt wiederholen wir für q3 bis zur letzten Spalte. In unserem Fall bilden die orthogonalen Vektoren q1, q2 und q3 die Basis der orthogonalen Matrix Q. Sie sind zentral, weil sie die Grundlage schaffen, die Originaldaten in einem neuen Koordinatensystem auszudrücken.
Damit wird klar: Das Gram-Schmidt-Verfahren ist iterativ und stellt sicher, dass jeder nachfolgende Vektor zu allen vorherigen orthogonal ist. Orthogonalität bedeutet, dass das Skalarprodukt zweier Vektoren Null ist – sie stehen also rechtwinklig im Vektorraum. Prüfen wir die Orthogonalität von q1 und q2 per Skalarprodukt:
# Calculate the dot product of q1 and q2
dot_product_q1_q2 <- sum(q1 * q2)

# Print the dot product to confirm orthogonality
print(dot_product_q1_q2)
[1] 2.43295e-16Jetzt, wo wir Q haben, konstruieren wir R. In der QR-Zerlegung enthält R Informationen über die Beziehungen zwischen den Spalten der orthogonalen Matrix Q und den ursprünglichen Daten. R ist eine obere Dreiecksmatrix; jedes Element im oberen Dreieck entsteht als Skalarprodukt der jeweiligen Spalten von Q und den Originaldaten.
Zur Konstruktion der oberen Dreiecksmatrix R berechnen wir also die Skalarprodukte jeder Spalte von Q mit jeder Spalte des ursprünglichen Datensatzes. Dadurch erhalten wir eine Matrix mit so vielen Zeilen wie Q Spalten hat – und sie ist aufgrund des vorangegangenen Prozesses obertriangular.
matrix_A <- matrix_A %>% as.matrix()

# Calculate and display the R matrix by multiplying Q^T and the subset data
R_matrix <- t(Q_matrix) %*% matrix_A
Die Ausgabe unserer R-Matrix sieht diesmal etwas anders aus. Der Grund: qr() verwendet Householder-Reflexionen, die numerisch stabiler sind als unser Gram-Schmidt-inspiriertes Vorgehen.
         column_1      column_2  column_3
[1,] -1.185003e+02 -1.611602e+01 -711.9200
[2,]  5.814446e-16 -1.005857e+01 -496.9319
[3,]  7.633287e-15  1.338669e-15  283.7369
Wir können die Rekonstruktion prüfen, indem wir Q und R multiplizieren und so wieder matrix_A erhalten. Dabei steht %*% in R für Matrixmultiplikation.
Q_matrix %*% R_matrix column_1 column_2 column_3
[1,] 21.0 2.620 110
[2,] 21.0 2.875 110
[3,] 22.8 2.320 93
[4,] 21.4 3.215 110
[5,] 18.7 3.440 175
[6,] 18.1 3.460 105
[7,] 14.3 3.570 245
[8,] 24.4 3.190 62
[9,] 22.8 3.150 95
[10,] 19.2 3.440 123
[11,] 17.8 3.440 123
[12,] 16.4 4.070 180
[13,] 17.3 3.730 180
[14,] 15.2 3.780 180
[15,] 10.4 5.250 205
[16,] 10.4 5.424 215
[17,] 14.7 5.345 230
[18,] 32.4 2.200 66
[19,] 30.4 1.615 52
[20,] 33.9 1.835 65
[21,] 21.5 2.465 97
[22,] 15.5 3.520 150
[23,] 15.2 3.435 150
[24,] 13.3 3.840 245
[25,] 19.2 3.845 175
[26,] 27.3 1.935 66
[27,] 26.0 2.140 91
[28,] 30.4 1.513 113
[29,] 15.8 3.170 264
[30,] 19.7 2.770 175
[31,] 15.0 3.570 335
[32,] 21.4 2.780 109Überprüfe deine professionellen Fähigkeiten als Data Scientist.

Lerne mit DataCamp
Kurs
Kurs
Lernpfad