
Kursus
Bekerja dengan Hugging Face
2 jam
39K
Bagaimana jika siapa pun bisa menggunakan kecerdasan buatan tingkat lanjut, bukan hanya perusahaan teknologi besar? Inilah gagasan besar di balik Qwen, sebuah keluarga model AI baru yang dibuat oleh Alibaba Cloud.
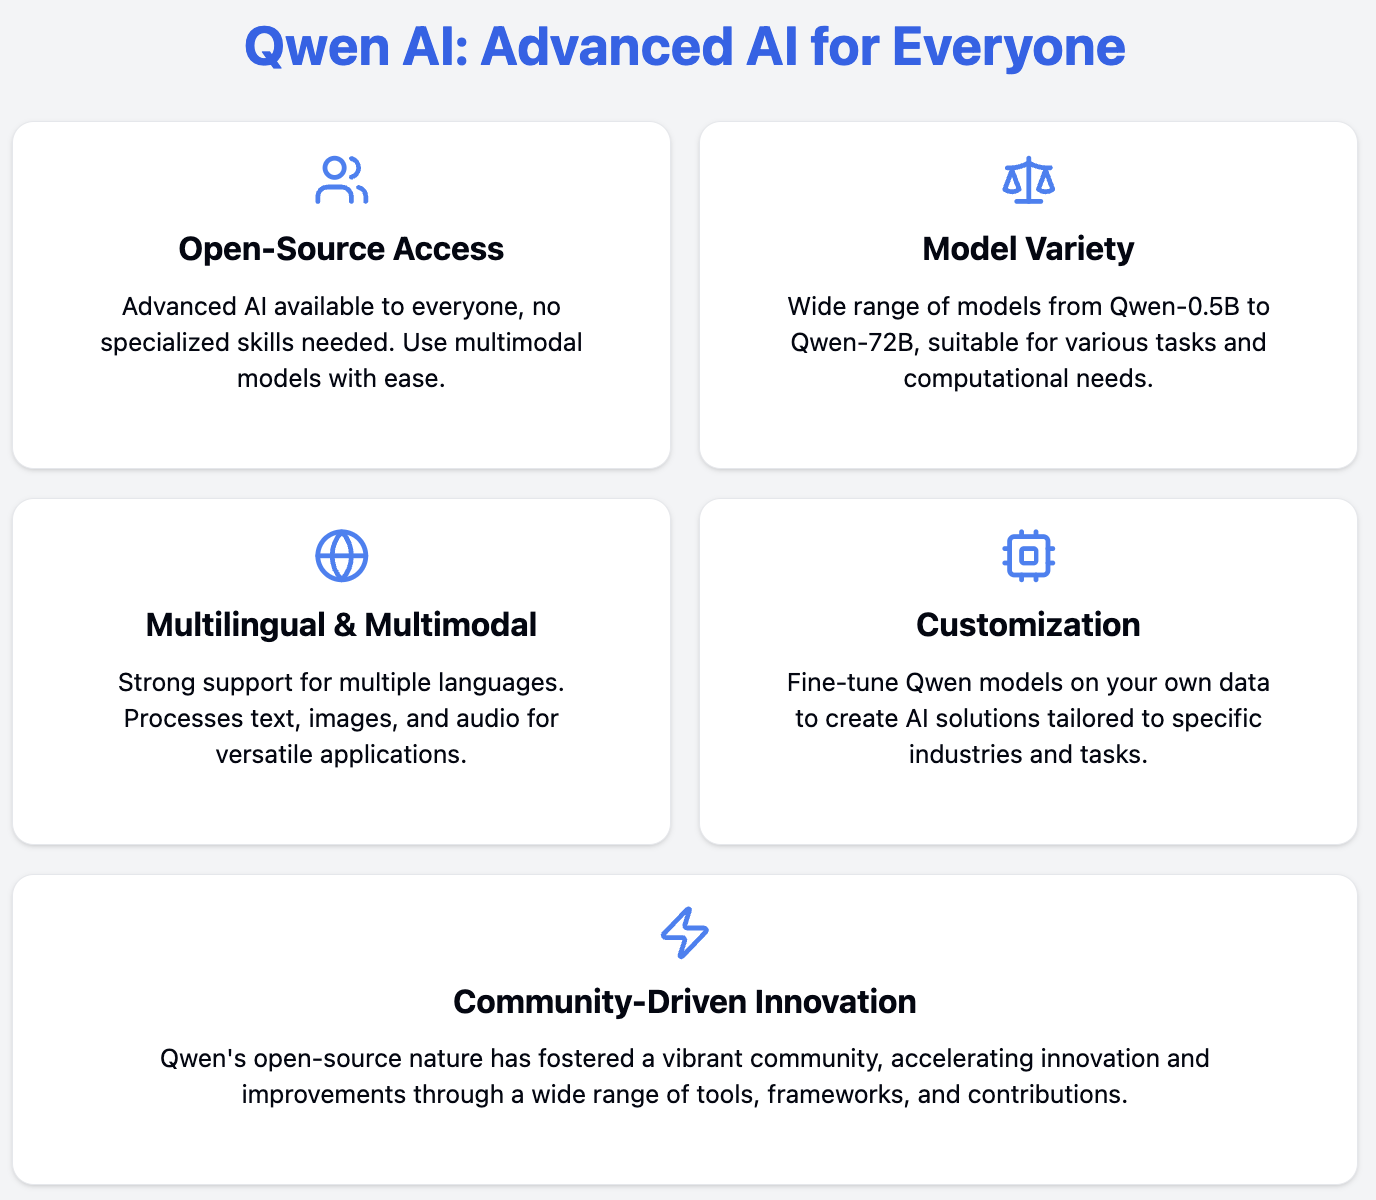
Qwen (singkatan dari Tongyi Qianwen) berupaya membuat model AI mudah diakses oleh semua orang dengan seperangkat alat AI buatan Alibaba Cloud. Qwen melakukan ini dengan menawarkan:
Dengan Qwen, Anda tidak membutuhkan sumber daya atau pengetahuan khusus sebanyak sebelumnya untuk menggunakan AI tingkat lanjut.
Dalam tutorial ini, kita akan:
Qwen adalah rangkaian model bertenaga yang dilatih pada dataset multibahasa dan multimodal skala besar. Dikembangkan oleh Alibaba Cloud, Qwen mendorong AI ke level baru, membuatnya lebih cerdas dan lebih berguna untuk pemrosesan bahasa alami, visi komputer, dan pemahaman audio.
Model-model ini mampu melakukan berbagai macam tugas, termasuk:
Model Qwen dilatih awal pada berbagai sumber data dan disempurnakan melalui pelatihan lanjutan pada data berkualitas tinggi.
Keluarga Qwen terdiri dari berbagai model khusus yang dirancang untuk kebutuhan dan kasus penggunaan yang berbeda.
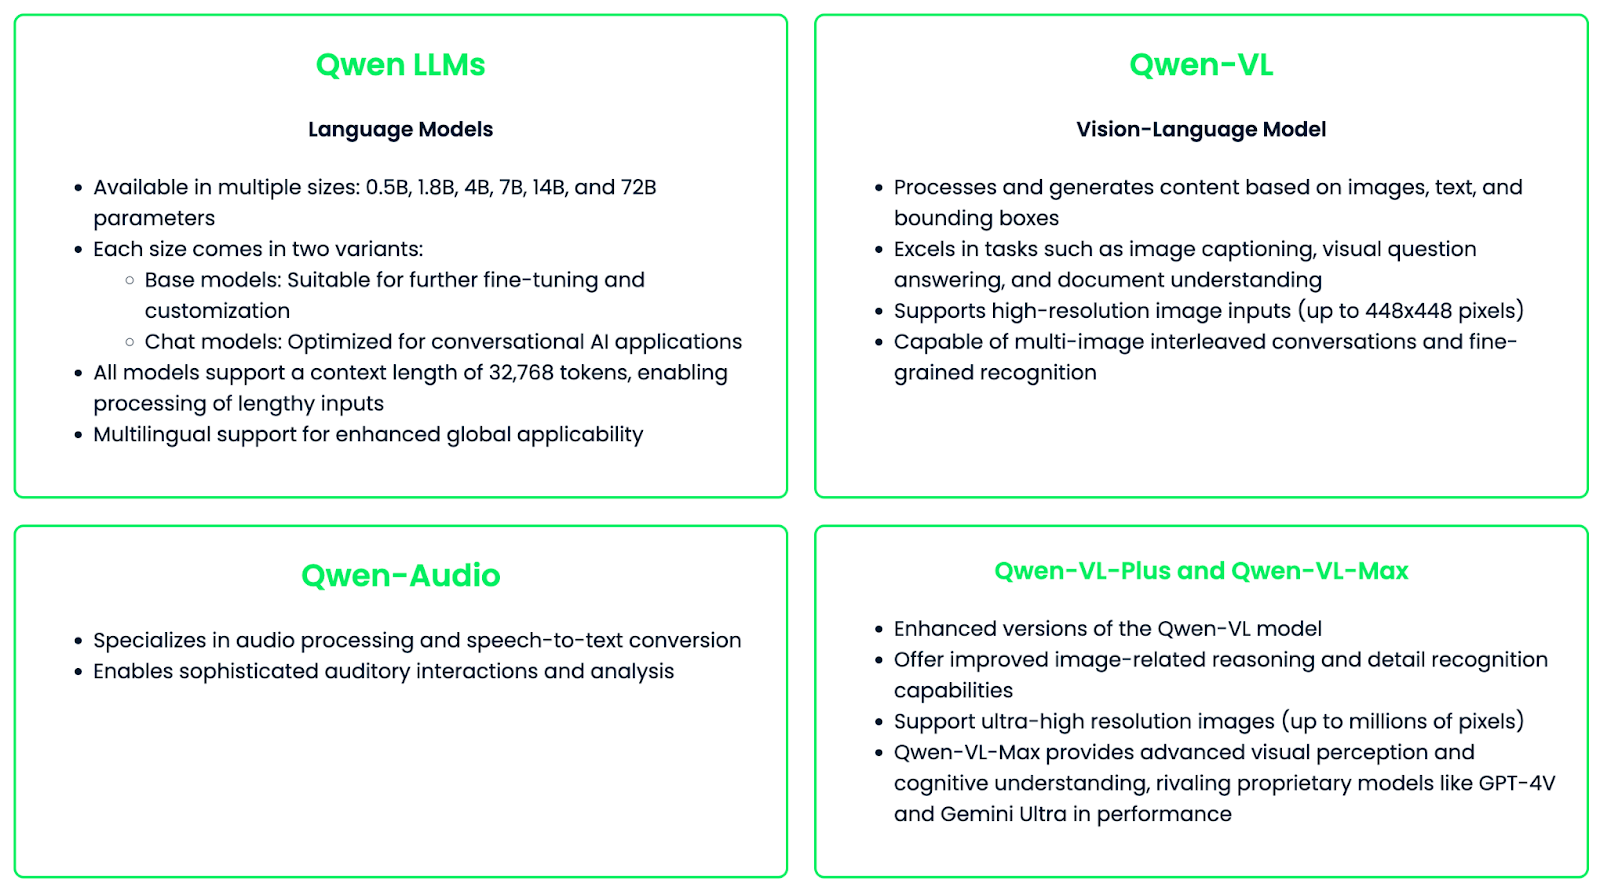
Keluarga model Qwen dirancang untuk fleksibilitas dan kemudahan kustomisasi, menawarkan fine-tuning untuk aplikasi atau industri tertentu. Fleksibilitas ini, dikombinasikan dengan kapabilitasnya yang kuat, menjadikan Qwen sumber daya yang sangat berharga untuk teknologi AI di berbagai bidang.
Keluarga model Qwen menyediakan alat yang kuat dan serbaguna untuk berbagai aplikasi AI. Mari kita telusuri fitur-fitur kunci yang membedakan Qwen:
Qwen unggul dalam pemahaman dan generasi multibahasa, dengan kemampuan kuat dalam bahasa Inggris dan Mandarin, serta dukungan untuk banyak bahasa lain. Model Qwen2 terbaru telah memperluas cakupan bahasanya mencakup 27 bahasa tambahan, meliputi kawasan seperti Eropa Barat, Eropa Timur dan Tengah, Timur Tengah, Asia Timur, dan Asia Selatan.
Dukungan bahasa yang luas ini memungkinkan Qwen memfasilitasi komunikasi lintas budaya, melakukan terjemahan berkualitas tinggi, menangani skenario alih kode, dan melayani aplikasi global dengan pembuatan konten terlokalisasi.
Model Qwen sangat mahir dalam berbagai tugas pembuatan teks. Beberapa aplikasi utama meliputi:
Kemampuan model untuk mempertahankan konteks pada urutan panjang (hingga 32.768 token) memungkinkan pembuatan keluaran teks yang panjang dan koheren.
Qwen juga unggul dalam tanya jawab faktual maupun terbuka. Fitur ini memungkinkan:
Dengan model Qwen-VL, keluarga Qwen memperluas kemampuannya ke tugas multimodal yang melibatkan gambar. Fitur utama meliputi:
Salah satu fitur paling signifikan dari Qwen adalah sifatnya yang open-source, yang membawa sejumlah manfaat bagi komunitas AI:
Pendekatan open-source telah menghasilkan dukungan luas dari proyek dan alat pihak ketiga:
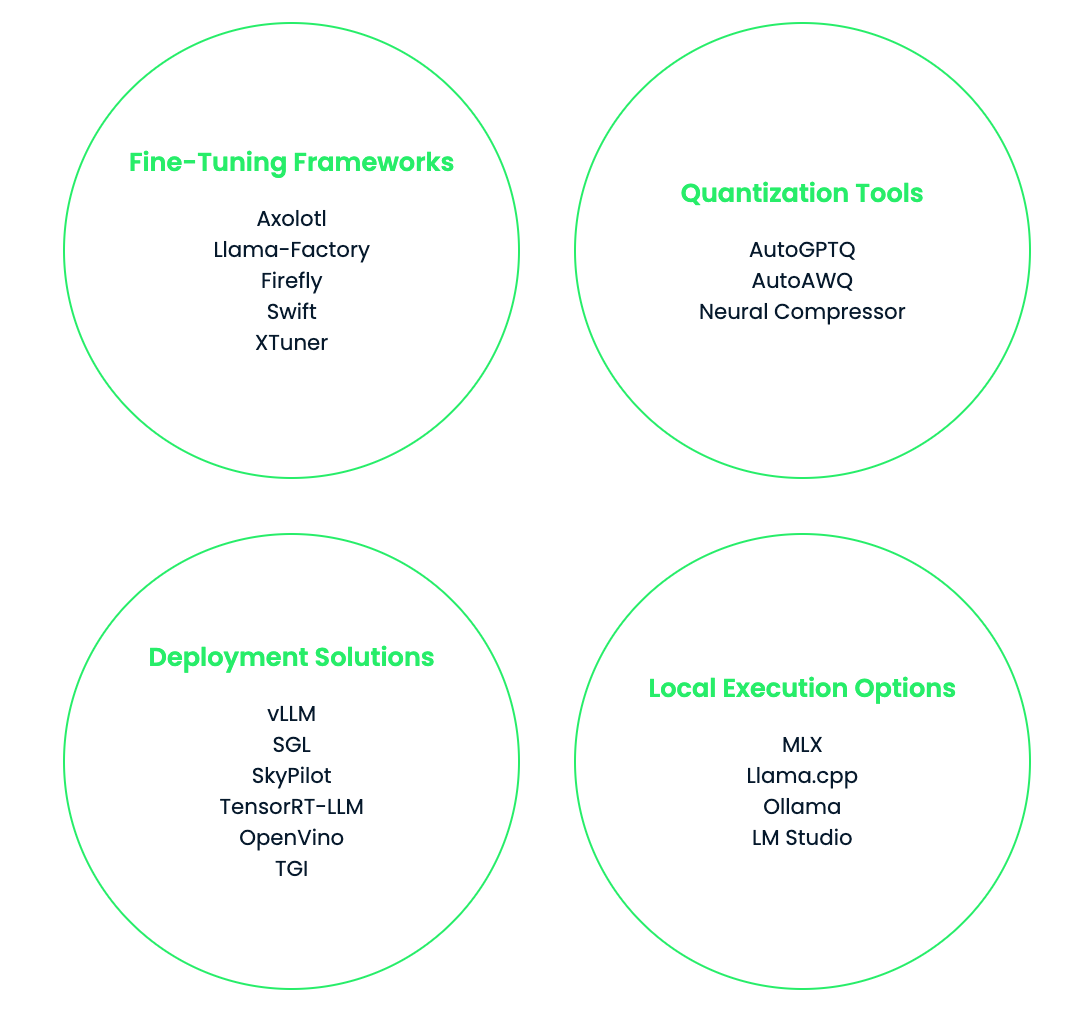
Sekarang setelah Anda memahami Qwen dan fitur utamanya, saatnya mempelajari cara menggunakannya secara praktis!
Model Qwen tersedia di beberapa platform, sehingga sangat mudah diakses untuk berbagai kasus penggunaan.
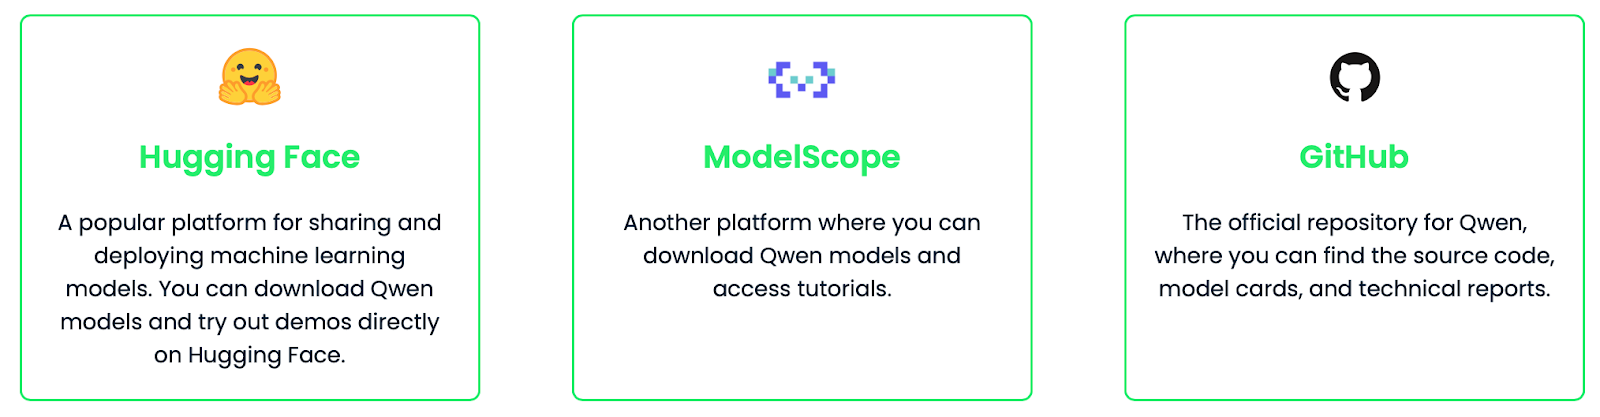
Di bagian ini, saya akan memandu Anda menggunakan model bahasa Qwen-7B melalui Hugging Face. Kita akan membahas penyiapan lingkungan, masuk ke Hugging Face, dan menjalankan model.
Pertama, pasang pustaka yang diperlukan:
pip install transformers torch huggingface_hubUntuk mengakses model Qwen-7B, Anda perlu masuk ke akun Hugging Face. Ini diperlukan karena beberapa model mungkin memiliki pembatasan penggunaan, tetapi Anda tetap dapat mengakses model privat milik Anda sendiri atau organisasi Anda. Ini membantu memantau penggunaan API dan menerapkan pembatasan laju jika diperlukan.
Untuk masuk, ikuti langkah-langkah ini:
1. Kunjungi Hugging Face.
2. Buka pengaturan profil Anda dan buat token akses.
3. Di terminal Anda, jalankan:
huggingface-cli login4. Saat diminta, masukkan token akses Anda.
Sekarang, kita akan membuat file Python atau file Jupyter Notebook tempat kita mulai menulis kode.
Pertama, kita akan mengimpor dua kelas dari pustaka transformers:
AutoModelForCausalLM: Kelas ini secara otomatis memilih arsitektur model yang sesuai berdasarkan nama model yang Anda berikan.AutoTokenizer: Kelas ini memuat tokenizer yang tepat untuk model yang Anda gunakan.from transformers import AutoModelForCausalLM, AutoTokenizerSekarang, kita menentukan model mana yang ingin digunakan. "Qwen/Qwen-7B" mengacu pada versi 7 miliar parameter dari model Qwen yang dihosting di Hugging Face model hub, tetapi silakan gunakan model Qwen lainnya.
model_name = "Qwen/Qwen-7B"Selanjutnya, kita perlu memuat tokenizer.
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)Baris ini memuat tokenizer yang terkait dengan model Qwen-7B. Parameter trust_remote_code=True diperlukan karena model Qwen mungkin membutuhkan eksekusi kode kustom saat pemuatan.
Langkah berikutnya adalah memuat model.
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)Ini memuat model Qwen-7B yang sesungguhnya. Sekali lagi, kita menggunakan trust_remote_code=True untuk mengizinkan dijalankannya kode kustom yang terkait dengan model.
Setelah kita memuat model, kita dapat mengujinya dengan menghasilkan teks berdasarkan masukan tertentu.
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
Di sini, kita menyiapkan masukan untuk model:
input_text sebagai prompt.return_tensors="pt" menentukan bahwa keluaran yang diinginkan adalah tensor PyTorch.Sekarang, kita menghasilkan teks:
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
Baris kode pertama memberi tahu model untuk menghasilkan teks:
inputs yang sudah ditokenisasi ke metode generate.**inputs membuka kamus yang dikembalikan oleh tokenizer.max_new_tokens=50 membatasi generasi hingga maksimal 50 token baru.generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)Langkah ini mengonversi keluaran model (dalam format ID token) kembali menjadi teks yang dapat dibaca:
outputs memilih urutan pertama dan satu-satunya (dalam kasus ini) yang dihasilkan.skip_special_tokens=True memberi tahu decoder untuk mengabaikan token khusus seperti padding atau token akhir urutan.Terakhir, kita mencetak teks yang dihasilkan untuk melihat hasilnya.
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…Berikut beberapa catatan dan kiat yang berguna:
trust_remote_code=True diperlukan untuk model Qwen karena mereka membutuhkan kode kustom agar berjalan dengan benar.Model Qwen dapat dideploy menggunakan Platform for AI (PAI) dan Elastic AI Serving (EAS) dari Alibaba Cloud. Mari lihat bagaimana Anda dapat mendeploy model Qwen hanya dalam beberapa klik:
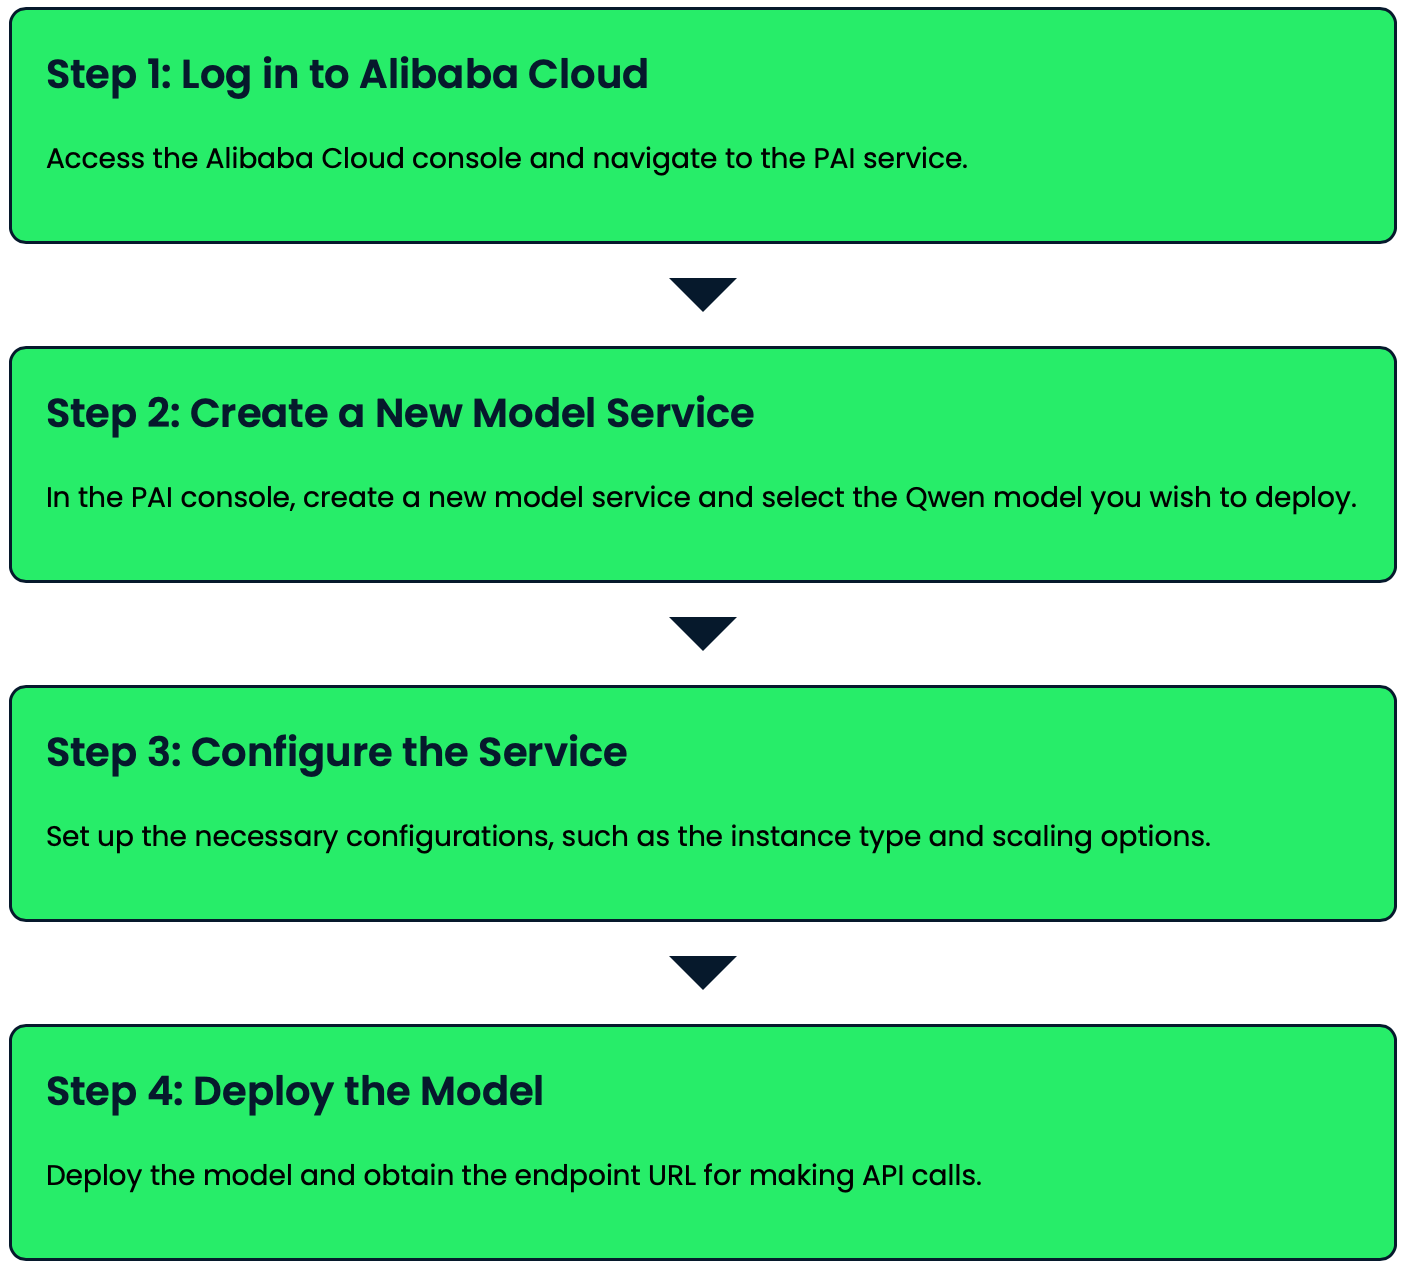
Mari kita jelajahi beberapa contoh praktis penggunaan Qwen untuk tugas pembuatan teks dan tanya jawab.
Qwen sangat andal menghasilkan teks yang koheren dan relevan secara kontekstual berdasarkan prompt yang diberikan. Mari lihat beberapa contoh:
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen dapat digunakan untuk menjawab berbagai pertanyaan, dari yang faktual hingga yang lebih terbuka atau analitis. Berikut beberapa contoh:
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.Contoh-contoh ini menunjukkan bagaimana Qwen dapat menangani berbagai jenis tugas pembuatan teks dan tanya jawab.
Anda dapat menyesuaikan parameter seperti max_new_tokens dan temperature untuk mengendalikan panjang dan kreativitas respons yang dihasilkan agar sesuai dengan kebutuhan spesifik Anda.
Fine-tuning model Qwen memungkinkan Anda mengadaptasinya untuk tugas tertentu, yang berpotensi meningkatkan kinerjanya untuk kasus penggunaan Anda. Proses ini melibatkan pelatihan model pralatih pada dataset kustom, sehingga model dapat mempelajari pengetahuan khusus tugas sambil mempertahankan kemampuan pemahaman bahasanya yang umum.
Di bagian ini, kita akan melalui proses fine-tuning model Qwen-7B pada dataset kustom. Kita akan menggunakan teknik fine-tuning yang efisien agar proses ini tetap terjangkau, bahkan untuk model besar. Dalam contoh kita, kita melakukan fine-tuning untuk meningkatkan kinerja pada tugas penerjemahan dan menjawab pertanyaan faktual. Proses ini memungkinkan model belajar dari dataset kustom sambil mempertahankan kemampuan pemahaman bahasa umumnya.
Sebelum mulai, pastikan Anda telah memasang hal berikut:
pip install datasets torch accelerate peftPertama, siapkan dataset Anda dalam format JSON. Setiap entri harus memiliki kolom "prompt" dan "completion". Simpan sebagai custom_dataset.json. Kita akan menggunakan contoh berikut:
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]Sekarang kita menambahkan impor berikut:
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelSelanjutnya, kita akan mendefinisikan fungsi untuk memproses dataset dan memuatnya menggunakan pustaka datasets dari Hugging Face:
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)Untuk membuat fine-tuning lebih efisien, kita akan menggunakan LoRA (Low-Rank Adaptation). Teknik ini memungkinkan kita melakukan fine-tuning model besar dengan lebih sedikit parameter:
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)Sekarang, kita akan menyiapkan argumen pelatihan yang mengendalikan berbagai aspek proses fine-tuning:
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)Dengan dataset dan argumen pelatihan yang sudah siap, kita sekarang dapat membuat objek Trainer dan memulai proses fine-tuning:
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()Setelah fine-tuning selesai, kita akan menyimpan model agar dapat digunakan nanti:
trainer.save_model("./fine_tuned_qwen")Fine-tuning model Qwen-7B pada dataset kustom Anda akan meningkatkan kinerjanya pada tugas-tugas yang serupa dengan data pelatihan Anda. Dalam kasus ini, model seharusnya lebih baik dalam menerjemahkan bahasa Inggris ke Prancis dan menjawab pertanyaan faktual tentang ibu kota negara.
Setelah fine-tuning, Anda dapat menggunakan model untuk inferensi:
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !Berikut beberapa kiat yang perlu dipertimbangkan untuk fine-tuning yang efektif:
Fine-tuning Qwen pada dataset kustom Anda memungkinkan pembuatan model khusus yang unggul pada tugas spesifik Anda sambil mempertahankan pengetahuan dan kapabilitas luas dari model pralatih asli. Pendekatan ini memanfaatkan kekuatan model bahasa besar untuk aplikasi dan domain unik Anda.
Seiring Qwen terus berkembang, kita dapat mengantisipasi beberapa perkembangan menarik:
Saat kita menutup eksplorasi tentang Qwen, jelas bahwa alat AI ini mewakili lompatan besar menuju AI yang mudah diakses, kuat, dan serbaguna. Qwen lebih dari sekadar rangkaian model AI yang bertenaga—ia mewakili visi untuk membuat AI tingkat lanjut dapat diakses dan dapat diadaptasi oleh semua orang. Dengan menyediakan alat-alat ini sebagai sumber terbuka, Alibaba Cloud mendorong inovasi dan kemajuan teknologi AI.
Jika Anda ingin mengikuti perkembangan terbaru di bidang AI, saya merekomendasikan artikel berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




