Khóa học
Làm việc với Hugging Face
2 giờ
40K
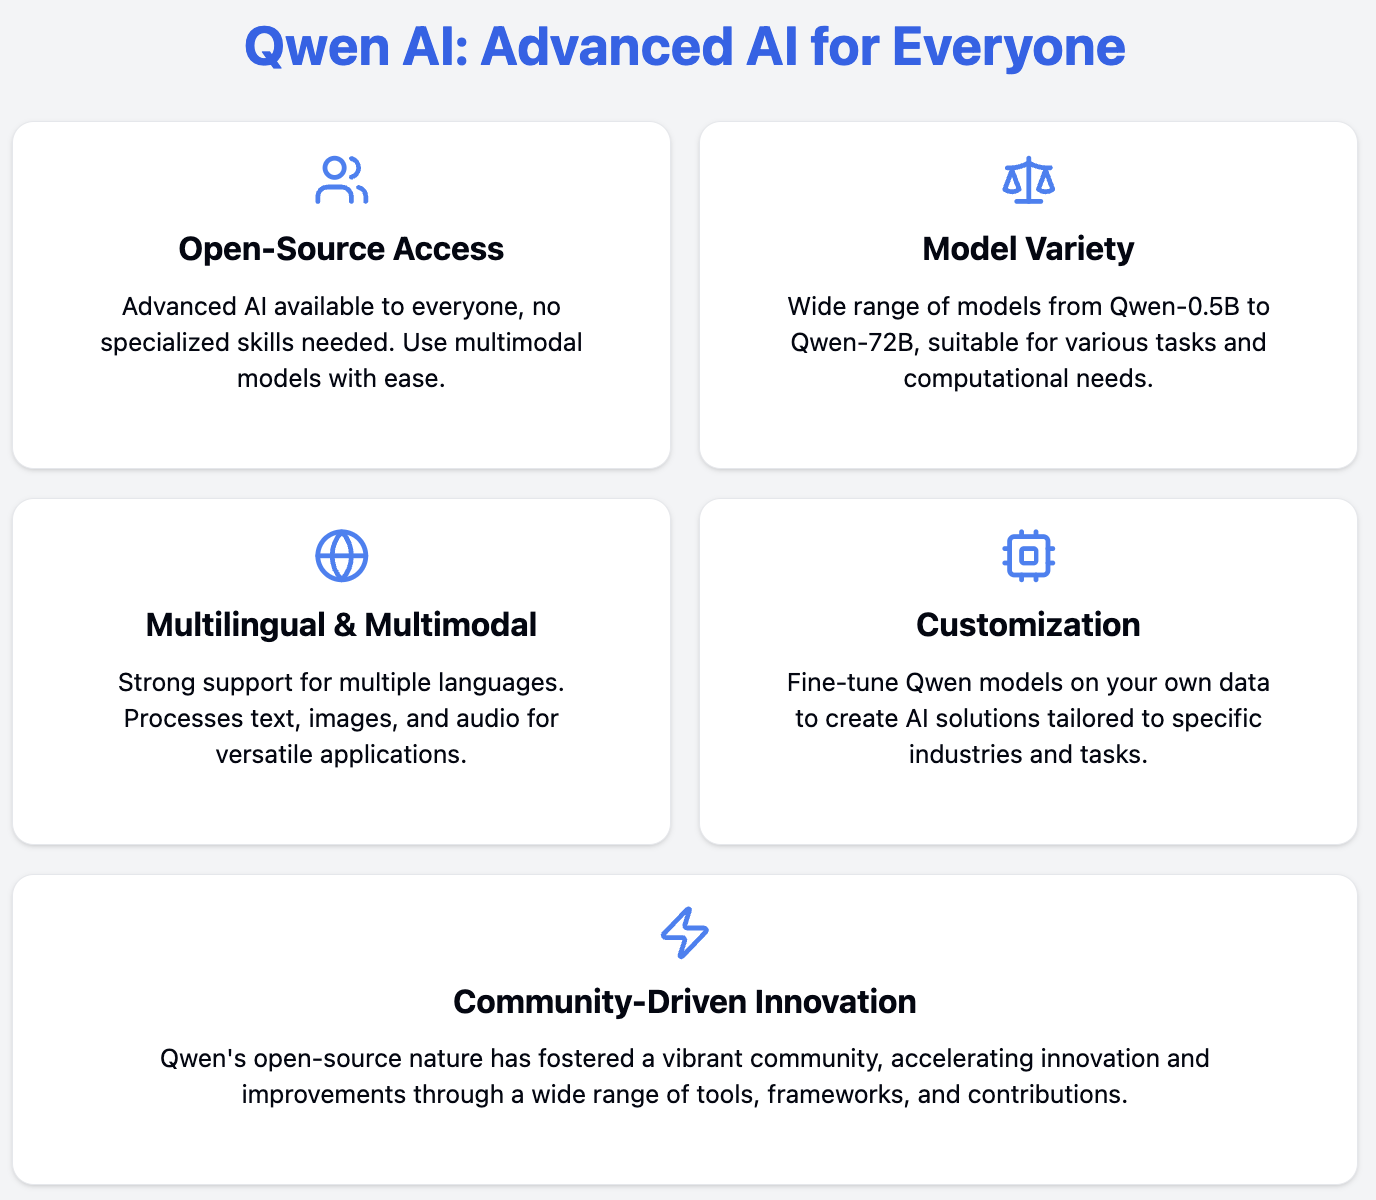
Điều gì sẽ xảy ra nếu bất kỳ ai cũng có thể sử dụng trí tuệ nhân tạo tiên tiến, không chỉ các công ty công nghệ lớn? Đây là ý tưởng lớn đằng sau Qwen, một họ mô hình AI mới do Alibaba Cloud tạo ra.
Qwen (viết tắt của Tongyi Qianwen) đang cố gắng giúp mọi người dễ dàng tiếp cận mô hình AI thông qua một bộ công cụ AI do Alibaba Cloud xây dựng. Qwen làm điều này bằng cách cung cấp:
Với Qwen, bạn không cần quá nhiều tài nguyên hay kiến thức chuyên sâu để dùng AI tiên tiến.
Trong hướng dẫn này, chúng ta sẽ:
Qwen là một chuỗi mô hình mạnh mẽ được huấn luyện trên các bộ dữ liệu đa ngôn ngữ và đa phương thức khổng lồ. Được phát triển bởi Alibaba Cloud, Qwen đẩy AI lên tầm cao mới, giúp mô hình thông minh và hữu ích hơn cho xử lý ngôn ngữ tự nhiên, thị giác máy tính và hiểu âm thanh.
Các mô hình này có khả năng thực hiện nhiều tác vụ, bao gồm:
Các mô hình Qwen được tiền huấn luyện trên nhiều nguồn dữ liệu đa dạng và được tinh chỉnh sau huấn luyện trên dữ liệu chất lượng cao.
Gia đình Qwen bao gồm nhiều mô hình chuyên biệt được thiết kế cho các nhu cầu và trường hợp sử dụng khác nhau.
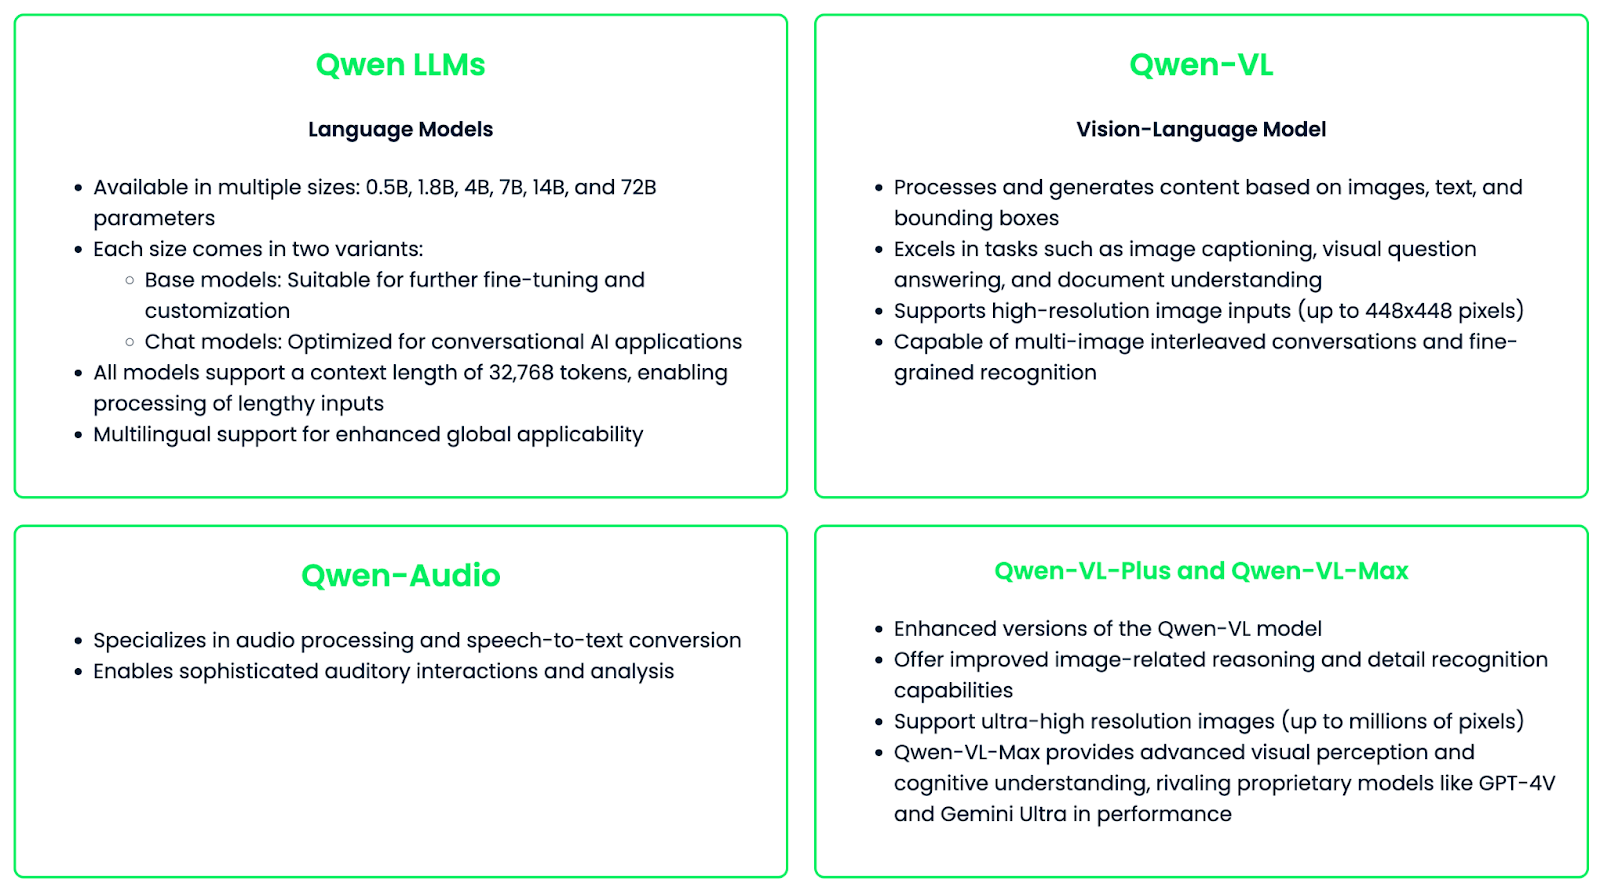
Họ mô hình Qwen được thiết kế linh hoạt và dễ tùy biến, cho phép fine-tuning cho các ứng dụng hoặc ngành dọc cụ thể. Sự linh hoạt này, kết hợp với năng lực mạnh mẽ, khiến Qwen trở thành nguồn lực tuyệt vời cho công nghệ AI trong nhiều lĩnh vực.
Họ mô hình của Qwen cung cấp công cụ mạnh mẽ và đa năng cho nhiều ứng dụng AI. Hãy cùng khám phá những điểm nổi bật giúp Qwen khác biệt:
Qwen vượt trội trong hiểu và sinh ngôn ngữ đa ngữ, với năng lực mạnh ở cả tiếng Anh và tiếng Trung, đồng thời hỗ trợ nhiều ngôn ngữ khác. Các mô hình Qwen2 mới nhất đã mở rộng kho ngôn ngữ thêm 27 ngôn ngữ, bao phủ Tây Âu, Đông và Trung Âu, Trung Đông, Đông Á và Nam Á.
Hỗ trợ ngôn ngữ rộng rãi này giúp Qwen thúc đẩy giao tiếp xuyên văn hóa, thực hiện dịch chất lượng cao, xử lý tình huống chuyển mã, và phục vụ ứng dụng toàn cầu với nội dung bản địa hóa.
Các mô hình Qwen rất thành thạo nhiều tác vụ tạo văn bản. Một số ứng dụng chính gồm:
Khả năng duy trì ngữ cảnh trên các chuỗi dài (lên đến 32.768 token) cho phép tạo đầu ra văn bản dài và mạch lạc.
Qwen cũng rất mạnh ở hỏi đáp dạng thực chứng và mở. Tính năng này cho phép:
Với mô hình Qwen-VL, họ Qwen mở rộng năng lực sang các tác vụ đa phương thức liên quan đến hình ảnh. Các tính năng chính gồm:
Một trong những điểm đáng chú ý nhất của Qwen là tính mã nguồn mở, mang lại nhiều lợi ích cho cộng đồng AI:
Cách tiếp cận mã nguồn mở đã dẫn đến sự hỗ trợ rộng rãi từ các dự án và công cụ bên thứ ba:
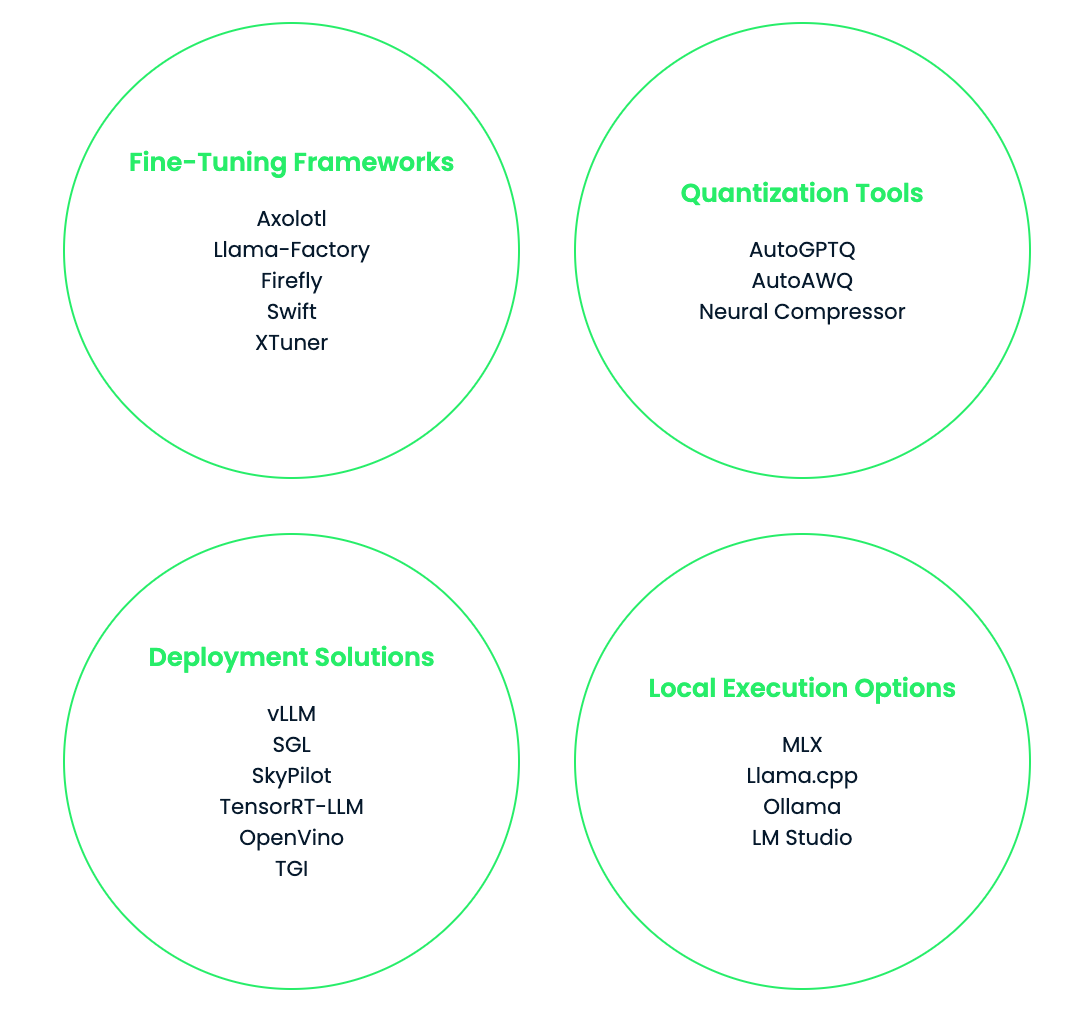
Giờ bạn đã biết về Qwen và các tính năng chính của nó, hãy học cách sử dụng trong thực tế!
Các mô hình Qwen có sẵn trên nhiều nền tảng, giúp rất dễ tiếp cận cho nhiều trường hợp sử dụng.
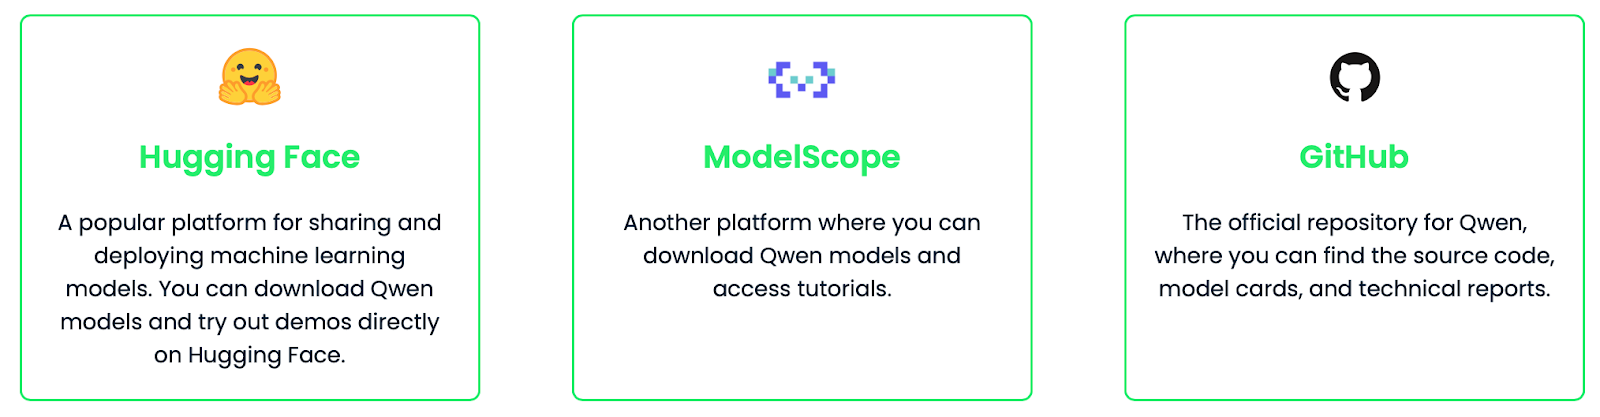
Trong phần này, tôi sẽ hướng dẫn bạn sử dụng mô hình ngôn ngữ Qwen-7B qua Hugging Face. Chúng ta sẽ thiết lập môi trường, đăng nhập Hugging Face và chạy mô hình.
Trước tiên, cài đặt các thư viện cần dùng:
pip install transformers torch huggingface_hubĐể truy cập mô hình Qwen-7B, bạn cần đăng nhập tài khoản Hugging Face. Điều này cần thiết vì một số mô hình có thể có hạn chế sử dụng, nhưng bạn vẫn có thể truy cập các mô hình riêng tư của mình hoặc tổ chức. Việc này giúp theo dõi mức sử dụng API và áp dụng giới hạn nếu cần.
Để đăng nhập, làm theo các bước:
1. Truy cập Hugging Face.
2. Vào cài đặt hồ sơ và tạo một access token.
3. Trong terminal, chạy:
huggingface-cli login4. Khi được nhắc, nhập access token của bạn.
Bây giờ, chúng ta sẽ tạo một tệp Python hoặc Jupyter Notebook để bắt đầu viết mã.
Trước hết, chúng ta import hai lớp từ thư viện transformers:
AutoModelForCausalLM: Lớp này tự động chọn kiến trúc mô hình phù hợp dựa trên tên mô hình bạn cung cấp.AutoTokenizer: Lớp này tải đúng tokenizer cho mô hình bạn đang dùng.from transformers import AutoModelForCausalLM, AutoTokenizerBây giờ, chúng ta chỉ định mô hình muốn sử dụng. "Qwen/Qwen-7B" là phiên bản 7 tỷ tham số của Qwen được lưu trữ trên Hugging Face model hub, nhưng bạn có thể dùng các mô hình Qwen khác.
model_name = "Qwen/Qwen-7B"Tiếp theo, chúng ta cần tải tokenizer.
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)Dòng này tải tokenizer đi kèm với mô hình Qwen-7B. Tham số trust_remote_code=True là cần thiết vì các mô hình Qwen có thể yêu cầu chạy mã tùy chỉnh khi tải.
Bước tiếp theo là tải mô hình.
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)Dòng này tải mô hình Qwen-7B thực tế. Một lần nữa, chúng ta dùng trust_remote_code=True để cho phép chạy bất kỳ mã tùy chỉnh nào đi kèm mô hình.
Sau khi tải mô hình, chúng ta có thể kiểm tra bằng cách tạo văn bản từ một đầu vào.
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
Ở đây, chúng ta chuẩn bị đầu vào cho mô hình:
input_text làm prompt.return_tensors="pt" chỉ định trả về tensor PyTorch.Giờ, chúng ta sinh văn bản:
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
Dòng đầu yêu cầu mô hình sinh văn bản:
inputs đã mã hóa vào phương thức generate.**inputs giải nén từ điển do tokenizer trả về.max_new_tokens=50 giới hạn tối đa 50 token mới.generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)Bước này chuyển đầu ra của mô hình (dạng ID token) về văn bản đọc được:
outputs chọn chuỗi sinh đầu tiên và cũng là duy nhất (trong trường hợp này).skip_special_tokens=True yêu cầu bỏ qua các token đặc biệt như padding hoặc kết thúc chuỗi.Cuối cùng, in văn bản đã sinh để xem kết quả.
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…Dưới đây là một số ghi chú và mẹo hữu ích:
trust_remote_code=True là cần thiết cho các mô hình Qwen vì chúng cần mã tùy chỉnh để chạy đúng.Các mô hình Qwen có thể được triển khai bằng Nền tảng AI (PAI) và Elastic AI Serving (EAS) của Alibaba Cloud. Hãy xem cách bạn có thể triển khai một mô hình Qwen chỉ với vài lần nhấp:
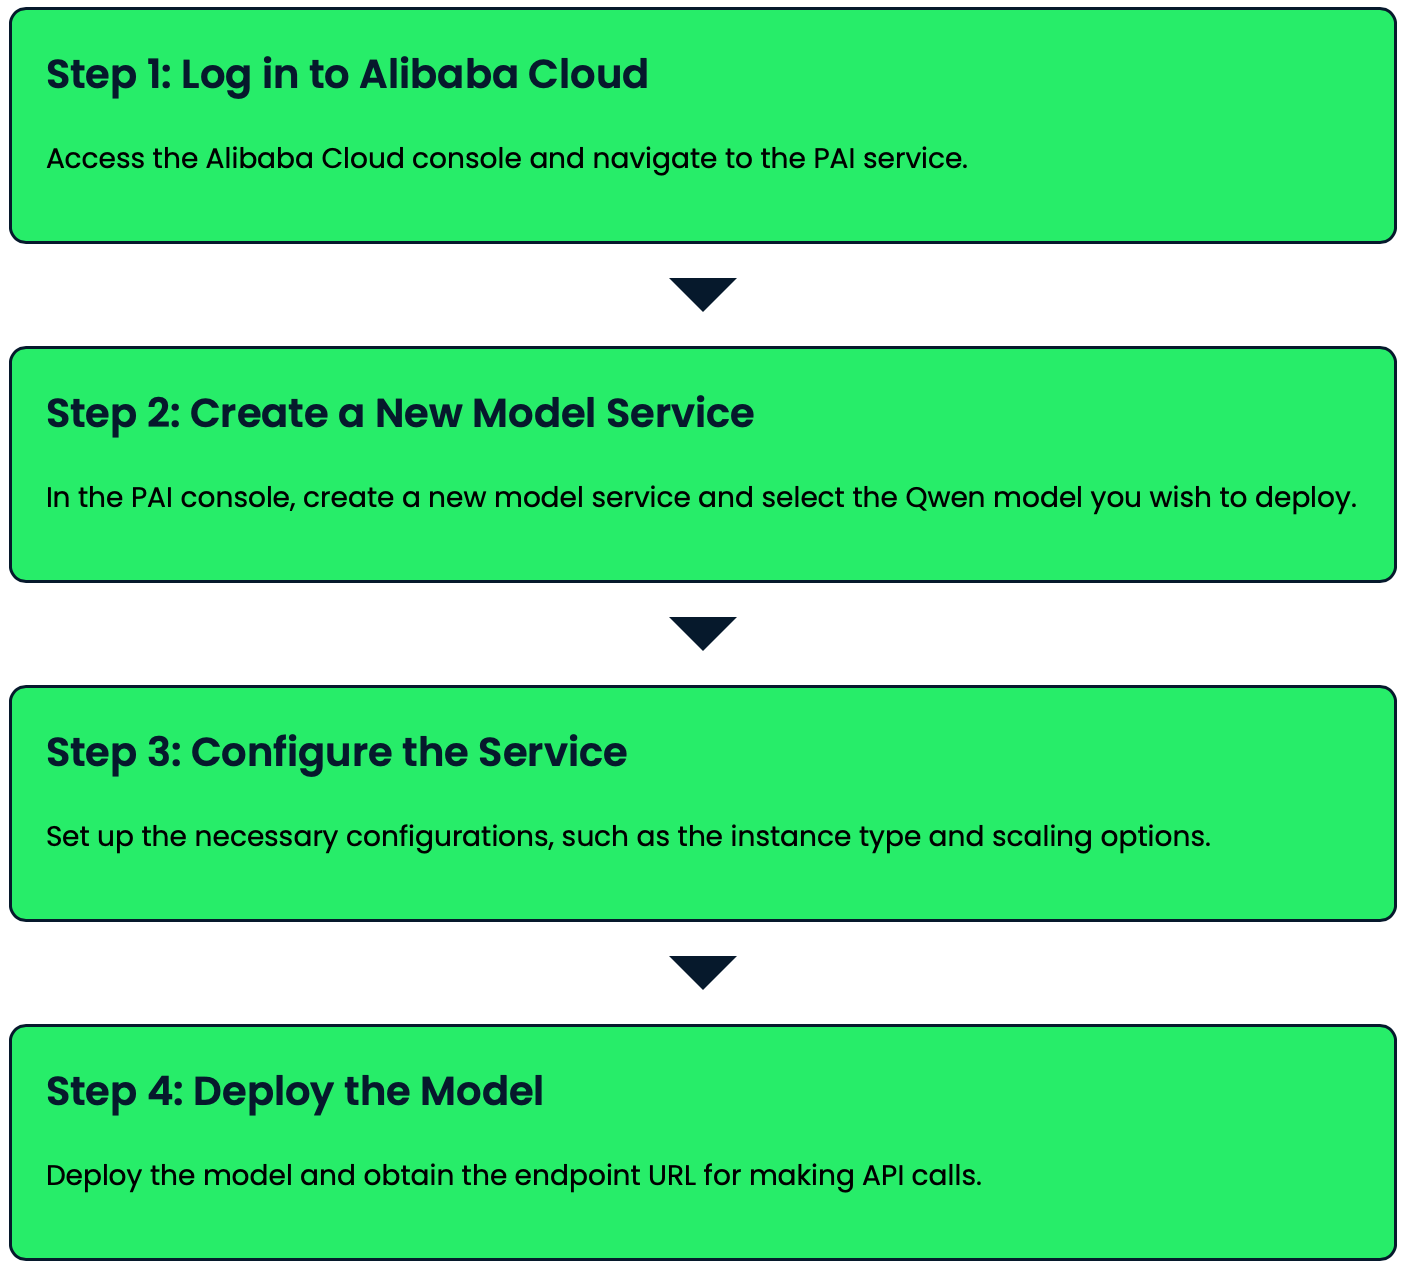
Hãy khám phá một số ví dụ thực tế dùng Qwen cho tác vụ tạo văn bản và hỏi đáp.
Qwen rất giỏi trong việc sinh văn bản mạch lạc và phù hợp ngữ cảnh dựa trên prompt cho trước. Hãy xem vài ví dụ:
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen có thể được dùng để trả lời nhiều loại câu hỏi, từ truy vấn thực tế đến câu hỏi mở hoặc thiên về phân tích. Dưới đây là một số ví dụ:
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.Những ví dụ này cho thấy Qwen có thể xử lý nhiều loại tác vụ tạo văn bản và hỏi đáp.
Bạn có thể điều chỉnh các tham số như max_new_tokens và temperature để kiểm soát độ dài và mức độ sáng tạo của phản hồi sao cho phù hợp nhu cầu.
Fine-tuning mô hình Qwen cho phép bạn điều chỉnh chúng cho các tác vụ cụ thể, có thể cải thiện hiệu năng cho trường hợp sử dụng của bạn. Quy trình này bao gồm huấn luyện mô hình đã tiền huấn luyện trên bộ dữ liệu tùy chỉnh, giúp nó học kiến thức theo tác vụ trong khi vẫn giữ năng lực hiểu ngôn ngữ tổng quát.
Trong phần này, chúng ta sẽ đi qua quy trình fine-tuning mô hình Qwen-7B trên bộ dữ liệu tùy chỉnh. Chúng ta sẽ dùng các kỹ thuật fine-tuning hiệu quả để quá trình này khả thi, ngay cả với mô hình lớn. Trong ví dụ, chúng ta fine-tune để cải thiện hiệu năng dịch và trả lời câu hỏi thực chứng. Quy trình này cho phép mô hình học từ dữ liệu tùy chỉnh đồng thời giữ năng lực hiểu ngôn ngữ chung.
Trước khi bắt đầu, hãy đảm bảo bạn đã cài đặt các gói sau:
pip install datasets torch accelerate peftTrước tiên, chuẩn bị bộ dữ liệu ở định dạng JSON. Mỗi mục nên có trường "prompt" và "completion". Lưu thành custom_dataset.json. Chúng ta sẽ dùng ví dụ này:
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]Giờ chúng ta thêm các import sau:
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelTiếp theo, chúng ta sẽ định nghĩa hàm tiền xử lý bộ dữ liệu và tải nó bằng thư viện datasets của Hugging Face:
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)Để fine-tuning hiệu quả hơn, chúng ta sẽ dùng LoRA (Low-Rank Adaptation). Kỹ thuật này cho phép fine-tuning mô hình lớn với ít tham số hơn:
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)Bây giờ, chúng ta thiết lập các tham số huấn luyện điều khiển nhiều khía cạnh của quá trình fine-tuning:
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)Với bộ dữ liệu và tham số huấn luyện đã sẵn sàng, chúng ta có thể tạo đối tượng Trainer và bắt đầu fine-tuning:
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()Sau khi fine-tuning xong, chúng ta sẽ lưu mô hình để dùng sau:
trainer.save_model("./fine_tuned_qwen")Fine-tuning mô hình Qwen-7B trên bộ dữ liệu tùy chỉnh sẽ cải thiện hiệu năng của nó trên các tác vụ tương tự dữ liệu huấn luyện. Trong trường hợp này, mô hình sẽ cải thiện ở việc dịch Anh-Pháp và trả lời câu hỏi thực chứng về thủ đô các nước.
Sau khi fine-tuning, bạn có thể dùng mô hình để suy luận:
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !Dưới đây là một số mẹo cần cân nhắc để fine-tuning hiệu quả:
Fine-tuning Qwen trên bộ dữ liệu tùy chỉnh cho phép bạn tạo ra mô hình chuyên biệt xuất sắc cho tác vụ của mình trong khi vẫn giữ tri thức rộng và năng lực của mô hình gốc. Cách tiếp cận này khai thác sức mạnh của mô hình ngôn ngữ lớn cho ứng dụng và miền riêng của bạn.
Khi Qwen tiếp tục phát triển, chúng ta có thể kỳ vọng một số tiến triển thú vị:
Khi kết thúc hành trình khám phá Qwen, có thể thấy các công cụ AI này đại diện cho bước tiến lớn về AI mạnh mẽ, linh hoạt và dễ tiếp cận. Qwen không chỉ là một bộ mô hình AI mạnh mẽ—đó còn là tầm nhìn đưa AI tiên tiến đến với mọi người. Bằng cách cung cấp các công cụ này dưới dạng mã nguồn mở, Alibaba Cloud đang thúc đẩy đổi mới và tiến bộ trong công nghệ AI.
Nếu bạn muốn cập nhật những điều mới nhất về AI, tôi gợi ý các bài viết sau:
Học AI với các khóa học này!
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
