Kurs
Arbeiten mit Hugging Face
2 Std.
38.2K
Was wäre, wenn nicht nur große Tech-Konzerne, sondern jede Person fortschrittliche Künstliche Intelligenz nutzen könnte? Genau diese Idee steckt hinter Qwen, einer neuen Familie von KI-Modellen von Alibaba Cloud.
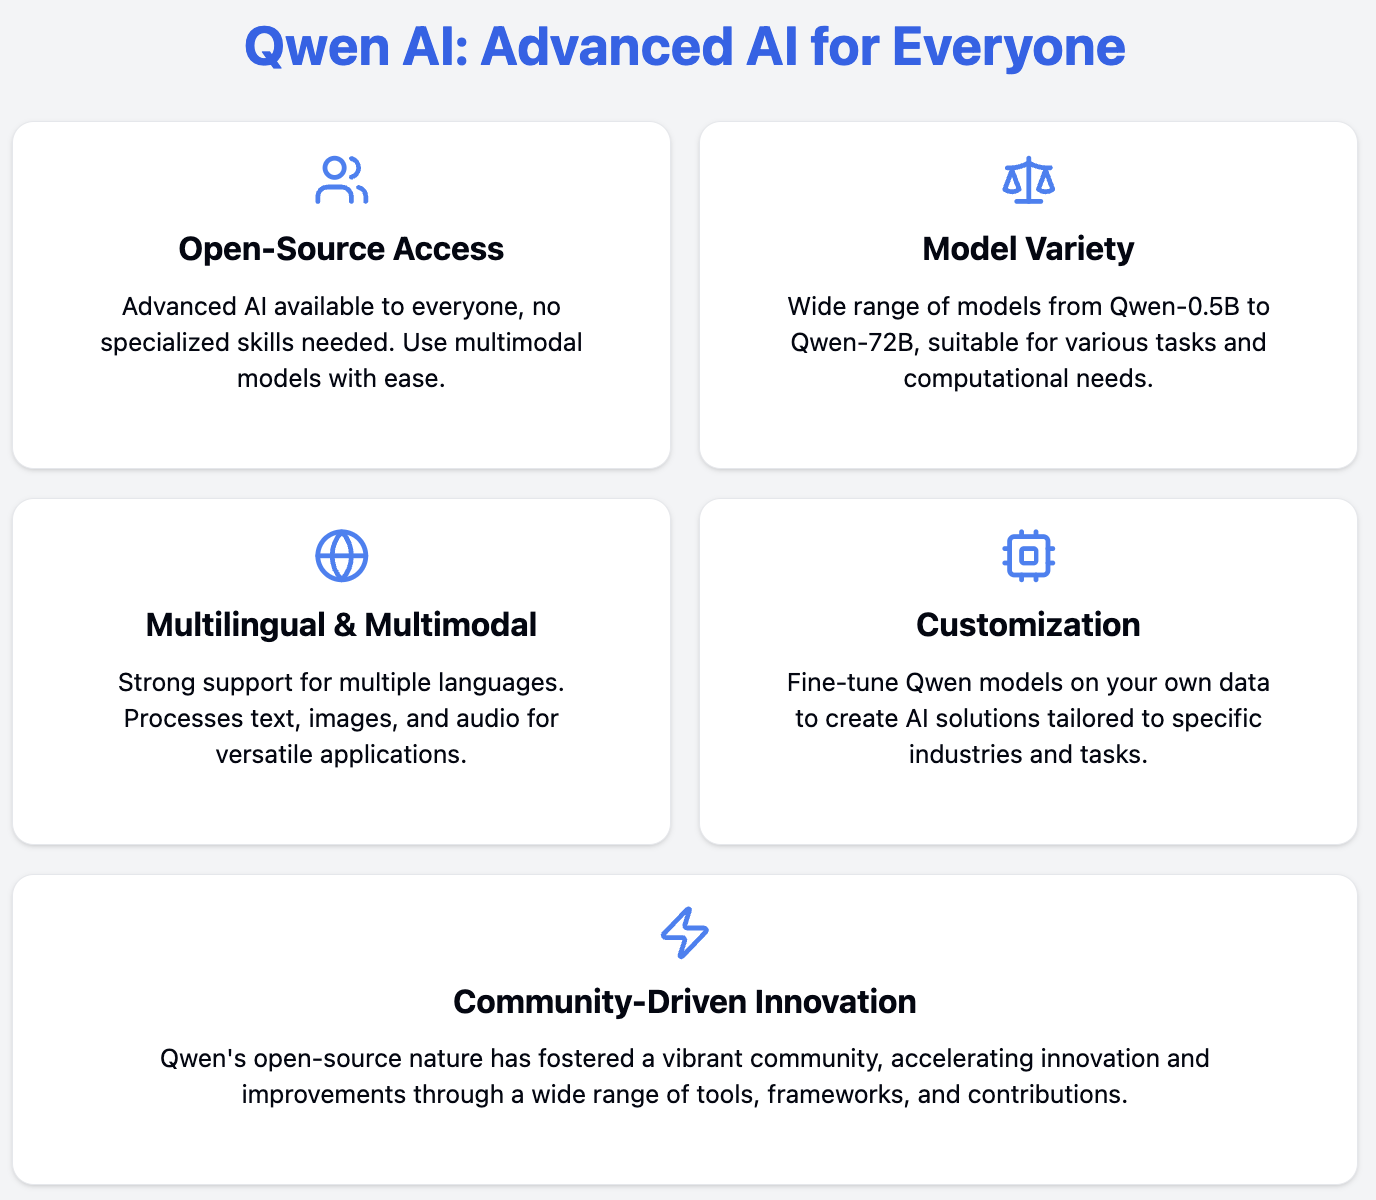
Qwen (Kurzform für Tongyi Qianwen) macht KI-Modelle mit einem Set von Alibaba-Cloud-Tools für alle leicht zugänglich. Qwen erreicht das durch:
Mit Qwen brauchst du weniger Ressourcen und Spezialwissen, um moderne KI zu nutzen.
In diesem Tutorial werden wir:
Qwen ist eine Reihe leistungsstarker Modelle, trainiert auf umfangreichen mehrsprachigen und multimodalen Datensätzen. Entwickelt von Alibaba Cloud, hebt Qwen KI auf ein neues Level und macht sie nützlicher für Natural Language Processing, Computer Vision und Audioverständnis.
Die Modelle decken ein breites Aufgabenspektrum ab, darunter:
Die Qwen-Modelle sind auf vielfältigen Datenquellen vortrainiert und mit hochwertigen Daten nachtrainiert.
Die Qwen-Familie umfasst verschiedene spezialisierte Modelle für unterschiedliche Anforderungen und Anwendungsfälle.
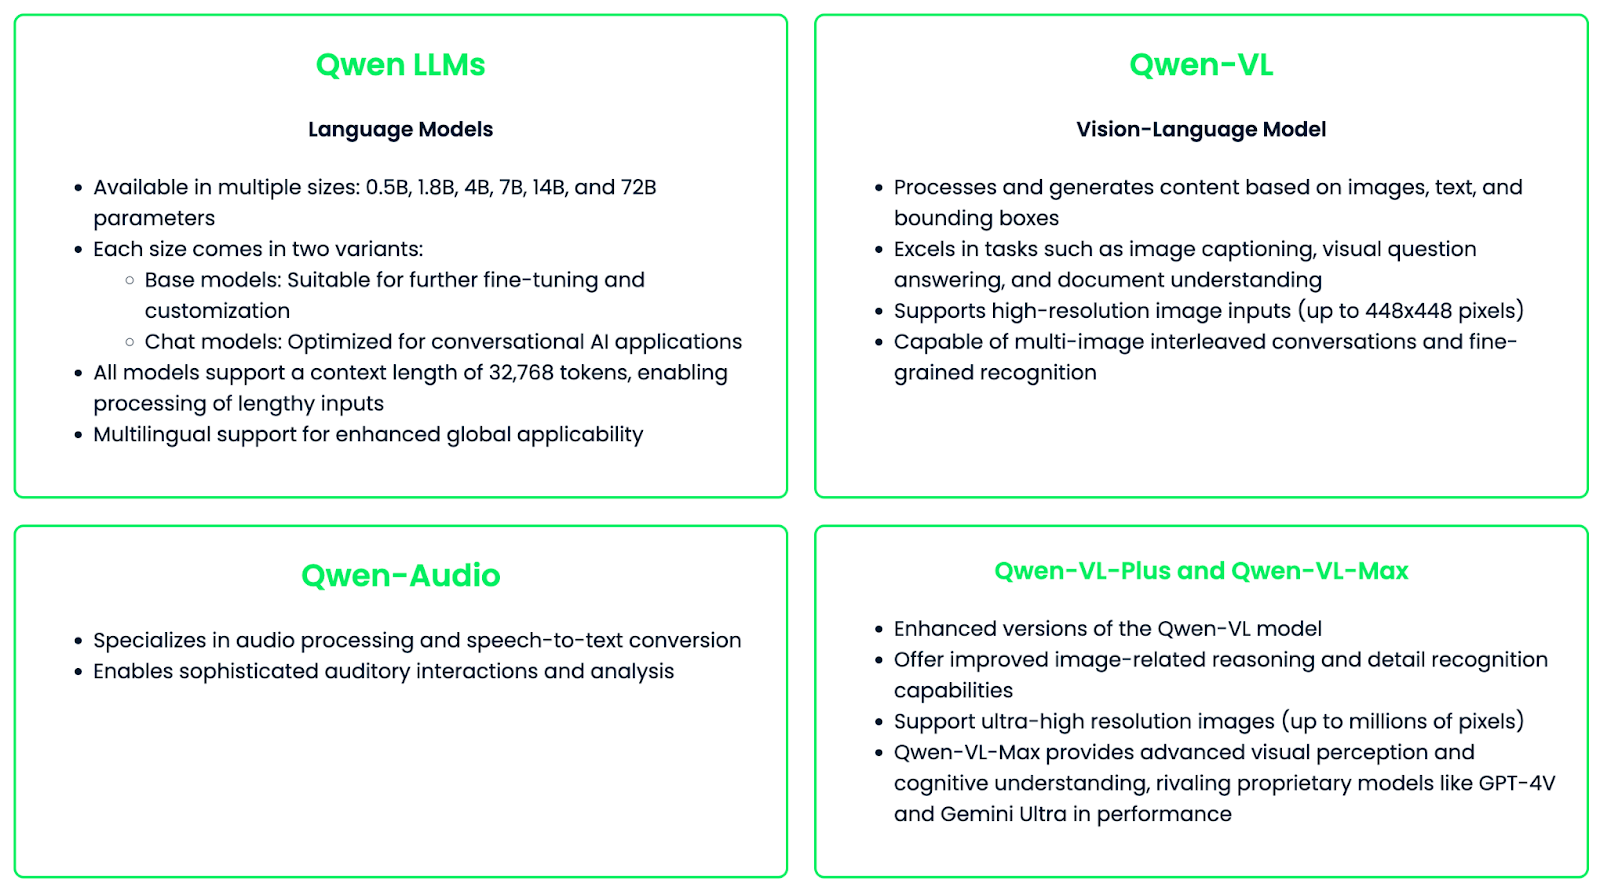
Die Qwen-Modellfamilie ist auf Vielseitigkeit und einfache Anpassung ausgelegt. Sie lässt sich per Fine-Tuning für spezifische Anwendungen oder Branchen zuschneiden. Diese Flexibilität, kombiniert mit starken Fähigkeiten, macht Qwen zu einer wertvollen Ressource für KI-Technologie in vielen Bereichen.
Die Qwen-Modellfamilie bietet ein leistungsstarkes, vielseitiges Werkzeug für zahlreiche KI-Anwendungen. Schauen wir uns die Features an, die Qwen besonders machen:
Qwen überzeugt bei Verständnis und Generierung in mehreren Sprachen, mit starken Fähigkeiten in Englisch und Chinesisch sowie Unterstützung für viele weitere Sprachen. Die neuesten Qwen2-Modelle erweitern das Spektrum um 27 zusätzliche Sprachen aus Westeuropa, Ost- und Mitteleuropa, dem Nahen Osten sowie Ost- und Südasien.
Dank der breiten Sprachabdeckung ermöglicht Qwen interkulturelle Kommunikation, hochwertige Übersetzungen, das Handling von Code-Switching und die Bereitstellung lokalisierter Inhalte für globale Anwendungen.
Qwen-Modelle sind sehr stark in verschiedenen Aufgaben der Textgenerierung. Wichtige Anwendungen sind:
Die Fähigkeit, über lange Sequenzen Kontext zu halten (bis zu 32.768 Tokens), ermöglicht umfangreiche, konsistente Ausgaben.
Qwen ist sowohl bei faktischen als auch offenen Fragen stark. Das ermöglicht:
Mit dem Qwen-VL-Modell erweitert die Qwen-Familie ihre Fähigkeiten auf multimodale Aufgaben mit Bildern. Wichtige Features sind:
Eines der stärksten Merkmale von Qwen ist der Open-Source-Ansatz mit mehreren Vorteilen für die KI-Community:
Der Open-Source-Ansatz hat zu breiter Unterstützung durch Drittprojekte und Tools geführt:
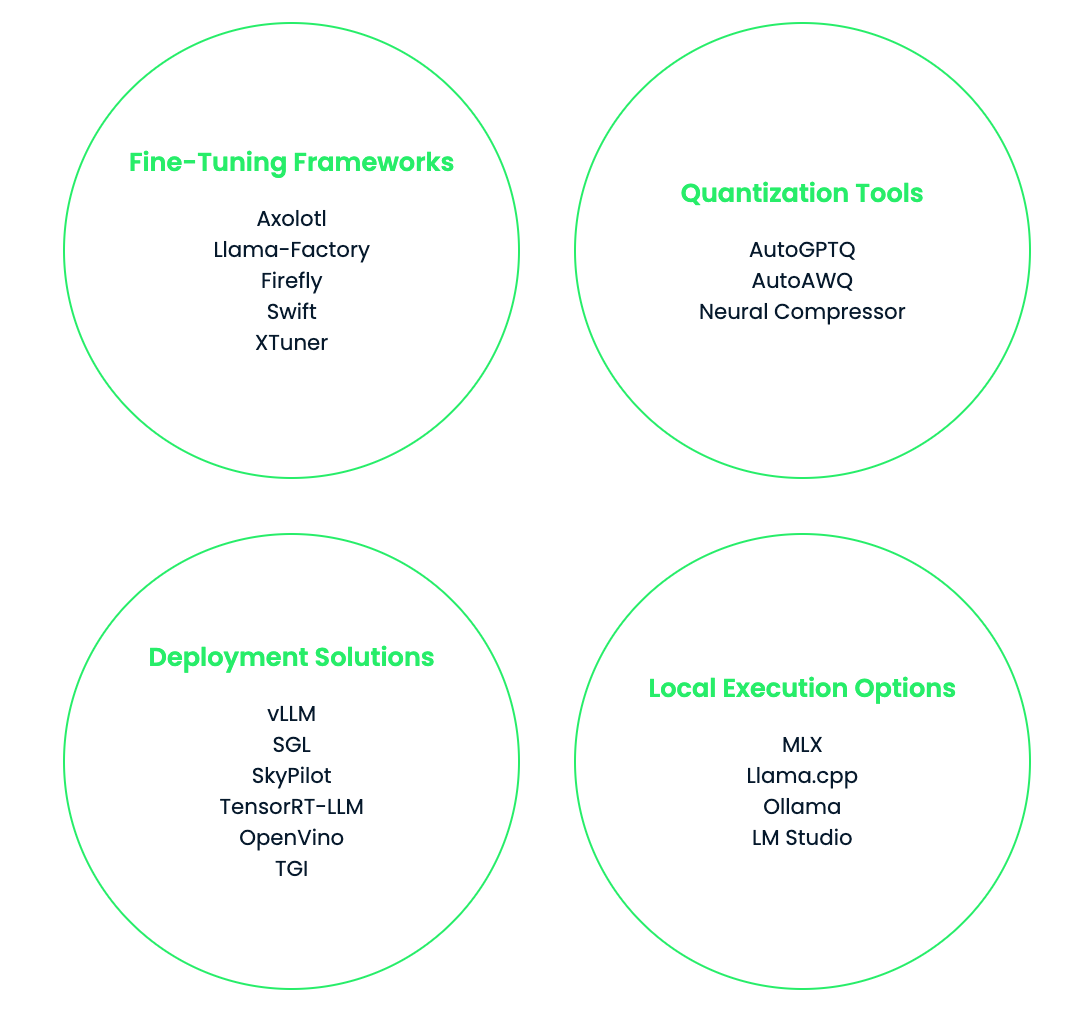
Nachdem du Qwen und seine Kernfunktionen kennst, geht es an die Praxis!
Qwen-Modelle sind auf mehreren Plattformen verfügbar und dadurch für viele Use Cases leicht zugänglich.
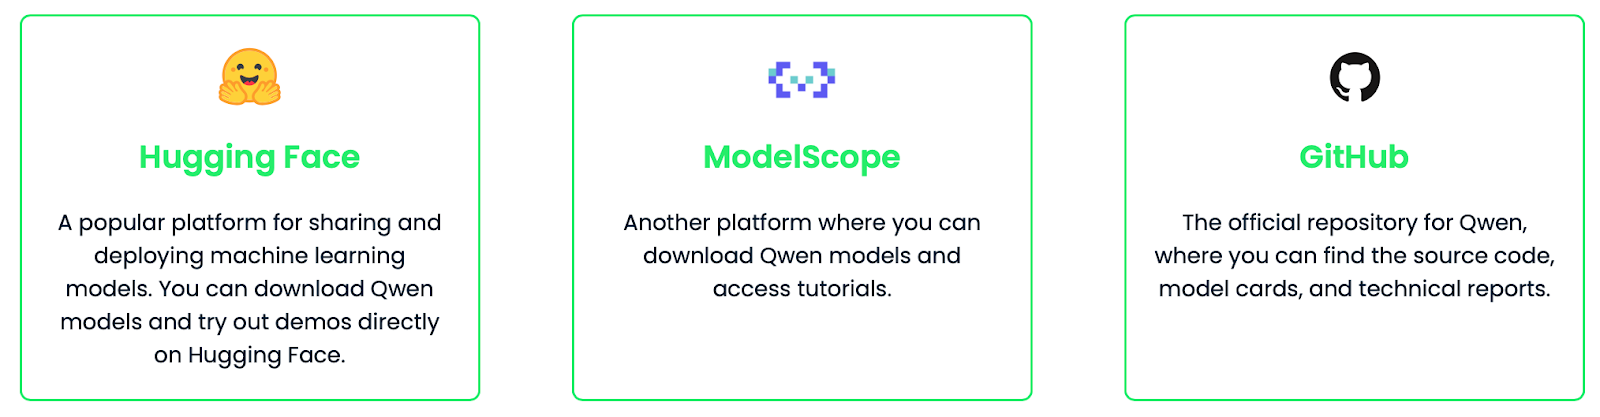
In diesem Abschnitt zeige ich dir, wie du das Sprachmodell Qwen-7B über Hugging Face nutzt. Wir richten die Umgebung ein, melden uns bei Hugging Face an und führen das Modell aus.
Installiere zunächst die notwendigen Bibliotheken:
pip install transformers torch huggingface_hubUm auf das Qwen-7B-Modell zuzugreifen, meldest du dich bei deinem Hugging-Face-Konto an. Manche Modelle haben Nutzungsbeschränkungen, aber du kannst weiterhin auf private Modelle von dir oder deiner Organisation zugreifen. Das erleichtert das Monitoring der API-Nutzung und das Durchsetzen von Rate Limits, falls nötig.
So meldest du dich an:
1. Gehe zu Hugging Face.
2. Erstelle in den Profileinstellungen ein Access Token.
3. Führe im Terminal aus:
huggingface-cli login4. Gib bei Aufforderung dein Access Token ein.
Lege nun eine Python-Datei oder ein Jupyter Notebook an, in dem wir den Code schreiben.
Wir importieren zwei Klassen aus der transformers-Bibliothek:
AutoModelForCausalLM: Wählt automatisch die passende Modellarchitektur basierend auf dem angegebenen Modellnamen.AutoTokenizer: Lädt den richtigen Tokenizer für das verwendete Modell.from transformers import AutoModelForCausalLM, AutoTokenizerAls Nächstes legen wir fest, welches Modell wir verwenden. "Qwen/Qwen-7B" bezeichnet die 7-Milliarden-Parameter-Variante von Qwen auf dem Hugging Face Hub. Du kannst aber auch andere Qwen-Modelle nutzen.
model_name = "Qwen/Qwen-7B"Jetzt laden wir den Tokenizer.
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)Diese Zeile lädt den zum Qwen-7B-Modell gehörenden Tokenizer. Der Parameter trust_remote_code=True ist nötig, weil Qwen-Modelle beim Laden teils eigenes Code-Handling benötigen.
Als Nächstes laden wir das Modell.
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)Damit wird das Qwen-7B-Modell geladen. Auch hier setzen wir trust_remote_code=True, um benutzerdefinierten Modellcode zuzulassen.
Sobald das Modell geladen ist, prüfen wir die Funktion, indem wir aus einem Prompt Text generieren.
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
Hier bereiten wir die Eingabe für das Modell vor:
input_text als Prompt.return_tensors="pt" gibt an, dass PyTorch-Tensoren zurückgegeben werden.Nun generieren wir Text:
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
Die erste Zeile weist das Modell an, Text zu erzeugen:
inputs an generate.**inputs entpackt das vom Tokenizer zurückgegebene Dictionary.max_new_tokens=50 begrenzt die Generierung auf maximal 50 neue Tokens.generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)Dieser Schritt wandelt die Ausgabetoken (IDs) zurück in lesbaren Text:
outputs wählt die erste (hier einzige) generierte Sequenz.skip_special_tokens=True blendet spezielle Tokens wie Padding oder Endmarken aus.Zum Schluss geben wir den generierten Text aus.
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…Hier ein paar hilfreiche Hinweise:
trust_remote_code=True ist bei Qwen-Modellen erforderlich, damit sie korrekt laufen.Qwen-Modelle lassen sich über die Platform for AI (PAI) und Elastic AI Serving (EAS) von Alibaba Cloud bereitstellen. So deployest du ein Qwen-Modell mit wenigen Klicks:
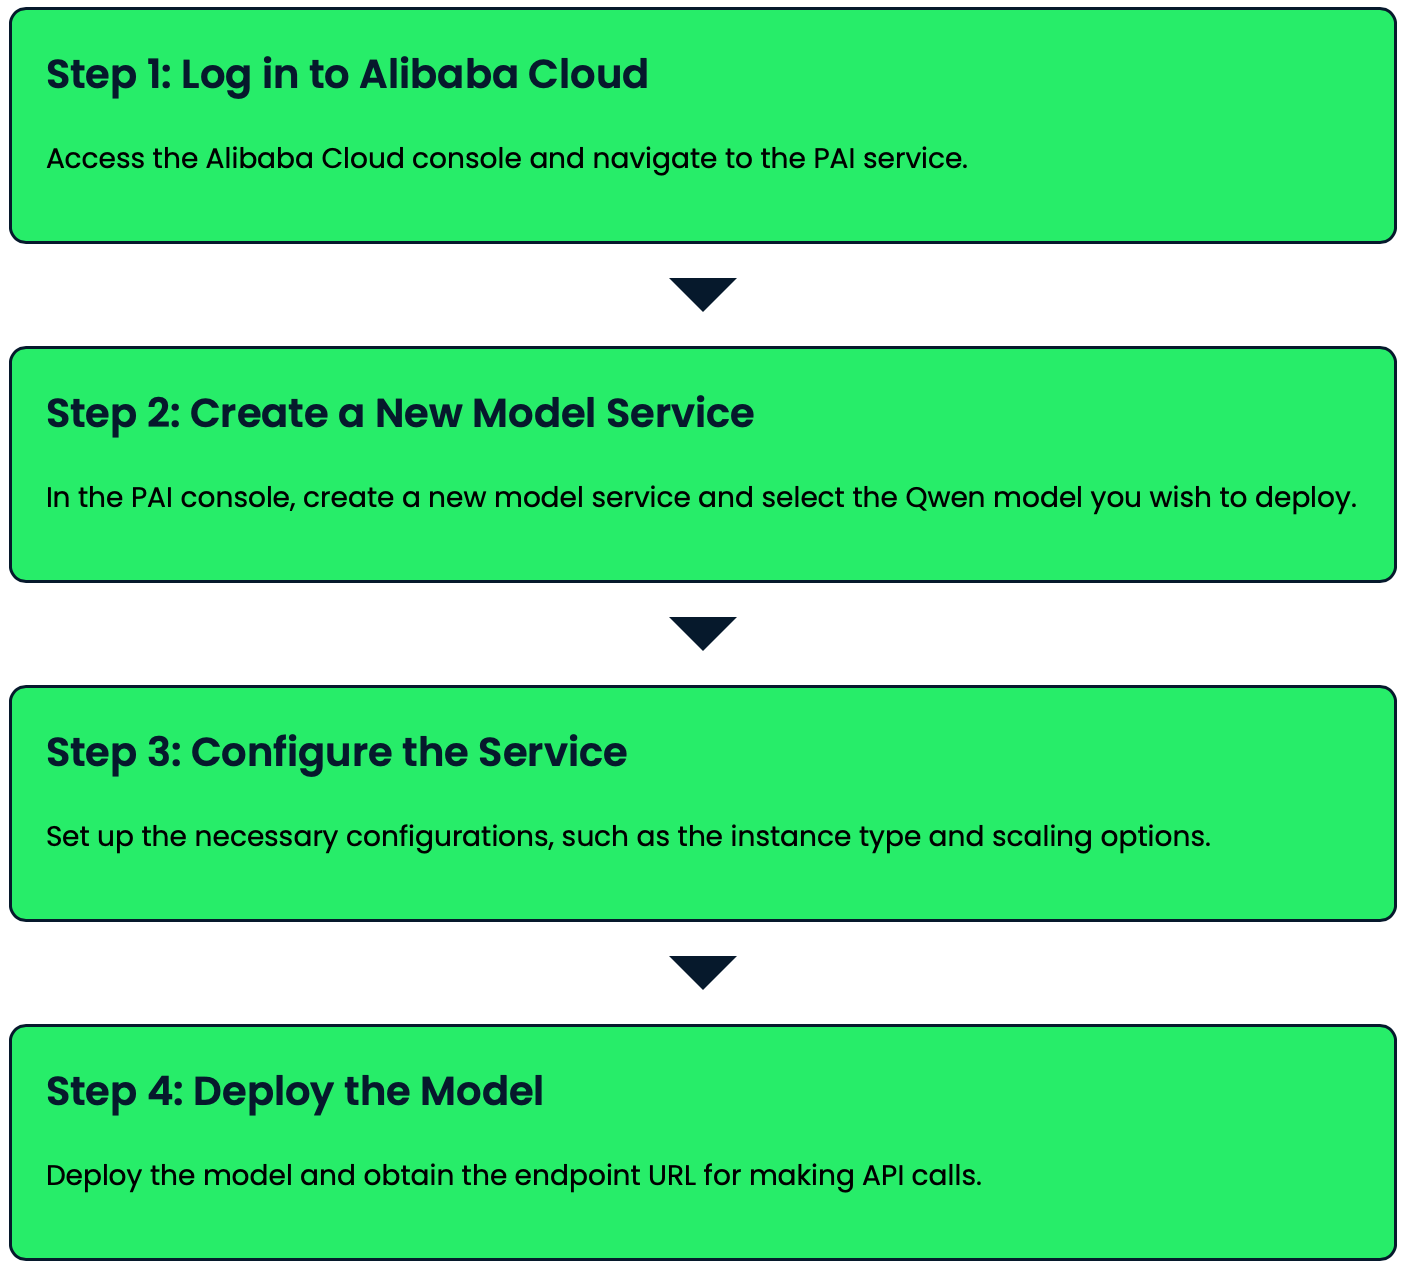
Schauen wir uns praktische Beispiele für Textgenerierung und Question Answering mit Qwen an.
Qwen generiert sehr kohärente und kontextrelevante Texte auf Basis deiner Prompts. Hier ein paar Beispiele:
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen beantwortet ein breites Spektrum an Fragen – von Fakten bis zu offenen, analytischen Fragen. Beispiele:
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.Die Beispiele zeigen, wie Qwen verschiedene Arten von Textgenerierung und Question Answering meistert.
Du kannst Parameter wie max_new_tokens und temperature anpassen, um Länge und Kreativität der Antworten für deine Anforderungen zu steuern.
Fine-Tuning von Qwen-Modellen ermöglicht es dir, sie auf bestimmte Aufgaben zuzuschneiden und so die Leistung für deinen Use Case zu steigern. Dafür trainierst du das vortrainierte Modell auf einem eigenen Datensatz weiter, sodass es aufgabenspezifisches Wissen lernt und zugleich seine allgemeinen Sprachfähigkeiten behält.
In diesem Abschnitt gehen wir den Prozess durch, das Qwen-7B-Modell auf einem eigenen Datensatz zu verfeinern. Wir nutzen effiziente Fine-Tuning-Techniken, damit das auch bei großen Modellen machbar bleibt. Im Beispiel verbessern wir das Modell für Übersetzungen und faktische Fragen. So lernt es aus deinem Datensatz, ohne sein allgemeines Sprachverständnis zu verlieren.
Stelle vorab sicher, dass Folgendes installiert ist:
pip install datasets torch accelerate peftBereite deinen Datensatz im JSON-Format vor. Jeder Eintrag sollte ein Feld "prompt" und ein Feld "completion" haben. Speichere ihn als custom_dataset.json. Wir nutzen dieses Beispiel:
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]Als Nächstes fügen wir folgende Importe hinzu:
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelWir definieren nun eine Funktion zur Vorverarbeitung und laden den Datensatz mit der Hugging-Face-datasets-Bibliothek:
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)Für effizienteres Fine-Tuning nutzen wir LoRA (Low-Rank Adaptation). Damit lassen sich große Modelle mit deutlich weniger zu trainierenden Parametern anpassen:
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)Jetzt legen wir die Trainingsparameter fest, die den Fine-Tuning-Prozess steuern:
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)Mit Datensatz und Trainingsparametern erstellen wir den Trainer und starten das Fine-Tuning:
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()Nach dem Fine-Tuning speichern wir das Modell für die spätere Nutzung:
trainer.save_model("./fine_tuned_qwen")Das Fine-Tuning von Qwen-7B auf deinem Datensatz verbessert die Leistung bei ähnlichen Aufgaben. In unserem Fall wird das Modell besser beim Übersetzen von Englisch nach Französisch und beim Beantworten faktischer Fragen zu Hauptstädten.
Nach dem Fine-Tuning kannst du das Modell für Inferenz verwenden:
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !Beachte für gutes Fine-Tuning Folgendes:
Mit Fine-Tuning auf deinem Datensatz erhältst du ein spezialisiertes Modell, das in deiner Aufgabe glänzt und gleichzeitig das breite Wissen des ursprünglichen Modells behält. So nutzt du die Stärken großer Sprachmodelle optimal für deine spezifischen Anwendungen und Domänen.
Mit der Weiterentwicklung von Qwen sind mehrere spannende Entwicklungen zu erwarten:
Zum Abschluss ist klar: Qwen steht für einen großen Schritt hin zu zugänglicher, leistungsfähiger und vielseitiger KI. Qwen ist mehr als nur eine Sammlung starker KI-Modelle – es ist eine Vision, fortgeschrittene KI für alle nutzbar und anpassbar zu machen. Mit dem Open-Source-Ansatz treibt Alibaba Cloud Innovation und Fortschritt in der KI voran.
Wenn du bei den neuesten KI-Themen am Ball bleiben willst, empfehle ich diese Artikel:
Lerne KI mit diesen Kursen!
Kurs
Lernpfad
Kurs