
{count, plural, one {Program} other {Program}}
Pemrosesan Bahasa Alami dalam Python
{hours} jam
Di dunia teknologi yang berubah cepat saat ini, Kecerdasan Buatan tampil sebagai bidang penting yang selalu hadir, dengan mulus meresap ke dalam pengalaman sehari-hari kita. Di pusat gelombang AI ini ada Natural Language Processing, area canggih yang mendayai alat percakapan populer seperti ChatGPT dan Bard.
Bagaimana jika sebagian besar model yang memungkinkan alat-alat ini tersedia untuk semua orang dan berada di satu tempat?
Inilah: Hugging Face, pengubah permainan dalam machine learning dan natural language processing serta agen kunci dalam demokratisasi AI. Berkat transfer learning, platform ini memainkan peran penting dalam membuat AI lebih mudah diakses.
Saat ini, Hugging Face memiliki pustaka NLP paling populer di Python, dengan lebih dari 115 ribu bintang di GitHub, dan telah muncul sebagai salah satu platform penting bagi penggemar dan profesional AI untuk bereksperimen, menerapkan, dan menskalakan model mereka sendiri.
Baik Anda seorang profesional data atau pemula yang penasaran, Hugging Face memiliki alat dan sumber daya untuk mewujudkan proyek AI Anda, mendorong batas kemungkinan dengan machine learning.
Jadi, mari kita temukan apa saja yang ditawarkan Hugging Face!
Anda juga dapat mempelajari lebih lanjut tentang Menggunakan Model AI Open Source dengan Hugging Face melalui sesi code-along kami.
Bagi kebanyakan orang, Hugging Face mungkin hanya emoji lain yang tersedia di papan ketik ponsel mereka (🤗)
Namun, di kancah teknologi, ini adalah GitHub-nya dunia ML — sebuah platform kolaboratif yang sarat alat yang memberdayakan siapa pun untuk membuat, melatih, dan menerapkan model NLP dan ML menggunakan kode open-source.
Terobosannya?
Model-model ini sudah hadir dalam bentuk pra-latih, yang semakin menyederhanakan proses memasuki NLP. Sederhananya, pengembang tidak lagi mulai dari nol; mereka cukup memuat model pra-latih dari hub Hugging Face, melakukan fine-tuning untuk tugas spesifik mereka, dan melanjutkan dari sana.
Kemudahan penggunaan ini sangat menyederhanakan proses pengembangan.
Dengan demikian, Hugging Face adalah hub tempat data scientist, peneliti, dan engineer ML berkumpul untuk bertukar ide, mencari dukungan, dan berkontribusi pada inisiatif open-source.
Mereka menggambarkan diri mereka sebagai:
“Komunitas AI untuk membangun masa depan.”
Visi ini adalah salah satu bahan rahasia kesuksesan Hugging Face: memiliki pendekatan yang digerakkan komunitas.
Alasan lain pertumbuhannya yang pesat adalah keintuitifan platformnya. Menyediakan antarmuka sederhana memudahkan untuk memulai — baik bagi pemula maupun profesional.
Dengan tujuan menjadi tuan rumah koleksi sumber daya NLP dan ML terbesar, Hugging Face berkomitmen untuk mendemokratisasi AI dan membuatnya dapat diakses oleh komunitas global.
Didirikan pada 2016, Hugging Face adalah perusahaan Amerika-Prancis yang bertujuan mengembangkan chatbot AI interaktif yang ditujukan untuk remaja. Namun, setelah melakukan open-source pada model yang mendayai chatbot ini, mereka dengan cepat berporos ke visi yang lebih besar: mempersenjatai industri AI dengan alat yang kuat dan mudah diakses.
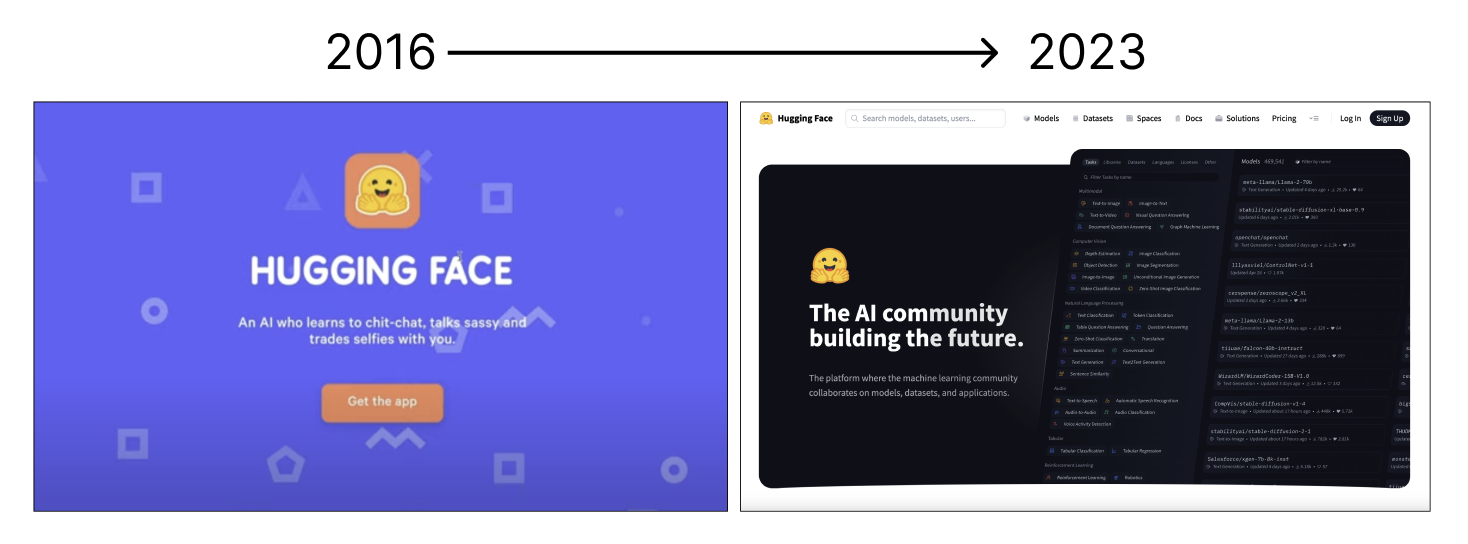
Gambar oleh penulis.
Peluncuran pustaka Transformers yang transformatif pada 2018 menjadi salah satu kontribusi terbesar dan paling dikenal ke komunitas AI, menawarkan model pra-latih seperti BERT dan GPT yang telah menjadi andalan dalam tugas NLP.
Hari ini, HuggingFace telah benar-benar mentransformasi ekosistem ML. Komitmennya terhadap kolaborasi open-source telah mengkatalisasi inovasi dalam NLP, memungkinkan pertumbuhan dan pengembangan teknologi secara komunal.
Platform ini telah menjadi pusat berbagi model dan dataset, mendorong riset dan penerapan praktis dalam AI.
Mantra mereka?
“Mendemokratisasi Machine Learning yang baik, satu commit pada satu waktu.”
Melalui kemitraan strategis dan dedikasi untuk membuat alat NLP tingkat lanjut tersedia luas, Hugging Face telah menjadi bagian integral dari komunitas, terus mendorong batas AI dan mendemokratisasi akses ke teknologi mutakhir.
Hugging Face telah menjadi pilar NLP modern melalui beragam komponen inti dan fitur yang melayani berbagai kebutuhan pemrosesan bahasa.
Mari kita uraikan satu per satu.
Pustaka Transformers adalah rangkaian komprehensif model machine learning mutakhir yang dirancang khusus untuk NLP. Pustaka ini terdiri dari kumpulan besar model pra-latih yang dioptimalkan untuk tugas seperti klasifikasi teks, generasi bahasa, terjemahan, dan peringkasan, di antaranya
Hugging Face telah mengabstraksikan tugas-tugas NLP umum ke dalam metode `pipeline()` yang mudah digunakan, sebuah API sederhana untuk melakukan berbagai tugas. Pipeline ini memungkinkan pengguna dengan mudah menerapkan model kompleks ke permasalahan dunia nyata. Jika Anda ingin mempelajari lebih lanjut di balik pustaka ini, saya sangat merekomendasikan membaca artikel Pengantar Menggunakan Transformers dan Hugging Face.
Model-model ini mudah diakses dan dapat dikustomisasi, yang menjadi terobosan bagi pengembang dan peneliti serta memainkan peran kunci dalam membuat model NLP canggih lebih mudah diakses.
Signifikansinya terletak pada kemampuannya mengabstraksikan kompleksitas yang terlibat dalam pelatihan dan penerapan model NLP, sehingga memudahkan praktisi mengimplementasikan fitur NLP tingkat lanjut dengan kode minimal.
Pustaka ini memungkinkan pemanfaatan model pra-latih tanpa menyelami algoritme dasarnya.
Pustaka Transformers menyederhanakan implementasi model NLP dalam beberapa cara kunci:
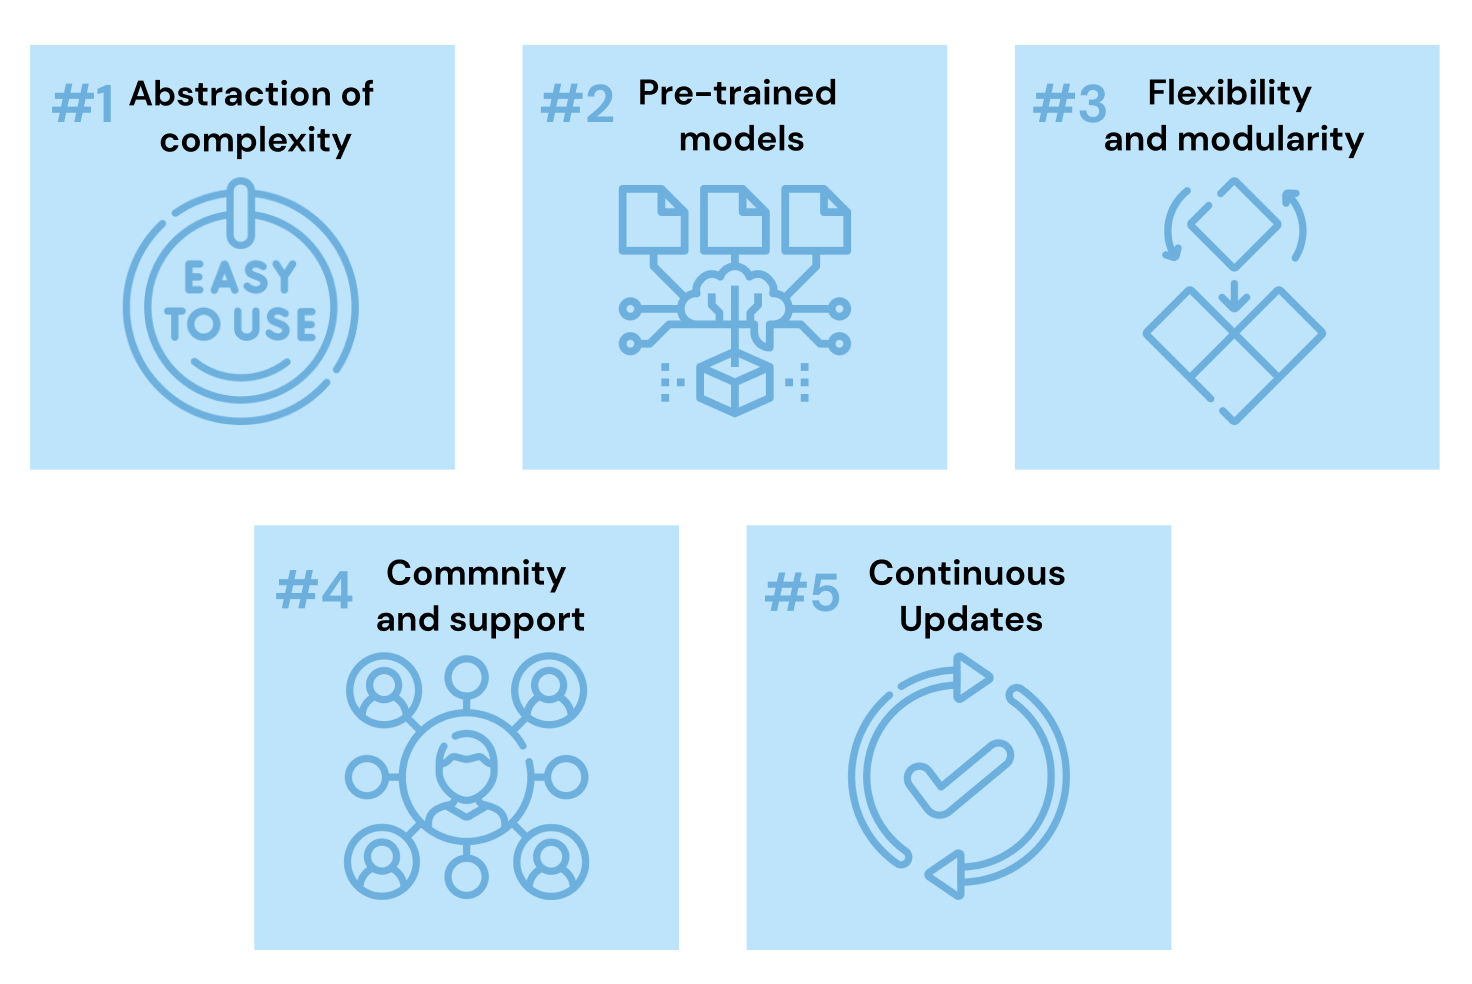
Jika Anda ingin melihat langsung semua pekerjaan yang dihindarkan oleh pustaka transformers, pelajari cara menerapkan model NLP melalui Membangun Transformer dengan PyTorch.
Model Hub hadir sebagai wajah komunitas, sebuah platform tempat ribuan model dan dataset ada di ujung jari Anda. Ini adalah fitur inovatif yang memungkinkan pengguna berbagi dan menemukan model yang dikontribusikan oleh komunitas, mendorong pendekatan kolaboratif untuk pengembangan NLP.
Anda dapat melihatnya di situs resmi mereka. Di sana Anda dapat dengan mudah memilih Model Hub dengan mengklik tombol Models di navigator, dan tampilan seperti berikut akan muncul:
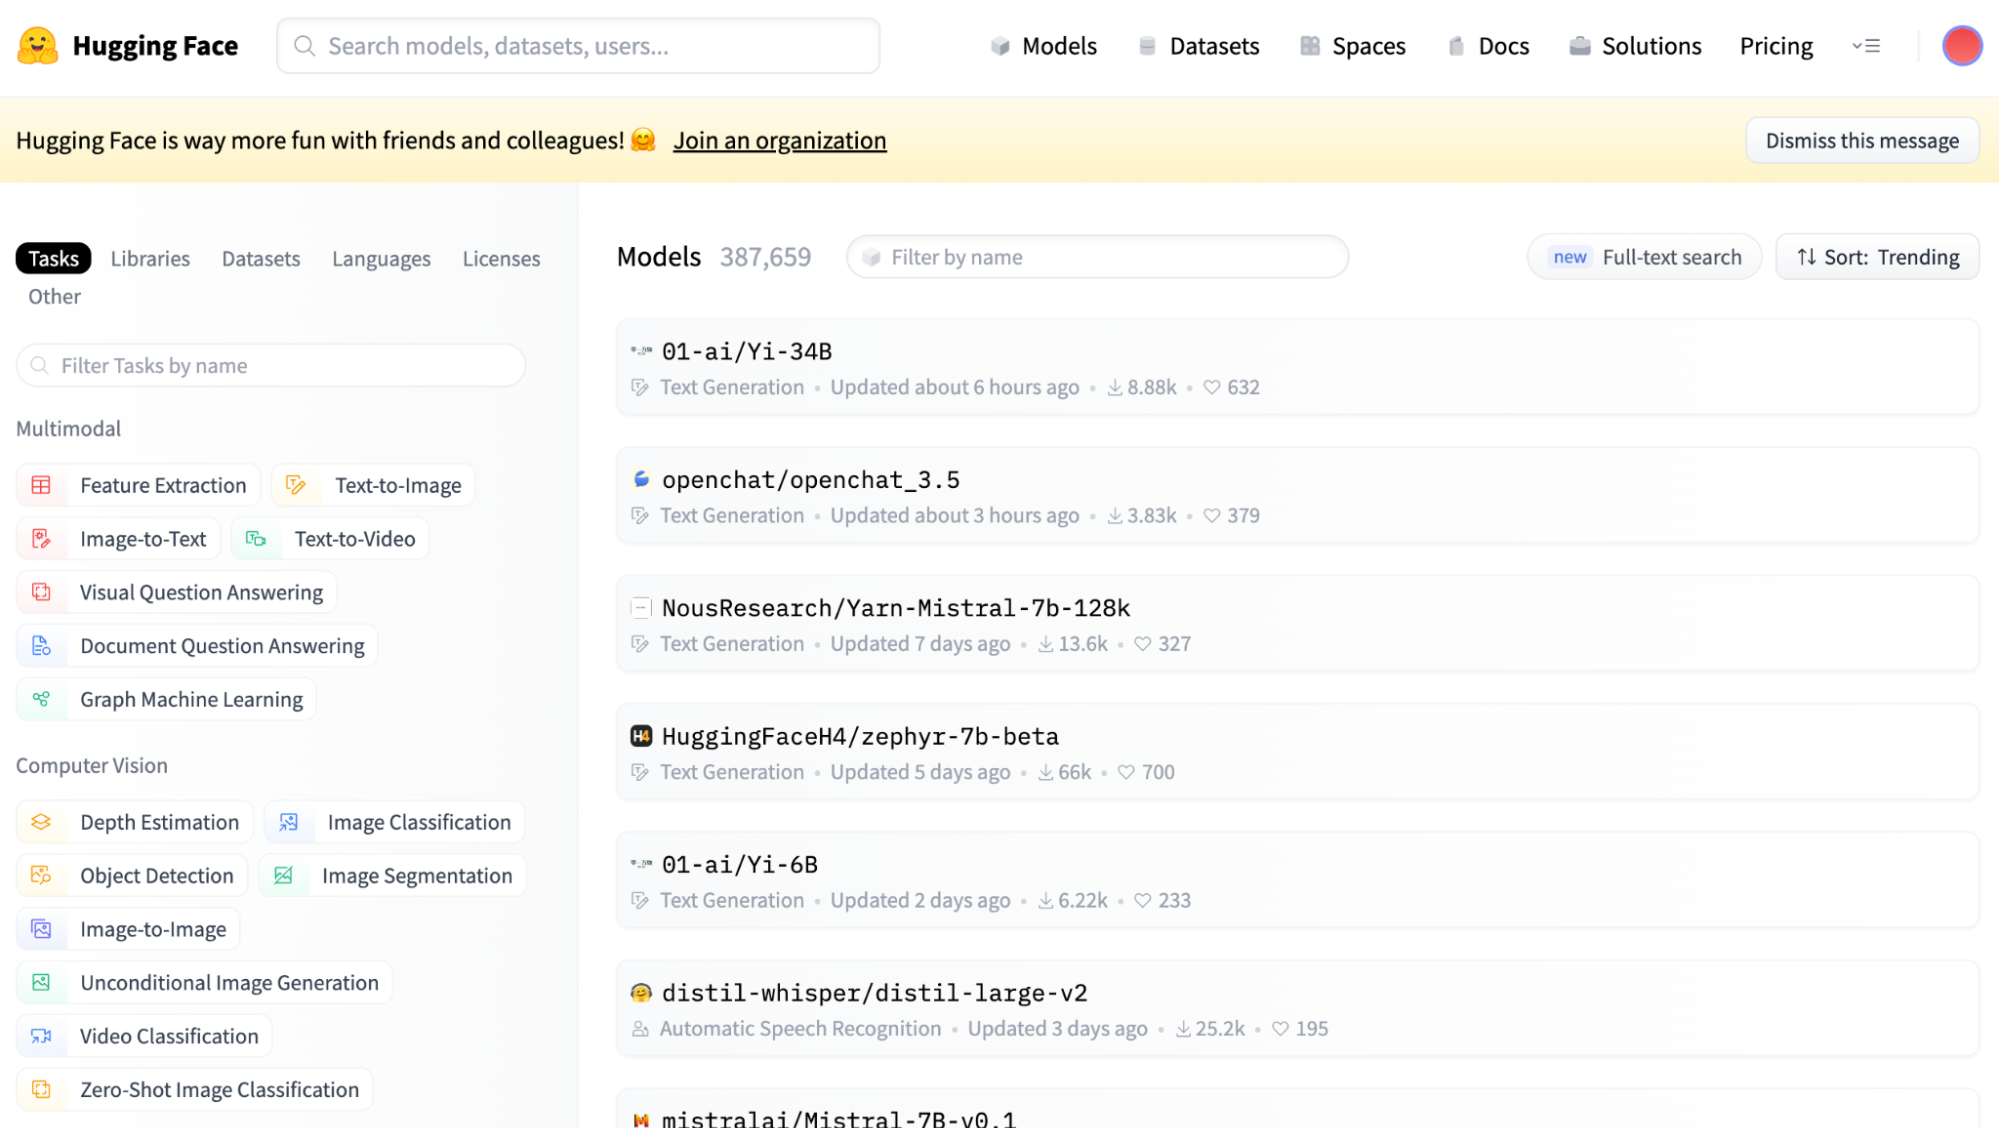
Screenshot tampilan utama Hugging Face Model Hub.
Seperti yang Anda lihat, di bilah sisi kiri terdapat beberapa filter terkait tugas utama yang akan dilakukan.
Berkontribusi ke Model Hub dibuat sederhana oleh alat Hugging Face, yang membimbing pengguna melalui proses mengunggah model mereka. Setelah dikontribusikan, model ini tersedia untuk seluruh komunitas, baik langsung melalui hub maupun melalui integrasi dengan pustaka Hugging Face Transformers.
Kemudahan akses dan kontribusi ini menumbuhkan ekosistem dinamis di mana model mutakhir terus disempurnakan dan dikembangkan, menyediakan fondasi kolaboratif yang kaya untuk kemajuan NLP.
Tokenizer sangat penting dalam NLP, karena bertugas mengonversi teks ke format yang dapat dipahami oleh model machine learning, yang esensial untuk memproses berbagai bahasa dan struktur teks.
Tokenizer bertanggung jawab memecah teks menjadi token — unit dasar seperti kata, sub-kata, atau karakter — sehingga menyiapkan data untuk diproses oleh model machine learning. Token-token ini adalah blok bangunan yang memungkinkan model memahami dan menghasilkan bahasa manusia.
Tokenizer juga memfasilitasi transformasi token ke representasi vektor untuk masukan model serta menangani padding dan truncation untuk panjang sekuens yang seragam.
Hugging Face menyediakan berbagai tokenizer yang ramah pengguna, dioptimalkan untuk pustaka Transformers mereka, yang menjadi kunci prapemrosesan teks yang mulus. Anda dapat membaca lebih lanjut tentang Tokenisasi di artikel terpisah.
Komponen kunci lainnya adalah pustaka Hugging Face Datasets, repositori luas dataset NLP yang mendukung pelatihan dan benchmarking model ML.
Pustaka ini adalah alat krusial bagi pengembang di bidang ini, karena menawarkan koleksi beragam dataset yang dapat digunakan untuk melatih, menguji, dan melakukan benchmarking model NLP di berbagai tugas.
Salah satu manfaat utamanya adalah antarmuka yang sederhana dan mudah digunakan. Meski Anda dapat menelusuri dan mengeksplorasi semua dataset di Hugging Face Hub, untuk digunakan dalam kode, mereka menyediakan pustaka dataset yang memungkinkan Anda mengunduh dataset apa pun dengan mudah.
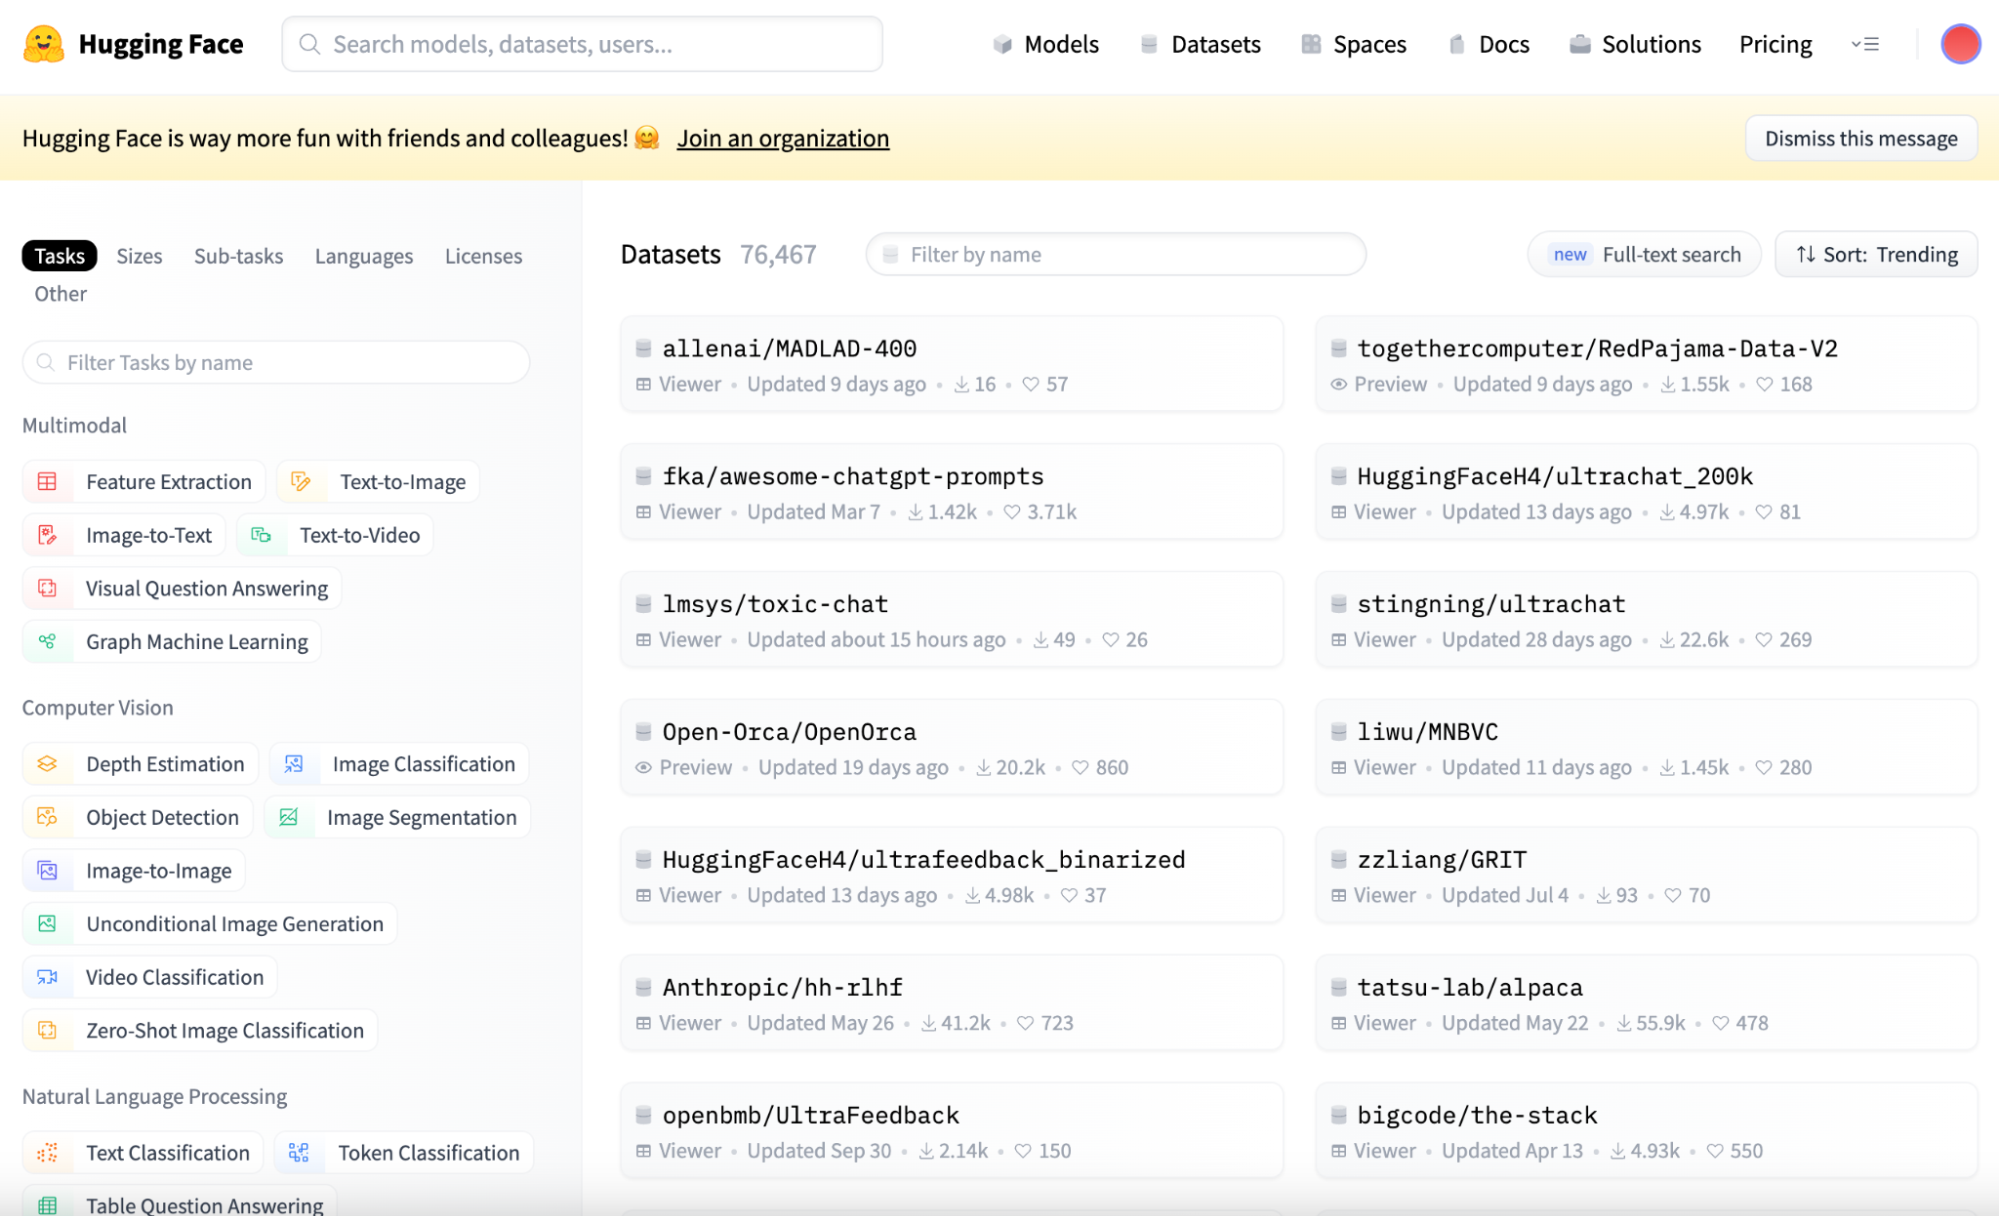
Screenshot tampilan utama Hugging Face Datasets.
Pustaka ini mencakup dataset untuk tugas umum seperti klasifikasi teks, terjemahan, dan tanya jawab, serta dataset yang lebih khusus untuk tantangan unik di bidang ini.
Sekarang kita sudah sejalan dan memahami konsep inti di balik Hugging Face, mari kita cari tahu cara menggunakan permata teknologi kecil ini.
Panduan ini akan menuntun Anda secara singkat melalui dasar-dasar memulai dengan Hugging Face, termasuk instalasi, penggunaan model pra-latih, fine-tuning, dan berbagi model Anda dengan komunitas.
Pertama, Anda sebaiknya memadukan pustaka transformers dengan pustaka deep learning favorit Anda, yakni TensorFlow atau PyTorch.
Pustaka transformers dapat dengan mudah dipasang menggunakan pip, penginstal paket Python.
pip install transformers
Untuk kemampuan penuh, Anda juga sebaiknya memasang pustaka datasets dan tokenizers.
pip install tokenizers, datasets
Model hub Hugging Face menawarkan koleksi besar model pra-latih yang dapat Anda gunakan untuk berbagai tugas NLP. Mari kita pelajari cara menggunakan model pra-latih pertama kita.
1. Pilih Model Pra-latih: Pertama, Anda perlu memilih model pra-latih. Untuk melakukannya, kita pergi ke Model Hub.
Bayangkan kita ingin menginferensikan sentimen yang sesuai dengan sebuah string teks. Jadi kita dapat dengan mudah menelusuri hanya model yang melakukan tugas `Text Classification` dengan memilih tombol Text Classification di bilah sisi kiri.
Model Hugging Face selalu ditampilkan berdasarkan Trending. Biasanya, hasil teratas adalah yang paling banyak digunakan. Maka, kita pilih hasil kedua, yakni model analisis sentimen yang paling banyak digunakan.
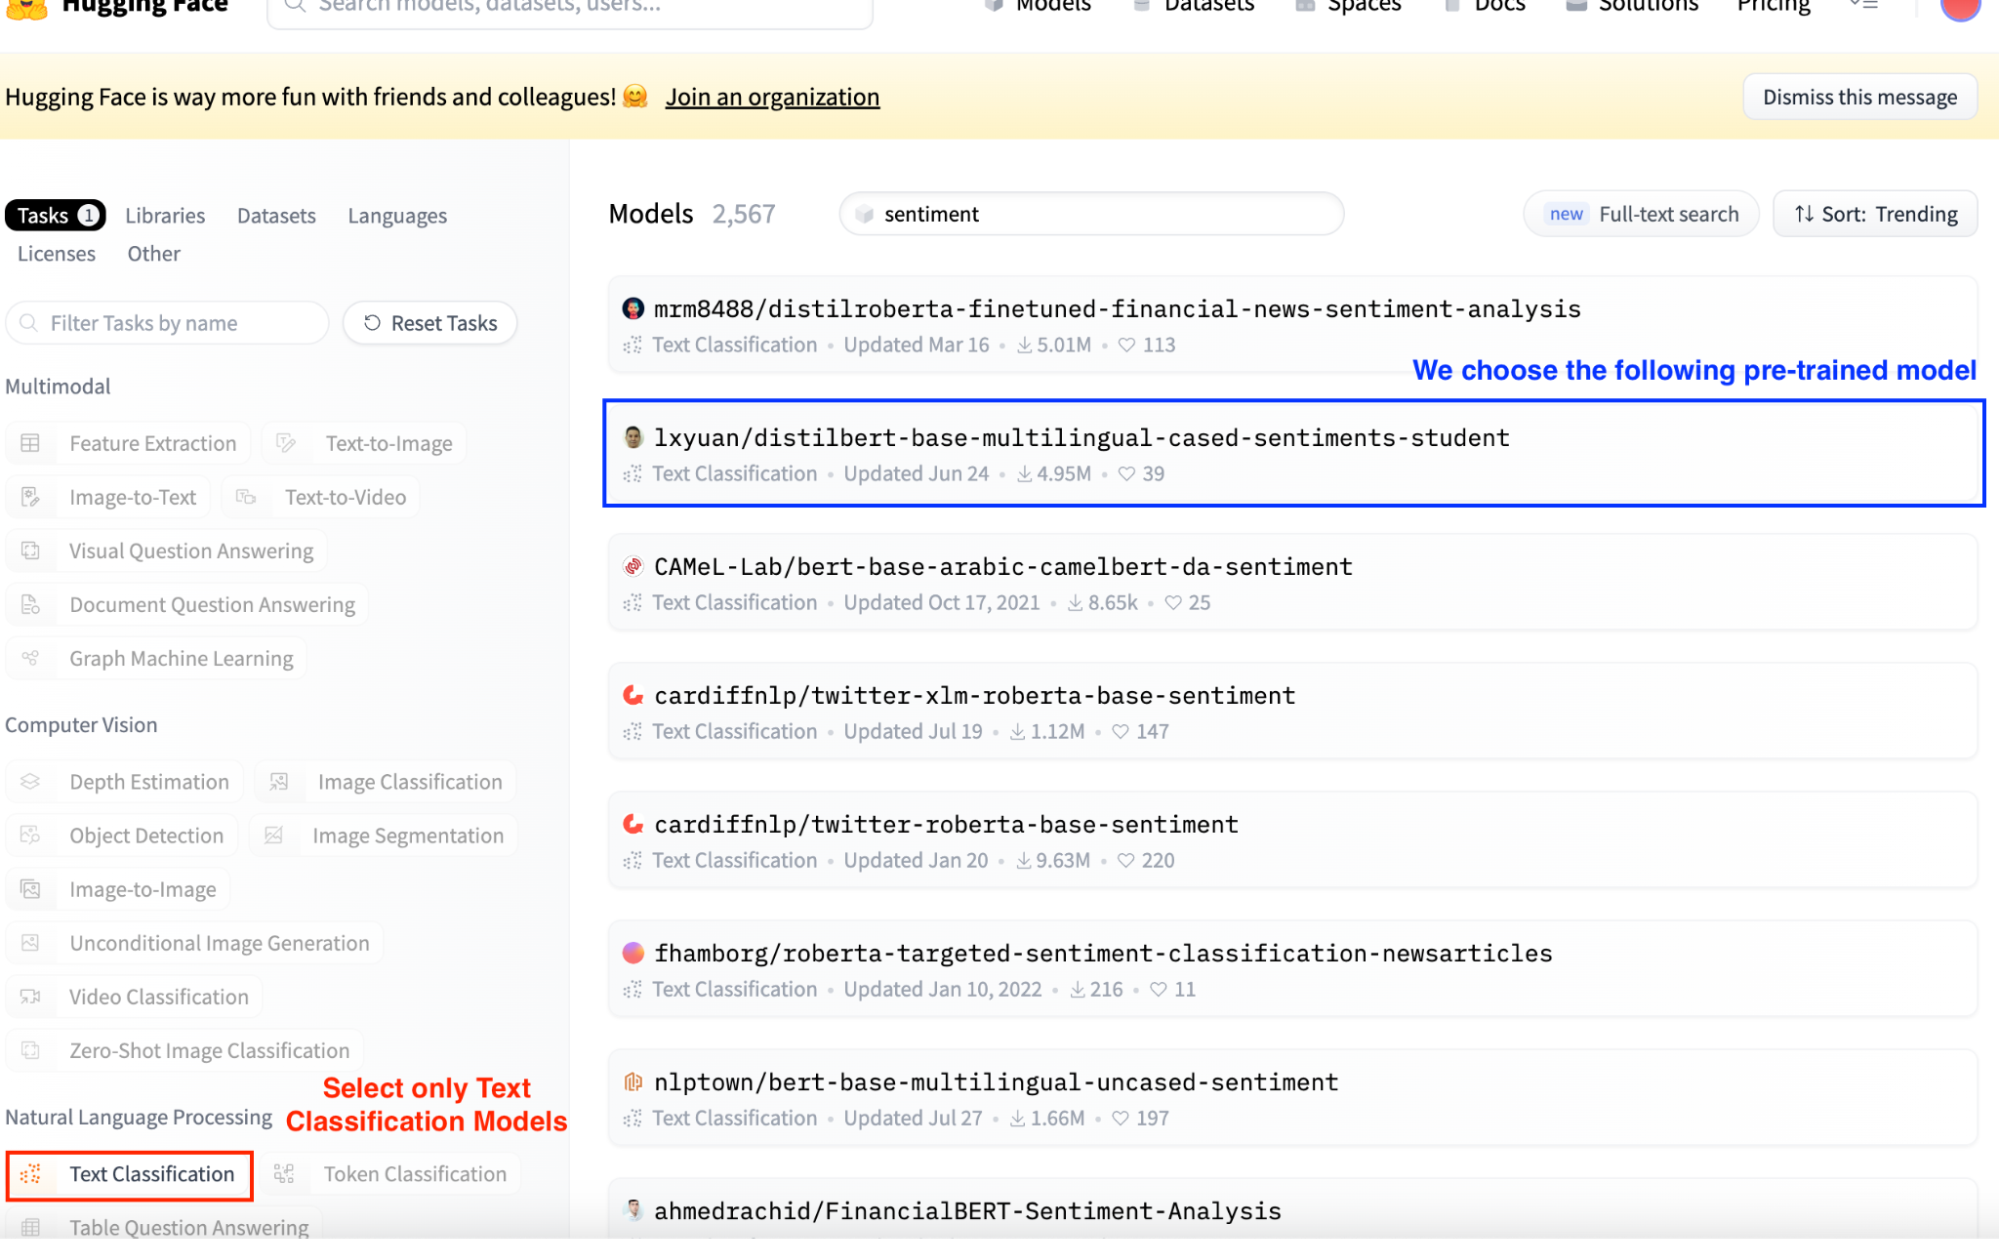
Screenshot tampilan utama Hugging Face Model Hub. Memilih model Text Classification.
Untuk menggunakannya, kita perlu menyalin nama model yang sesuai. Nama tersebut dapat ditemukan di bagian atas tampilan spesifik modelnya.
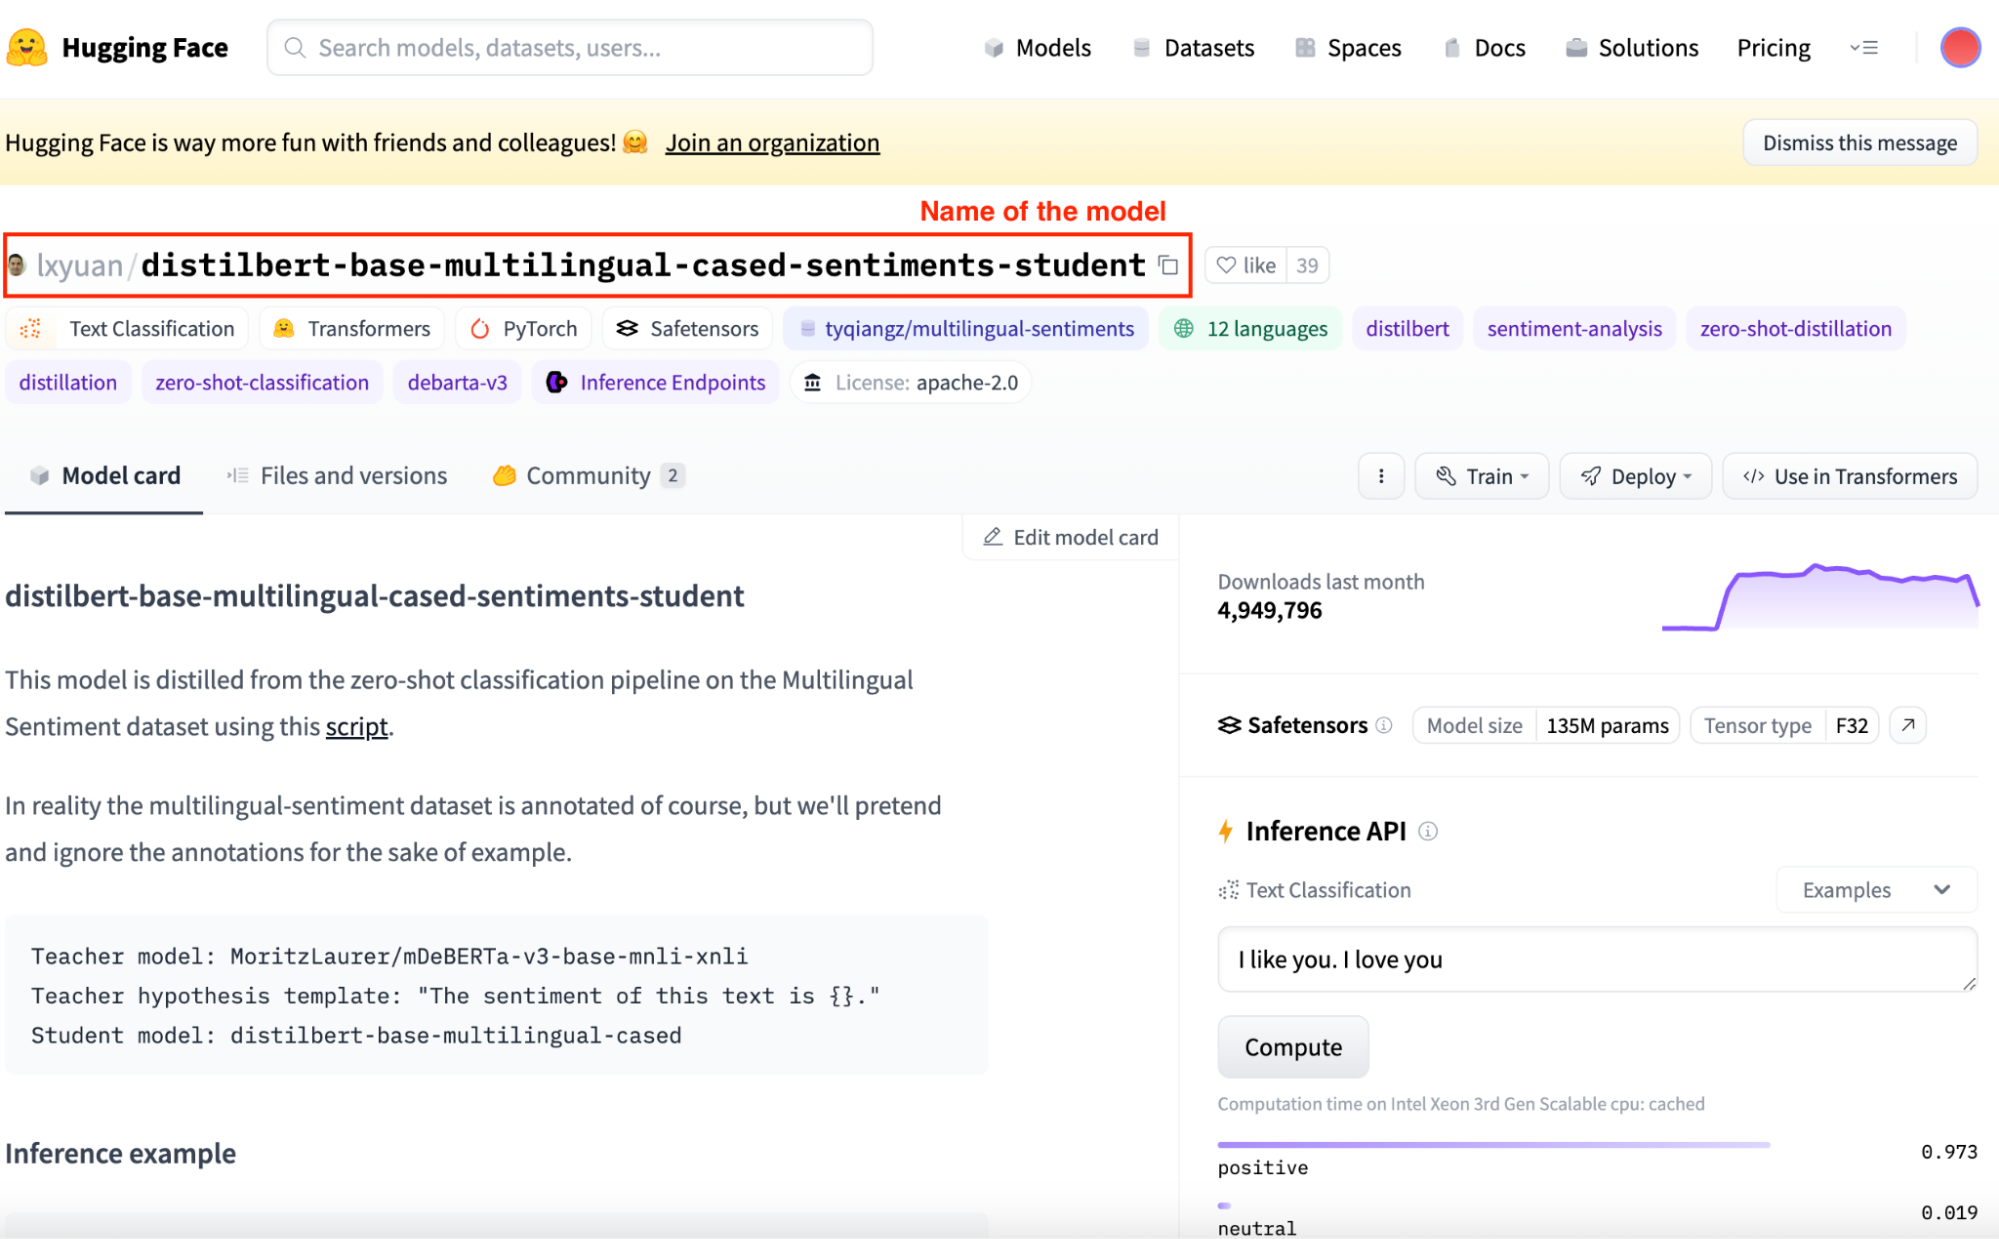
Screenshot tampilan model spesifik di Hugging Face Model Hub.
1. Muat model pra-latih: Sekarang kita sudah tahu model apa yang akan digunakan, mari kita gunakan di Python. Pertama kita perlu mengimpor kelas AutoTokenizer dan AutoModelForSequenceClassification dari transformers.
Menggunakan kelas AutoModel ini akan secara otomatis menginferensikan arsitektur model dari nama model.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Siapkan masukan Anda: Muat tokenizer untuk model kita; dalam hal ini, pustaka transformers mempermudah proses karena menginferensikan tokenizer yang akan digunakan dari nama model yang kita pilih.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Jalankan model: Hasilkan objek pipeline dengan model yang dipilih, tokenizer, dan tugas yang akan dilakukan. Dalam kasus kita, analisis sentimen. Jika Anda menginisialisasi objek classifier dengan tugasnya, kelas pipeline akan mengisinya dengan nilai bawaan, meskipun ini tidak direkomendasikan di produksi.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Kita dapat mengeksekusi model ini dengan memberikan beberapa masukan.
output = classifier("I've been waiting for this tutorial all my life!")
4. Interpretasikan keluaran: Model akan mengembalikan objek yang berisi berbagai elemen tergantung pada kelas model. Misalnya, untuk contoh analisis sentimen ini, kita akan mendapat:
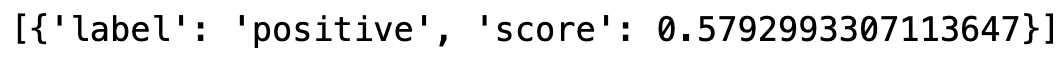
Keluaran yang diperoleh.
Fine-tuning adalah proses mengambil model pra-latih dan memperbarui parameternya dengan melatih pada dataset yang spesifik untuk tugas Anda. Ini memungkinkan Anda memanfaatkan representasi yang telah dipelajari model dan menyesuaikannya dengan kasus penggunaan Anda.
Bayangkan kita perlu menggunakan model pengklasifikasi teks untuk menginferensikan sentimen dari daftar tweet. Satu pertanyaan wajar yang muncul: Apakah model pra-latih ini akan bekerja dengan baik?
Untuk memastikan, kita dapat memanfaatkan fine-tuning dengan melatih model Hugging Face pra-latih menggunakan dataset yang berisi tweet dan sentimennya sehingga kinerjanya meningkat.
Berikut contoh dasar fine-tuning model untuk klasifikasi sekuens:
1. Pilih model pra-latih dan dataset: Pilih arsitektur model yang cocok untuk tugas Anda. Dalam hal ini, kita ingin tetap menggunakan model analisis sentimen yang sama. Namun, sekarang kita membutuhkan data untuk melatih model kita.
Dan di sinilah pustaka datasets berperan. Kita dapat menelusuri semua dataset di Model Hub, dan menemukan yang paling sesuai.
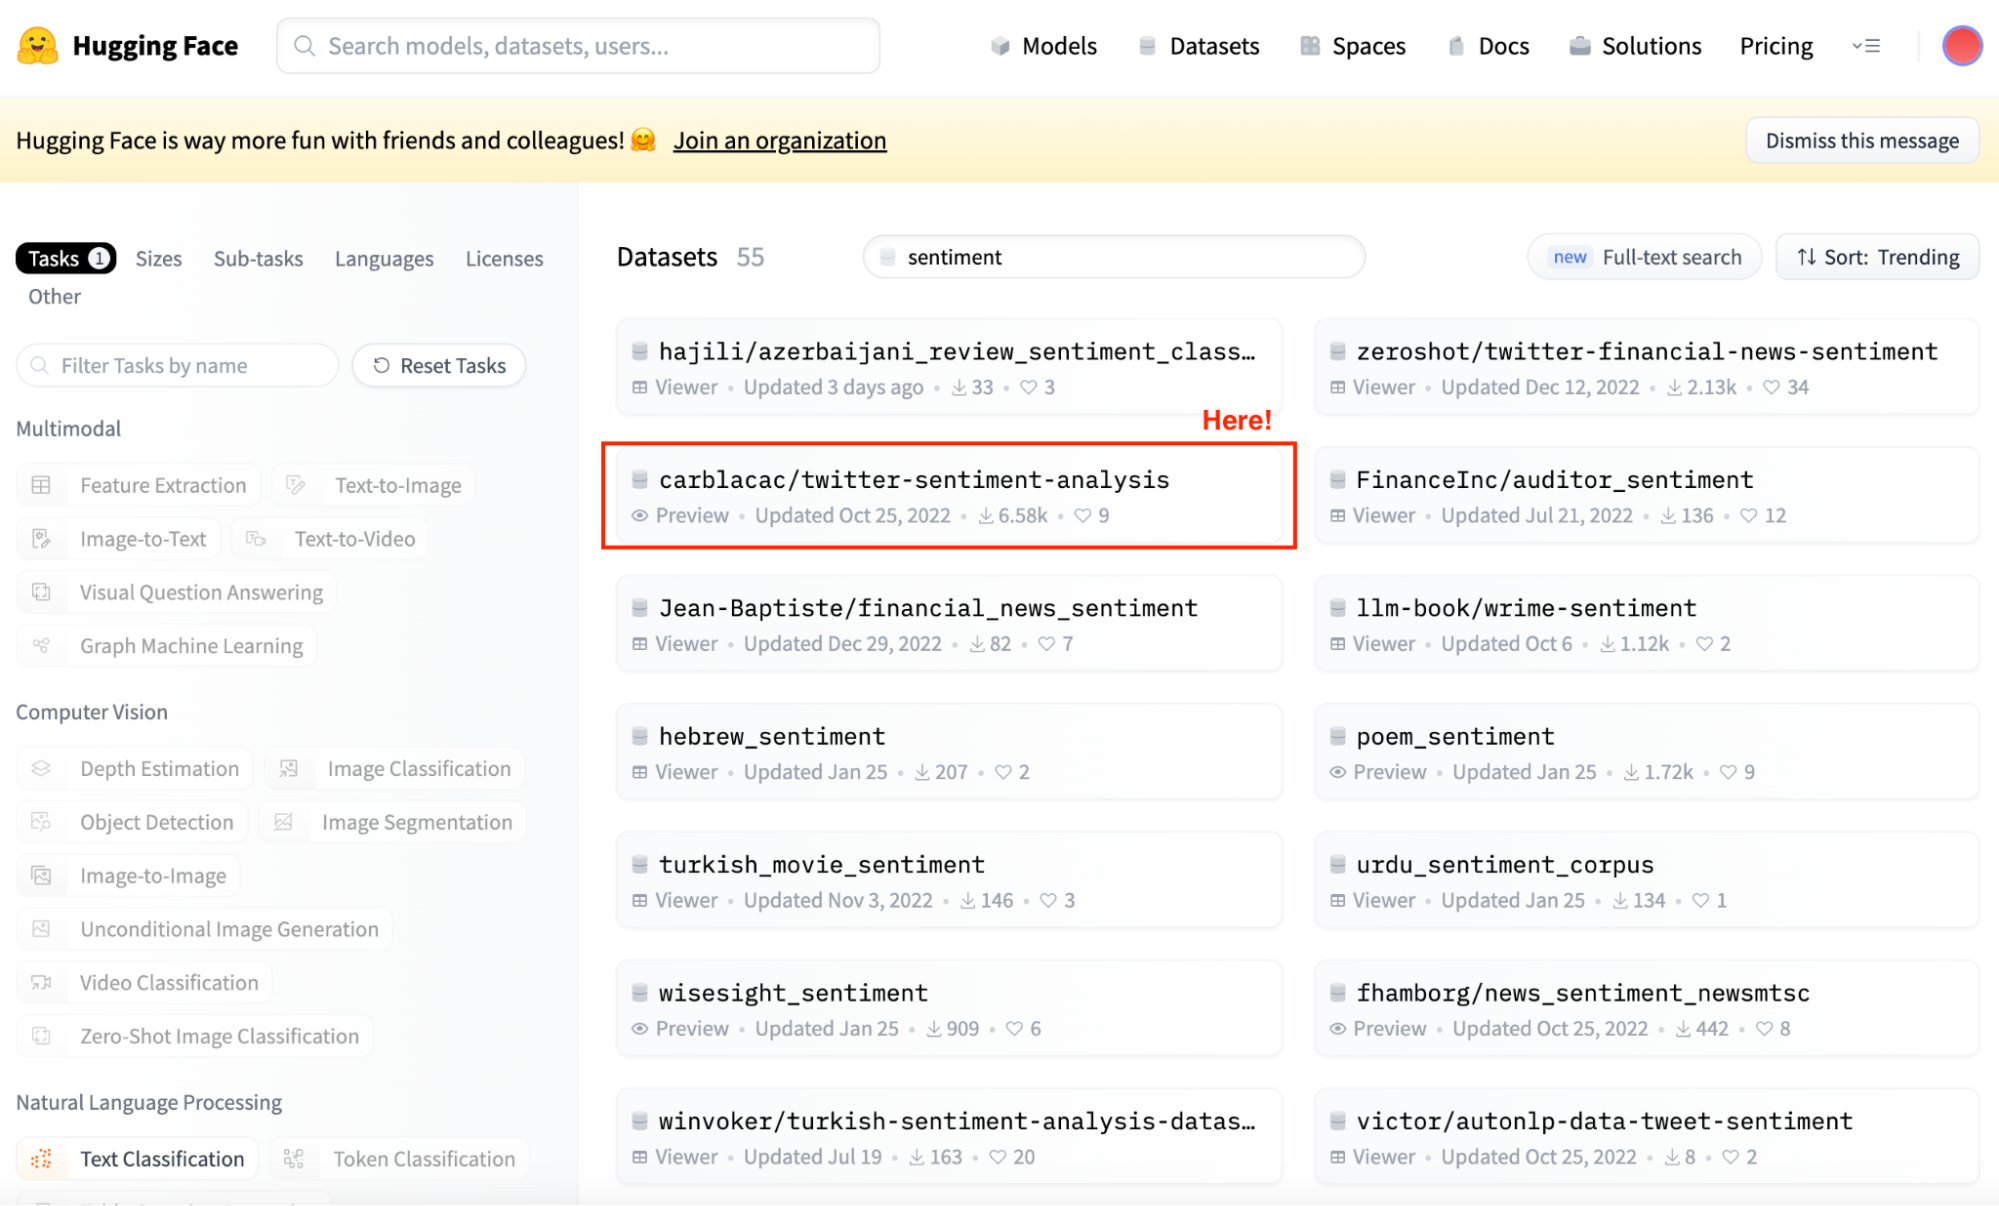
Screenshot tampilan utama Hugging Face Datasets Hub. Memilih dataset analisis sentimen.
Sekarang setelah saya tahu dataset mana yang dipilih, kita dapat dengan mudah menginisialisasi model dan dataset.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Jika kita periksa dataset yang baru saja diunduh, ini adalah kamus yang berisi subset untuk pelatihan dan subset untuk pengujian. Jika kita konversi subset pelatihan ke dataframe, tampilannya sebagai berikut:
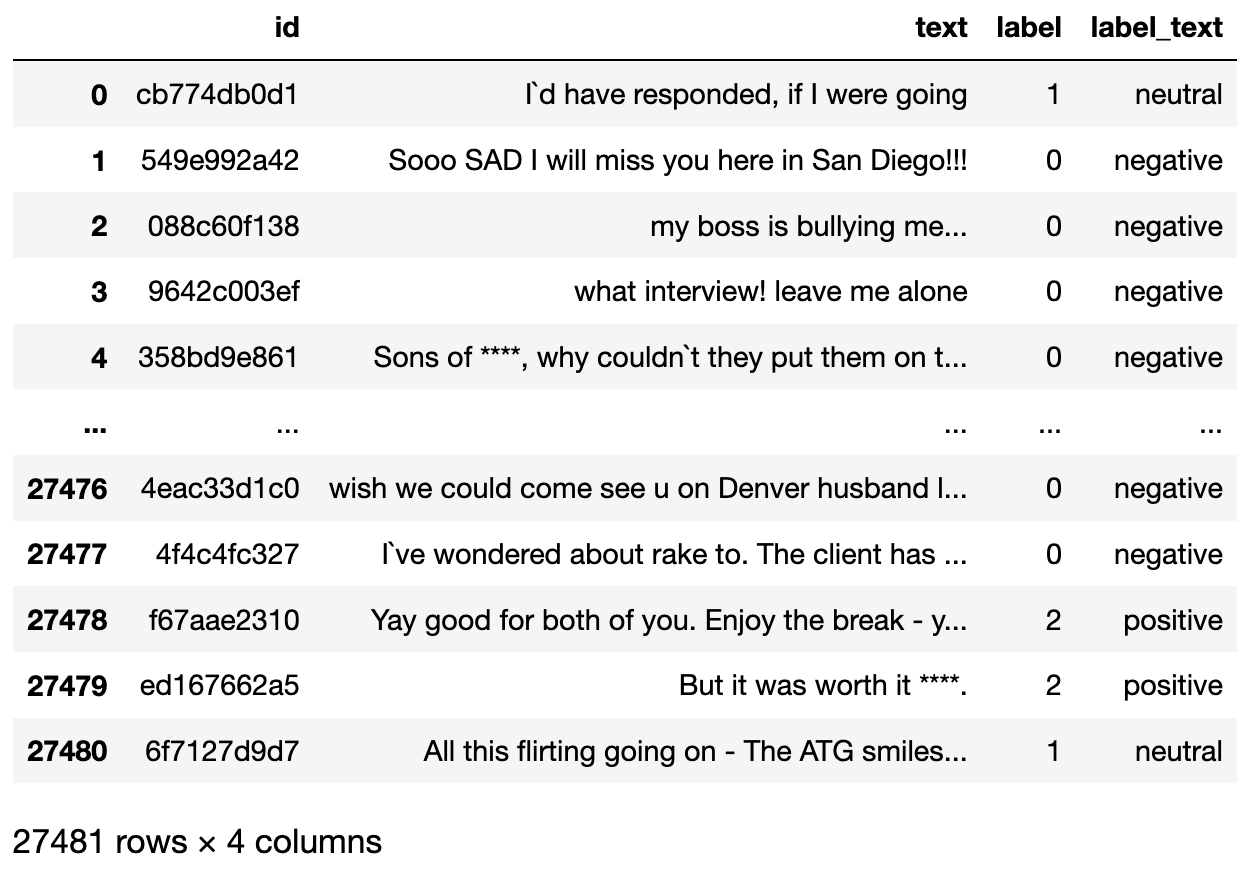
Dataset yang akan digunakan.
2. Siapkan dataset Anda: Kini setelah kita memiliki dataset, kita memerlukan tokenizer untuk menyiapkannya agar dapat diurai oleh model kita. Variabel teks pada dataset perlu ditokenisasi agar bisa digunakan untuk fine-tuning model kita.
Inilah mengapa langkah kedua adalah memuat Tokenizer pra-latih dan men-tokenisasi dataset kita agar dapat digunakan untuk fine-tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Bangun dataset PyTorch dengan encoding: Langkah ketiga adalah menghasilkan dataset pelatihan dan pengujian. Set pelatihan akan digunakan untuk fine-tuning model kita, sementara set pengujian digunakan untuk evaluasi.
Biasanya, proses fine-tuning memakan banyak waktu. Untuk mempermudah tutorial, kita melakukan sampel acak pada kedua dataset untuk mengurangi waktu komputasi.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Fine-tune model: Langkah terakhir adalah menyiapkan argumen pelatihan dan memulai proses pelatihan. Pustaka transformers memiliki kelas trainer(), yang menangani semuanya.
Kita terlebih dahulu mendefinisikan argumen pelatihan beserta strategi evaluasinya. Setelah semuanya didefinisikan, kita dapat dengan mudah melatih model dengan perintah train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Evaluasi model: Setelah pelatihan, evaluasi kinerja model pada set validasi atau pengujian. Sekali lagi, kelas trainer sudah memiliki metode evaluate yang menanganinya.
import evaluate

trainer.evaluate()
Model yang kita fine-tune menunjukkan akurasi 70%.
Sekarang setelah kita meningkatkan model, bagaimana cara membagikannya dengan komunitas? Ini membawa kita ke langkah terakhir.
Setelah kita melakukan fine-tuning pada model, Anda mungkin ingin membagikannya dengan komunitas.
Hugging Face membuat proses ini menjadi sederhana. Pertama, Anda perlu memasang pustaka huggingface_hub.
Syarat untuk langkah terakhir ini adalah memiliki token aktif agar dapat terhubung ke akun Hugging Face Anda. Anda dapat dengan mudah mendapatkannya mengikuti panduan ini. Saat bekerja di Jupyter Notebook, kita dapat dengan mudah mengimpor pustaka notebook_login.
from huggingface_hub import notebook_login

notebook_login()
Ini akan menghasilkan proses login di Jupyter Notebook kita. Kita hanya perlu mengirimkan token, dan notebook kita akan terhubung ke akun Hugging Face kita.
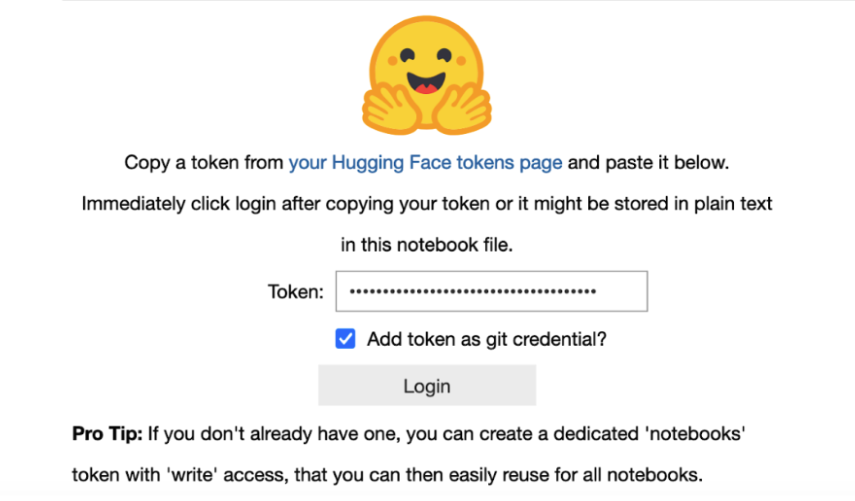
Sekarang kita hanya perlu mengunggah model menggunakan perintah push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Dan setelah itu, model akan tersedia untuk semua orang di profil Hugging Face kita.
Jika kita ingin menstandarkan proses NLP apa pun, dengan Hugging Face, biasanya melibatkan tiga langkah sederhana yang memerlukan kurang dari lima baris kode:
1. Definisikan objek model dengan kelas pipeline (beserta model dan tokenizer yang sesuai).
2. Definisikan teks masukan atau prompt.
3. Jalankan model pra-latih dengan masukan kita dan amati keluarannya.
Klasifikasi teks adalah tugas fundamental dalam NLP. Tugas ini terdiri dari memberikan satu atau lebih kategori pada setiap teks masukan. Ini dapat digunakan untuk berbagai aplikasi seperti deteksi spam, analisis sentimen, pelabelan topik, dan lainnya.
Anda dapat melihat contoh kode di bawah, bagaimana, hanya dengan tiga langkah sederhana yang disediakan pada bagian sebelumnya, kita dapat mengimplementasikan model klasifikasi teks.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Mudah, bukan?
Maka mari beralih ke use case kedua dan salah satu yang paling sering digunakan sepanjang masa.
Kebanyakan dari Anda pasti sudah familiar dengan ChatGPT atau Google Bard, yang merupakan alat untuk menghasilkan teks dari prompt masukan. Proses ini disebut “Text Generation,” dan ini adalah aspek menarik dari NLP, di mana model menghasilkan teks yang mirip manusia dari masukan awal.
Ini memiliki beragam aplikasi, dari membuat respons chatbot hingga menghasilkan karya tulis kreatif.
Gagasan utamanya adalah melatih model pada korpus teks yang besar, sehingga memungkinkannya mempelajari pola, gaya, dan struktur bahasa. Seperti yang Anda bayangkan, bagian paling mahal adalah pelatihan model itu sendiri.
Namun, Hugging Face memungkinkan kita mengimplementasikan model seperti itu hanya dalam lima baris kode, seperti pada kasus sebelumnya.
Lihat contoh di bawah:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Question answering, biasa disingkat QA, adalah bidang dalam NLP yang berfokus pada pembangunan sistem yang secara otomatis menjawab pertanyaan yang diajukan manusia dalam bahasa alami.
Sistem QA digunakan luas dalam berbagai aplikasi, seperti asisten virtual, dukungan pelanggan, dan sistem temu kembali informasi.
Sistem QA secara garis besar dapat dikategorikan menjadi dua jenis:
Sistem ini biasanya menggunakan kombinasi pemahaman bahasa alami untuk menafsirkan pertanyaan dan temu kembali informasi untuk menemukan jawaban yang relevan.
Sekali lagi, mengimplementasikan salah satu model ini menggunakan Hugging Face cepat dan mudah.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
Use case terakhir adalah terjemahan. Machine translation adalah subbidang linguistik komputasional yang berfokus pada penerjemahan teks atau ujaran dari satu bahasa ke bahasa lain menggunakan perangkat lunak. Dengan hadirnya deep learning, machine translation mengalami kemajuan signifikan, khususnya dengan model seperti Neural Machine Translation (NMT) yang menggunakan jaringan saraf besar.
Sistem NMT modern, berbeda dengan model terjemahan berbasis aturan atau statistik tradisional, belajar menerjemahkan dengan dilatih pada dataset besar teks dwibahasa. Mereka menggunakan arsitektur sequence-to-sequence, di mana satu bagian jaringan mengenkode teks sumber, dan bagian lain mendekodenya ke bahasa target, sering kali dengan kefasihan dan akurasi yang mengesankan.
Contoh sederhana menggunakan Hugging Face adalah:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face telah muncul sebagai kekuatan transformatif di bidang kecerdasan buatan dan natural language processing. Rangkaian alatnya yang komprehensif, termasuk pustaka Transformers yang revolusioner, Model Hub kolaboratif, dan pustaka Datasets yang ekstensif, telah mendemokratisasi akses ke kapabilitas NLP tingkat lanjut.
Dengan menumbuhkan lingkungan di mana inovasi dibagikan dan dibangun secara kolektif, Hugging Face tidak hanya berkontribusi pada kemajuan AI, tetapi juga membentuk masa depan di mana teknologi lebih mudah diakses, inklusif, dan kuat.
Saat kita terus menyaksikan dan berpartisipasi dalam revolusi AI, Hugging Face mengingatkan bahwa kemajuan teknologi paling mendalam adalah yang bersifat terbuka, dibagikan, dan dibangun bersama.
Ini bukan hanya tentang menciptakan mesin yang lebih cerdas, melainkan juga memupuk komunitas pengembang, peneliti, dan penggemar yang lebih cerdas dan lebih terhubung, yang bersemangat mendorong batas kemungkinan.
Start Your AI & NLP Journey Today!
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt



