Cursus
Werken met Hugging Face
2 uur
40K
Wat als iedereen geavanceerde kunstmatige intelligentie kon gebruiken, en niet alleen de grote techbedrijven? Dat is het idee achter Qwen, een nieuwe familie AI-modellen van Alibaba Cloud.
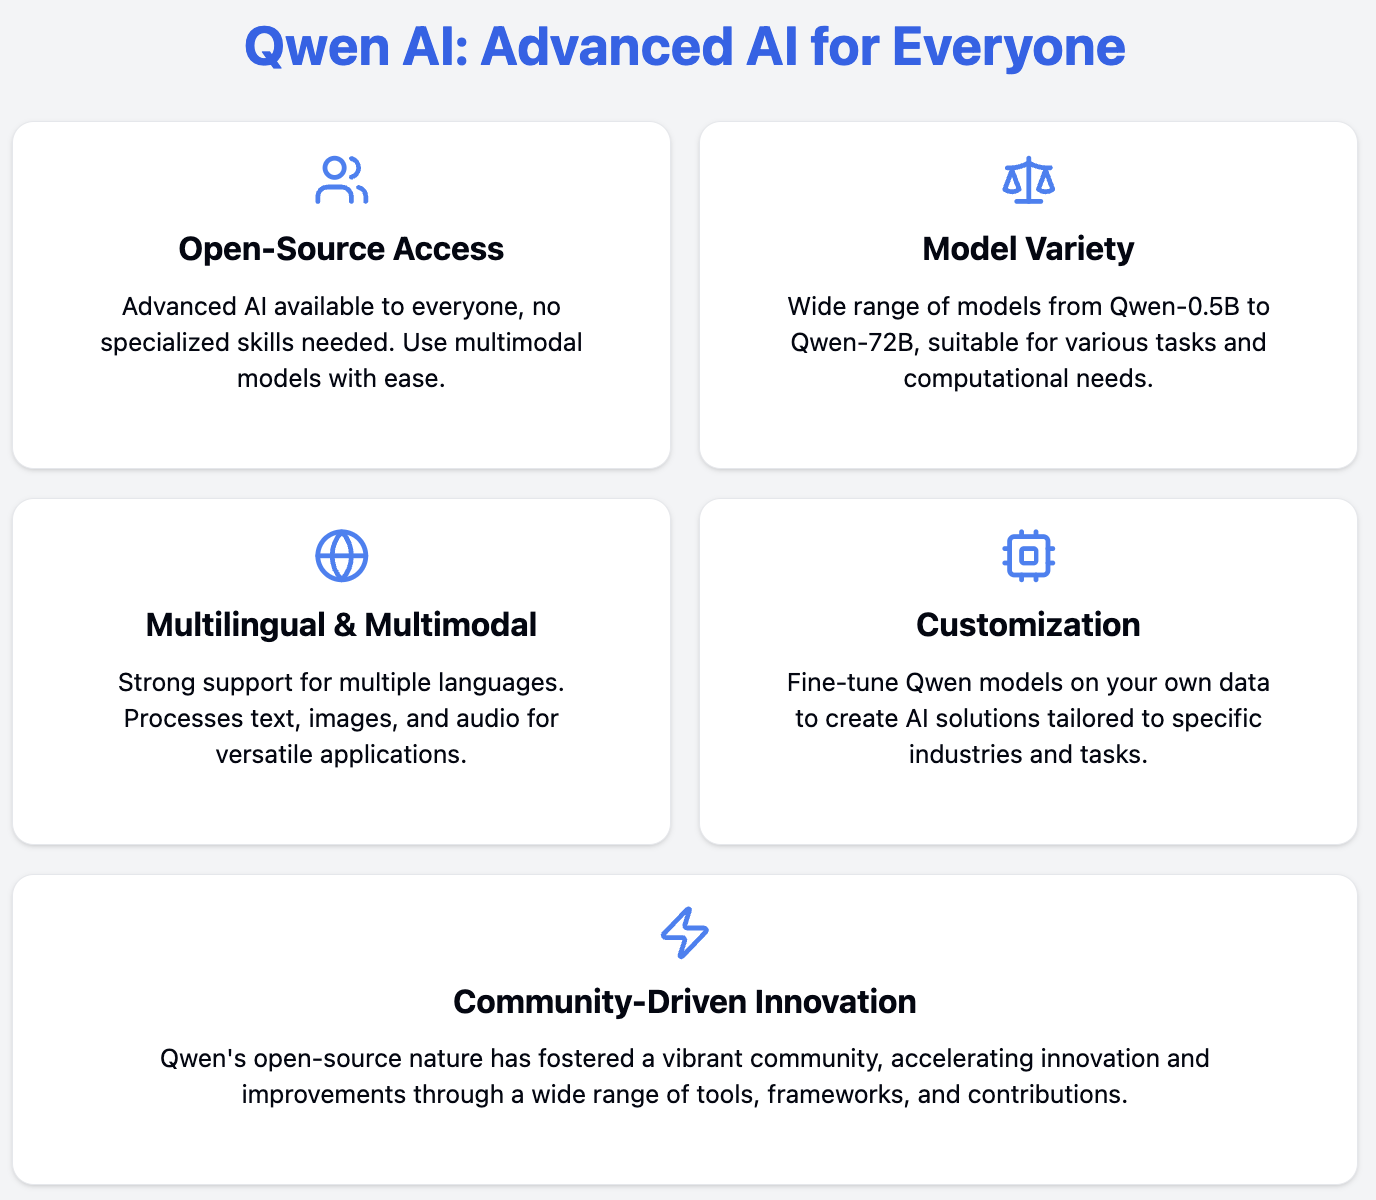
Qwen (een afkorting van Tongyi Qianwen) wil AI-modellen voor iedereen toegankelijk maken met een set AI-tools van Alibaba Cloud. Qwen doet dit door het aanbieden van:
Met Qwen heb je minder middelen en minder gespecialiseerde kennis nodig om geavanceerde AI te gebruiken.
In deze tutorial gaan we:
Qwen is een serie krachtige modellen, getraind op enorme meertalige en multimodale datasets. Ontwikkeld door Alibaba Cloud, tilt Qwen AI naar een hoger niveau en maakt het slimmer en nuttiger voor natural language processing, computervisie en audiobegrip.
Deze modellen kunnen een breed scala aan taken uitvoeren, waaronder:
De Qwen-modellen zijn voorgetraind op diverse databronnen en verder verfijnd via post-training op hoogwaardige data.
De Qwen-familie bestaat uit verschillende gespecialiseerde modellen voor uiteenlopende behoeften en use-cases.
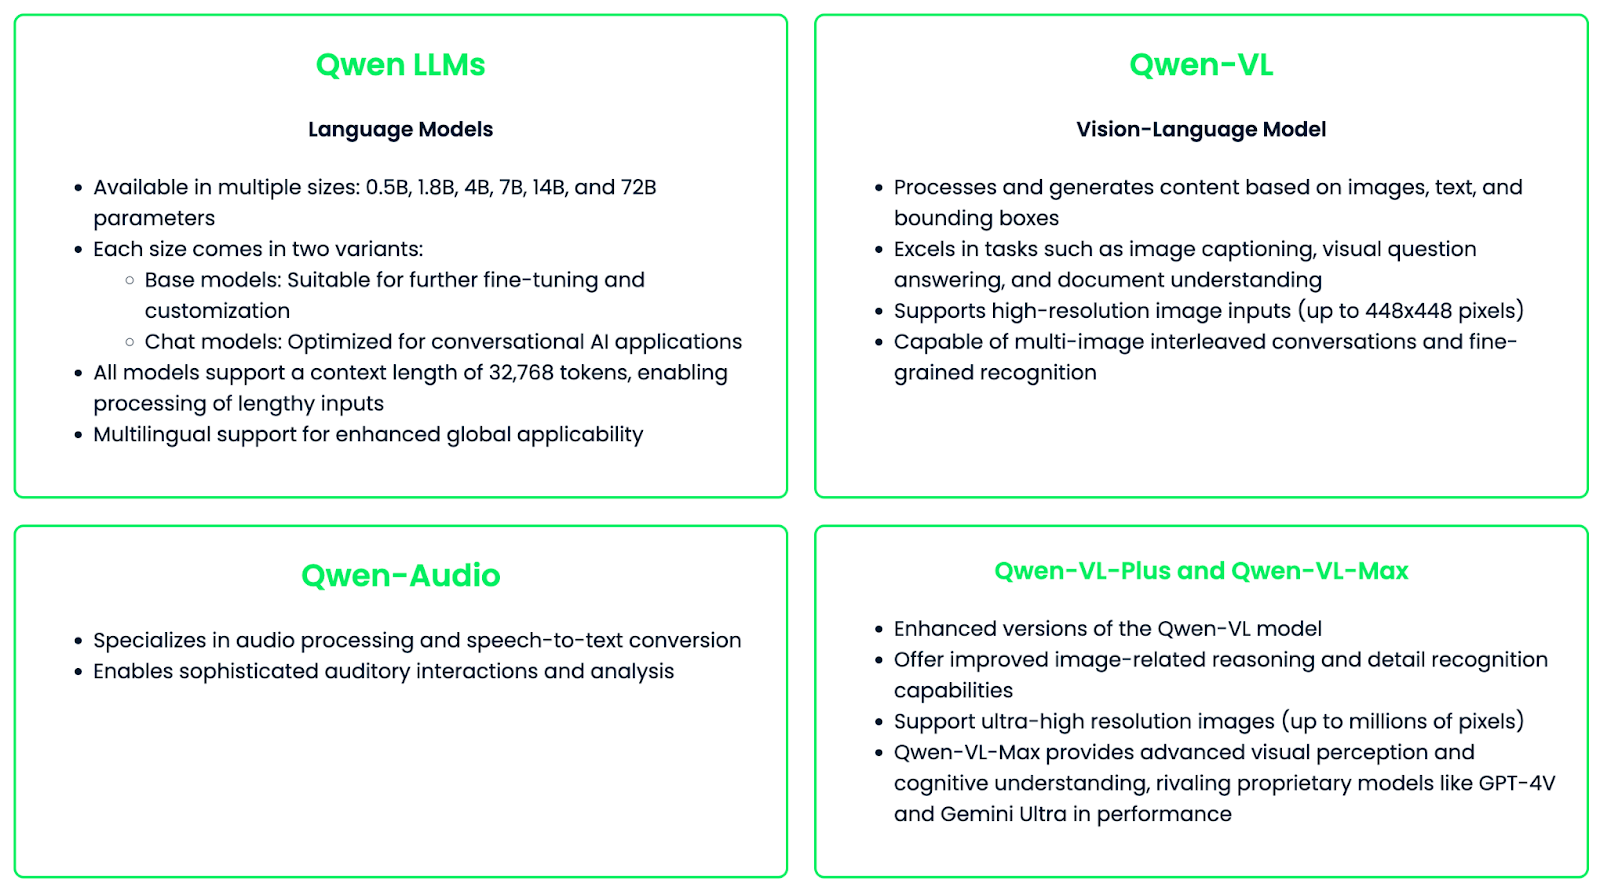
De Qwen-modellen zijn ontworpen voor veelzijdigheid en eenvoudige aanpasbaarheid, met mogelijkheden voor fine-tuning voor specifieke toepassingen of sectoren. Die flexibiliteit, gecombineerd met hun krachtige capaciteiten, maakt Qwen een waardevolle bron voor AI-technologie in verschillende domeinen.
De modellenfamilie van Qwen biedt een krachtig en veelzijdig hulpmiddel voor uiteenlopende AI-toepassingen. Laten we de belangrijkste kenmerken bekijken die Qwen onderscheiden:
Qwen blinkt uit in meertalig begrijpen en genereren, met sterke capaciteiten in zowel Engels als Chinees, en ondersteuning voor tal van andere talen. De nieuwste Qwen2-modellen hebben hun taalaanbod uitgebreid met 27 extra talen, waaronder West-, Oost- en Centraal-Europa, het Midden-Oosten, Oost-Azië en Zuid-Azië.
Dankzij die brede taalondersteuning kan Qwen grensoverschrijdende communicatie vergemakkelijken, hoogwaardige vertalingen leveren, code-switching aan, en wereldwijde toepassingen bedienen met gelokaliseerde contentgeneratie.
Qwen-modellen zijn zeer bedreven in uiteenlopende tekstgeneratietaken. Belangrijke toepassingen zijn onder meer:
Het vermogen om context te behouden over lange sequenties (tot 32.768 tokens) maakt uitgebreide en samenhangende tekstopvoer mogelijk.
Qwen is ook sterk in zowel feitelijke als open vraagbeantwoording. Dit maakt mogelijk:
Met het Qwen-VL-model breidt de Qwen-familie zijn capaciteiten uit naar multimodale taken met beelden. Belangrijke functies zijn:
Een van de belangrijkste kenmerken van Qwen is het open-sourcekarakter, wat de AI-community verschillende voordelen biedt:
De open-sourcebenadering heeft geleid tot brede ondersteuning door projecten en tools van derden:
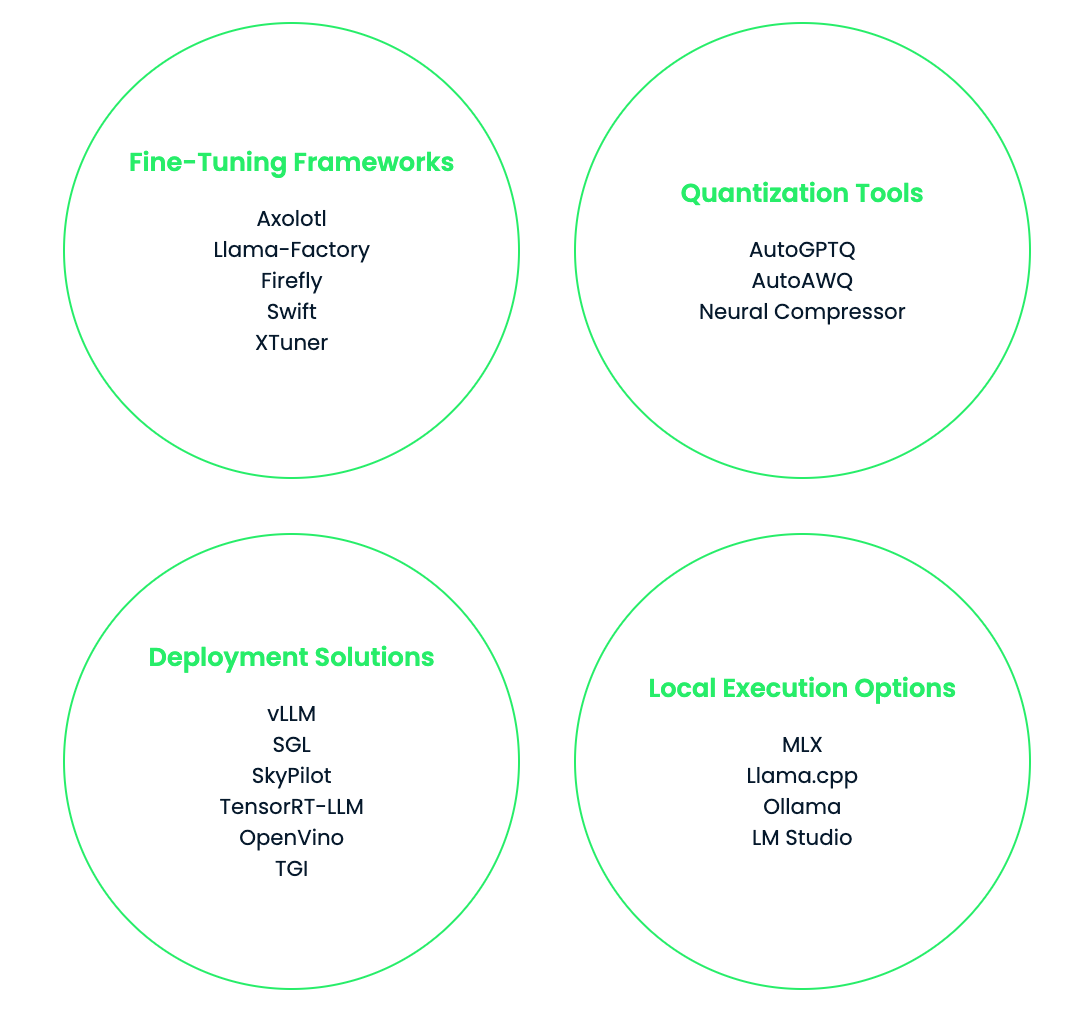
Nu je Qwen en de belangrijkste kenmerken kent, is het tijd om te leren hoe je het in de praktijk gebruikt!
Qwen-modellen zijn beschikbaar op meerdere platforms, waardoor ze zeer toegankelijk zijn voor uiteenlopende use-cases.
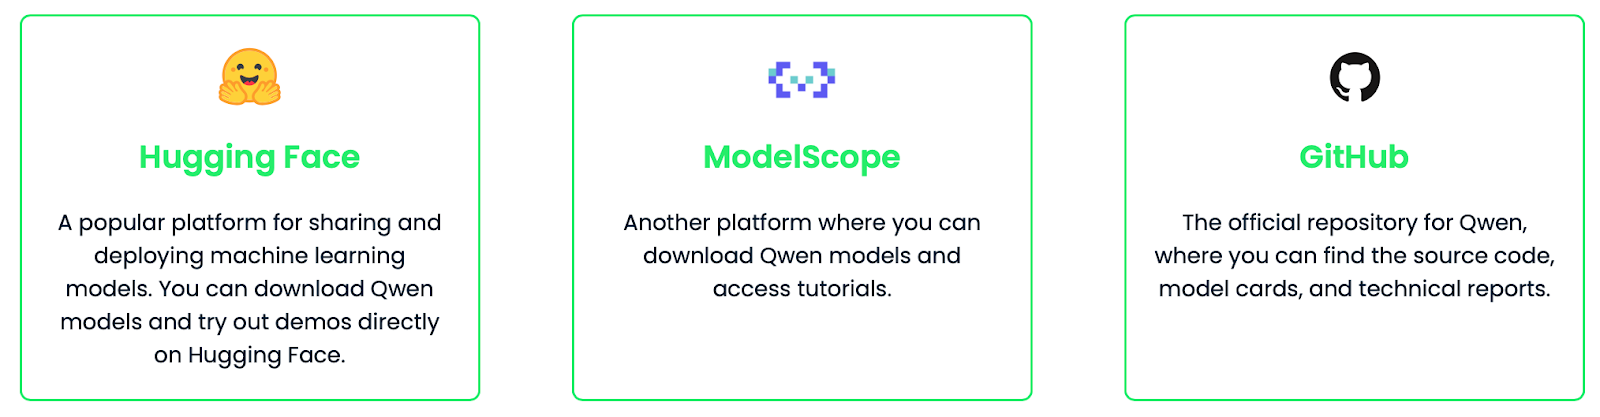
In deze sectie laat ik zien hoe je het Qwen-7B-taalmodel gebruikt via Hugging Face. We behandelen het inrichten van je omgeving, inloggen bij Hugging Face en het model draaien.
Installeer eerst de benodigde libraries:
pip install transformers torch huggingface_hubOm toegang te krijgen tot het Qwen-7B-model moet je inloggen bij je Hugging Face-account. Dit is nodig omdat sommige modellen gebruiksbeperkingen hebben, maar je hebt nog steeds toegang tot privémodellen van jezelf of je organisatie. Dit helpt bij het monitoren van API-gebruik en het toepassen van snelheidslimieten indien nodig.
Log in met deze stappen:
1. Ga naar Hugging Face.
2. Ga naar je profielinstellingen en maak een access token aan.
3. Voer in je terminal uit:
huggingface-cli login4. Voer wanneer daarom wordt gevraagd je access token in.
We maken nu een Python-bestand of Jupyter Notebook waarin we onze code gaan schrijven.
Eerst importeren we twee klassen uit de transformers-library:
AutoModelForCausalLM: Deze klasse kiest automatisch de juiste modelarchitectuur op basis van de modelnaam die je opgeeft.AutoTokenizer: Deze klasse laadt de juiste tokenizer voor het model dat je gebruikt.from transformers import AutoModelForCausalLM, AutoTokenizerWe geven nu aan welk model we willen gebruiken. "Qwen/Qwen-7B" verwijst naar de 7 miljard-parameter-versie van het Qwen-model dat wordt gehost op de Hugging Face model hub, maar voel je vrij om andere Qwen-modellen te gebruiken.
model_name = "Qwen/Qwen-7B"Vervolgens moeten we de tokenizer laden.
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)Deze regel laadt de tokenizer die hoort bij het Qwen-7B-model. De parameter trust_remote_code=True is nodig omdat Qwen-modellen mogelijk aangepaste code moeten uitvoeren tijdens het laden.
De volgende stap is het model laden.
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)Dit laadt het daadwerkelijke Qwen-7B-model. Opnieuw gebruiken we trust_remote_code=True om eventuele aangepaste code die bij het model hoort toe te staan.
Zodra we het model hebben geladen, kunnen we testen of het werkt door tekst te genereren op basis van een invoer.
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
Hier bereiden we de invoer voor het model voor:
input_text als onze prompt.return_tensors="pt" geeft aan dat we de output in PyTorch-tensorformaat willen.Nu genereren we de tekst:
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
De eerste regel code geeft het model de opdracht om tekst te genereren:
inputs door aan de generate-methode.**inputs pakt de dictionary uit die door de tokenizer is teruggegeven.max_new_tokens=50 beperkt de generatie tot maximaal 50 nieuwe tokens.generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)Deze stap zet de modeluitvoer (in token-ID-formaat) terug naar leesbare tekst:
outputs selecteert de eerste en in dit geval enige gegenereerde sequentie.skip_special_tokens=True vertelt de decoder speciale tokens zoals padding of end-of-sequence te negeren.Tot slot printen we de gegenereerde tekst om het resultaat te zien.
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…Hier zijn enkele nuttige notities en tips:
trust_remote_code=True is noodzakelijk voor Qwen-modellen omdat ze aangepaste code nodig hebben om goed te werken.Qwen-modellen kunnen worden gedeployed met Alibaba Cloud’s Platform for AI (PAI) en Elastic AI Serving (EAS). Zo kun je met een paar klikken een Qwen-model deployen:
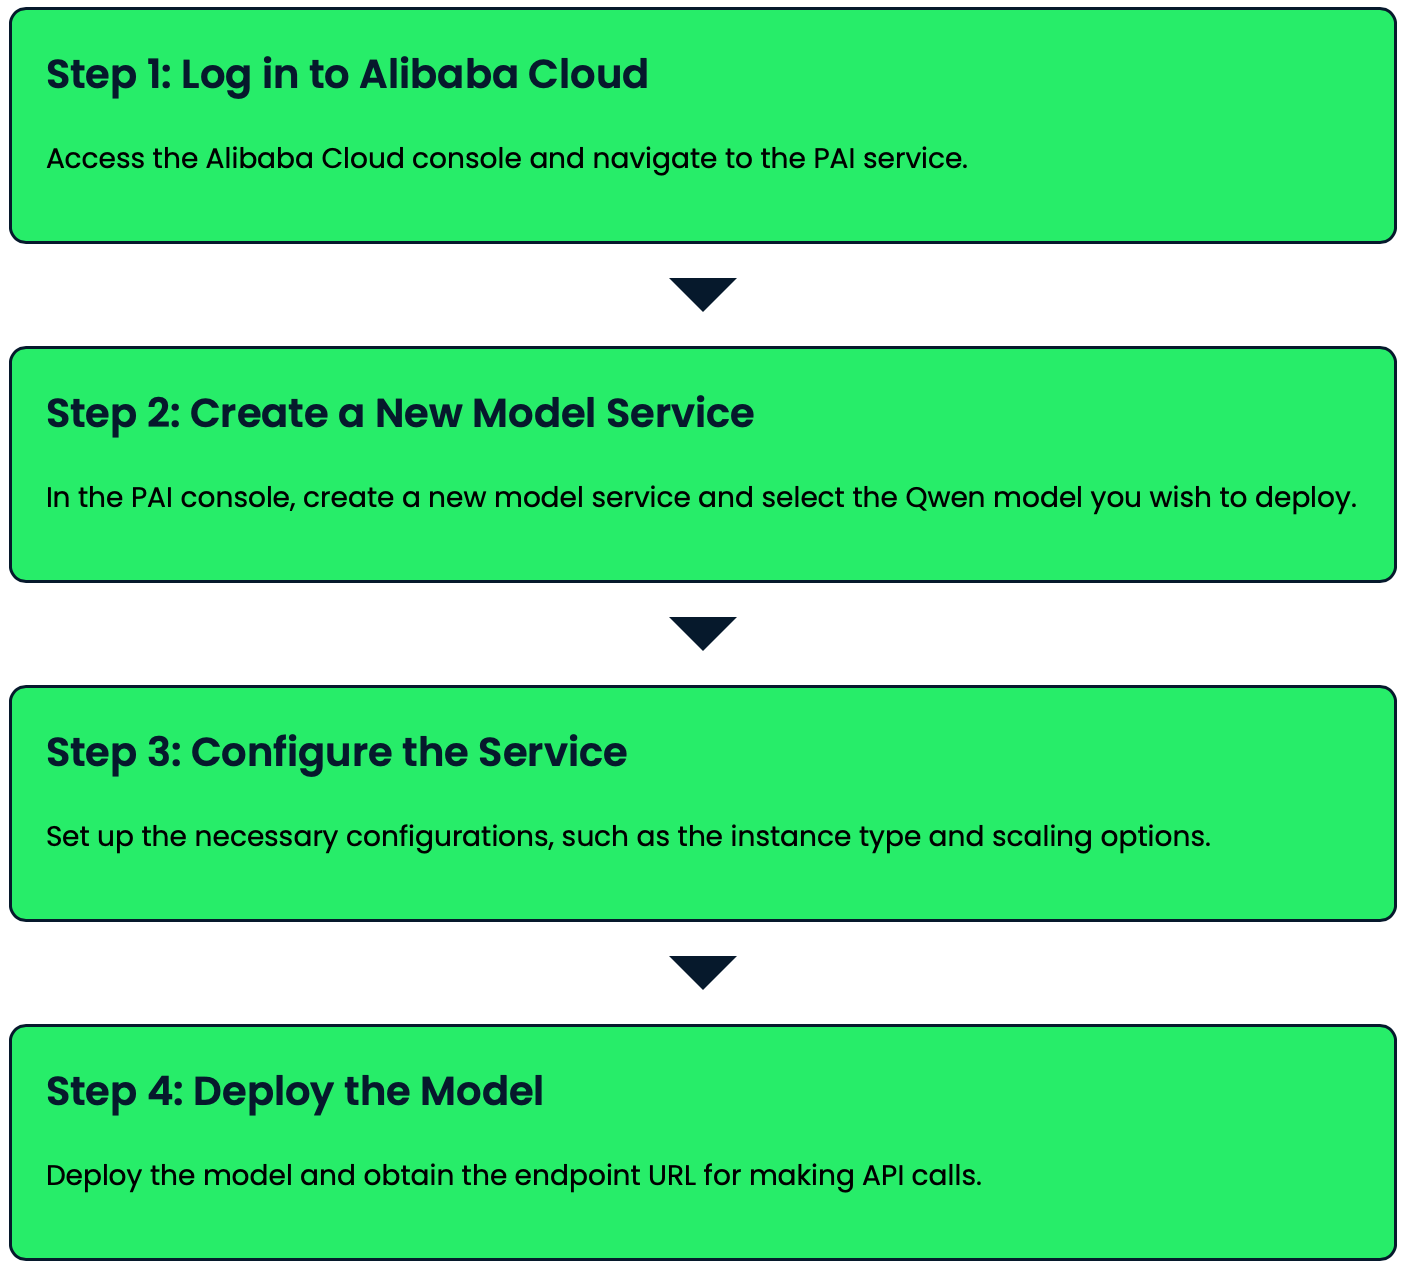
Laten we enkele praktische voorbeelden verkennen van Qwen voor tekstgeneratie- en vraagbeantwoordingstaken.
Qwen is erg goed in het genereren van coherente en contextueel relevante tekst op basis van prompts. Laten we enkele voorbeelden bekijken:
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen kan een breed scala aan vragen beantwoorden, van feitelijke vragen tot meer open of analytische vragen. Hier zijn enkele voorbeelden:
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.Deze voorbeelden laten zien hoe Qwen verschillende types tekstgeneratie en vraagbeantwoording aankan.
Je kunt parameters zoals max_new_tokens en temperature aanpassen om de lengte en creativiteit van de gegenereerde antwoorden te sturen, passend bij jouw behoeften.
Fine-tuning van Qwen-modellen stelt je in staat ze aan te passen aan specifieke taken, wat de prestaties voor jouw use-case kan verbeteren. Dit proces houdt in dat je het voorgetrainde model traint op een eigen dataset, zodat het taakspecifieke kennis leert en tegelijk de algemene taalbegripscapaciteiten behoudt.
In deze sectie lopen we door het proces van het fine-tunen van het Qwen-7B-model op een eigen dataset. We gebruiken efficiënte fine-tuningtechnieken om dit beheersbaar te maken, zelfs voor grote modellen. In ons voorbeeld fine-tunen we het model om beter te worden in vertaaltaken en het beantwoorden van feitelijke vragen. Zo leert het model van een eigen dataset terwijl het zijn algemene taalbegrip behoudt.
Zorg voordat je begint dat je het volgende hebt geïnstalleerd:
pip install datasets torch accelerate peftBereid eerst je dataset voor in JSON-formaat. Elke entry moet een "prompt"- en een "completion"-veld hebben. Sla dit op als custom_dataset.json. We gebruiken dit voorbeeld:
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]We voegen nu de volgende imports toe:
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelVervolgens definiëren we een functie om onze dataset te pre-processen en laden we deze met de Hugging Face datasets-library:
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)Om fine-tuning efficiënter te maken, gebruiken we LoRA (Low-Rank Adaptation). Deze techniek laat ons grote modellen fine-tunen met minder parameters:
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)We stellen nu de training-argumenten in die verschillende aspecten van het fine-tuningproces bepalen:
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)Met onze dataset en training-argumenten klaar, kunnen we nu een Trainer-object maken en het fine-tunen starten:
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()Na het fine-tunen slaan we ons model op zodat we het later kunnen gebruiken:
trainer.save_model("./fine_tuned_qwen")Fine-tuning van het Qwen-7B-model op je eigen dataset verbetert de prestaties op taken die lijken op die in je trainingsdata. In dit geval zou het model beter moeten worden in het vertalen van Engels naar Frans en het beantwoorden van feitelijke vragen over hoofdsteden.
Na het fine-tunen kun je het model gebruiken voor inferentie:
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !Houd rekening met deze tips voor effectieve fine-tuning:
Door Qwen te fine-tunen op je eigen dataset maak je een gespecialiseerd model dat uitblinkt in jouw specifieke taak, terwijl het de brede kennis en capaciteiten van het oorspronkelijke voorgetrainde model behoudt. Zo benut je de kracht van grote taalmodellen voor jouw unieke toepassingen en domeinen.
Naarmate Qwen zich verder ontwikkelt, kunnen we verschillende spannende ontwikkelingen verwachten:
Aan het einde van onze verkenning van Qwen is duidelijk dat deze AI-tools een grote stap voorwaarts betekenen in toegankelijke, krachtige en veelzijdige AI. Qwen is meer dan alleen een set krachtige AI-modellen—het staat voor een visie om geavanceerde AI voor iedereen toegankelijk en aanpasbaar te maken. Door deze tools als open-source beschikbaar te stellen, stimuleert Alibaba Cloud innovatie en vooruitgang in AI-technologie.
Wil je op de hoogte blijven van het laatste AI-nieuws? Dan raad ik deze artikelen aan:
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

