
कोर्स
Hugging Face के साथ काम करना
2 घंटा
39K
क्या होगा अगर उन्नत आर्टिफिशियल इंटेलिजेंस का उपयोग कोई भी कर सके, सिर्फ बड़ी टेक कंपनियाँ ही नहीं? यही बड़ा विचार है Qwen के पीछे—यह Alibaba Cloud द्वारा बनाया गया AI मॉडलों का नया परिवार है।
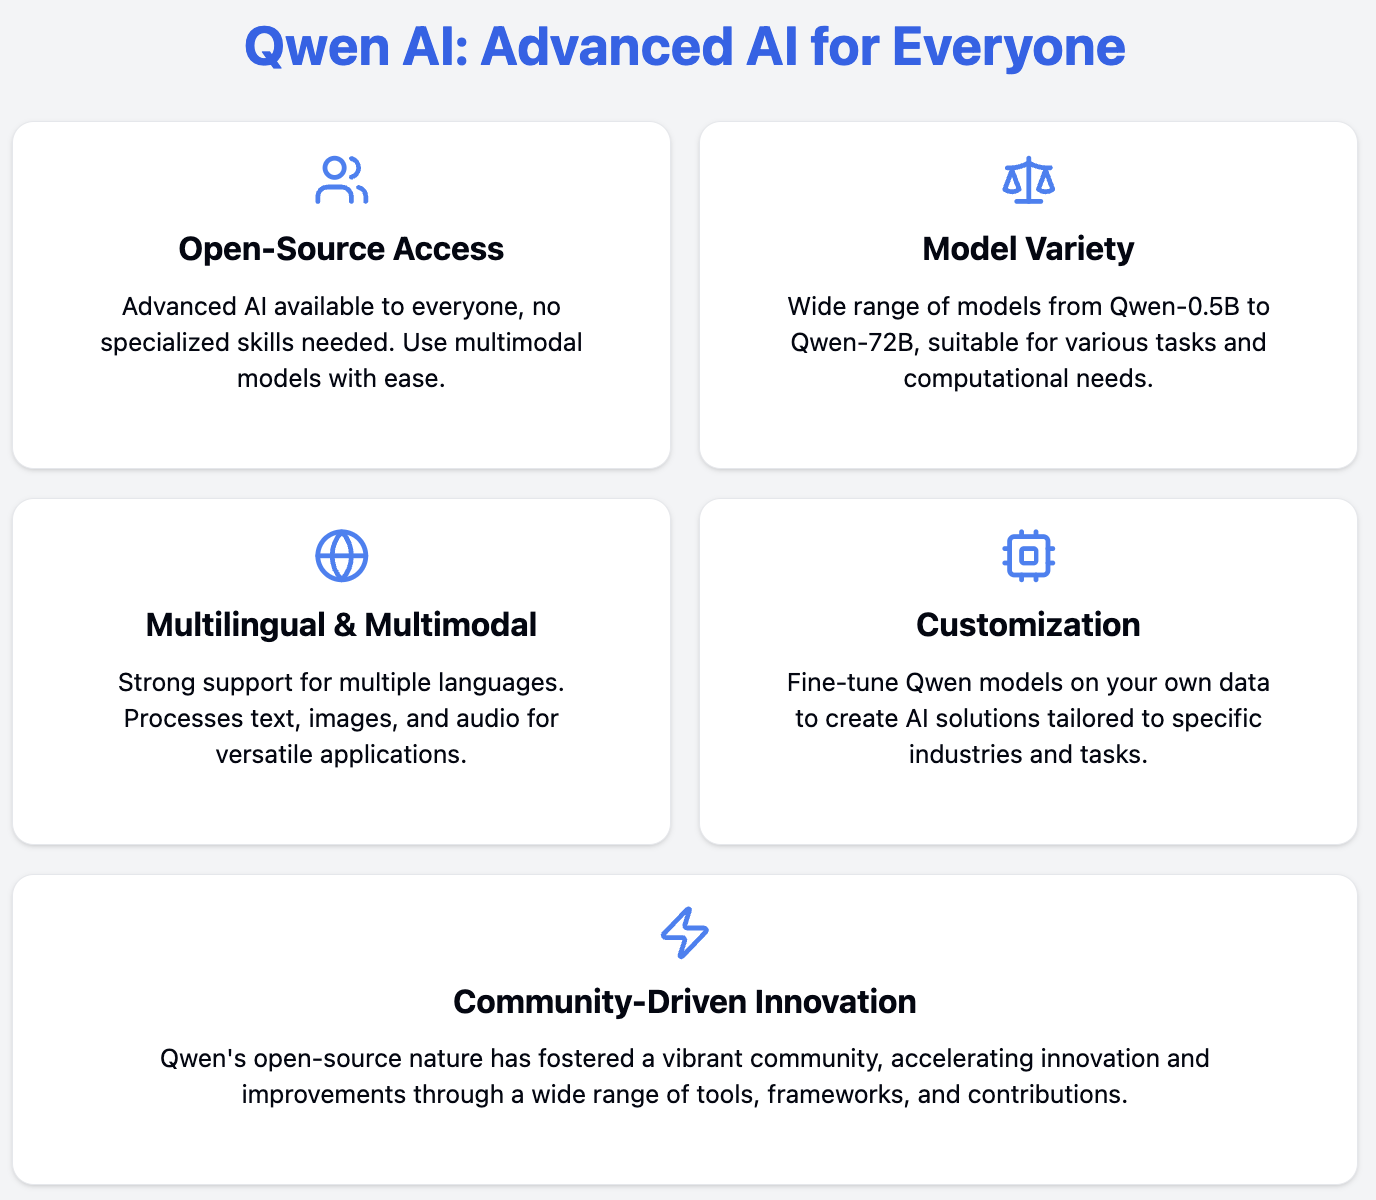
Qwen (जिसका पूरा नाम Tongyi Qianwen है) Alibaba Cloud के AI टूल्स के सेट के साथ AI मॉडलों को सभी के लिए आसानी से सुलभ बनाने की कोशिश कर रहा है। Qwen यह पेशकश करके करता है:
Qwen के साथ, उन्नत AI का उपयोग करने के लिए उतने संसाधनों या विशेष ज्ञान की ज़रूरत नहीं रहती।
इस ट्यूटोरियल में, हम:
Qwen शक्तिशाली मॉडलों की एक श्रृंखला है जिसे विशाल बहुभाषी और मल्टीमॉडल डेटासेट पर प्रशिक्षित किया गया है। Alibaba Cloud द्वारा विकसित, Qwen AI को नए स्तरों तक ले जाता है, जिससे यह नैचुरल लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न और ऑडियो समझ के लिए और अधिक स्मार्ट व उपयोगी बनता है।
ये मॉडल कई तरह के कार्य कर सकते हैं, जिनमें शामिल हैं:
Qwen मॉडल विविध डेटा स्रोतों पर प्री-ट्रेंड हैं और उच्च-गुणवत्ता वाले डेटा पर पोस्ट-ट्रेनिंग के माध्यम से परिष्कृत किए गए हैं।
Qwen परिवार में अलग-अलग जरूरतों और उपयोग मामलों के लिए डिज़ाइन किए गए विशेषीकृत मॉडल शामिल हैं।
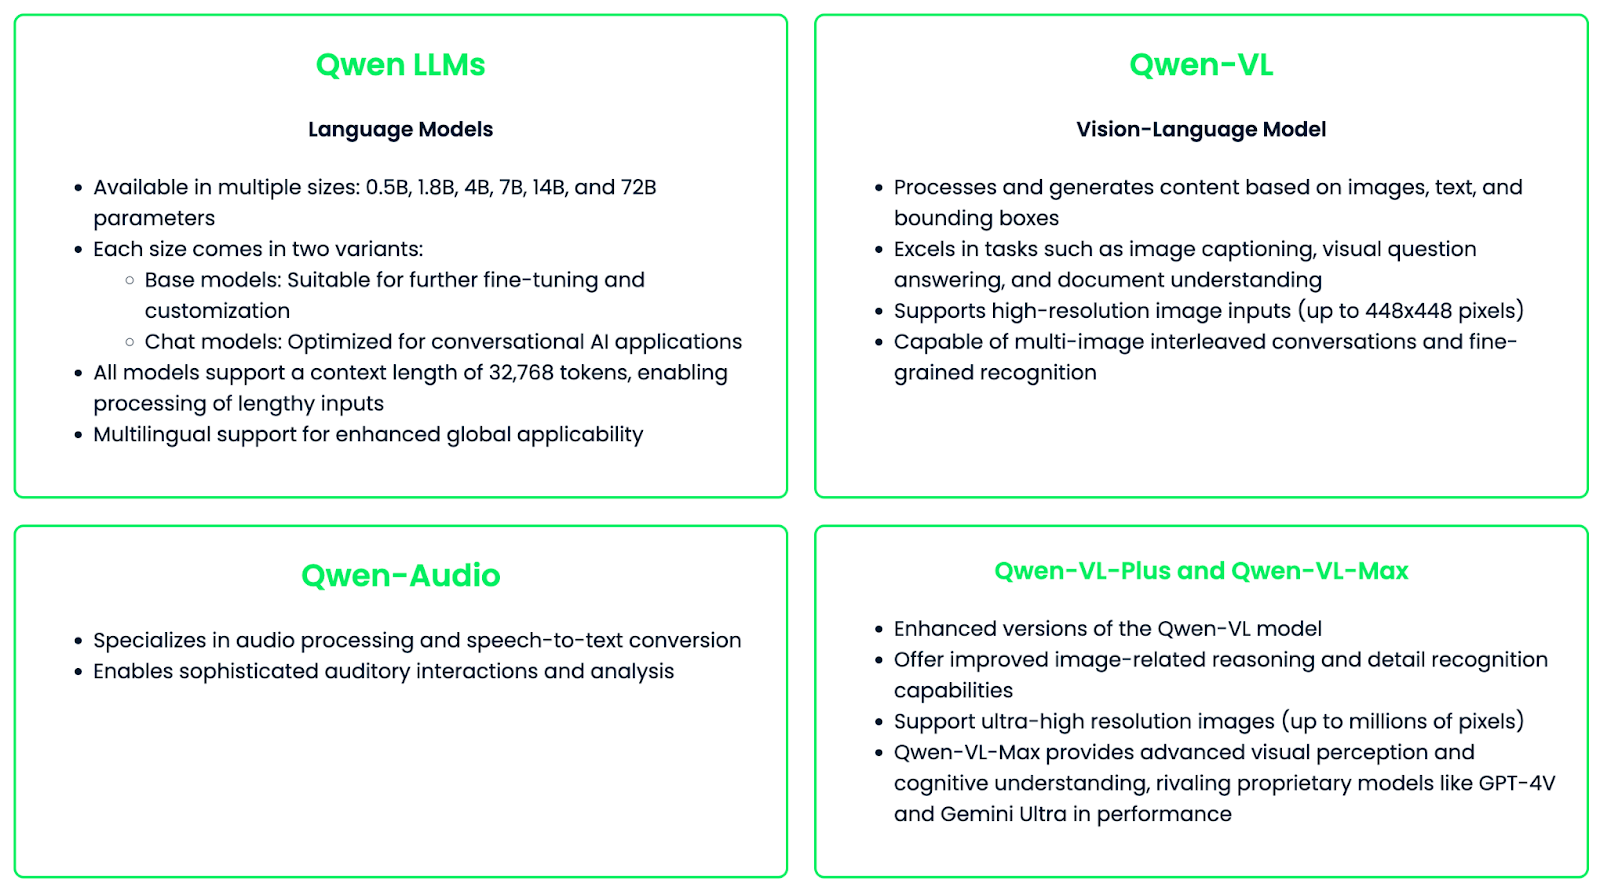
Qwen मॉडलों का परिवार बहुमुखी और आसान कस्टमाइज़ेशन के लिए बनाया गया है, जो विशिष्ट अनुप्रयोगों या उद्योगों हेतु फाइन-ट्यूनिंग प्रदान करता है। उनकी यह लचीलापन, और उनकी शक्तिशाली क्षमताओं के साथ मिलकर, Qwen को विभिन्न क्षेत्रों में AI तकनीक के लिए एक उत्कृष्ट संसाधन बनाता है।
Qwen के मॉडलों का परिवार विभिन्न AI अनुप्रयोगों के लिए एक शक्तिशाली और बहुमुखी टूलसेट प्रदान करता है। आइए वे प्रमुख विशेषताएँ देखें जो Qwen को अलग बनाती हैं:
Qwen बहुभाषी समझ और जनरेशन में उत्कृष्ट है—अंग्रेज़ी और चीनी दोनों में मजबूत क्षमताओं के साथ-साथ कई अन्य भाषाओं के लिए भी समर्थन। नवीनतम Qwen2 मॉडलों ने अपनी भाषाई क्षमता को 27 अतिरिक्त भाषाओं तक बढ़ाया है, जो पश्चिमी यूरोप, पूर्वी और मध्य यूरोप, मध्य पूर्व, पूर्वी एशिया और दक्षिणी एशिया जैसे क्षेत्रों को कवर करती हैं।
यह व्यापक भाषा समर्थन Qwen को अंतर-सांस्कृतिक संचार में मदद करने, उच्च-गुणवत्ता अनुवाद करने, कोड-स्विचिंग परिदृश्यों को संभालने और स्थानीयकृत सामग्री जनरेशन के साथ वैश्विक अनुप्रयोगों की सेवा करने में सक्षम बनाता है।
Qwen मॉडल विविध टेक्स्ट जनरेशन कार्यों में अत्यंत सक्षम हैं। कुछ प्रमुख अनुप्रयोग:
लंबी अनुक्रमों (32,768 टोकन तक) पर संदर्भ बनाए रखने की मॉडलों की क्षमता विस्तृत और सुसंगत टेक्स्ट आउटपुट जनरेट करने देती है।
Qwen तथ्यात्मक और ओपन-एंडेड दोनों तरह के प्रश्नोत्तर में भी बेहतरीन है। यह सुविधा सक्षम बनाती है:
Qwen-VL मॉडल के साथ, Qwen परिवार अपनी क्षमताओं को छवियों से जुड़े मल्टीमॉडल कार्यों तक बढ़ाता है। प्रमुख विशेषताएँ शामिल हैं:
Qwen की सबसे महत्वपूर्ण विशेषताओं में से एक इसका ओपन-सोर्स होना है, जो AI समुदाय को कई लाभ देता है:
ओपन-सोर्स दृष्टिकोण ने थर्ड-पार्टी प्रोजेक्ट्स और टूल्स से व्यापक समर्थन हासिल किया है:
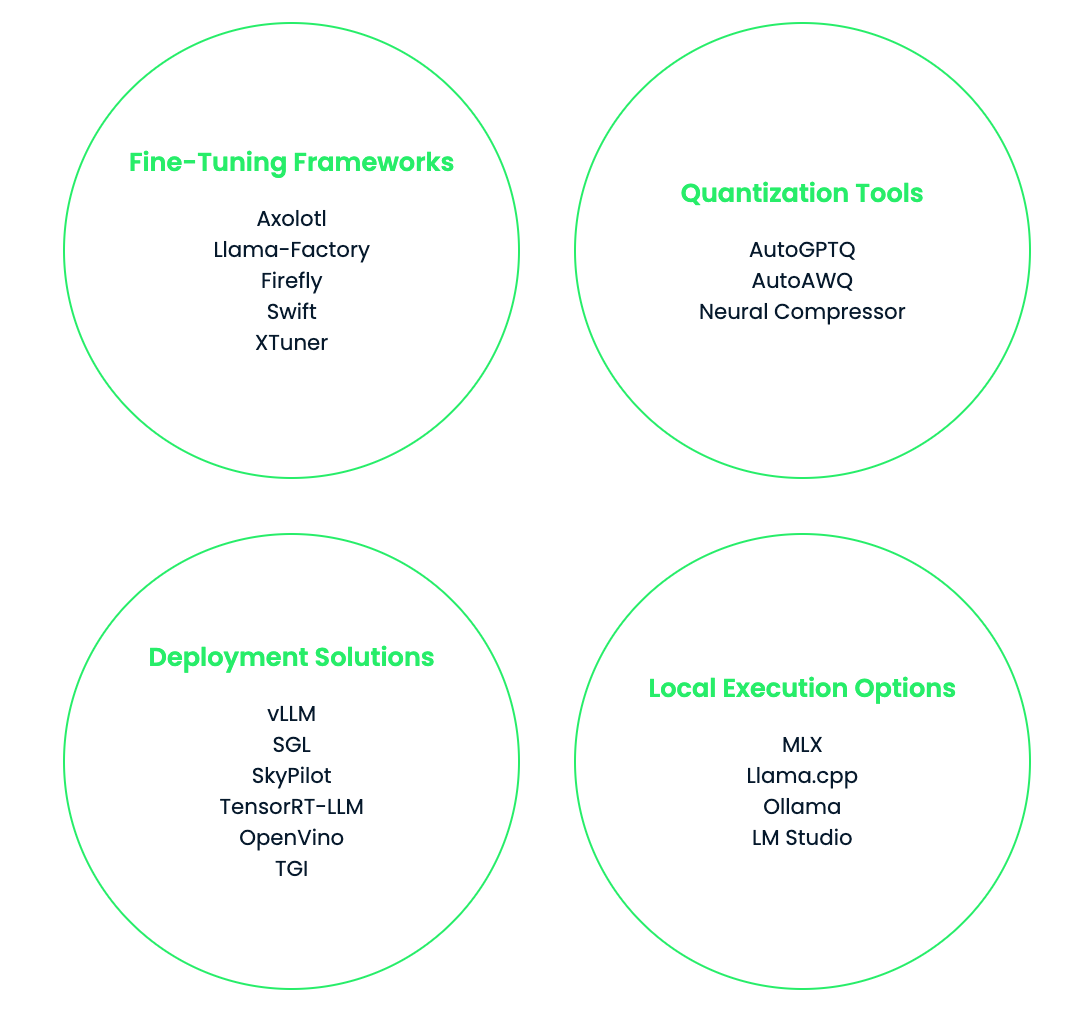
अब जबकि आपने Qwen और उसकी प्रमुख विशेषताएँ जान ली हैं, आइए सीखें कि इसे व्यवहार में कैसे उपयोग करें!
Qwen मॉडल कई प्लेटफ़ॉर्म पर उपलब्ध हैं, जिससे वे विभिन्न उपयोग मामलों के लिए बेहद सुलभ हो जाते हैं।
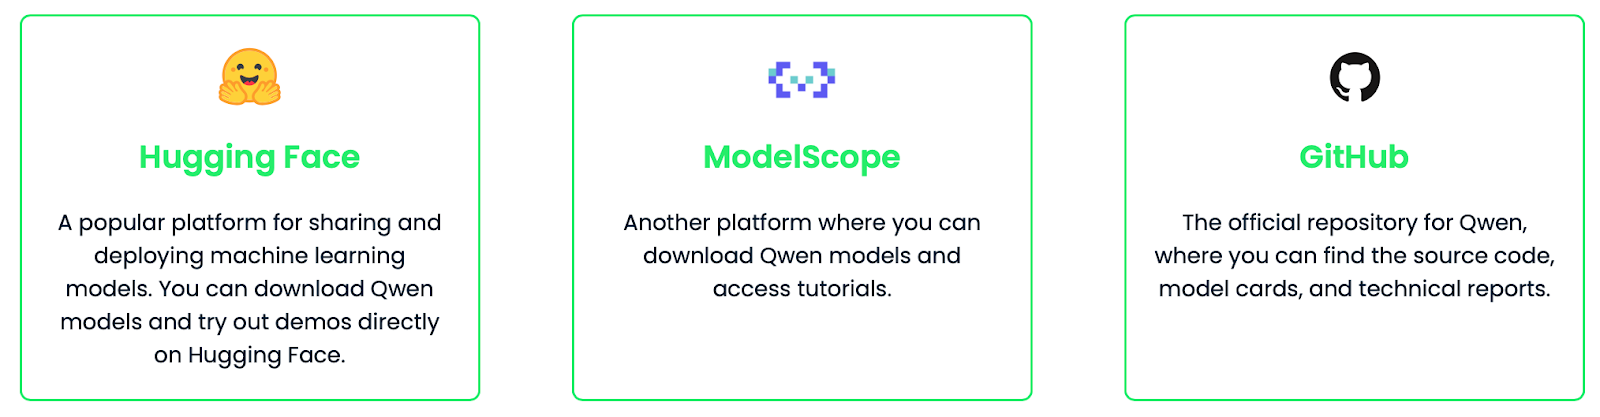
इस खंड में, मैं आपको Hugging Face के माध्यम से Qwen-7B भाषा मॉडल का उपयोग करने की प्रक्रिया बताऊँगा। हम आपका वातावरण सेट करना, Hugging Face में लॉगिन करना और मॉडल चलाना कवर करेंगे।
सबसे पहले, आवश्यक लाइब्रेरी इंस्टॉल करें:
pip install transformers torch huggingface_hubQwen-7B मॉडल तक पहुँचने के लिए, आपको अपने Hugging Face खाते में लॉगिन करना होगा। यह इसलिए ज़रूरी है क्योंकि कुछ मॉडलों पर उपयोग संबंधी प्रतिबंध हो सकते हैं, लेकिन आप फिर भी अपने या अपनी संस्था के निजी मॉडलों तक पहुँच सकते हैं। यह आवश्यकता पड़ने पर API उपयोग की निगरानी और रेट लिमिट लागू करने में मदद करता है।
लॉगिन करने के लिए ये चरण अपनाएँ:
1. Hugging Face पर जाएँ।
2. अपनी प्रोफ़ाइल सेटिंग्स में जाएँ और एक एक्सेस टोकन बनाएँ।
3. अपने टर्मिनल में यह चलाएँ:
huggingface-cli login4. संकेत मिलने पर अपना एक्सेस टोकन दर्ज करें।
अब, हम एक Python फ़ाइल या Jupyter Notebook फ़ाइल बनाएँगे जहाँ हम अपना कोड लिखना शुरू करेंगे।
सबसे पहले, हम transformers लाइब्रेरी से दो क्लास इम्पोर्ट करेंगे:
AutoModelForCausalLM: यह क्लास आपके द्वारा दिए गए मॉडल नाम के आधार पर उपयुक्त मॉडल आर्किटेक्चर अपने-आप चुनती है।AutoTokenizer: यह क्लास आपके इस्तेमाल किए जाने वाले मॉडल के लिए सही टोकनाइज़र लोड करती है।from transformers import AutoModelForCausalLM, AutoTokenizerअब, हम बता रहे हैं कि हमें कौन सा मॉडल उपयोग करना है। "Qwen/Qwen-7B" Hugging Face मॉडल हब पर होस्ट किए गए Qwen मॉडल के 7-बिलियन पैरामीटर संस्करण को संदर्भित करता है, लेकिन आप चाहें तो अन्य Qwen मॉडल भी उपयोग कर सकते हैं।
model_name = "Qwen/Qwen-7B"अगला, हमें टोकनाइज़र लोड करना है।
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)यह लाइन Qwen-7B मॉडल से संबंधित टोकनाइज़र लोड करती है। trust_remote_code=True पैरामीटर आवश्यक है क्योंकि Qwen मॉडलों को लोडिंग के दौरान कस्टम कोड निष्पादित करने की आवश्यकता हो सकती है।
अगला चरण मॉडल लोड करना है।
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)यह वास्तविक Qwen-7B मॉडल लोड करता है। फिर से, हम trust_remote_code=True का उपयोग करते हैं ताकि मॉडल से संबंधित कोई भी कस्टम कोड चल सके।
मॉडल लोड हो जाने के बाद, हम दिए गए इनपुट पर टेक्स्ट जनरेट करके जाँच सकते हैं कि यह काम कर रहा है या नहीं।
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
यहाँ, हम मॉडल के लिए इनपुट तैयार कर रहे हैं:
input_text को अपना प्रॉम्प्ट परिभाषित करते हैं।return_tensors="pt" तर्क निर्दिष्ट करता है कि हम आउटपुट PyTorch टेन्सर प्रारूप में चाहते हैं।अब, हम टेक्स्ट जनरेट करते हैं:
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
पहली कोड लाइन मॉडल को टेक्स्ट जनरेट करने के लिए कहती है:
inputs को generate मेथड में पास करते हैं।**inputs टोकनाइज़र द्वारा लौटाए गए डिक्शनरी को अनपैक करता है।max_new_tokens=50 जनरेशन को अधिकतम 50 नए टोकन तक सीमित करता है।generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)यह चरण मॉडल के आउटपुट (जो टोकन ID प्रारूप में है) को फिर से पठनीय टेक्स्ट में बदलता है:
outputs पहली और (इस मामले में) एकमात्र जनरेटेड सीक्वेंस का चयन करता है।skip_special_tokens=True डिकोडर को पैडिंग या एंड-ऑफ-सीक्वेंस जैसे विशेष टोकन को अनदेखा करने के लिए कहता है।अंत में, परिणाम देखने के लिए हम जनरेटेड टेक्स्ट को प्रिंट करते हैं।
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…यहाँ कुछ उपयोगी नोट्स और टिप्स हैं:
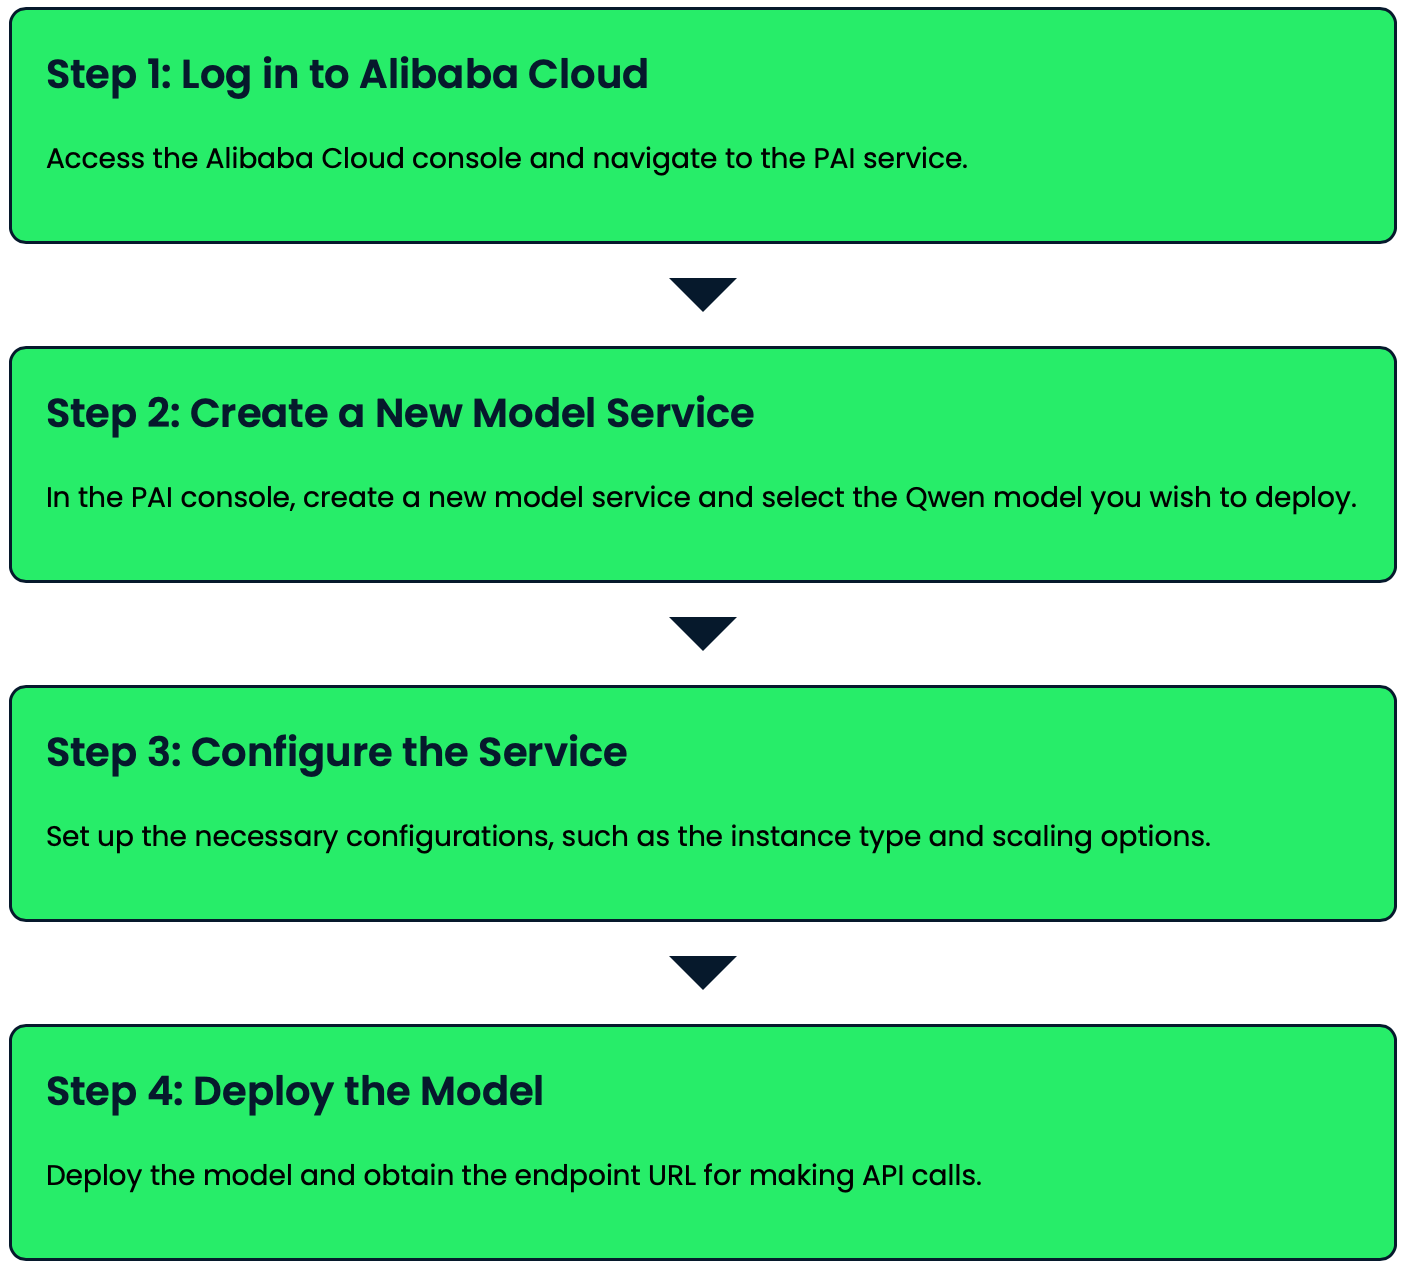
trust_remote_code=True पैरामीटर Qwen मॉडलों के लिए आवश्यक है क्योंकि उन्हें सही तरीके से चलने हेतु कस्टम कोड की आवश्यकता होती है।Qwen मॉडलों को Alibaba Cloud के Platform for AI (PAI) और Elastic AI Serving (EAS) का उपयोग करके डिप्लॉय किया जा सकता है। आइए देखें कि आप कुछ क्लिक में Qwen मॉडल कैसे डिप्लॉय कर सकते हैं:
टेक्स्ट जनरेशन और प्रश्नोत्तर कार्यों के लिए Qwen का उपयोग करने के कुछ व्यावहारिक उदाहरण देखते हैं।
Qwen दिए गए प्रॉम्प्ट्स के आधार पर सुसंगत और संदर्भानुकूल टेक्स्ट जनरेट करने में बहुत अच्छा है। आइए कुछ उदाहरण देखें:
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen का उपयोग तथ्यात्मक प्रश्नों से लेकर अधिक खुले या विश्लेषणात्मक प्रश्नों तक, व्यापक रेंज के प्रश्नों के उत्तर देने के लिए किया जा सकता है। यहाँ कुछ उदाहरण हैं:
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.ये उदाहरण दिखाते हैं कि Qwen टेक्स्ट जनरेशन और प्रश्नोत्तर के विभिन्न प्रकार के कार्यों को कैसे संभाल सकता है।
आप max_new_tokens और temperature जैसे पैरामीटर समायोजित कर सकते हैं ताकि जनरेटेड उत्तरों की लंबाई और रचनात्मकता को अपनी आवश्यकताओं के अनुसार नियंत्रित किया जा सके।
फाइन-ट्यूनिंग Qwen मॉडलों को विशिष्ट कार्यों के अनुरूप ढालने देती है, जिससे आपके विशेष उपयोग मामलों के लिए उनका प्रदर्शन बेहतर हो सकता है। इस प्रक्रिया में प्री-ट्रेंड मॉडल को कस्टम डेटासेट पर ट्रेन करना शामिल है, जिससे यह सामान्य भाषा समझने की क्षमता बनाए रखते हुए कार्य-विशिष्ट ज्ञान सीख सके।
इस खंड में, हम कस्टम डेटासेट पर Qwen-7B मॉडल की फाइन-ट्यूनिंग की प्रक्रिया से गुजरेंगे। हम बड़े मॉडलों के लिए भी इस प्रक्रिया को प्रबंधनीय बनाने हेतु कुशल फाइन-ट्यूनिंग तकनीकों का उपयोग करेंगे। हमारे उदाहरण में, हम मॉडल को अनुवाद कार्यों और तथ्यात्मक प्रश्नों के उत्तर देने में उसका प्रदर्शन सुधारने के लिए फाइन-ट्यून कर रहे हैं। यह प्रक्रिया मॉडल को कस्टम डेटासेट से सीखने देती है जबकि उसकी सामान्य भाषा समझने की क्षमता बनी रहती है।
शुरू करने से पहले, सुनिश्चित करें कि आपने निम्नलिखित इंस्टॉल कर लिया है:
pip install datasets torch accelerate peftसबसे पहले, अपना डेटासेट JSON प्रारूप में तैयार करें। प्रत्येक प्रविष्टि में "prompt" और "completion" फ़ील्ड होना चाहिए। इसे custom_dataset.json के रूप में सहेजें। हम यह उदाहरण उपयोग करेंगे:
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]अब हम निम्नलिखित इम्पोर्ट जोड़ते हैं:
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelअगला, हम अपने डेटासेट को प्रीप्रोसेस करने के लिए एक फ़ंक्शन परिभाषित करेंगे और Hugging Face datasets लाइब्रेरी का उपयोग करके इसे लोड करेंगे:
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)फाइन-ट्यूनिंग को अधिक कुशल बनाने के लिए, हम LoRA (Low-Rank Adaptation) का उपयोग करेंगे। यह तकनीक हमें कम पैरामीटरों के साथ बड़े मॉडलों को फाइन-ट्यून करने देती है:
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)अब, हम प्रशिक्षण तर्क (training arguments) सेट करेंगे जो फाइन-ट्यूनिंग प्रक्रिया के विभिन्न पहलुओं को नियंत्रित करते हैं:
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)हमारा डेटासेट और प्रशिक्षण तर्क तैयार होने के साथ, अब हम एक Trainer ऑब्जेक्ट बना सकते हैं और फाइन-ट्यूनिंग प्रक्रिया शुरू कर सकते हैं:
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()फाइन-ट्यूनिंग पूरी होने के बाद, हम अपने मॉडल को सहेजेंगे ताकि बाद में उपयोग कर सकें:
trainer.save_model("./fine_tuned_qwen")अपने कस्टम डेटासेट पर Qwen-7B मॉडल की फाइन-ट्यूनिंग करने से उन कार्यों पर इसका प्रदर्शन बेहतर होगा जो आपके प्रशिक्षण डेटा से मिलते-जुलते हैं। इस मामले में, मॉडल को अंग्रेज़ी से फ्रेंच में अनुवाद करने और राजधानी शहरों से संबंधित तथ्यात्मक प्रश्नों के उत्तर देने में सुधार होना चाहिए।
फाइन-ट्यूनिंग के बाद, आप मॉडल का उपयोग इन्फ़ेरेंस के लिए कर सकते हैं:
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !प्रभावी फाइन-ट्यूनिंग के लिए ये बातें ध्यान में रखें:
अपने कस्टम डेटासेट पर Qwen की फाइन-ट्यूनिंग करने से आप एक ऐसा विशेषीकृत मॉडल बना सकते हैं जो आपके विशिष्ट कार्य में उत्कृष्ट प्रदर्शन करता है, जबकि मूल प्री-ट्रेंड मॉडल के व्यापक ज्ञान और क्षमताओं को बनाए रखता है। यह दृष्टिकोण आपके अनूठे अनुप्रयोगों और डोमेनों के लिए बड़े भाषा मॉडलों की शक्ति का उपयोग करता है।
जैसे-जैसे Qwen विकसित होता जाएगा, हम कई रोमांचक प्रगतियों की उम्मीद कर सकते हैं:
Qwen की हमारी पड़ताल के अंत में, यह स्पष्ट है कि ये AI टूल्स सुलभ, शक्तिशाली और बहुमुखी AI में एक महत्वपूर्ण छलांग का प्रतिनिधित्व करते हैं। Qwen सिर्फ शक्तिशाली AI मॉडलों का सेट नहीं है—यह सभी के लिए उन्नत AI को सुलभ और अनुकूलनीय बनाने की दृष्टि को दर्शाता है। इन टूल्स को ओपन-सोर्स संसाधन के रूप में उपलब्ध कराकर, Alibaba Cloud AI तकनीक में नवाचार और प्रगति को आगे बढ़ा रहा है।
यदि आप AI में नवीनतम जानकारी से अपडेट रहना चाहते हैं, तो मैं ये लेख सुझाता/सुझाती हूँ:
इन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
लर्निंग पाथ
कोर्स