Cours
Travailler avec Hugging Face
2 h
38.3K
Et si chacun pouvait utiliser une intelligence artificielle avancée, et pas seulement les géants de la tech ? C’est l’idée directrice de Qwen, une nouvelle famille de modèles d’IA créée par Alibaba Cloud.
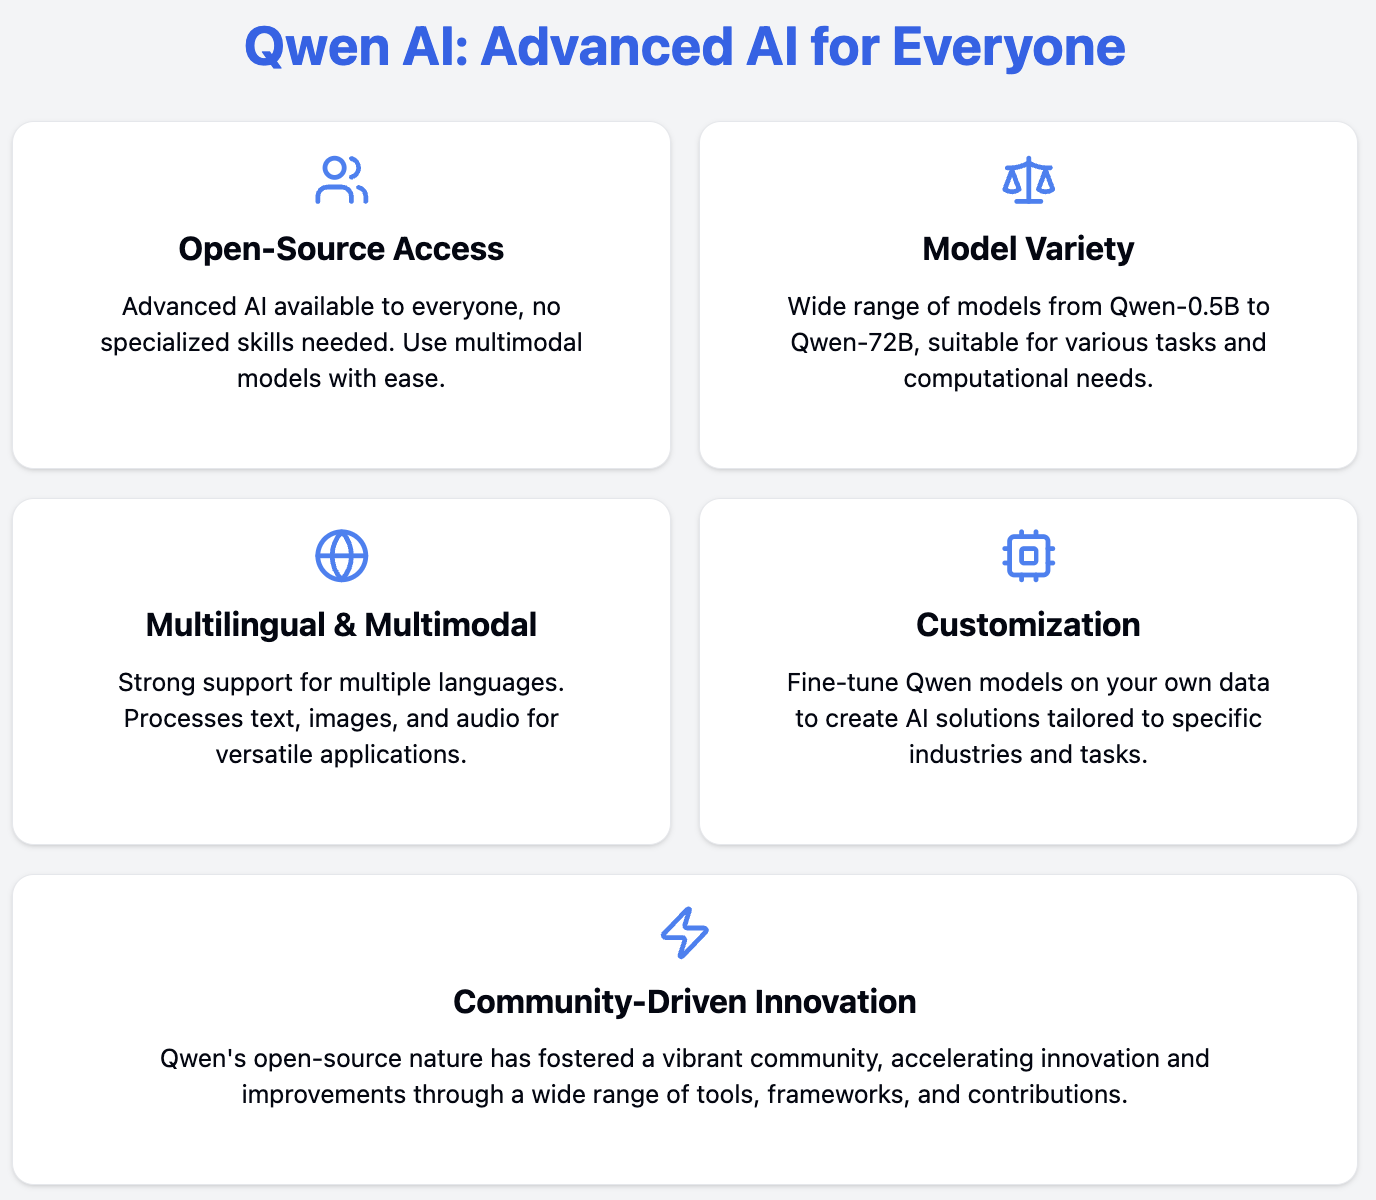
Qwen (abréviation de Tongyi Qianwen) vise à rendre les modèles d’IA facilement accessibles au plus grand nombre grâce à une suite d’outils conçus par Alibaba Cloud. Concrètement, Qwen propose :
Avec Qwen, vous n’avez plus besoin d’autant de ressources ni d’une expertise pointue pour exploiter une IA avancée.
Dans ce tutoriel, nous allons :
Qwen est une série de modèles puissants entraînés sur d’immenses jeux de données multilingues et multimodaux. Développé par Alibaba Cloud, Qwen repousse les limites de l’IA et la rend plus performante et utile pour le traitement du langage naturel, la vision par ordinateur et la compréhension audio.
Ces modèles couvrent un large éventail de tâches, notamment :
Les modèles Qwen sont pré-entraînés sur des sources variées et améliorés via un post-entraînement sur des données de haute qualité.
La famille Qwen regroupe différents modèles spécialisés, conçus pour répondre à des besoins et cas d’usage variés.
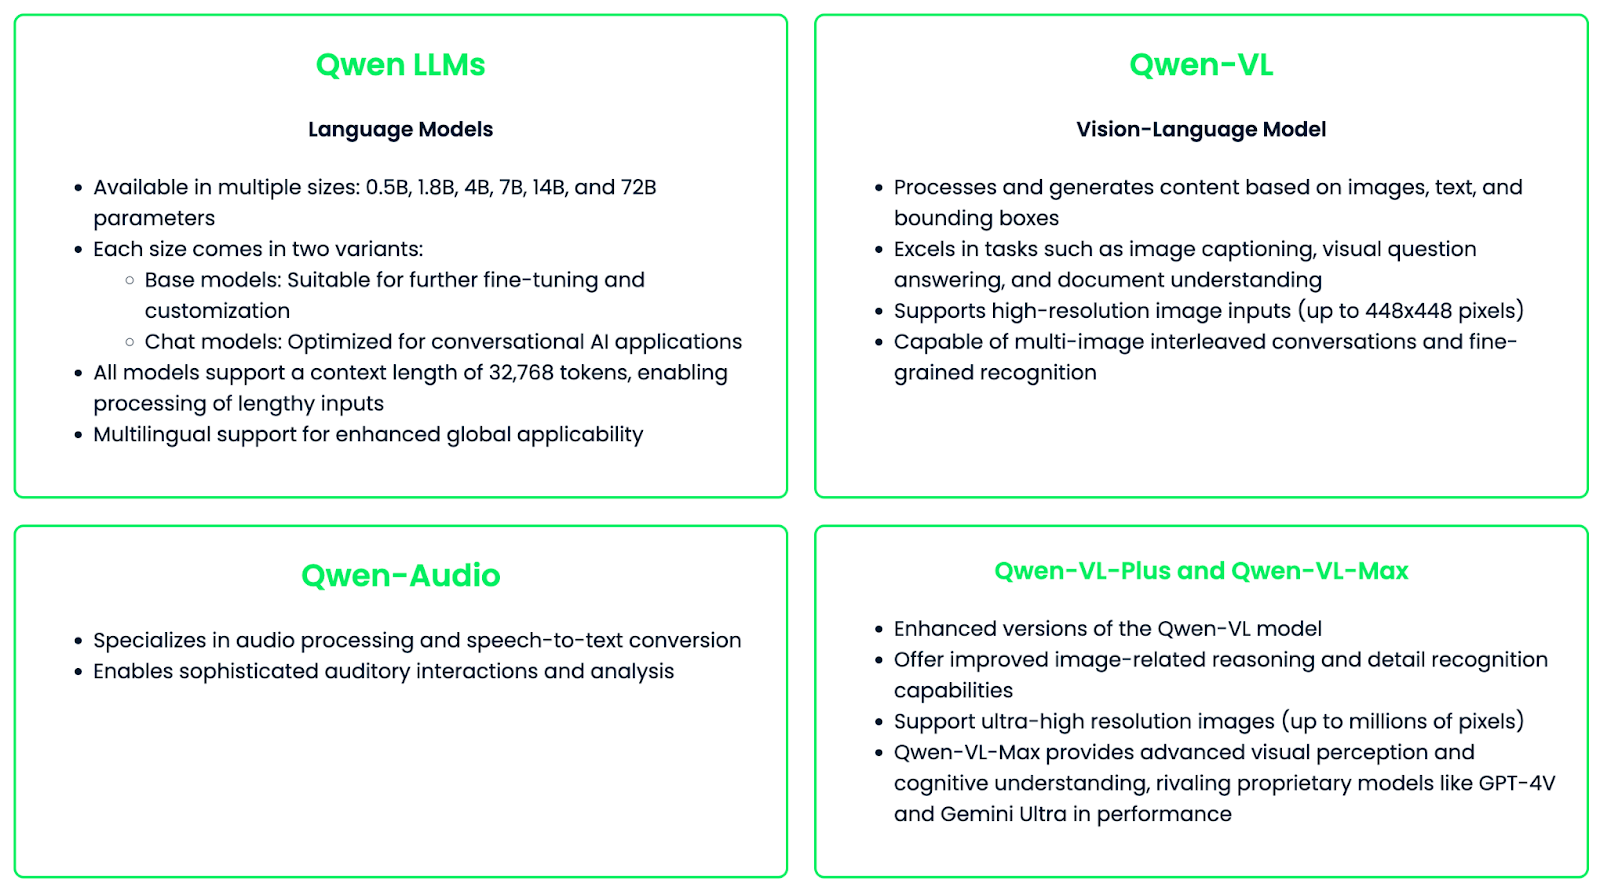
La famille Qwen est pensée pour la polyvalence et la personnalisation, avec la possibilité d’affiner les modèles pour des applications ou secteurs spécifiques. Cette flexibilité, combinée à leurs capacités avancées, fait de Qwen une ressource de choix pour l’IA dans de nombreux domaines.
La famille de modèles Qwen constitue un outil puissant et polyvalent pour de nombreuses applications d’IA. Voici les atouts qui distinguent Qwen :
Qwen excelle en compréhension et génération multilingues, avec de solides performances en anglais et en chinois, et le support de nombreuses autres langues. Les derniers modèles Qwen2 élargissent encore cet éventail à 27 langues supplémentaires, couvrant l’Europe de l’Ouest, l’Europe de l’Est et centrale, le Moyen-Orient, l’Asie de l’Est et l’Asie du Sud.
Ce large support linguistique favorise la communication interculturelle, des traductions de qualité, la gestion de contextes de code-switching et la production de contenus localisés pour des applications globales.
Les modèles Qwen excellent dans de nombreuses tâches de génération de texte. Parmi les usages clés :
La capacité à conserver le contexte sur de longues séquences (jusqu’à 32 768 tokens) permet de générer des textes longs cohérents.
Qwen est également performant en question-réponse factuelle et ouverte. Cela permet :
Avec le modèle Qwen-VL, la famille Qwen étend ses capacités aux tâches multimodales impliquant des images. Principales fonctions :
L’un des atouts majeurs de Qwen est son caractère open source, qui apporte plusieurs bénéfices à la communauté IA :
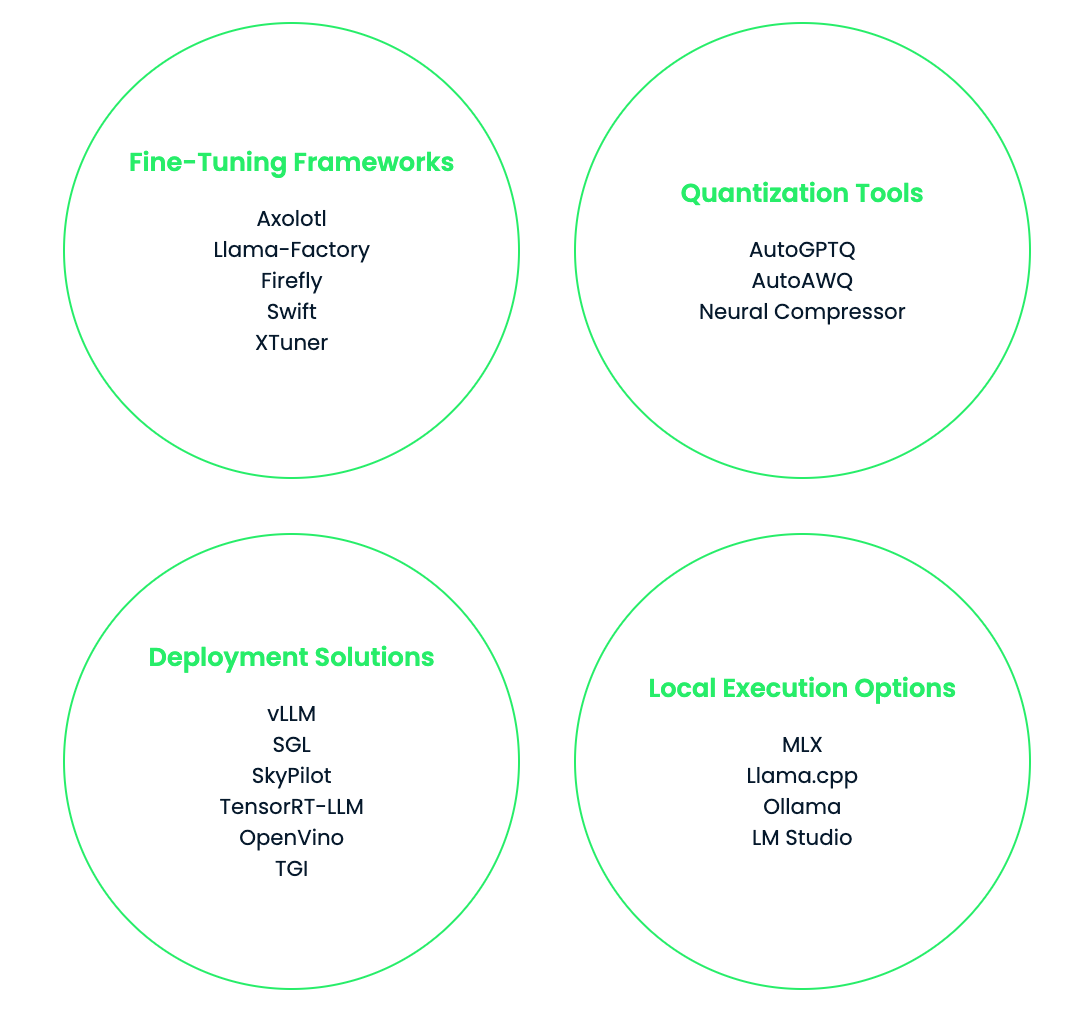
Cette approche open source a suscité un large soutien d’outils et projets tiers :
Maintenant que vous connaissez Qwen et ses principales caractéristiques, passons à la pratique !
Les modèles Qwen sont disponibles sur plusieurs plateformes, ce qui les rend très accessibles selon vos usages.
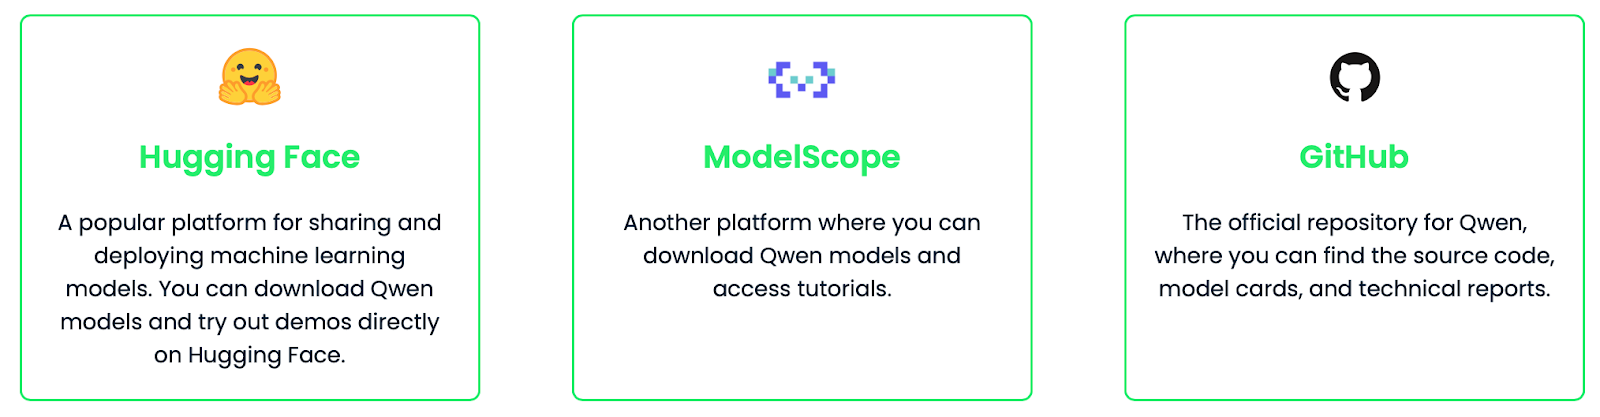
Dans cette section, je vous guide pour utiliser le modèle de langage Qwen-7B via Hugging Face. Nous allons configurer l’environnement, nous connecter à Hugging Face et exécuter le modèle.
Commencez par installer les bibliothèques requises :
pip install transformers torch huggingface_hubPour accéder au modèle Qwen-7B, vous devez vous connecter à votre compte Hugging Face. Certains modèles peuvent être soumis à des restrictions d’usage, mais vous pouvez toujours accéder aux modèles privés de votre compte ou de votre organisation. Cela facilite le suivi de l’usage de l’API et la mise en place de limites si nécessaire.
Pour vous connecter, procédez ainsi :
1. Rendez-vous sur Hugging Face.
2. Dans les paramètres de votre profil, créez un jeton d’accès.
3. Dans votre terminal, exécutez :
huggingface-cli login4. Lorsque vous y êtes invité, saisissez votre jeton d’accès.
Créez maintenant un fichier Python ou un Notebook Jupyter pour y écrire votre code.
Nous allons d’abord importer deux classes de la bibliothèque transformers :
AutoModelForCausalLM : sélectionne automatiquement l’architecture adaptée selon le nom du modèle fourni.AutoTokenizer : charge le tokenizer adéquat pour le modèle utilisé.from transformers import AutoModelForCausalLM, AutoTokenizerIndiquons maintenant le modèle à utiliser. "Qwen/Qwen-7B" correspond à la version 7 milliards de paramètres hébergée sur le hub de modèles Hugging Face, mais vous pouvez choisir d’autres modèles Qwen.
model_name = "Qwen/Qwen-7B"Chargeons ensuite le tokenizer.
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)Cette ligne charge le tokenizer associé à Qwen-7B. Le paramètre trust_remote_code=True est nécessaire car certains modèles Qwen requièrent l’exécution de code personnalisé au chargement.
L’étape suivante consiste à charger le modèle.
model = AutoModelForCausalLM.from_pretrained(model_name, trust_remote_code=True)Cette commande charge le modèle Qwen-7B. Là encore, nous utilisons trust_remote_code=True pour autoriser l’exécution du code personnalisé associé.
Une fois le modèle chargé, testons sa génération de texte à partir d’une invite.
input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
Ici, nous préparons l’entrée du modèle :
input_text comme prompt.return_tensors="pt" indique que la sortie doit être un tenseur PyTorch.Générons maintenant le texte :
outputs = model.generate(**inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
La première ligne demande au modèle de générer du texte :
inputs tokenisés à la méthode generate.**inputs déplie le dictionnaire renvoyé par le tokenizer.max_new_tokens=50 limite la génération à 50 tokens nouveaux.generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)Cette étape convertit la sortie du modèle (identifiants de tokens) en texte lisible :
outputs sélectionne la première (et ici unique) séquence générée.skip_special_tokens=True demande d’ignorer les tokens spéciaux (remplissage, fin de séquence, etc.).Enfin, affichez le texte généré pour voir le résultat.
print(generated_text)Once upon a time, in a far-off kingdom, there lived a young princess named Lily.
She was known throughout the land for her kindness and beauty. Despite living in a grand castle with everything she could ever want, Lily felt something was missing in her life. She longed for adventure and to see the world beyond the castle walls.
One day, while walking in the royal gardens, she stumbled upon a hidden door overgrown with vines. Curiosity got the better of her, and she decided to see where it led. As she pushed open the creaky door, she found herself stepping into a magical forest filled with talking animals and glowing flowers.
Little did Lily know that this discovery would be the beginning of an extraordinary journey that would change her life forever…Voici quelques points utiles :
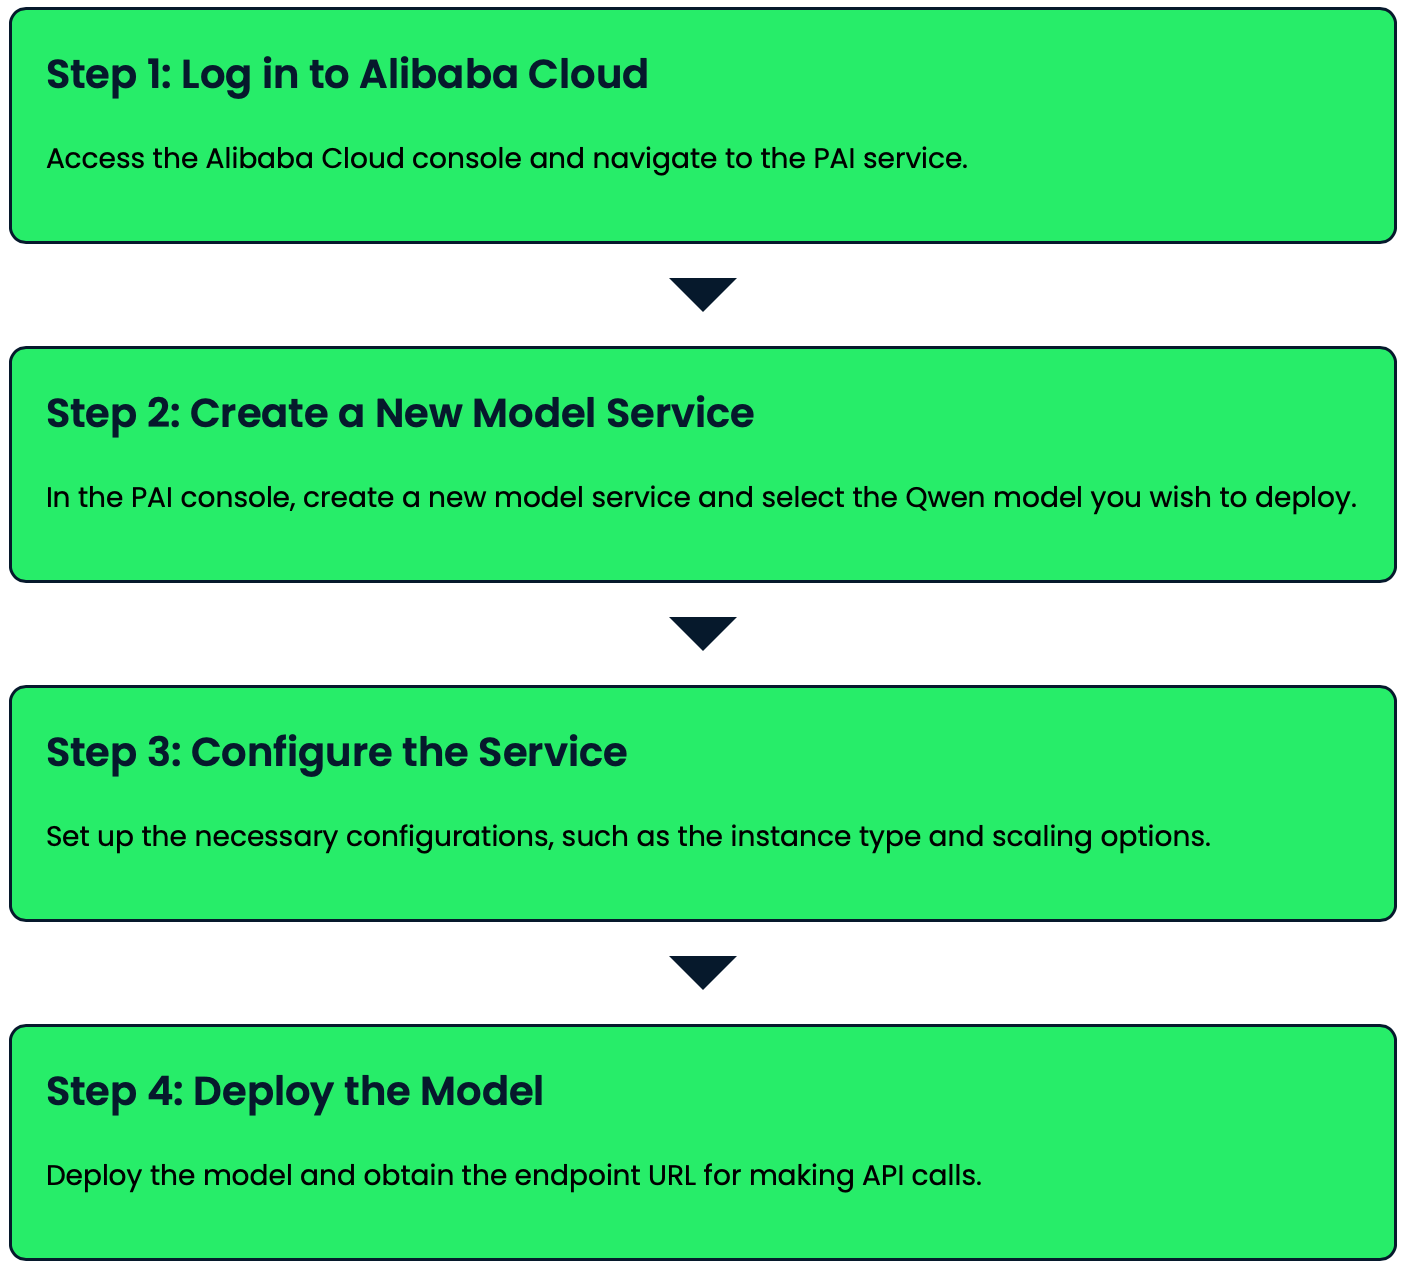
trust_remote_code=True est nécessaire avec Qwen, car du code personnalisé peut être requis.Les modèles Qwen peuvent être déployés via la Platform for AI (PAI) et Elastic AI Serving (EAS) d’Alibaba Cloud. Voici comment déployer un modèle Qwen en quelques clics :
Voyons des exemples concrets d’utilisation de Qwen pour la génération de texte et le question-réponse.
Qwen est particulièrement à l’aise pour produire des textes cohérents et pertinents à partir d’une invite. Voici quelques exemples :
prompt = "The future of artificial intelligence is"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
The future of artificial intelligence is bright and full of potential. As technology continues to advance, AI will play an increasingly important role in various aspects of our lives. From healthcare and education to transportation and entertainment, AI will revolutionize the way we live and work. However, it's crucial to ensure that AI is developed and used responsibly, with proper ethical considerations and safeguards in place.prompt = "Write a short poem about the changing seasons:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=100, temperature=0.7)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)Leaves of gold and crimson fall,
As autumn's whisper fills the air.
Winter's chill soon follows all,
Blanketing the earth with care.
Spring awakens with gentle rain,
Coaxing buds to bloom anew.
Summer's warmth returns again,
Painting skies in vibrant blue.
Nature's cycle, ever turning,
Each season brings its own delight.
In this dance, we're always learning,
Of life's beauty, day and night.prompt = "Write a Python function to calculate the Fibonacci sequence:"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.2)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)def fibonacci(n):
"""
Calculate the Fibonacci sequence up to the nth term.
Args:
n (int): The number of terms in the sequence to calculate.
Returns:
list: A list containing the Fibonacci sequence up to the nth term.
"""
if n <= 0:
return []
elif n == 1:
return [0]
elif n == 2:
return [0, 1]
fib_sequence = [0, 1]
for i in range(2, n):
fib_sequence.append(fib_sequence[i-1] + fib_sequence[i-2])
return fib_sequence
# Example usage:
print(fibonacci(10)) [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]Qwen peut répondre à un large éventail de questions, des faits simples aux sujets ouverts ou analytiques. Exemples :
question = "What is the capital of France?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=50)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")
Q: What is the capital of France?
A: The capital of France is Paris. Paris is the largest city in France and serves as the country's political, economic, and cultural center. It is known for its iconic landmarks such as the Eiffel Tower, the Louvre Museum, and Notre-Dame Cathedral.question = "What are the potential ethical concerns surrounding artificial intelligence?"
inputs = tokenizer(question, return_tensors="pt")
outputs = model.generate(inputs, max_new_tokens=200, temperature=0.7)
answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(f"Q: {question}\nA: {answer}")Q: What are the potential ethical concerns surrounding artificial intelligence?
A: There are several potential ethical concerns surrounding artificial intelligence (AI):
1. Privacy and data protection: AI systems often require large amounts of data, raising concerns about personal information collection and use.
2. Bias and discrimination: AI algorithms can perpetuate or amplify existing biases in training data, leading to unfair treatment of certain groups.
3. Job displacement: As AI becomes more advanced, it may replace human workers in various industries, potentially leading to unemployment and economic inequality.
4. Accountability and transparency: It can be challenging to understand how AI systems make decisions, making it difficult to assign responsibility for errors or harmful outcomes.
5. Autonomous weapons: The development of AI-powered weapons raises concerns about the ethics of warfare and the potential for uncontrolled escalation.
6. Superintelligence: There are concerns about the potential development of AI systems that surpass human intelligence, potentially posing existential risks to humanity.
7. Human autonomy: As AI systems become more integrated into our lives, there are concerns about the erosion of human decision-making and free will.
8. Security risks: AI systems can be vulnerable to hacking or manipulation, potentially leading to severe consequences in critical applications.
9. Social manipulation: AI-powered systems could be used to influence human behavior on a large scale, raising concerns about democracy and free will.
10. Ethical decision-making: As AI systems are tasked with making complex decisions, there are concerns about their ability to navigate ethical dilemmas appropriately.
Addressing these concerns requires ongoing dialogue between technologists, ethicists, policymakers, and the public to ensure responsible development and deployment of AI technologies.Ces exemples illustrent la capacité de Qwen à gérer différents types de génération de texte et de question-réponse.
Ajustez des paramètres comme max_new_tokens et temperature pour contrôler la longueur et la créativité des réponses générées selon vos besoins.
L’affinage (fine-tuning) des modèles Qwen permet de les adapter à des tâches spécifiques et d’améliorer leurs performances sur vos cas d’usage. Le principe consiste à réentraîner le modèle pré-entraîné sur un jeu de données personnalisé, afin qu’il acquière des connaissances ciblées tout en conservant ses capacités générales en langage.
Dans cette section, nous décrivons l’affinage de Qwen-7B sur un jeu de données personnalisé. Nous utiliserons des techniques efficaces afin de garder le processus gérable, même pour de grands modèles. Dans notre exemple, nous cherchons à améliorer les performances en traduction et en réponses factuelles. Le modèle apprend ainsi à partir de vos données tout en conservant ses compétences générales.
Avant de commencer, installez les éléments suivants :
pip install datasets torch accelerate peftPréparez d’abord votre jeu de données au format JSON. Chaque entrée doit contenir un champ "prompt" et un champ "completion". Enregistrez-le sous custom_dataset.json. Exemple :
[
  {
    "prompt": "Translate to French: 'Hello, how are you?'",
    "completion": "Bonjour, comment allez-vous?"
  },
  {
    "prompt": "What is the capital of Spain?",
    "completion": "The capital of Spain is Madrid."
  }
]Ajoutons maintenant les imports suivants :
import torch
from transformers import TrainingArguments, Trainer
from datasets import load_dataset
from peft import LoraConfig, get_peft_modelNous définissons ensuite une fonction de prétraitement et chargeons les données via la bibliothèque datasets de Hugging Face :
def preprocess_function(examples):
    inputs = [f"{prompt}\n" for prompt in examples["prompt"]]
    targets = [f"{completion}\n" for completion in examples["completion"]]
    model_inputs = tokenizer(inputs, max_length=512, truncation=True, padding="max_length")
    labels = tokenizer(targets, max_length=512, truncation=True, padding="max_length")
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
dataset = load_dataset("json", data_files="custom_dataset.json")
tokenized_dataset = dataset["train"].train_test_split(test_size=0.1)
tokenized_dataset = tokenized_dataset.map(preprocess_function, batched=True, remove_columns=dataset["train"].column_names)Pour rendre l’affinage plus efficient, nous allons utiliser LoRA (Low-Rank Adaptation). Cette technique permet d’affiner de grands modèles avec moins de paramètres :
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)Nous définissons à présent les arguments d’entraînement qui pilotent l’affinage :
training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir="./logs",
    logging_steps=10,
    evaluation_strategy="steps",
    eval_steps=500,
    save_strategy="steps",
    save_steps=1000,
    learning_rate=1e-4,
    fp16=True,
    gradient_checkpointing=True,
    gradient_accumulation_steps=4,
)Avec le jeu de données et les paramètres prêts, nous créons un objet Trainer et démarrons l’affinage :
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()Une fois l’affinage terminé, enregistrons le modèle pour un usage ultérieur :
trainer.save_model("./fine_tuned_qwen")L’affinage de Qwen-7B sur votre jeu de données personnalisé améliore ses performances sur des tâches proches de vos exemples. Ici, le modèle devrait progresser en traduction de l’anglais vers le français et en réponses factuelles sur les capitales.
Après l’affinage, vous pouvez l’exploiter en inférence :
fine_tuned_model = AutoModelForCausalLM.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
fine_tuned_tokenizer = AutoTokenizer.from_pretrained("./fine_tuned_qwen", trust_remote_code=True)
def generate_response(prompt):
    inputs = fine_tuned_tokenizer(prompt, return_tensors="pt").to(fine_tuned_model.device)
    outputs = fine_tuned_model.generate(**inputs, max_new_tokens=50)
    return fine_tuned_tokenizer.decode(outputs[0], skip_special_tokens=True)
# Example usage
prompt = "Translate to French: 'Good morning, have a nice day!'"
response = generate_response(prompt)
print(f"Prompt: {prompt}\n Response: {response}")
Prompt: Translate to French: 'Good morning, have a nice day!'
Response: Bonjour, passez une bonne journée !Quelques bonnes pratiques à garder en tête :
Affiner Qwen sur vos données vous permet d’obtenir un modèle spécialisé performant sur votre tâche, tout en conservant l’étendue des connaissances du modèle pré-entraîné. Une façon d’exploiter toute la puissance des grands modèles de langage pour vos cas d’usage.
À mesure que Qwen évolue, plusieurs avancées prometteuses se dessinent :
Au terme de cette exploration, il est clair que Qwen incarne une avancée majeure : une IA puissante, polyvalente et accessible. Qwen n’est pas qu’un ensemble de modèles performants : c’est une vision, celle d’une IA avancée à la portée de tous et adaptable. En proposant ces outils en open source, Alibaba Cloud stimule l’innovation et fait progresser l’IA.
Pour rester à jour sur l’IA, nous vous recommandons ces articles :
Formez-vous à l’IA avec ces cours !
Cours
Cursus
Cours