
Last chance! 50% off DataCamp Premium
Sale ends in
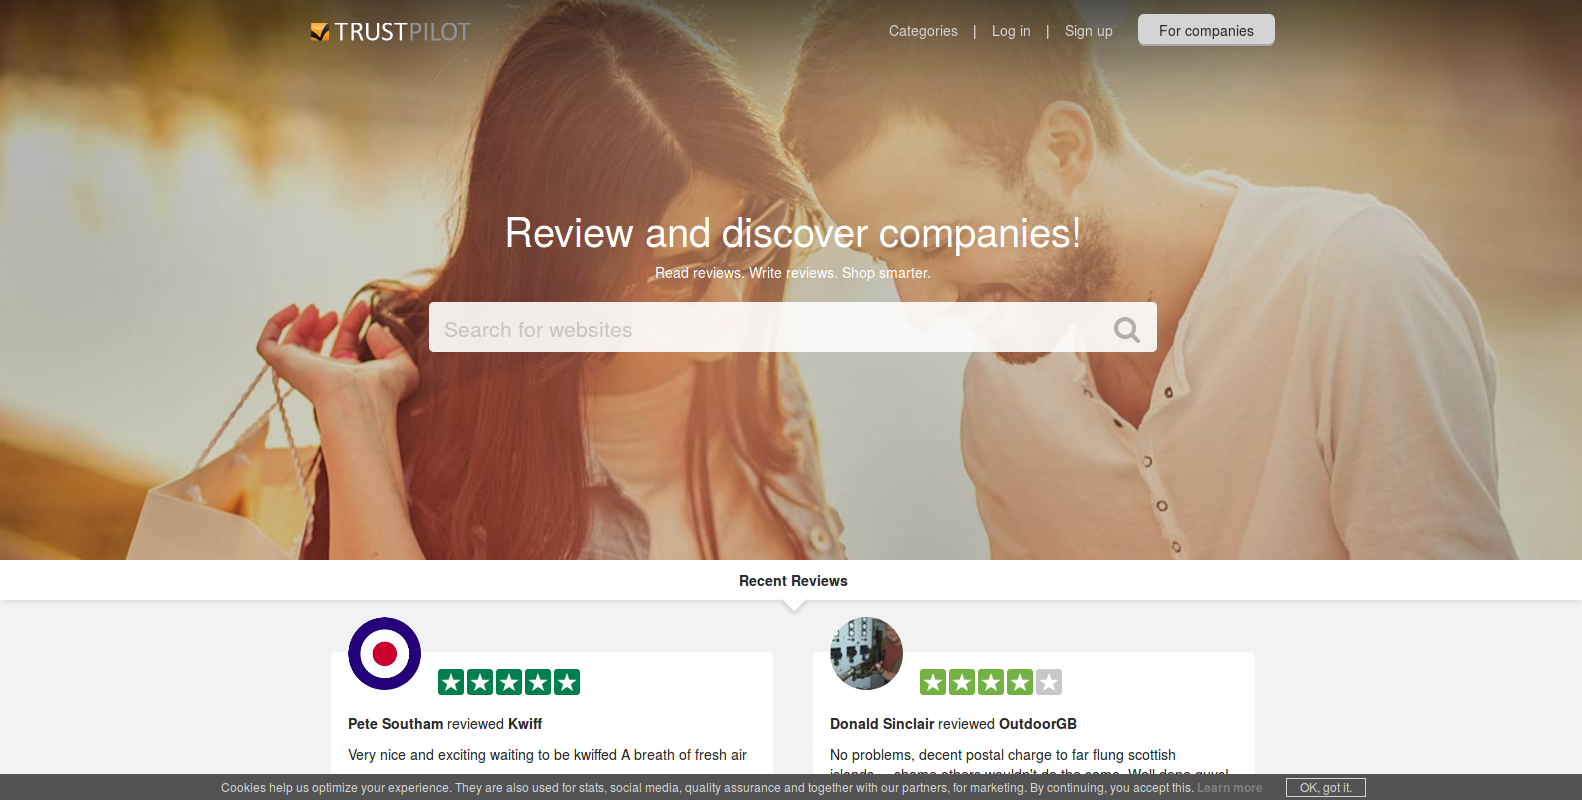
Trustpilot telah menjadi situs populer bagi pelanggan untuk meninjau bisnis dan layanan. Dalam tutorial singkat ini, Anda akan belajar cara mengambil informasi berguna dari situs ini dan menghasilkan beberapa wawasan dasar darinya dengan bantuan R. Anda akan menemukan bahwa TrustPilot mungkin tidak seterpercaya yang diiklankan.
Lebih spesifiknya, tutorial ini akan membahas hal-hal berikut:
ggplot2 dan dplyr, dikombinasikan dengan xts, untuk menelaah data lebih lanjut dan merumuskan hipotesis, yang kemudian dapat Anda selidiki dengan paket infer, sebuah paket inferensi statistik yang mengikuti filosofi tidyverse.Di Trustpilot, sebuah ulasan terdiri dari deskripsi singkat layanan, rating 5 bintang, nama pengguna, dan waktu saat posting dibuat.
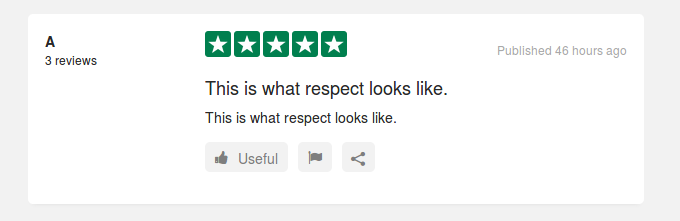
Tujuan Anda adalah menulis sebuah fungsi dalam R yang akan mengekstrak informasi ini untuk perusahaan apa pun yang Anda pilih.
Pertama, Anda perlu memuat semua pustaka untuk tugas ini.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) Sebagai contoh, Anda dapat memilih perusahaan e-commerce Amazon. Ini murni untuk tujuan demonstrasi dan sama sekali tidak terkait dengan studi kasus yang akan Anda bahas di paruh kedua tutorial.
URL halaman arahan akan menjadi pengenal untuk sebuah perusahaan, jadi Anda akan menyimpannya sebagai variabel.
url <-'http://www.trustpilot.com/review/www.amazon.com'
Kebanyakan perusahaan besar memiliki beberapa halaman ulasan. Pada halaman arahan Amazon Anda dapat membaca jumlah halamannya, di sini ada 155.
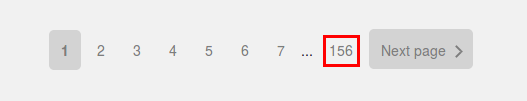
Mengklik salah satu subhalaman mengungkap pola bagaimana URL individual sebuah perusahaan dapat diakses. Masing-masing adalah URL utama dengan tambahan ?page=n, di mana n adalah nomor halaman ulasan, di sini angka apa pun antara 1 dan 155.
Begini cara program Anda seharusnya beroperasi:
Mari mulai dengan menemukan jumlah maksimum halaman. Secara umum, Anda dapat memeriksa elemen visual situs web menggunakan alat pengembangan web bawaan peramban Anda. Gagasannya adalah semua konten situs web, bahkan jika dibuat secara dinamis, ditandai dengan cara tertentu dalam kode sumber. Tag ini biasanya cukup untuk menunjuk data yang ingin Anda ekstrak.
Karena ini hanya pengantar, Anda dapat mengambil jalan yang lebih mudah dan langsung melihat sendiri kode sumbernya.
Data HTML memiliki struktur berikut:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Untuk mendapatkan datanya, Anda memerlukan beberapa fungsi dari paket rvest. Untuk mengonversi situs web menjadi objek XML, gunakan fungsi read_html(). Anda perlu memberikan URL target dan fungsi tersebut akan memanggil server web, mengumpulkan data, dan mem-parsing-nya. Untuk mengekstrak node yang relevan dari objek XML Anda menggunakan html_nodes(), dengan argumen deskriptor kelas yang diawali . untuk menandakan bahwa itu adalah kelas. Keluaran berupa daftar semua node yang ditemukan dengan cara itu. Untuk mengekstrak data bertag, Anda perlu menerapkan html_text() pada node yang Anda inginkan. Untuk kasus di mana Anda perlu mengekstrak atributnya, Anda menerapkan html_attrs(). Ini akan mengembalikan daftar atribut, yang dapat Anda subset untuk mendapatkan atribut yang ingin Anda ekstrak.
Mari terapkan ini dalam praktik. Setelah klik kanan pada halaman arahan Amazon Anda dapat memilih untuk memeriksa kode sumber. Anda dapat mencari angka '155' untuk dengan cepat menemukan bagian yang relevan.
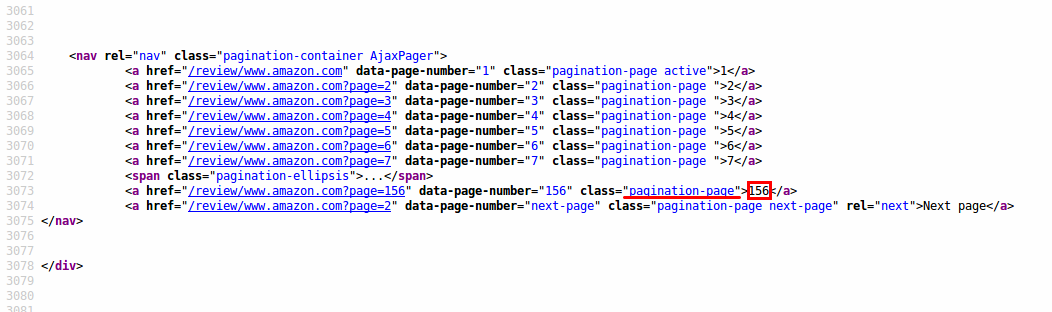
Anda dapat melihat bahwa semua informasi tombol halaman ditandai sebagai kelas 'pagination-page'. Fungsi yang mengambil HTML mentah dari halaman arahan dan mengekstrak item kedua dari belakang dari kelas pagination-page terlihat seperti ini:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
Langkah khusus untuk fungsi ini adalah penerapan fungsi html_nodes() yang mengekstrak semua node dari kelas pagination. Bagian terakhir dari fungsi hanya mengambil item yang benar dari daftar, yaitu yang kedua dari belakang, dan mengonversinya menjadi nilai numerik.
Untuk menguji fungsi, Anda dapat memuat halaman awal menggunakan fungsi read_html() dan menerapkan fungsi yang baru saja Anda tulis:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Sekarang setelah Anda memiliki angka ini, Anda dapat membuat daftar semua URL yang relevan
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Anda dapat memeriksa secara manual bahwa entri ke list_of_pages memang valid dan dapat dipanggil melalui peramban web.
Anda ingin mengekstrak teks ulasan, rating, nama penulis, dan waktu pengiriman semua ulasan pada sebuah subhalaman. Anda dapat mengulangi langkah-langkah sebelumnya untuk setiap bidang yang Anda cari.
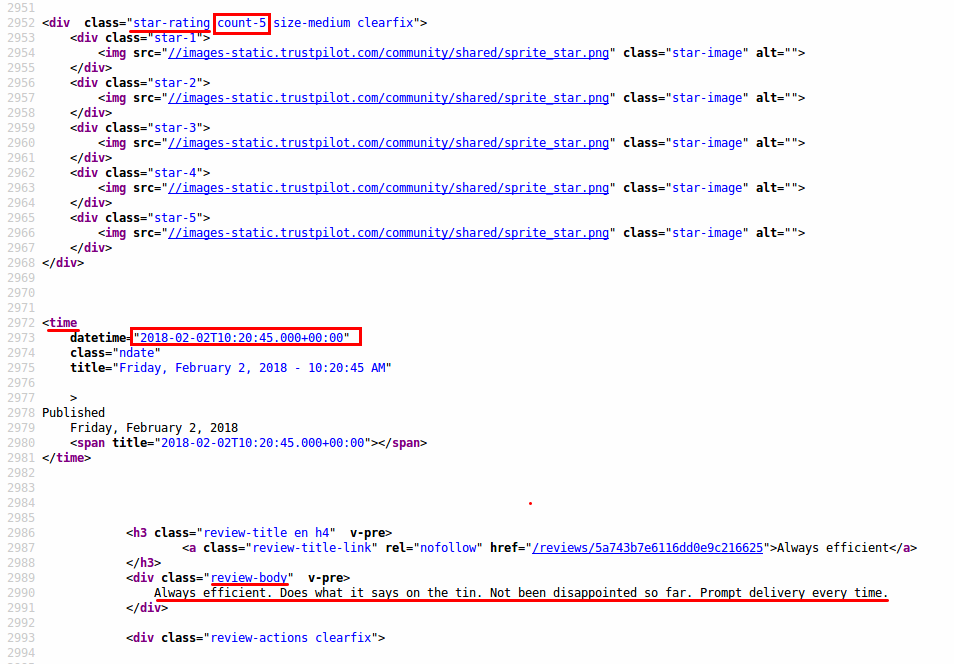
Untuk setiap bidang data Anda menulis satu fungsi ekstraksi menggunakan tag yang Anda amati. Pada titik ini diperlukan sedikit coba-coba untuk mendapatkan data yang Anda inginkan secara tepat. Terkadang Anda akan menemukan bahwa item tambahan ikut tertandai, jadi Anda harus mengurangi keluaran secara manual.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
Informasi tanggal-waktu sedikit lebih rumit, karena disimpan sebagai atribut.
Secara umum, Anda mencari deskripsi yang paling luas lalu mencoba memotong semua informasi yang berlebih. Karena informasi waktu tidak hanya muncul dalam ulasan, Anda juga harus mengekstrak informasi status yang relevan dan memfilternya berdasarkan entri yang benar.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
Fungsi terakhir yang Anda butuhkan adalah ekstraktor rating. Anda akan menggunakan regular expression untuk pencocokan pola. Rating ditempatkan sebagai atribut tag. Alih-alih hanya angka, ia adalah bagian dari string count-X, di mana X adalah angka yang Anda inginkan. Regular expression bisa sedikit merepotkan, tetapi paket rebus memungkinkan untuk menuliskannya dalam bentuk yang mudah dibaca manusia. Selain itu, kemampuan piping rebus, melalui operator %R%, memungkinkan menguraikan pola kompleks menjadi subpola yang lebih sederhana untuk menyusun regular expression yang lebih rumit.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Setelah Anda menguji bahwa fungsi-fungsi ekstraktor individual bekerja pada satu URL, Anda menggabungkannya untuk membuat sebuah tibble, yang pada dasarnya adalah data frame, untuk seluruh halaman. Karena Anda kemungkinan akan menerapkan fungsi ini pada lebih dari satu perusahaan, Anda akan menambahkan bidang dengan nama perusahaan. Ini dapat membantu dalam analisis selanjutnya ketika Anda ingin membandingkan berbagai perusahaan.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Anda membungkus fungsi ini dalam perintah yang mengekstrak HTML dari URL agar penanganannya menjadi lebih mudah.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
Pada langkah terakhir, Anda menerapkan fungsi ini pada daftar URL yang Anda buat sebelumnya. Untuk melakukan ini, Anda menggunakan fungsi map() dari paket purrr yang merupakan bagian dari tidyverse. Fungsi ini menerapkan fungsi yang sama pada item-item sebuah daftar. Anda sudah menggunakan fungsi ini sebelumnya, namun Anda meneruskan sebuah angka n, yang merupakan singkatan untuk mengekstrak subitem ke-n dari daftar.
Terakhir, Anda menulis satu fungsi praktis yang menerima input URL halaman arahan sebuah perusahaan dan label yang ingin Anda berikan pada perusahaan tersebut. Fungsi ini mengekstrak semua ulasan, menggabungkannya menjadi satu tibble. Ini juga merupakan titik awal yang baik untuk mengoptimalkan kode. Fungsi map menerapkan fungsi get_data_from_url() secara berurutan, tetapi tidak harus demikian. Anda bisa menerapkan paralelisasi di sini, sehingga beberapa CPU masing-masing dapat mengambil ulasan untuk subset halaman dan hanya digabungkan di akhir.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Anda menyimpan hasil ke disk menggunakan file bertanda tab, bukan file umum yang dipisahkan koma (CSV), karena ulasan sering kali berisi koma, yang dapat membingungkan parser.
Sebagai contoh Anda dapat menerapkan fungsi ke Amazon:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Dengan fungsi web scraping dari bagian sebelumnya, Anda dapat dengan cepat memperoleh banyak data. Dengan data ini, banyak analisis berbeda dimungkinkan.
Dalam studi kasus ini, Anda hanya akan menggunakan meta-data dari ulasan, yaitu rating mereka dan waktu ulasan.
Pertama, Anda memuat pustaka tambahan.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
Perusahaan yang Anda minati keduanya merupakan pemain terkemuka di industri yang sama. Keduanya juga menggunakan skor TrustPilot mereka sebagai nilai jual di situs web mereka.
Anda telah mengambil data mereka dan hanya perlu memuatnya:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Anda dapat merangkum angka keseluruhan mereka dengan bantuan fungsi group_by() dan summarise() dari paket dplyr:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
Rata-rata rating untuk kedua perusahaan terlihat sebanding. Perusahaan B, yang telah beroperasi sedikit lebih lama, juga tampaknya memiliki rating yang sedikit lebih rendah.
Titik awal yang baik untuk analisis lebih lanjut adalah melihat bagaimana kinerja bulanan berdasarkan rating untuk setiap perusahaan. Pertama, Anda mengekstrak deret waktu dari data lalu mensubsetnya ke titik di mana kedua perusahaan beroperasi dan aktivitas ulasan yang cukup dihasilkan. Ini dapat ditemukan dengan memvisualisasikan deret waktu. Jika ada celah yang sangat besar dalam data selama beberapa bulan berturut-turut, maka kesimpulan yang ditarik dari data menjadi kurang andal.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Sekarang Anda dapat menerapkan perataan bulanan dengan fungsi apply.monthly() dari paket xts. Untuk mulai, kumpulkan rata-rata bulanan rating untuk setiap perusahaan. Deret waktu dapat memiliki lebih dari satu pengamatan untuk indeks yang sama. Untuk menentukan bahwa rata-rata diambil terhadap satu kolom, di sini rating, kita harus meneruskan colMeans.
Berikutnya, jangan lupa meneruskan length ke argumen FUN untuk mengambil jumlah bulanan. Ini karena deret waktu dapat dipandang sebagai vektor. Setiap ulasan menambah panjang vektor tersebut satu dan fungsi length pada dasarnya menghitung ulasannya.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Selanjutnya, Anda dapat membandingkan rating dan jumlah bulanan. Ini sangat mudah dilakukan dengan memplot rata-rata rating bulanan untuk setiap perusahaan dan jumlah untuk rating tersebut untuk setiap perusahaan dalam plot terpisah dan kemudian menyusunnya dalam kisi:
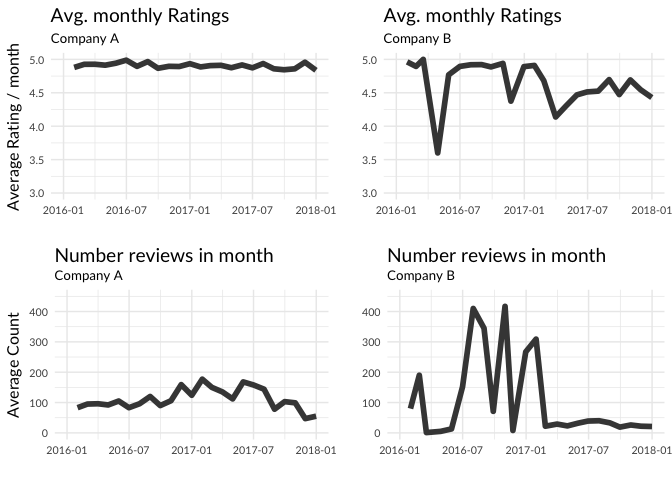
Tampaknya perusahaan A memiliki rating tinggi yang jauh lebih konsisten. Namun bukan hanya itu, untuk perusahaan B, jumlah ulasan bulanan menunjukkan lonjakan yang sangat mencolok, terutama setelah periode ulasan yang biasa-biasa saja.
Apakah ada kemungkinan permainan curang?
Sekarang setelah Anda melihat bahwa data, terutama untuk perusahaan B, berubah cukup dramatis dari waktu ke waktu, pertanyaan yang wajar untuk ditanyakan adalah bagaimana aktivitas ulasan didistribusikan dalam sepekan atau dalam sehari.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
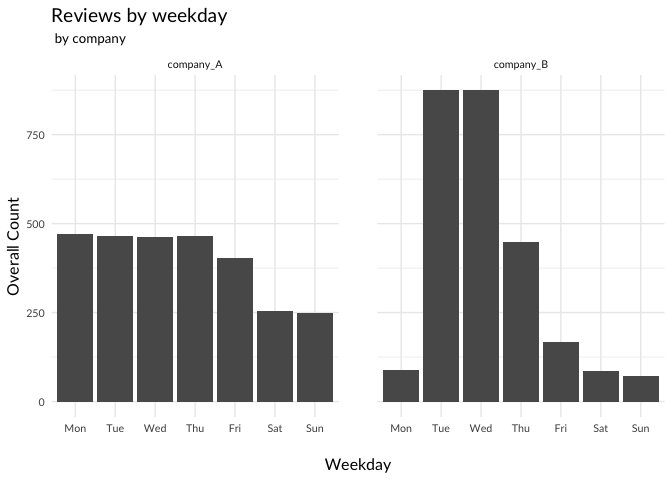
Jika Anda memplot ulasan menurut hari dalam sepekan dan jam dalam sepekan, Anda juga mendapatkan perbedaan yang luar biasa:
Pembagian berdasarkan waktu dalam sehari dari ulasan juga menunjukkan perbedaan mencolok antara kedua pesaing:
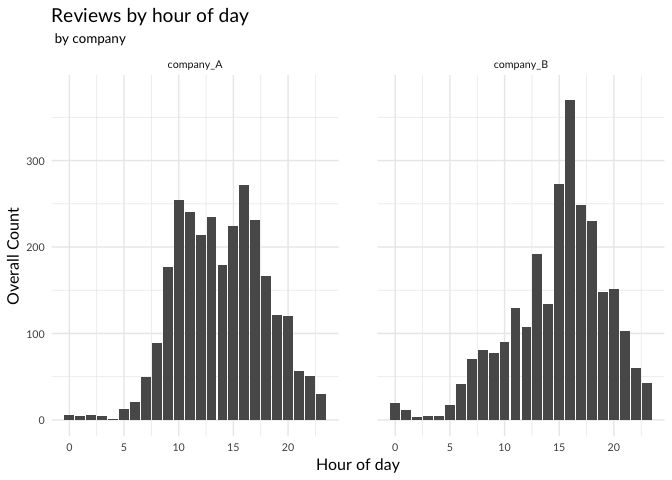
Terlihat seolah lebih banyak ulasan ditulis pada siang hari daripada malam. Namun perusahaan B menunjukkan puncak yang jelas pada ulasan yang ditulis di sore hari.
Pola-pola ini tampaknya mengindikasikan ada sesuatu yang janggal di perusahaan B. Mungkin sebagian ulasan tidak ditulis oleh pengguna, melainkan oleh profesional. Anda akan mengharapkan ulasan ini, rata-rata, lebih baik daripada yang ditulis oleh orang biasa. Karena aktivitas ulasan untuk perusahaan B jauh lebih tinggi selama hari kerja, tampaknya mungkin para profesional menulis ulasan mereka pada salah satu hari tersebut. Sekarang Anda dapat merumuskan hipotesis nol yang dapat Anda coba sangkal menggunakan bukti dari data.
Tidak ada perbedaan sistematis antara ulasan yang ditulis pada hari kerja versus ulasan yang ditulis pada akhir pekan.
Untuk mengujinya, Anda membagi ulasan perusahaan B menjadi yang ditulis pada hari kerja dan yang ditulis pada akhir pekan, lalu periksa rata-rata ratingnya
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Tentu saja terlihat seperti perbedaan yang cukup kecil, tetapi apakah itu murni kebetulan?
Anda dapat mengekstrak perbedaan rata-ratanya:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Jika memang tidak ada perbedaan antara hari kerja dan akhir pekan, maka Anda bisa cukup mengacak label is_weekend dan perbedaan antara rata-rata seharusnya berada pada ordo besaran yang sama. Cara yang nyaman untuk melakukan 'Statistik Hacker' semacam ini disediakan oleh paket infer:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Di sini Anda telah menentukan relasi yang ingin diuji, hipotesis independensi Anda dan Anda memberi tahu fungsi untuk menghasilkan 10000 permutasi, menghitung perbedaan rata-rata rating, untuk masing-masingnya. Sekarang Anda dapat menghitung frekuensi permutasi yang menghasilkan, secara kebetulan, perbedaan rata-rata rating seperti itu:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
Memang, kemungkinan efek yang diamati merupakan kebetulan semata sangatlah kecil. Ini tidak membuktikan perbuatan salah, namun sangat mencurigakan. Misalnya, melakukan eksperimen yang sama untuk perusahaan A menghasilkan nilai p sebesar 0,561, yang berarti sangat mungkin mendapatkan nilai setara ekstrem dengan yang diamati, yang tentu saja tidak membatalkan hipotesis nol Anda.
Dalam tutorial ini, Anda telah menulis program sederhana yang memungkinkan Anda melakukan scraping data dari situs TrustPilot. Data disusun dalam tabel data yang rapi dan menghadirkan peluang untuk sejumlah besar analisis lanjutan.
Sebagai contoh, Anda melakukan scraping informasi untuk dua perusahaan yang bergerak di industri yang sama. Anda menganalisis meta-data mereka dan menemukan pola mencurigakan untuk salah satunya. Anda menggunakan pengujian hipotesis untuk menunjukkan bahwa ada efek sistematis dari hari kerja terhadap rating salah satu perusahaan. Ini merupakan indikator bahwa ulasan telah dimanipulasi, karena tidak ada penjelasan baik lainnya mengapa harus ada perbedaan seperti itu. Anda tidak dapat memverifikasi efek ini untuk perusahaan lainnya, yang bagaimanapun tidak berarti bahwa ulasan mereka pasti jujur.
Informasi lebih lanjut tentang situs ulasan yang dipenuhi ulasan palsu dapat ditemukan misalnya di Guardian.
Ingin mempelajari lebih lanjut tentang Web scraping di R? Lihat tutorial Web Scraping and Parsing Data in R kami.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



