Curso
Introdução ao Tidyverse
4 h
394.9K
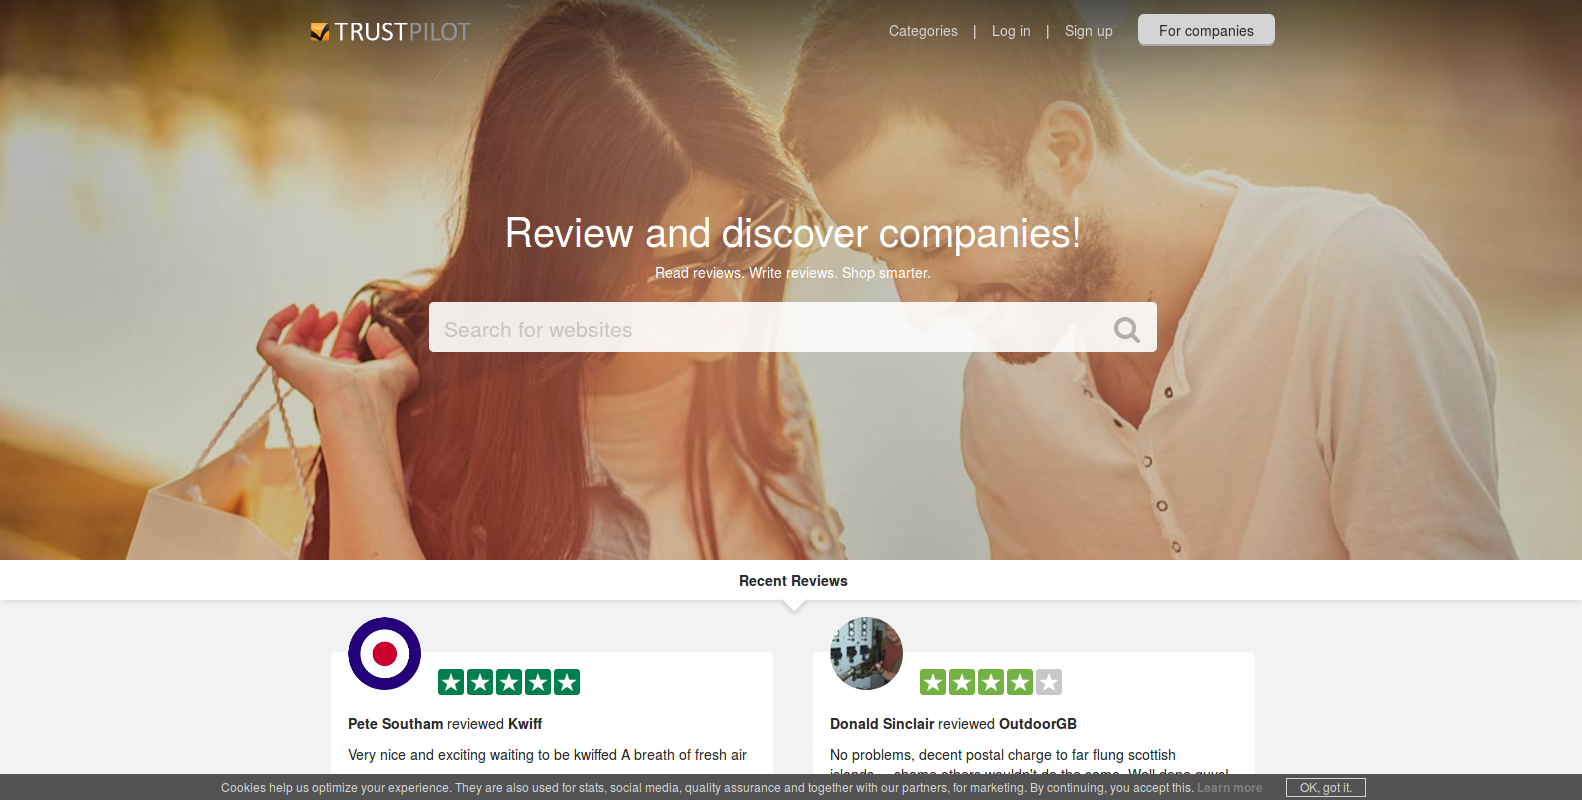
A Trustpilot se tornou um site popular para clientes avaliarem empresas e serviços. Neste tutorial rápido, você vai aprender a coletar informações úteis desse site e gerar alguns insights básicos com a ajuda do R. Você vai descobrir que a Trustpilot talvez não seja tão confiável quanto parece.
Mais especificamente, este tutorial cobre:
ggplot2 e dplyr, em combinação com xts, para explorar os dados e formular uma hipótese, que você poderá investigar com o pacote infer, de inferência estatística alinhado à filosofia do tidyverse.Na Trustpilot, uma avaliação traz uma breve descrição do serviço, uma nota de 1 a 5 estrelas, um nome de usuário e a data/hora da publicação.
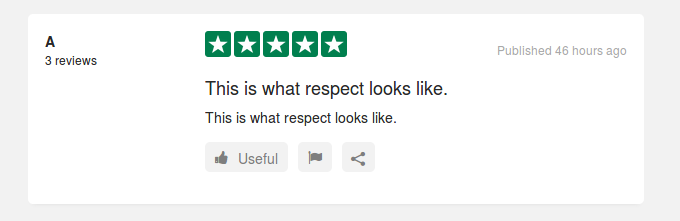
Seu objetivo é escrever uma função em R que extraia essas informações para qualquer empresa que você escolher.
Para começar, carregue todas as bibliotecas necessárias.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) Como exemplo, você pode escolher a Amazon. Isso é apenas para demonstração e não tem relação com o estudo de caso da segunda parte do tutorial.
A URL da landing page será o identificador da empresa, então vamos armazená-la em uma variável.
url <-'http://www.trustpilot.com/review/www.amazon.com'
Muitas empresas grandes têm várias páginas de avaliações. Na landing page da Amazon, você encontra o número de páginas; aqui, são 155.
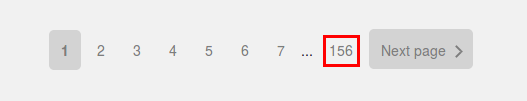
Ao clicar em qualquer subpágina, fica claro o padrão das URLs individuais: cada uma é a URL principal com ?page=n ao final, onde n é o número da página de avaliações (neste caso, de 1 a 155).
Seu programa deve operar assim:
Vamos começar encontrando o número máximo de páginas. Em geral, você pode inspecionar os elementos visuais de um site usando as ferramentas de desenvolvedor do seu navegador. A ideia é que todo o conteúdo do site, mesmo se gerado dinamicamente, está marcado de alguma forma no código-fonte. Esses seletores costumam ser suficientes para localizar os dados que você quer extrair.
Como esta é só uma introdução, vamos pelo caminho simples e olhar o código-fonte diretamente.
Os dados HTML têm a seguinte estrutura:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Para chegar aos dados, você vai usar funções do pacote rvest. Para converter um site em um objeto XML, use read_html(). Você fornece a URL e a função acessa o servidor, coleta os dados e faz o parsing. Para extrair os nós relevantes do objeto XML, use html_nodes(), cujo argumento é o seletor de classe, precedido por . para indicar que é uma classe. A saída será uma lista com todos os nós encontrados. Para extrair o texto marcado, aplique html_text() aos nós desejados. Quando precisar extrair atributos, use html_attrs(). Isso retorna uma lista de atributos, que você pode subconjuntar para pegar o atributo de interesse.
Vamos à prática. Após clicar com o botão direito na landing page da Amazon, escolha inspecionar o código-fonte. Procure por "155" para encontrar rapidamente a seção relevante.
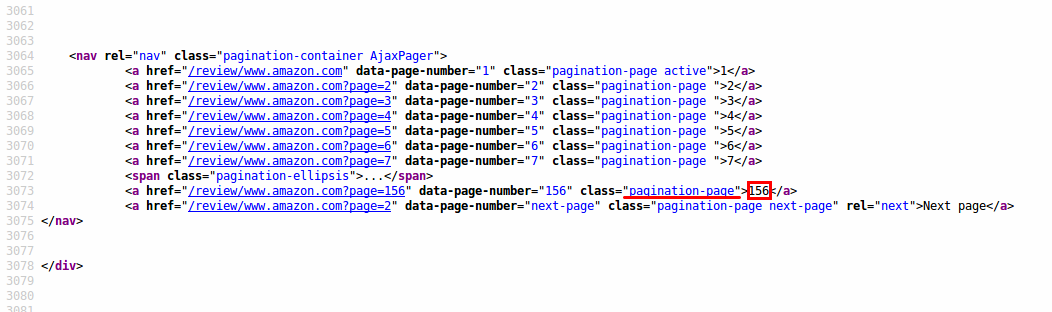
Você verá que todas as informações dos botões de página estão marcadas com a classe 'pagination-page'. Uma função que recebe o HTML bruto da landing page e extrai o penúltimo item da classe pagination-page fica assim:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
O passo específico aqui é o uso de html_nodes() para extrair todos os nós da classe pagination. No final, a função pega o item certo da lista (o penúltimo) e o converte para número.
Para testar, carregue a página inicial com read_html() e aplique a função que você acabou de escrever:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Com esse número em mãos, gere a lista de todas as URLs relevantes:
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Você pode checar manualmente se as entradas em list_of_pages são válidas e abrem no navegador.
Você quer extrair o texto da avaliação, a nota, o nome do autor e a data/hora de envio de todas as avaliações em uma subpágina. Repita os passos anteriores para cada campo desejado.
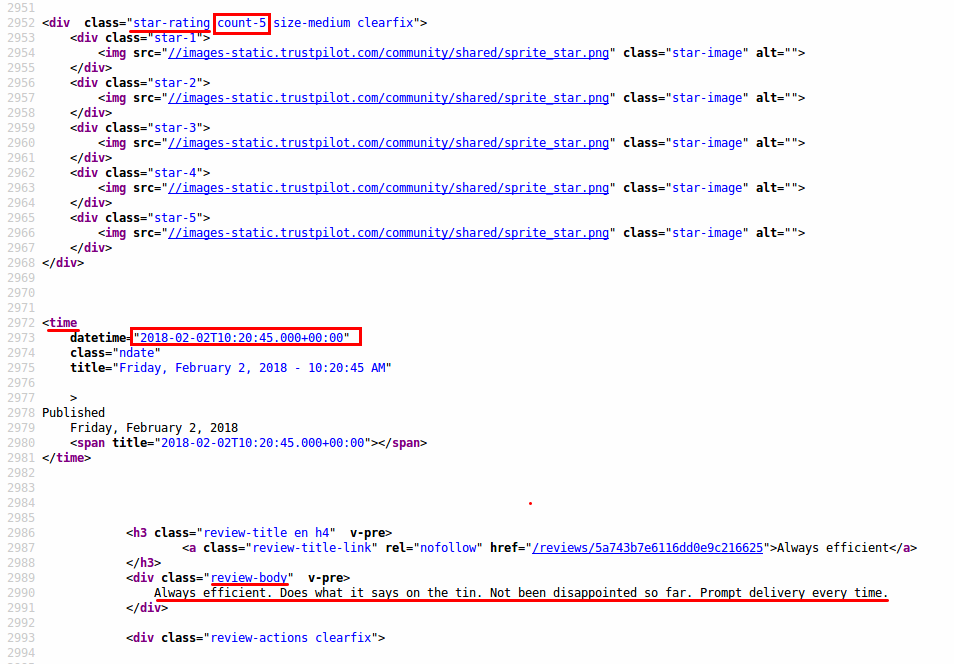
Para cada campo, escreva uma função de extração usando os seletores observados. Nesta etapa, um pouco de tentativa e erro ajuda a ajustar exatamente o que extrair. Às vezes, itens extras vêm com a mesma classe e você precisa filtrar manualmente.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
As informações de data/hora são um pouco mais complicadas, pois estão em atributos.
Em geral, busque a descrição mais ampla e depois elimine o que for redundante. Como há horários que não pertencem às avaliações, também é preciso extrair o status relevante e filtrar pela entrada correta.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
A última função é a que extrai as notas. Você vai usar expressões regulares para casar padrões. A nota aparece como atributo da tag. Em vez de ser apenas um número, é parte da string count-X, em que X é o número desejado. Expressões regulares podem ser trabalhosas, mas o pacote rebus permite escrevê-las de forma legível. Além disso, o operador %R% do rebus ajuda a compor padrões complexos a partir de subpadrões mais simples.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Depois de testar que as funções de extração funcionam em uma única URL, combine tudo para criar uma tibble (um tipo de data frame) da página inteira. Como você provavelmente aplicará essa função a mais de uma empresa, adicione um campo com o nome da empresa. Isso ajuda na análise posterior quando você quiser comparar empresas.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Encapsule essa função em um comando que extrai o HTML a partir da URL para facilitar o uso.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
No último passo, aplique essa função à lista de URLs gerada antes. Para isso, use map() do pacote purrr (parte do tidyverse), que aplica a mesma função a todos os itens de uma lista. Você já usou a função antes passando um número n, que é um atalho para extrair o n-ésimo subitem da lista.
Por fim, escreva uma função prática que recebe a URL da landing page de uma empresa e o rótulo que você quer dar a ela. Ela extrai todas as avaliações e as combina em uma única tibble. Este também é um bom ponto para otimizar o código. A função map aplica get_data_from_url() em sequência, mas não precisa ser assim. Você pode paralelizar, com várias CPUs buscando subconjuntos de páginas e combinando os resultados no final.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Você salva o resultado em disco como um arquivo separado por tabulações (TSV), em vez de CSV, porque os textos das avaliações costumam ter vírgulas, o que pode confundir o parser.
Como exemplo, aplique a função à Amazon:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Com a função de web scraping da seção anterior, você consegue obter muitos dados rapidamente. Com eles, várias análises são possíveis.
Neste estudo de caso, vamos usar apenas metadados das avaliações: a nota e o horário da avaliação.
Primeiro, carregue bibliotecas adicionais.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
As empresas de interesse são ambas players de destaque no mesmo setor. E usam suas notas na Trustpilot como argumento de venda em seus sites.
Você já fez o scraping dos dados e só precisa carregá-los:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Você pode resumir os números gerais com group_by() e summarise() do dplyr:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
As médias das notas parecem comparáveis. A empresa B, que atua há um pouco mais de tempo, também parece ter uma média ligeiramente menor.
Um bom ponto de partida é analisar o desempenho mês a mês por nota em cada empresa. Primeiro, extraia séries temporais dos dados e depois reduza para um período em que ambas estavam ativas e havia avaliação suficiente. Você encontra esse ponto visualizando as séries. Se houver grandes lacunas de vários meses, as conclusões a partir desses dados ficam menos confiáveis.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Agora aplique a média mensal com apply.monthly() do xts. Para começar, calcule as médias mensais de nota de cada empresa. Séries temporais podem ter mais de uma observação por índice. Para especificar que a média é calculada por um campo (aqui, rating), passamos colMeans.
Em seguida, não esqueça de passar length no argumento FUN para obter as contagens mensais. A série pode ser vista como um vetor: cada avaliação aumenta seu comprimento em 1 e length conta as avaliações.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Agora compare as notas e contagens mensais. É fácil: faça os gráficos das médias mensais de cada empresa e das contagens mensais em gráficos separados e organize em uma grade:
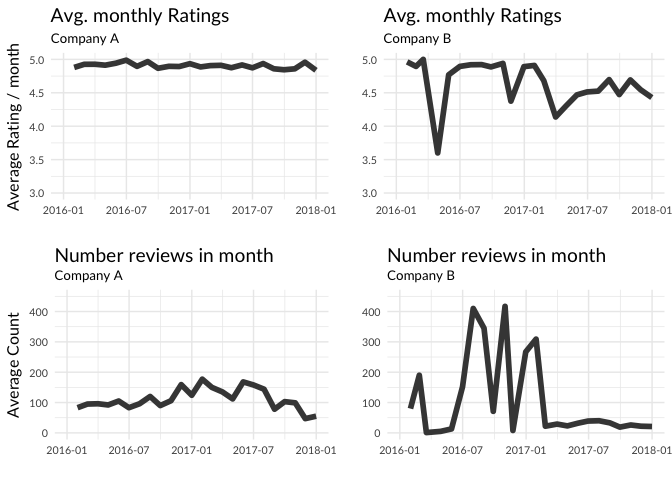
Parece que a empresa A tem notas consistentemente mais altas. Além disso, na empresa B, o número mensal de avaliações mostra picos bem marcados, especialmente após uma sequência de avaliações medianas.
Será que há algo estranho acontecendo?
Como os dados — especialmente da empresa B — variam bastante ao longo do tempo, uma pergunta natural é: como a atividade de avaliações se distribui ao longo da semana e do dia?
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
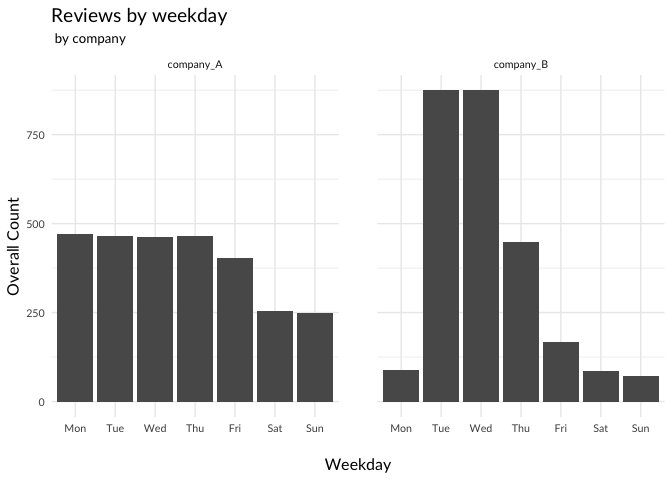
Ao plotar as avaliações por dia da semana e por hora, surgem diferenças notáveis:
Ao dividir por hora do dia, as diferenças entre as duas empresas também chamam atenção:
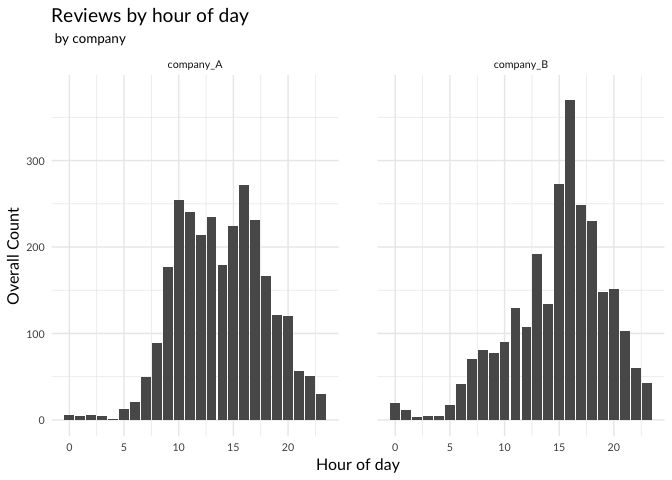
Parece que há mais avaliações durante o dia do que à noite. Já a empresa B mostra um pico acentuado à tarde.
Esses padrões indicam que pode haver algo suspeito na empresa B. Talvez algumas avaliações não sejam de usuários, e sim de profissionais. Espera-se que essas avaliações sejam, em média, melhores do que as escritas por pessoas comuns. Como a atividade de avaliações da empresa B é muito maior nos dias úteis, é provável que profissionais escrevam nesses dias. Agora, você pode formular uma hipótese nula a ser testada com os dados.
Não há diferença sistemática entre avaliações escritas em dias úteis e nos fins de semana.
Para testar, separe as avaliações da empresa B entre dias úteis e fins de semana e compare as médias:
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Parece uma diferença pequena, mas será que é só acaso?
Você pode extrair a diferença entre as médias:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Se realmente não houvesse diferença entre dias úteis e fins de semana, poderíamos simplesmente permutar o rótulo is_weekend e a diferença entre as médias deveria ser da mesma ordem de grandeza. Uma forma prática de fazer esse tipo de "hacker statistics" é com o pacote infer:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Aqui, você especificou a relação a testar, a hipótese de independência e pediu 10.000 permutações, calculando a diferença na média da nota em cada uma. Agora, calcule a frequência de se obter por acaso uma diferença tão grande quanto a observada:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
De fato, a chance de o efeito observado ser puro acaso é baixíssima. Isso não prova má conduta, mas é bem suspeito. Por exemplo, fazendo o mesmo experimento para a empresa A, obtemos p = 0,561, o que indica que é muito provável observar um valor tão extremo quanto o observado — não refutando a hipótese nula.
Neste tutorial, você escreveu um programa simples que permite coletar dados do site Trustpilot. Os dados ficam estruturados em um formato tidy e abrem espaço para muitas análises.
Como exemplo, você extraiu informações de duas empresas do mesmo setor. Ao analisar os metadados, encontrou padrões suspeitos em uma delas. Usou testes de hipótese para mostrar que existe um efeito sistemático do dia da semana nas notas de uma empresa — um indicativo de possível manipulação, já que não há outra boa explicação para uma diferença assim. Você não verificou esse efeito na outra empresa, o que não significa necessariamente que suas avaliações sejam totalmente autênticas.
Mais informações sobre a presença de avaliações falsas em sites de review podem ser encontradas, por exemplo, no Guardian.
Quer aprender mais sobre web scraping em R? Confira nosso tutorial Web Scraping and Parsing Data in R.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Ryan Sheehy
3 min
Tutorial
Elena Kosourova
12 min



