Kurs
Tidyverse’a Giriş
4 sa
397.5K
Trustpilot, müşterilerin işletmeler ve hizmetler hakkında yorum yaptığı popüler bir site haline geldi. Bu kısa eğitimde, R yardımıyla bu siteden faydalı bilgiler toplamayı ve bunlardan temel içgörüler üretmeyi öğreneceksiniz. TrustPilot’un, reklam edildiği kadar güvenilir olmayabileceğini göreceksiniz.
Daha spesifik olarak, bu eğitim aşağıdakileri kapsayacak:
ggplot2 ve dplyr gibi tidyverse paketlerinden, xts ile birlikte yararlanarak veriyi daha derinlemesine inceleyecek ve infer paketiyle (tidyverse felsefesini izleyen bir istatistiksel çıkarım paketi) daha fazla araştırabileceğiniz bir hipotez oluşturacaksınız.Trustpilot’ta bir yorum; hizmetin kısa bir açıklaması, 5 yıldızlı bir puan, bir kullanıcı adı ve gönderim zamanından oluşur.
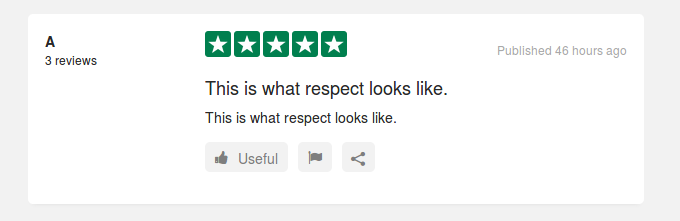
Amacınız, seçtiğiniz herhangi bir şirket için bu bilgileri çıkaracak bir R fonksiyonu yazmaktır.
Öncelikle, bu görev için gerekli tüm kütüphaneleri yüklemeniz gerekir.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) Örnek olarak e-ticaret şirketi Amazon’u seçebilirsiniz. Bu yalnızca gösterim amaçlıdır ve eğitimin ikinci yarısında ele alacağınız vaka çalışmasıyla herhangi bir ilişkisi yoktur.
Açılış sayfası URL’si bir şirket için tanımlayıcı olacaktır, bu yüzden bunu bir değişken olarak saklayacaksınız.
url <-'http://www.trustpilot.com/review/www.amazon.com'
Çoğu büyük şirketin birden fazla yorum sayfası vardır. Amazon’un açılış sayfasında sayfa sayısını okuyabilirsiniz, burada 155’tir.
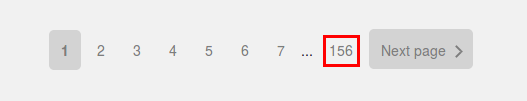
Alt sayfalardan herhangi birine tıklamak, bir şirketin bireysel URL’lerine nasıl erişilebileceğine dair bir örüntü ortaya çıkarır. Her biri ana URL’ye eklenmiş ?page=n biçimindedir; burada n, bir yorum sayfasının numarasıdır; bu örnekte 1 ile 155 arasındaki herhangi bir sayı.
Programınız şu şekilde çalışmalıdır:
Hadi maksimum sayfa sayısını bulmakla başlayalım. Genel olarak, tarayıcınızın yerleşik web geliştirme araçlarını kullanarak bir sitenin görsel öğelerini inceleyebilirsiniz. Bunun arkasındaki fikir; dinamik olarak oluşturulsa bile, bir sitenin tüm içeriğinin kaynak kodda bir şekilde etiketlenmiş olmasıdır. Bu etiketler genellikle çıkarmaya çalıştığınız veriyi nokta atışıyla bulmak için yeterlidir.
Bu yalnızca bir giriş olduğundan, kestirmeden gidip kaynak koduna doğrudan kendiniz bakabilirsiniz.
HTML verisinin yapısı şu şekildedir:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Veriye ulaşmak için rvest paketinin bazı fonksiyonlarına ihtiyacınız olacak. Bir web sitesini XML nesnesine dönüştürmek için read_html() fonksiyonunu kullanırsınız. Bir hedef URL sağlamanız gerekir ve fonksiyon web sunucusunu çağırır, verileri toplar ve ayrıştırır. XML nesnesinden ilgili düğümleri çıkarmak için, argümanı sınıf tanımlayıcısı olan ve bunun bir sınıf olduğunu belirtmek için başına . getirilen html_nodes() fonksiyonunu kullanırsınız. Çıktı, bu şekilde bulunan tüm düğümlerin bir listesi olacaktır. Etiketlenmiş veriyi çıkarmak için, istediğiniz düğümlere html_text() uygularsınız. Öznitelikleri çıkarmanız gereken durumlarda ise html_attrs() uygularsınız. Bu, özniteliklerin bir listesini döndürür; içinden çıkarmak istediğiniz özniteliğe ulaşmak için bu listeyi altkümeleyebilirsiniz.
Bunu uygulamada deneyelim. Amazon’un açılış sayfasında sağ tıklamanın ardından kaynak kodu incelemeyi seçebilirsiniz. İlgili bölümü hızla bulmak için ‘155’ sayısını aratabilirsiniz.
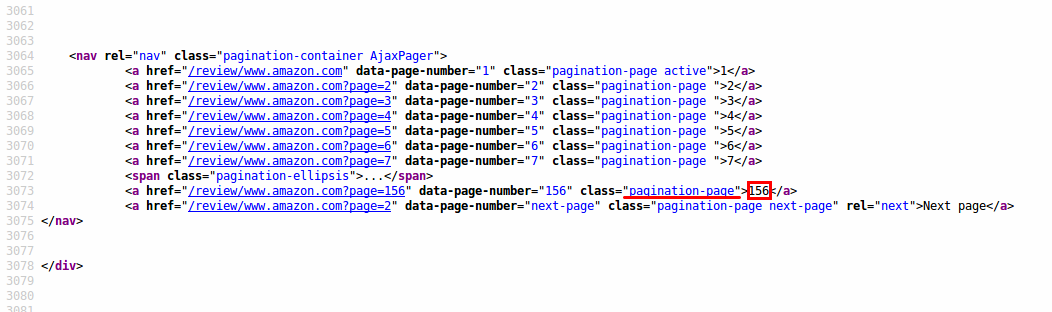
Tüm sayfa düğmesi bilgilerinin 'pagination-page' sınıfı olarak etiketlendiğini görebilirsiniz. Açılış sayfasının ham HTML’sini alan ve pagination-page sınıfındaki sondan bir önceki öğeyi çıkaran bir fonksiyon şu şekildedir:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
Bu fonksiyona özgü adım, pagination sınıfının tüm düğümlerini çıkaran html_nodes() fonksiyonunun uygulanmasıdır. Fonksiyonun son kısmı, listenin doğru öğesini, yani sondan bir öncekini alır ve sayısal bir değere dönüştürür.
Fonksiyonu test etmek için, read_html() fonksiyonunu kullanarak başlangıç sayfasını yükleyebilir ve az önce yazdığınız fonksiyonu uygulayabilirsiniz:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Bu sayıyı elde ettiğinize göre, tüm ilgili URL’lerin bir listesini üretebilirsiniz
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
list_of_pages içindeki girişlerin gerçekten geçerli olduğunu ve bir web tarayıcısı aracılığıyla çağrılabildiğini manuel olarak kontrol edebilirsiniz.
Bir alt sayfadaki tüm yorumların metnini, puanını, yazarın adını ve gönderim zamanını çıkarmak istiyorsunuz. Aradığınız her bir alan için önceki adımları tekrarlayabilirsiniz.
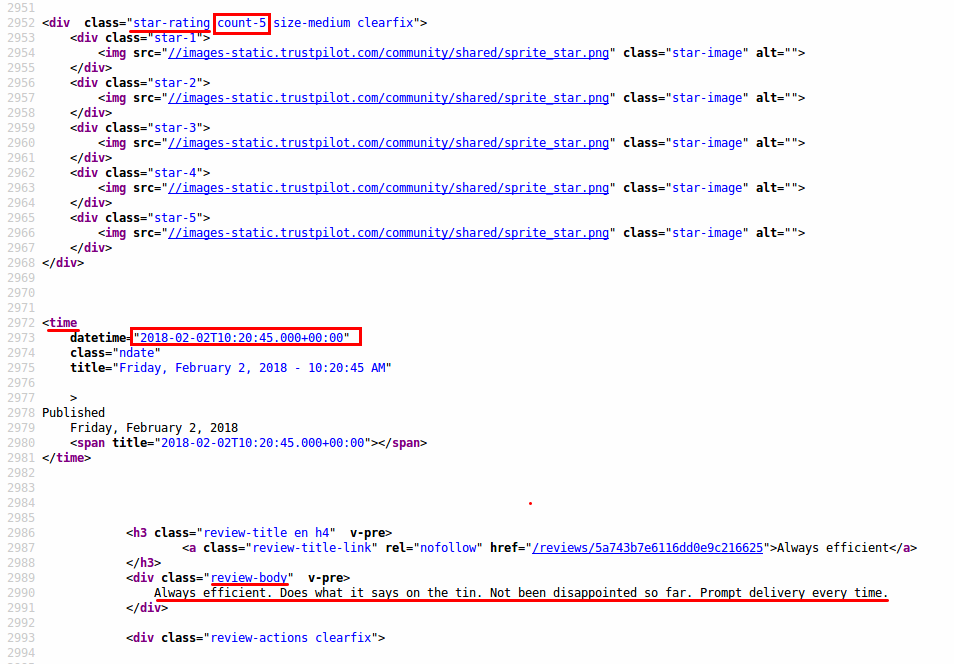
Her bir veri alanı için, gözlemlediğiniz etiketleri kullanarak bir çıkarım fonksiyonu yazarsınız. Bu noktada, tam istediğiniz veriyi almak için biraz deneme-yanılma gerekebilir. Bazen ek öğelerin de etiketlendiğini görürsünüz, bu nedenle çıktıyı manuel olarak kısaltmanız gerekir.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
Tarih-saat bilgisi biraz daha zordur, çünkü bir öznitelik olarak saklanır.
Genel olarak, en geniş tanımı arar ve sonra tüm mükerrer bilgileri ayıklamaya çalışırsınız. Zaman bilgisi yalnızca yorumlarda görünmediğinden, ilgili status bilgisini de çıkarmalı ve doğru girişe göre filtrelemelisiniz.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
İhtiyacınız olan son fonksiyon, puan çıkarıcıdır. Desen eşleme için düzenli ifadeler kullanacaksınız. Puan, etiketin bir özniteliği olarak yer alır. Yalnızca bir sayı olmak yerine, count-X biçimindeki bir dizgenin parçasıdır; burada X istediğiniz sayıdır. Düzenli ifadeler biraz hantal olabilir, ancak rebus paketi bunları okunaklı bir biçimde yazmayı sağlar. Ek olarak, rebus’un %R% işleciyle sağlanan borulama işlevi, karmaşık düzenli ifadeleri yapılandırmak için karmaşık desenleri daha basit alt desenlere ayırmaya olanak tanır.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Tek bir URL’de bireysel çıkarım fonksiyonlarının çalıştığını test ettikten sonra, bunları bir araya getirerek tüm sayfa için bir tibble, yani esasen bir veri çerçevesi oluşturursunuz. Bu fonksiyonu birden fazla şirkete uygulamanız muhtemel olduğundan, şirket adını içeren bir alan eklersiniz. Bu, daha sonra farklı şirketleri karşılaştırmak istediğiniz analizlerde yardımcı olabilir.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Bu fonksiyonu, URL’den HTML’yi çıkaran ve kullanımı daha kolay hale getiren bir komutla sarmalarsınız.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
Son adımda, bu fonksiyonu daha önce oluşturduğunuz URL listesine uygularsınız. Bunu yapmak için, tidyverse’ün bir parçası olan purrr paketindeki map() fonksiyonunu kullanırsınız. Bu fonksiyon, bir listenin öğeleri üzerinde aynı fonksiyonu uygular. Fonksiyonu daha önce de kullanmıştınız; ancak o zaman bir sayı n geçirmiştiniz; bu, listenin n’inci alt öğesini çıkarmanın kısayoludur.
Son olarak, bir şirketin açılış sayfası URL’sini ve şirkete vermek istediğiniz etiketi girdi olarak alan kullanışlı bir fonksiyon yazarsınız. Tüm yorumları çıkarır ve bunları tek bir tibble’da birleştirir. Bu, kodu iyileştirmek için de iyi bir başlangıç noktasıdır. map fonksiyonu get_data_from_url() fonksiyonunu sıralı olarak uygular, ancak bu şart değildir. Burada paralelleştirme uygulanabilir; böylece birden fazla CPU, sayfaların bir alt kümesi için yorumları ayrı ayrı alır ve yalnızca sonunda birleştirilirler.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Sonucu diske kaydetmek için, yorumlar genellikle ayrıştırıcıyı şaşırtabilecek virgüller içerdiğinden, yaygın virgülle ayrılmış dosyalar (CSV) yerine sekmeyle ayrılmış bir dosya kullanırsınız.
Örnek olarak, fonksiyonu Amazon’a uygulayabilirsiniz:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Önceki bölümdeki web kazıma fonksiyonuyla hızla çok sayıda veri elde edebilirsiniz. Bu verilerle birçok farklı analiz mümkündür.
Bu vaka çalışmasında yalnızca yorumların meta verilerini, yani puanlarını ve yorum zamanını kullanacaksınız.
Önce ek kütüphaneleri yüklersiniz.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
İlgilendiğiniz şirketler aynı sektördeki iki önde gelen oyuncudur. Her ikisi de web sitelerinde satış argümanı olarak TrustPilot puanlarını kullanmaktadır.
Verilerini kazıdınız ve yalnızca yüklemeniz gerekiyor:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Genel sayılarını dplyr paketindeki group_by() ve summarise() fonksiyonlarının yardımıyla özetleyebilirsiniz:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
İki şirketin ortalama puanları karşılaştırılabilir görünüyor. Biraz daha uzun süredir faaliyet gösteren Şirket B’nin puanı da biraz daha düşük görünüyor.
Daha fazla analiz için iyi bir başlangıç noktası, her şirketin ay ay puan performansına bakmaktır. Önce verilerden zaman serileri çıkarır, ardından her iki şirketin de faaliyette olduğu ve yeterli yorum etkinliğinin üretildiği bir noktaya kadar altküme oluşturursunuz. Bu, zaman serilerini görselleştirerek bulunabilir. Veride arka arkaya birkaç ay boyunca çok büyük boşluklar varsa, veriden çıkarılan sonuçlar daha az güvenilirdir.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Şimdi xts paketindeki apply.monthly() fonksiyonuyla aylık ortalamayı uygulayabilirsiniz. Başlamak için, her şirketin aylık ortalama puanlarını toplayın. Zaman serilerinin aynı indeks için birden fazla gözlemi olabilir. Ortalamanın tek bir alana göre alınacağını, burada rating, belirtmek için colMeans geçirmemiz gerekir.
Ardından, aylık sayıları elde etmek için FUN argümanına length geçirmeyi unutmayın. Bunun nedeni, zaman serisinin bir vektör olarak görülebilmesidir. Her yorum bu vektörün uzunluğunu bir artırır ve length fonksiyonu özünde yorumları sayar.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Sonraki adımda, aylık puanları ve sayıları karşılaştırabilirsiniz. Her şirket için aylık ortalama puanları ve her şirket için bu puanların sayılarını ayrı grafiklerde çizmek ve ardından bunları bir ızgarada düzenlemek oldukça kolaydır:
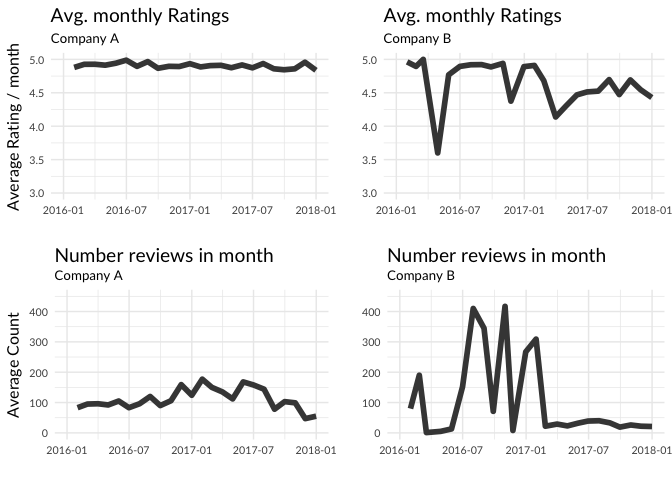
Şirket A’nın puanlarının çok daha tutarlı şekilde yüksek olduğu görülüyor. Ancak sadece bu değil, Şirket B için aylık yorum sayısı da özellikle vasat yorumların ardından belirgin sivrilmeler gösteriyor.
İşin içinde bir hile olma ihtimali olabilir mi?
Verinin, özellikle Şirket B için, zaman içinde oldukça dramatik biçimde değiştiğini gördüğünüze göre, doğal bir soru; yorum etkinliğinin hafta içinde veya gün içinde nasıl dağıldığıdır.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
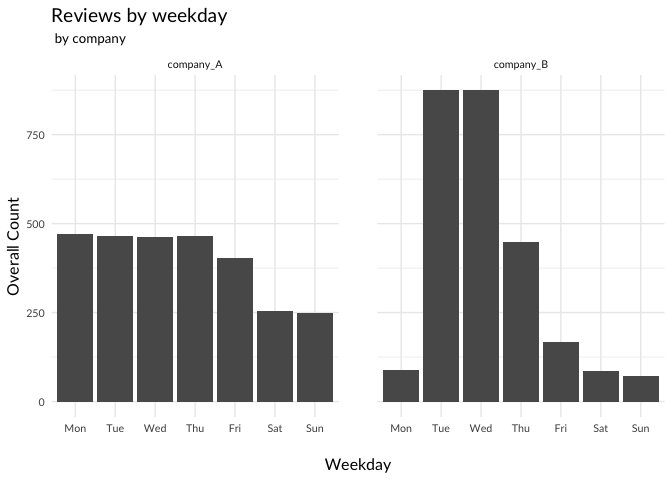
Yorumları hafta günü ve haftanın saati bazında görselleştirirseniz, dikkat çekici farklılıklar da elde edersiniz:
Yorumların günün saatine göre ayrımı da iki rakip arasında çarpıcı farklılıklar gösterir:
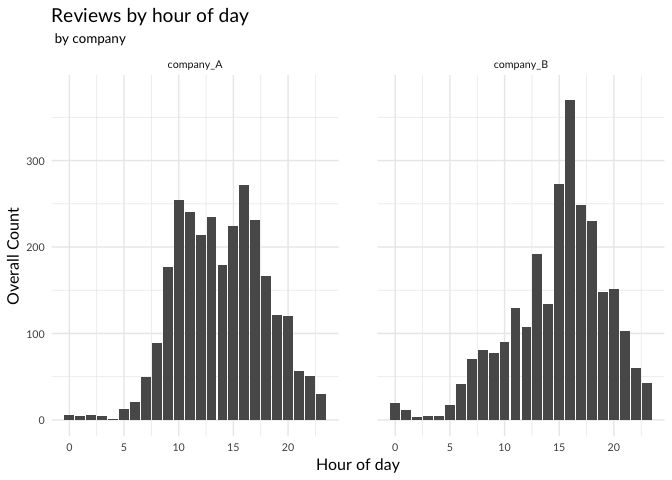
Daha fazla yorumun gündüz, geceden ziyade yazıldığı görülüyor. Ancak Şirket B, öğleden sonra yazılan yorumlarda belirgin bir zirve sergiliyor.
Bu örüntüler, Şirket B’de şüpheli bir şeyler olduğuna işaret ediyor gibi görünüyor. Belki de bazı yorumlar kullanıcılar tarafından değil, profesyoneller tarafından yazılıyor. Bu yorumların, ortalama olarak, sıradan insanlar tarafından yazılanlardan daha iyi olmasını beklersiniz. Şirket B için yorum etkinliği hafta içi günlerde çok daha yüksek olduğundan, profesyonellerin yorumlarını bu günlerde yazması olası görünüyor. Artık verilerden elde edilen kanıtları kullanarak çürütmeye çalışabileceğiniz bir sıfır hipotezi formüle edebilirsiniz.
Hafta içi bir günde yazılan yorumlarla hafta sonunda yazılan yorumlar arasında sistematik bir fark yoktur.
Bunu test etmek için, Şirket B’nin yorumlarını hafta içi yazılanlar ve hafta sonu yazılanlar olarak ikiye ayırır ve ortalama puanlarını kontrol edersiniz
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Bu kesinlikle yeterince küçük bir fark gibi görünüyor, peki bu safi şans mı?
Ortalama farkını çıkarabilirsiniz:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Eğer gerçekten hafta içi ve hafta sonu arasında fark yoksa, is_weekend etiketini basitçe permüte edebilir ve ortalamalar arasındaki fark aynı mertebede olmalıdır. Bu tür ‘Hacker İstatistikleri’ni yapmak için kullanışlı bir yöntem infer paketi tarafından sağlanır:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Burada test etmek istediğiniz ilişkiyi, bağımsızlık hipotezinizi belirttiniz ve fonksiyona 10.000 permütasyon üretmesini, her biri için ortalama puan farkını hesaplamasını söylediniz. Şimdi, permütasyonların tesadüfen bu kadar büyük bir ortalama farkı üretme sıklığını hesaplayabilirsiniz:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
Gerçekten de, gözlenen etkinin salt şans olma olasılığı son derece düşüktür. Bu herhangi bir suistimali kanıtlamaz, ancak oldukça şüphelidir. Örneğin, aynı deneyi Şirket A için yaptığınızda 0,561’lik bir p değeri elde edilir; bu da gözlenen kadar uç bir değeri elde etmenin çok olası olduğu anlamına gelir; bu ise sıfır hipotezinizi kesinlikle geçersiz kılmaz.
Bu eğitimde, TrustPilot sitesinden veri kazımanıza olanak tanıyan basit bir program yazdınız. Veriler, düzenli bir veri tablosu halinde yapılandırıldı ve çok sayıda ileri analiz için fırsat sunuyor.
Örnek olarak, aynı sektörde faaliyet gösteren iki şirket için bilgi kazıdınız. Meta verilerini analiz ettiniz ve birinde şüpheli örüntüler buldunuz. Bir şirketin puanları üzerinde hafta gününün sistematik bir etkisi olduğunu göstermek için hipotez testini kullandınız. Bu, yorumların manipüle edildiğine dair bir göstergedir; çünkü bu farkın neden var olması gerektiğine dair başka makul bir açıklama yoktur. Diğer şirket için bu etkiyi doğrulayamadınız; ancak bu, onların yorumlarının mutlaka dürüst olduğu anlamına gelmez.
Sahte yorumların tüketici sitelerini istila etmesi hakkında daha fazla bilgiye örneğin Guardian’dan ulaşabilirsiniz.
R’de Web kazıma hakkında daha fazla bilgi edinmek ister misiniz? R ile Web Kazıma ve Veri Ayrıştırma eğitimimize göz atın.
R kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



