Cours
Introduction à Tidyverse
4 h
395.3K
Trustpilot est devenu un site incontournable où les clients évaluent des entreprises et des services. Dans ce court tutoriel, vous apprendrez à extraire des informations utiles de ce site et à en tirer des premiers enseignements avec R. Vous verrez que Trustpilot n'est peut-être pas aussi fiable qu'il y paraît.
Plus précisément, ce tutoriel couvre :
ggplot2 et dplyr, combinés à xts, pour explorer plus finement les données et formuler une hypothèse, que vous approfondirez avec le package infer, dédié à l'inférence statistique dans l'esprit du tidyverse.Sur Trustpilot, un avis comprend une brève description du service, une note sur 5 étoiles, un nom d'utilisateur et la date de publication.
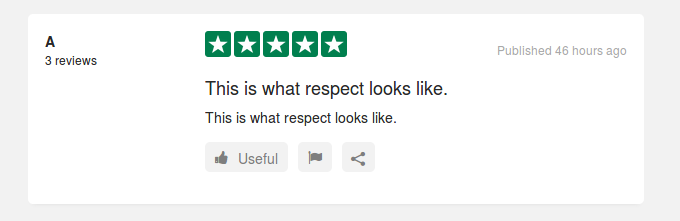
Votre objectif est d'écrire une fonction en R qui extraira ces informations pour n'importe quelle entreprise.
Commencez par charger toutes les bibliothèques nécessaires.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) À titre d'exemple, vous pouvez choisir l'e-commerçant Amazon. C'est uniquement pour la démonstration et sans lien avec l'étude de cas traitée en seconde partie du tutoriel.
L'URL de la page d'accueil fera office d'identifiant de l'entreprise ; stockez-la donc dans une variable.
url <-'http://www.trustpilot.com/review/www.amazon.com'
La plupart des grandes entreprises disposent de plusieurs pages d'avis. Sur la page d'Amazon, vous pouvez lire le nombre de pages : ici, 155.
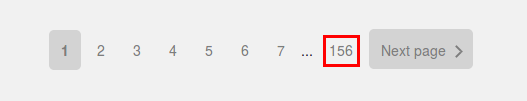
En cliquant sur une sous-page, on observe un motif commun dans les URL : on reprend l'URL principale et on ajoute ?page=n, où n est le numéro de page d'avis, ici entre 1 et 155.
Votre programme doit fonctionner ainsi :
Commençons par trouver le nombre maximal de pages. En général, vous pouvez inspecter les éléments d'une page avec les outils de développement de votre navigateur. L'idée : tout le contenu, même généré dynamiquement, est balisé dans le code source. Ces balises suffisent en général à cibler les données à extraire.
Comme il s'agit d'une introduction, prenons la voie simple et regardons directement le code source.
Une structure HTML ressemble à ceci :
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Pour accéder aux données, vous utiliserez des fonctions du package rvest. Pour convertir une page web en objet XML, utilisez read_html(). Vous fournissez l'URL, la fonction contacte le serveur, récupère les données et les parse. Pour extraire les nœuds pertinents de l'objet XML, utilisez html_nodes() en lui passant le descripteur de classe préfixé par un .. La sortie est la liste de tous les nœuds trouvés. Pour récupérer le texte balisé, appliquez html_text() aux nœuds souhaités. Si vous devez extraire des attributs, utilisez plutôt html_attrs(), puis sous-sélectionnez l'attribut voulu.
Passons à la pratique. Après un clic droit sur la page d'Amazon, ouvrez le code source. Cherchez le nombre « 155 » pour localiser rapidement la section pertinente.
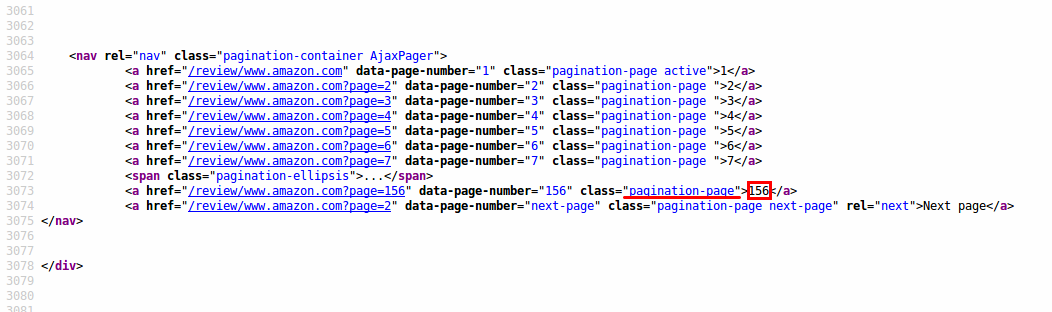
Toute la pagination est balisée avec la classe 'pagination-page'. Une fonction qui prend le HTML brut de la page d'accueil et extrait l'avant-dernier élément de la classe pagination-page ressemble à ceci :
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
L'étape spécifique ici est l'appel à html_nodes(), qui extrait tous les nœuds de la classe pagination. La fin de la fonction sélectionne l'avant-dernier élément de la liste et le convertit en valeur numérique.
Pour tester, chargez la page de départ avec read_html() et appliquez la fonction :
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Avec ce nombre, générez la liste de toutes les URLs pertinentes :
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Vous pouvez vérifier manuellement que les entrées de list_of_pages sont valides et accessibles via un navigateur.
Vous souhaitez extraire le texte de l'avis, la note, le nom de l'auteur et la date de publication pour tous les avis d'une sous-page. Répliquez les étapes précédentes pour chaque champ visé.
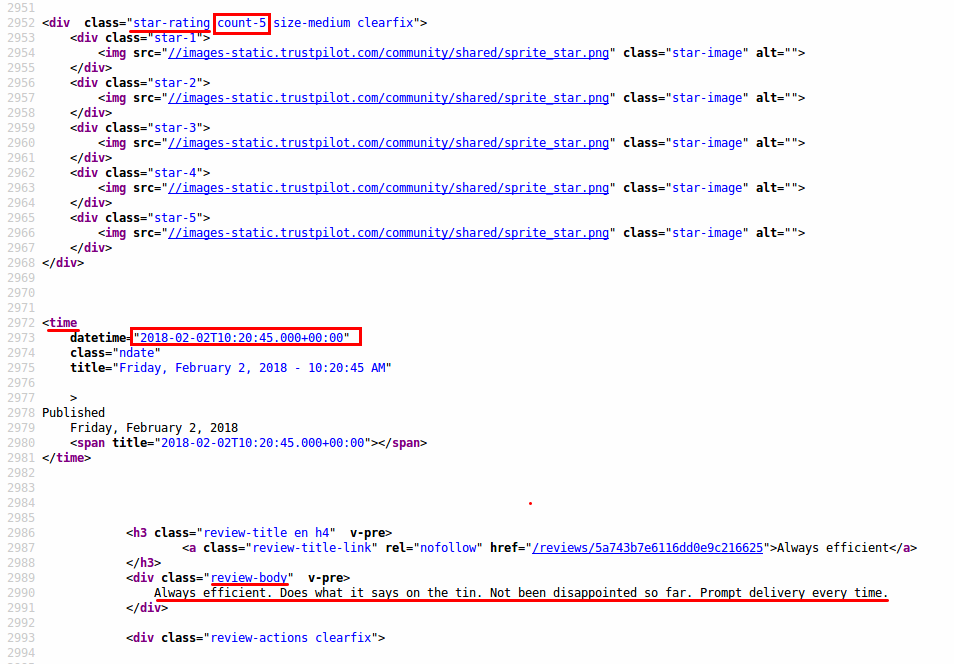
Pour chaque champ, écrivez une fonction d'extraction en vous basant sur les balises repérées. Un peu d'aller-retour sera nécessaire pour ajuster exactement ce que vous voulez. Il arrive que des éléments supplémentaires partagent la même balise : il faut alors élaguer manuellement la sortie.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
Les informations de date/heure sont un peu plus délicates, car stockées en attributs.
En règle générale, partez de la définition la plus large, puis éliminez le superflu. Comme des informations temporelles apparaissent ailleurs que dans les avis, vous devez aussi extraire le status et filtrer la bonne entrée.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
La dernière fonction à écrire extrait les notes. Vous utiliserez des expressions régulières pour faire correspondre les motifs. La note se trouve dans un attribut de balise ; au lieu d'être un simple chiffre, elle est incluse dans une chaîne count-X, où X est le nombre recherché. Les regex peuvent être ardues, mais le package rebus permet de les écrire de manière lisible. Son opérateur %R% aide aussi à composer des motifs complexes à partir de sous-motifs simples.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Après avoir testé que chaque extracteur fonctionne sur une URL, combinez-les pour créer un tibble (un data frame moderne) pour l'ensemble de la page. Comme vous appliquerez probablement cette fonction à plusieurs entreprises, ajoutez un champ avec le nom de l'entreprise : pratique pour comparer par la suite.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Encapsulez cette fonction dans une commande qui extrait le HTML à partir d'une URL pour simplifier l'usage.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
Dernier étape : appliquez cette fonction à la liste d'URLs générée plus tôt. Utilisez pour cela map() du package purrr (tidyverse), qui applique une même fonction à tous les éléments d'une liste. Vous l'avez déjà croisée plus haut en lui passant un nombre n pour extraire le n-ième sous-élément.
Enfin, écrivez une fonction pratique qui prend l'URL de la page d'accueil d'une entreprise et le libellé à lui attribuer, puis extrait tous les avis et les rassemble dans un seul tibble. C'est aussi un bon point de départ pour optimiser le code : map applique get_data_from_url() en série, mais on pourrait paralléliser pour répartir les pages entre plusieurs CPU et ne fusionner qu'en fin de parcours.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Vous enregistrez le résultat au format TSV (tabulations) plutôt qu'au format CSV, car les avis contiennent souvent des virgules qui perturbent l'analyse.
Par exemple, appliquez la fonction à Amazon :
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Avec la fonction de web scraping précédente, vous pouvez récupérer rapidement beaucoup de données. Les analyses possibles sont nombreuses.
Ici, vous n'utiliserez que les métadonnées des avis : leur note et leur date.
Commencez par charger des bibliothèques complémentaires.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
Les entreprises étudiées sont deux acteurs bien connus d'un même marché. Elles mettent aussi en avant leurs scores Trustpilot sur leur site.
Leur données étant déjà scrapées, il suffit de les charger :
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Résumez leurs chiffres globaux avec group_by() et summarise() de dplyr :
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
Les notes moyennes semblent proches. L'entreprise B, présente depuis un peu plus longtemps, affiche également une note légèrement inférieure.
Un bon point de départ consiste à observer la performance mensuelle de chaque entreprise. Extrayez d'abord des séries temporelles, puis restreignez-les à une période où les deux étaient actives et où le volume d'avis est suffisant. La visualisation aide à identifier les périodes à grands trous, sources de conclusions fragiles.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Appliquez ensuite la moyenne mensuelle avec apply.monthly() du package xts. Commencez par les notes moyennes mensuelles. Comme une série peut contenir plusieurs observations au même index, précisez que la moyenne porte sur le champ rating en passant colMeans.
N'oubliez pas de passer length à l'argument FUN pour récupérer les volumes mensuels. La série étant un vecteur, chaque avis augmente sa longueur d'une unité : length compte donc les avis.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Vous pouvez maintenant comparer les notes et les volumes mensuels. Tracez les notes moyennes par mois pour chaque entreprise et, séparément, les nombres d'avis, puis agencez-les en grille :
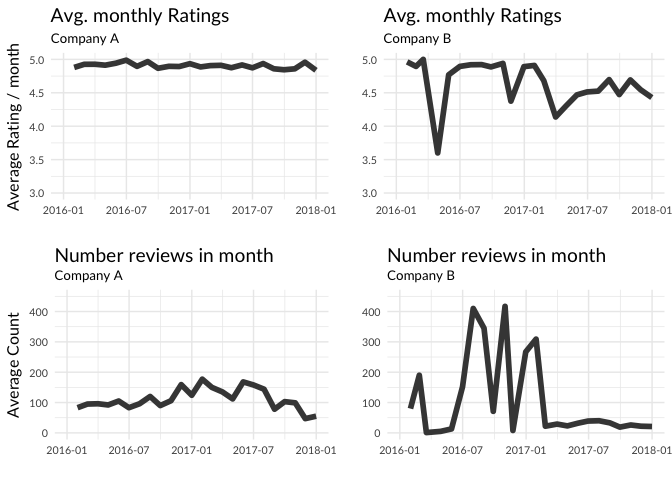
L'entreprise A semble afficher des notes élevées plus régulières. De plus, pour l'entreprise B, le nombre mensuel d'avis présente de forts pics, notamment après des séries d'avis moyens.
Y aurait-il anguille sous roche ?
Après avoir constaté que les données — surtout pour l'entreprise B — varient fortement dans le temps, on peut se demander comment l'activité d'avis se répartit au sein d'une semaine ou d'une journée.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
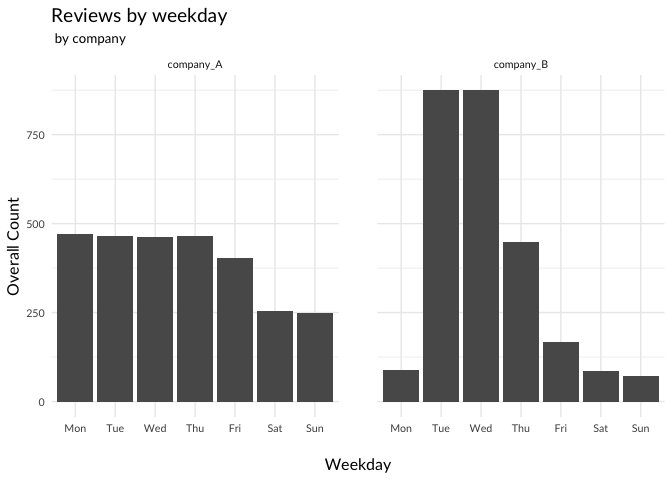
En représentant les avis par jour de la semaine et par heure, on observe aussi des différences marquées :
La répartition par heure de la journée révèle également des écarts frappants entre les deux concurrents :
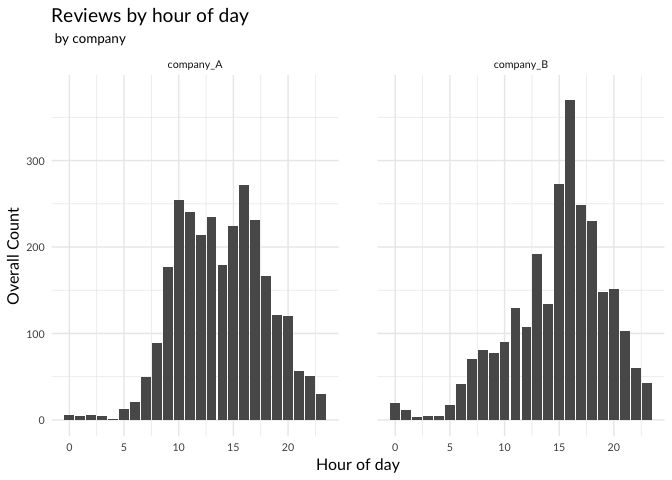
On dirait que davantage d'avis sont rédigés en journée que la nuit. L'entreprise B présente toutefois un pic marqué début d'après-midi.
Ces motifs laissent penser qu'il se passe quelque chose d'étrange chez B. Peut-être que certains avis ne sont pas écrits par des utilisateurs, mais par des professionnels. On s'attendrait alors à ce que ces avis soient, en moyenne, meilleurs que ceux d'utilisateurs ordinaires. Comme l'activité d'avis de B est bien plus forte en semaine, il est plausible que des rédacteurs professionnels publient à ces moments-là. Formulons une hypothèse nulle à tester.
Il n'y a pas de différence systématique entre les avis écrits en semaine et ceux publiés le week-end.
Pour tester cela, séparez les avis de l'entreprise B entre jours ouvrés et week-ends, puis comparez leurs notes moyennes.
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
La différence paraît minime, mais est-ce simplement le fruit du hasard ?
Extrayez la différence de moyennes :
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Si vraiment il n'y avait pas de différence entre semaine et week-end, on pourrait permuter aléatoirement l'étiquette is_weekend et la différence des moyennes resterait du même ordre de grandeur. Le package infer offre un moyen simple de réaliser ce type de « Hacker Statistics » :
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Ici, vous spécifiez la relation à tester, l'hypothèse d'indépendance et demandez 10 000 permutations, en calculant la différence de moyenne à chaque fois. Vous pouvez maintenant estimer la fréquence à laquelle une permutation produit par hasard une différence au moins aussi grande :
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
Effectivement, la probabilité que l'effet observé soit dû au hasard est très faible. Cela ne prouve pas une fraude, mais c'est suspect. Par exemple, le même test pour l'entreprise A donne une p-valeur de 0,561 : obtenir un écart aussi grand par hasard est probable, ce qui ne permet pas de rejeter l'hypothèse nulle.
Dans ce tutoriel, vous avez écrit un programme simple pour extraire des données de Trustpilot. Les données sont structurées dans un tableau tidy, ouvrant la voie à de nombreuses analyses.
À titre d'exemple, vous avez scrapé des informations pour deux entreprises d'un même secteur. L'analyse des métadonnées a révélé des motifs suspects pour l'une d'elles. Les tests d'hypothèses ont montré un effet systématique du jour de la semaine sur ses notes — un indice de manipulation, faute d'autre explication crédible. Vous n'avez pas observé cet effet pour l'autre entreprise, ce qui ne garantit pas pour autant l'authenticité de ses avis.
Pour aller plus loin sur le fléau des faux avis, consultez par exemple cet article du Guardian.
Vous voulez en savoir plus sur le web scraping en R ? Consultez notre tutoriel Web scraping et parsing de données en R.
Cours R
Cours
Cours
Cours