Curso
Introducción a Tidyverse
4 h
394.9K
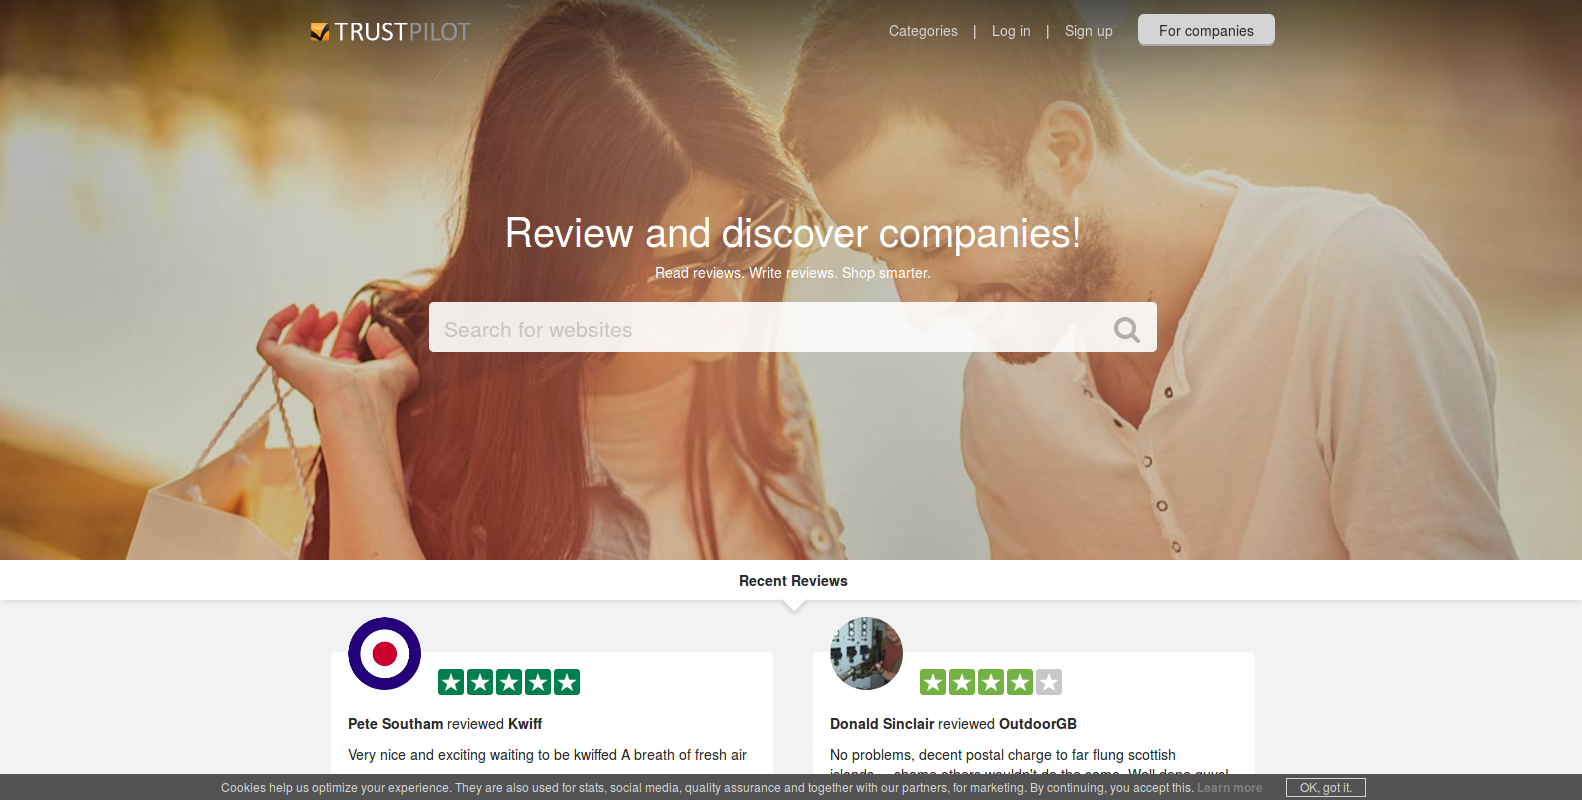
Trustpilot se ha convertido en un sitio popular donde los clientes valoran empresas y servicios. En este breve tutorial, aprenderás a extraer información útil de este sitio y a generar algunos insights básicos con ayuda de R. Verás que Trustpilot quizá no sea tan de fiar como parece.
En concreto, este tutorial cubre lo siguiente:
ggplot2 y dplyr, en combinación con xts, para inspeccionar los datos y formular una hipótesis que después investigarás con el paquete infer, un paquete de inferencia estadística alineado con la filosofía del tidyverse.En Trustpilot, una reseña incluye una breve descripción del servicio, una valoración de 5 estrellas, un nombre de usuario y la fecha de la publicación.
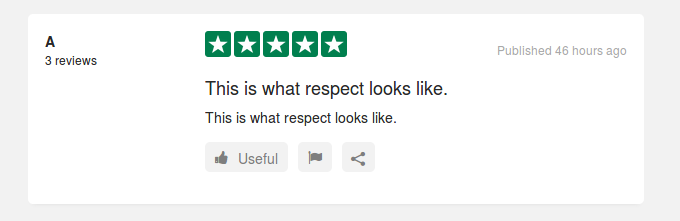
Tu objetivo es escribir una función en R que extraiga esta información para cualquier empresa que elijas.
Primero, necesitas cargar todas las librerías para esta tarea.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) A modo de ejemplo, puedes elegir la empresa de e-commerce Amazon. Es solo con fines demostrativos y no guarda relación con el caso práctico que verás en la segunda parte del tutorial.
La URL de la página principal será el identificador de una empresa, así que la guardarás en una variable.
url <-'http://www.trustpilot.com/review/www.amazon.com'
La mayoría de empresas grandes tienen varias páginas de reseñas. En la landing de Amazon puedes ver el número de páginas; aquí son 155.
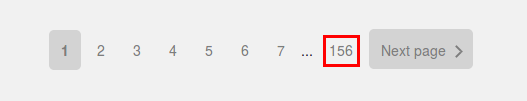
Si haces clic en cualquiera de las subpáginas, verás un patrón para las URLs individuales de una empresa. Cada una es la URL principal con ?page=n añadido, donde n es el número de página de reseñas, aquí entre 1 y 155.
Así debería funcionar tu programa:
Empecemos por encontrar el número máximo de páginas. En general, puedes inspeccionar los elementos visuales de un sitio con las herramientas de desarrollo web del navegador. La idea es que todo el contenido, incluso si se crea dinámicamente, está etiquetado de alguna forma en el código fuente. Esas etiquetas suelen bastar para localizar los datos que quieres extraer.
Como esto es solo una introducción, puedes ir por la vía fácil y mirar directamente el código fuente.
Los datos HTML tienen la siguiente estructura:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Para llegar a los datos, necesitarás algunas funciones del paquete rvest. Para convertir una web en un objeto XML, usa read_html(). Le pasas una URL y la función llama al servidor, recoge los datos y los parsea. Para extraer los nodos relevantes del objeto XML, usa html_nodes(), cuyo argumento es el descriptor de clase, precedido de un . para indicar que es una clase. La salida será una lista de todos los nodos encontrados. Para extraer los datos etiquetados, aplica html_text() a los nodos deseados. Si necesitas extraer atributos, aplica html_attrs(). Esto devolverá una lista de atributos que puedes subconjuntar para obtener el atributo concreto.
Llevémoslo a la práctica. Tras hacer clic derecho en la landing de Amazon, elige inspeccionar el código fuente. Busca el número "155" para encontrar rápido la sección relevante.
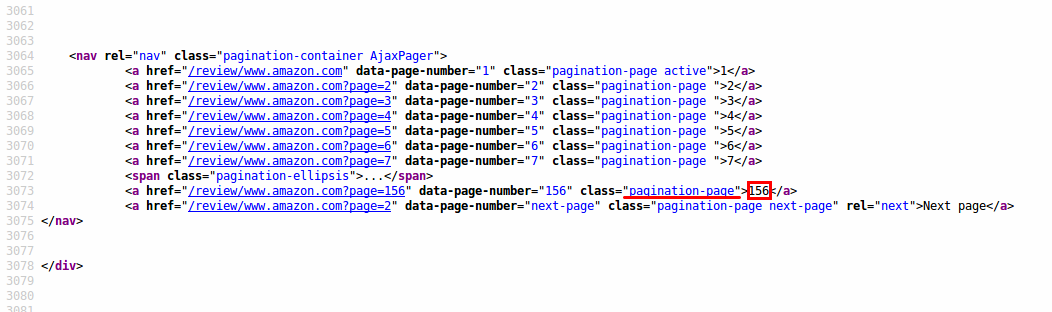
Verás que toda la información de los botones de paginación está etiquetada con la clase 'pagination-page'. Una función que toma el HTML bruto de la landing y extrae el penúltimo elemento de la clase pagination-page sería así:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
El paso específico de esta función es el uso de html_nodes(), que extrae todos los nodos de la clase pagination. La última parte simplemente toma el elemento correcto de la lista (el penúltimo) y lo convierte a numérico.
Para probarla, carga la página inicial con read_html() y aplica la función que acabas de escribir:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Con este número ya puedes generar una lista de todas las URLs relevantes:
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Puedes comprobar manualmente que las entradas de list_of_pages son válidas y se abren en el navegador.
Quieres extraer el texto de la reseña, la valoración, el nombre del autor y la fecha de publicación de todas las reseñas en una subpágina. Puedes repetir los pasos anteriores para cada uno de los campos que buscas.
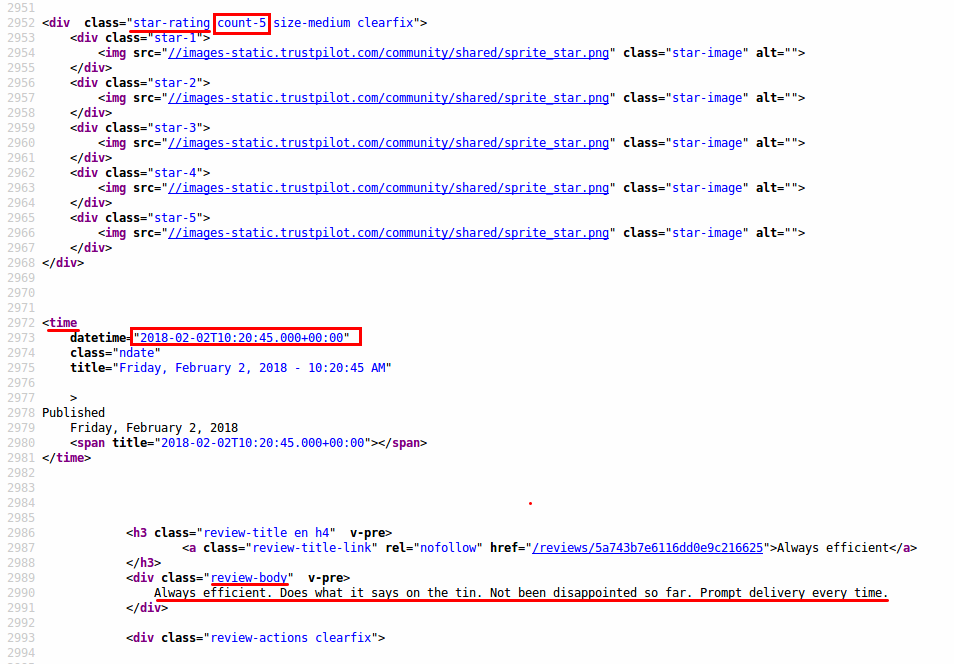
Para cada campo, escribe una función de extracción usando las etiquetas que has observado. En este punto necesitarás algo de prueba y error para afinar exactamente qué datos quieres. A veces verás elementos adicionales con la misma etiqueta y tendrás que reducir la salida manualmente.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
La información de fecha y hora es algo más delicada, ya que se almacena como atributo.
En general, busca la descripción más amplia y después recorta la información redundante. Como la hora aparece no solo en las reseñas, también tienes que extraer la información de status y filtrar por la entrada correcta.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
La última función que necesitas es la que extrae las valoraciones. Usarás expresiones regulares para detectar patrones. La valoración está en un atributo de la etiqueta. En lugar de ser solo un número, forma parte de una cadena count-X, donde X es el número que buscas. Las expresiones regulares pueden ser engorrosas, pero el paquete rebus permite escribirlas de forma legible. Además, su operador %R% facilita descomponer patrones complejos en subpatrones más simples.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Tras comprobar que las funciones de extracción funcionan en una sola URL, combínalas para crear un tibble (básicamente un data frame) para toda la página. Como probablemente aplicarás esta función a más de una empresa, añade un campo con el nombre de la empresa. Te será útil más tarde al comparar compañías.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Encapsula esta función en un comando que extraiga el HTML desde la URL para que sea más cómodo trabajar.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
En el último paso, aplica esta función a la lista de URLs que generaste. Para ello, usa map() del paquete purrr (parte de tidyverse). Aplica la misma función a los elementos de una lista. Ya lo usaste antes para extraer el subelemento n-ésimo de la lista.
Por último, escribe una función práctica que reciba la URL de la landing de una empresa y la etiqueta que quieres darle. Extrae todas las reseñas y las une en un único tibble. Este también es un buen punto para optimizar el código. La función map aplica get_data_from_url() en secuencia, pero no tiene por qué ser así: podrías paralelizar para que varias CPU obtengan reseñas de subconjuntos de páginas y combinarlas al final.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Guardas el resultado en disco como un archivo con tabuladores (TSV) en lugar de CSV, ya que las reseñas suelen contener comas y podrían confundir al parser.
Por ejemplo, puedes aplicar la función a Amazon:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Con la función de web scraping de la sección anterior puedes obtener muchos datos rápidamente. Con ellos, son posibles muchos análisis distintos.
En este caso práctico, solo usarás metadatos de las reseñas: su valoración y la fecha de la reseña.
Primero, carga librerías adicionales.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
Las empresas que te interesan son dos actores destacados del mismo sector. Ambas usan también sus puntuaciones de Trustpilot como argumento comercial en sus webs.
Ya has hecho el scraping de sus datos, ahora solo hay que cargarlos:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Puedes resumir sus cifras generales con group_by() y summarise() de dplyr:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
Las valoraciones medias de ambas parecen comparables. Company B, que lleva un poco más de tiempo en el mercado, también parece tener una media algo menor.
Un buen punto de partida es ver el desempeño mes a mes por valoración en cada empresa. Primero, extrae series temporales de los datos y luego recórtalas a un periodo en el que ambas estuvieran activas y hubiera suficiente volumen de reseñas. Puedes detectarlo visualizando las series: si hay huecos muy grandes durante varios meses, las conclusiones son menos fiables.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Ahora puedes calcular la media mensual con apply.monthly() del paquete xts. Para empezar, calcula las valoraciones medias mensuales de cada empresa. Las series temporales pueden tener más de una observación por índice. Para indicar que el promedio se toma sobre un campo (aquí, rating), hay que pasar colMeans.
No olvides pasar length al argumento FUN para obtener los recuentos mensuales. Piensa que la serie es como un vector: cada reseña incrementa su longitud en uno y length cuenta esas reseñas.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Después, compara valoraciones y recuentos mensuales. Es muy sencillo representando las medias mensuales por empresa y, en otra gráfica, los recuentos de reseñas por empresa, y colocándolas en una cuadrícula:
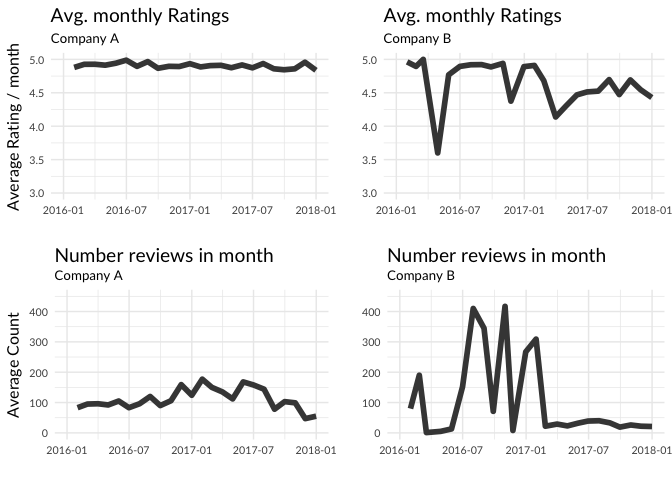
Parece que company A mantiene valoraciones altas de forma más constante. Además, en company B el número mensual de reseñas muestra picos muy marcados, sobre todo tras una racha de valoraciones mediocres.
¿Podría haber juego sucio?
Ahora que has visto que los datos, especialmente los de company B, cambian de forma acusada con el tiempo, una pregunta natural es cómo se distribuye la actividad de reseñas dentro de una semana o de un día.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
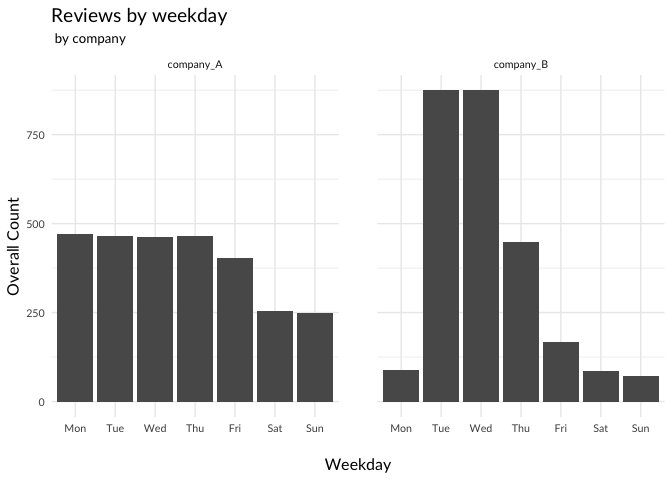
Si representas las reseñas por día de la semana y hora, también aparecen diferencias notables:
Dividir por hora del día también muestra diferencias llamativas entre los dos competidores:
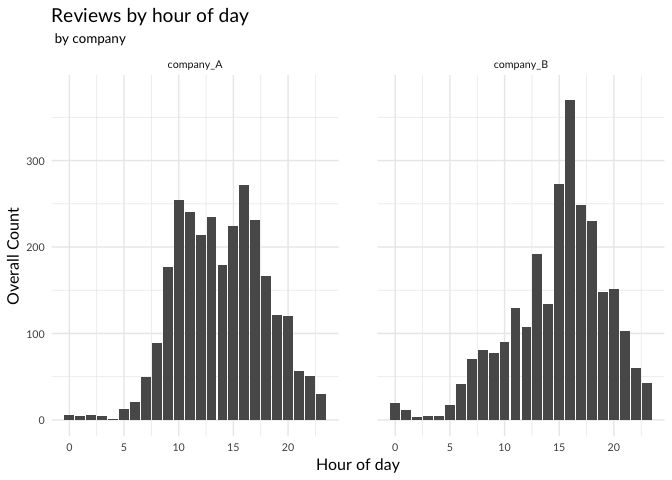
Parece que se escriben más reseñas de día que de noche. Sin embargo, en company B hay un pico muy pronunciado por la tarde.
Estos patrones sugieren que pasa algo raro en company B. Puede que algunas reseñas no las escriban usuarios, sino profesionales. Esperarías que estas reseñas, de media, fueran mejores que las de usuarios corrientes. Como la actividad de reseñas de company B es mucho mayor entre semana, es probable que esos profesionales escriban entonces. Ahora puedes formular una hipótesis nula que intentarás refutar con la evidencia de los datos.
No hay diferencias sistemáticas entre las reseñas escritas en días laborables y las escritas en fin de semana.
Para comprobarlo, divide las reseñas de company B entre las escritas entre semana y las de fin de semana, y compara sus medias:
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Parece una diferencia pequeña, ¿pero es simple azar?
Puedes extraer la diferencia de medias:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Si realmente no hubiera diferencia entre laborables y fines de semana, podrías permutar la etiqueta is_weekend y la diferencia entre medias debería ser del mismo orden de magnitud. Una forma cómoda de hacer estas "estadísticas hacker" te la da el paquete infer:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Aquí defines la relación que quieres probar, la hipótesis de independencia y le dices que genere 10.000 permutaciones calculando la diferencia de medias cada vez. Ahora puedes calcular la frecuencia con la que, por azar, se obtiene una diferencia al menos tan grande:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
Efectivamente, la probabilidad de que el efecto observado sea puro azar es bajísima. Esto no prueba ninguna mala práctica, pero sí es muy sospechoso. Por ejemplo, si haces el mismo experimento para company A obtienes un valor p de 0.561, lo que significa que es muy probable obtener un valor tan extremo como el observado, y desde luego no invalida tu hipótesis nula.
En este tutorial has escrito un programa sencillo que te permite extraer datos de Trustpilot. Los datos quedan estructurados en una tabla ordenada y abren la puerta a muchos análisis adicionales.
Como ejemplo, extrajiste información de dos empresas del mismo sector. Analizaste sus metadatos y encontraste patrones sospechosos en una de ellas. Usaste pruebas de hipótesis para mostrar que hay un efecto sistemático del día de la semana en las valoraciones de una empresa, lo que apunta a que las reseñas podrían estar manipuladas, ya que no hay otra buena explicación para una diferencia así. No pudiste verificar este efecto en la otra empresa, lo que no significa necesariamente que sus reseñas sean honestas.
Puedes encontrar más información sobre reseñas falsas en sitios de opiniones, por ejemplo, en este artículo de The Guardian.
¿Quieres aprender más sobre web scraping en R? Échale un vistazo a nuestro tutorial Web scraping y parsing de datos en R.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Elena Kosourova
12 min
Tutorial
DataCamp Team
4 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Karlijn Willems
15 min



