
Last chance! 50% off DataCamp Premium
Sale ends in
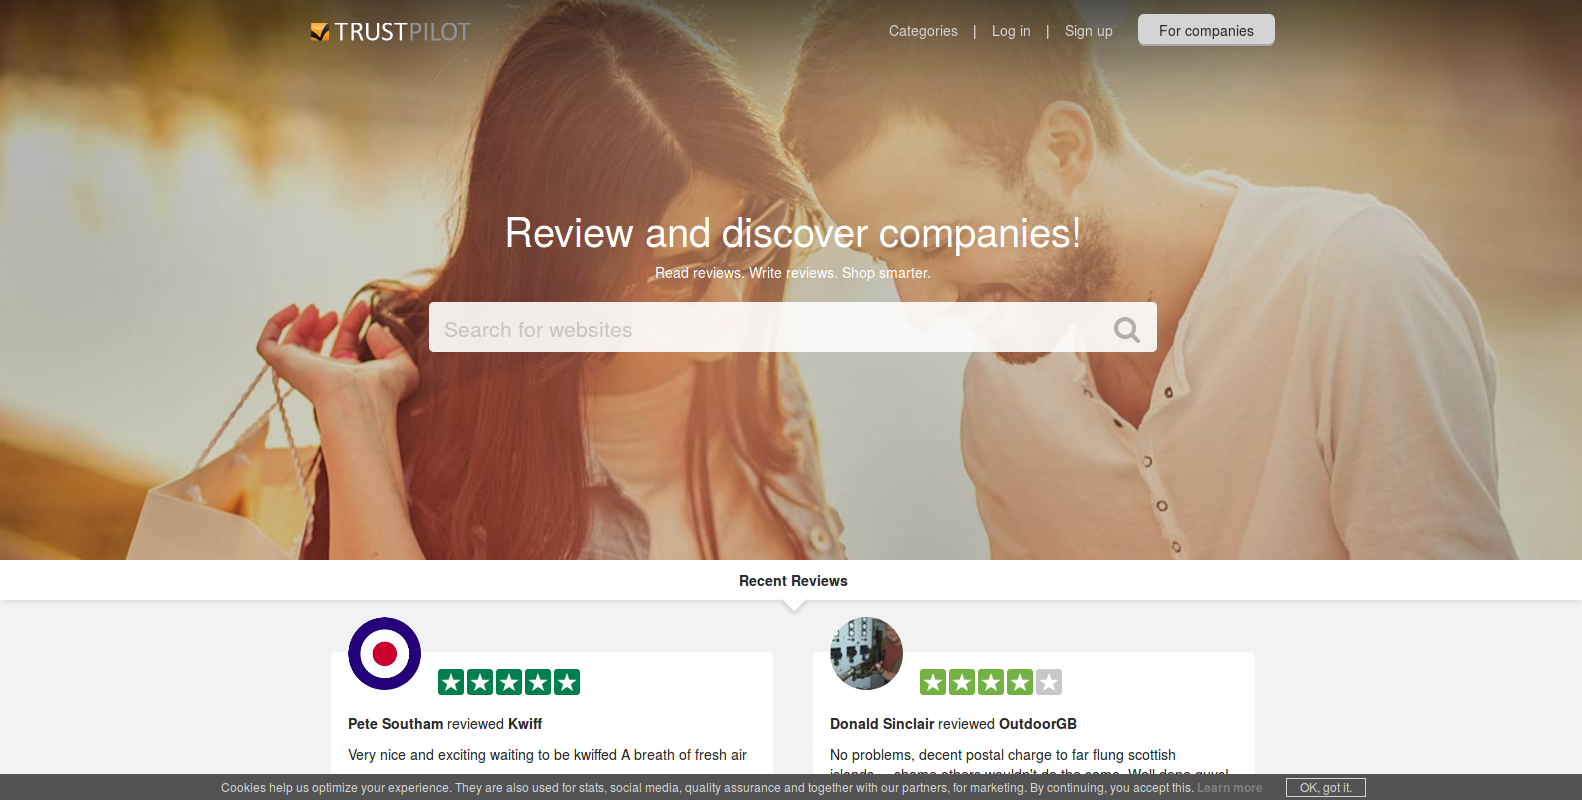
Trustpilot è diventato un sito popolare per i clienti che vogliono recensire aziende e servizi. In questo breve tutorial imparerai a fare scraping di informazioni utili da questo sito e a generare alcuni insight di base con l'aiuto di R. Scoprirai che TrustPilot potrebbe non essere così affidabile come pubblicizzato.
Più nello specifico, questo tutorial coprirà i seguenti punti:
ggplot2 e dplyr, in combinazione con xts, per ispezionare ulteriormente i dati e formulare un’ipotesi, che potrai approfondire con il pacchetto infer, un pacchetto per l’inferenza statistica che segue la filosofia del tidyverse.Su Trustpilot una recensione consiste in una breve descrizione del servizio, una valutazione a 5 stelle, un nome utente e l’ora in cui è stato pubblicato il post.
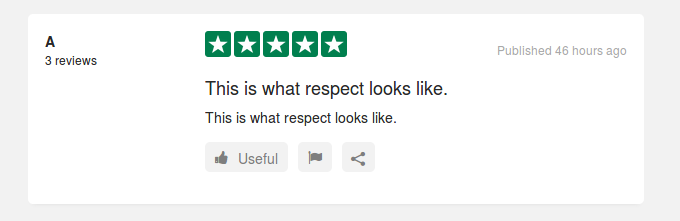
Il tuo obiettivo è scrivere una funzione in R che estragga queste informazioni per qualsiasi azienda tu scelga.
Per prima cosa, dovrai caricare tutte le librerie necessarie per questo compito.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) Come esempio, puoi scegliere l’azienda di e-commerce Amazon. Questo è puramente a scopo dimostrativo e non è in alcun modo correlato allo studio di caso che affronterai nella seconda metà del tutorial.
L’URL della landing page sarà l’identificatore di un’azienda, quindi lo salverai come variabile.
url <-'http://www.trustpilot.com/review/www.amazon.com'
La maggior parte delle grandi aziende ha diverse pagine di recensioni. Sulla landing page di Amazon puoi leggere il numero di pagine, qui è 155.
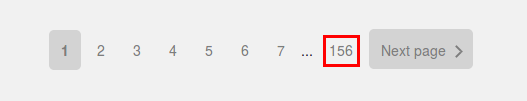
Cliccando su una qualsiasi delle sottopagine si rivela un pattern su come vengono costruiti gli URL individuali di un’azienda. Ognuno di essi è l’URL principale con ?page=n aggiunto, dove n è il numero di una pagina di recensioni, qui un numero tra 1 e 155.
Ecco come dovrebbe operare il tuo programma:
Iniziamo trovando il numero massimo di pagine. In generale, puoi ispezionare gli elementi visivi di un sito usando gli strumenti di sviluppo web nativi del tuo browser. L’idea è che tutti i contenuti di un sito, anche se creati dinamicamente, sono in qualche modo taggati nel codice sorgente. Questi tag sono in genere sufficienti per individuare i dati che stai cercando di estrarre.
Poiché questa è solo un’introduzione, puoi prendere la via panoramica e guardare direttamente tu stesso il codice sorgente.
I dati HTML hanno la seguente struttura:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Per arrivare ai dati, ti serviranno alcune funzioni del pacchetto rvest. Per convertire un sito in un oggetto XML, usa la funzione read_html(). Devi fornire un URL di destinazione e la funzione contatta il server web, raccoglie i dati e li analizza. Per estrarre i nodi rilevanti dall’oggetto XML usi html_nodes(), il cui argomento è il descrittore di classe, preceduto da un . per indicare che è una classe. L’output sarà un elenco di tutti i nodi trovati in quel modo. Per estrarre i dati taggati, devi applicare html_text() ai nodi che vuoi. Nei casi in cui devi invece estrarre gli attributi, applichi html_attrs(). Questo restituirà un elenco degli attributi, che puoi sottoselezionare per ottenere l’attributo che vuoi estrarre.
Applichiamo questo in pratica. Dopo un clic destro sulla landing page di Amazon puoi scegliere di ispezionare il codice sorgente. Puoi cercare il numero "155" per trovare rapidamente la sezione rilevante.
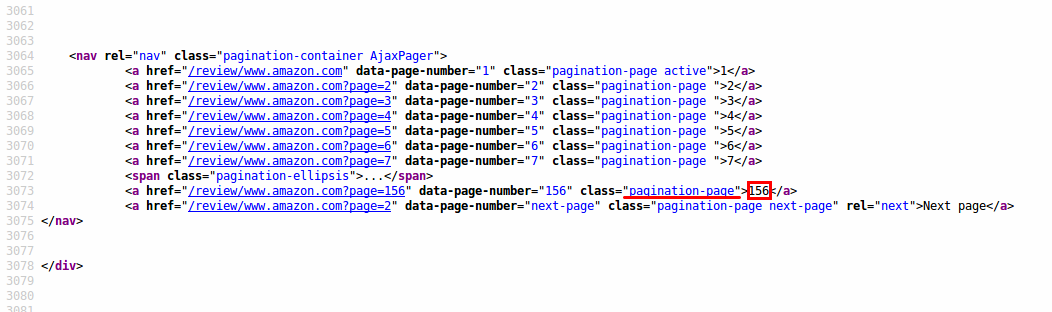
Puoi vedere che tutte le informazioni dei pulsanti di pagina sono taggate con la classe 'pagination-page'. Una funzione che prende l’HTML grezzo della landing page ed estrae il penultimo elemento della classe pagination-page è la seguente:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
Il passaggio specifico per questa funzione è l’applicazione della funzione html_nodes() che estrae tutti i nodi della classe pagination. L’ultima parte della funzione prende semplicemente l’elemento corretto della lista, il penultimo, e lo converte in un valore numerico.
Per testare la funzione, puoi caricare la pagina iniziale usando la funzione read_html() e applicare la funzione che hai appena scritto:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Ora che hai questo numero, puoi generare un elenco di tutti gli URL rilevanti
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Puoi verificare manualmente che le voci di list_of_pages siano effettivamente valide e richiamabili tramite un browser web.
Vuoi estrarre il testo della recensione, la valutazione, il nome dell’autore e l’ora di invio di tutte le recensioni su una sottopagina. Puoi ripetere i passaggi visti prima per ciascun campo che stai cercando.
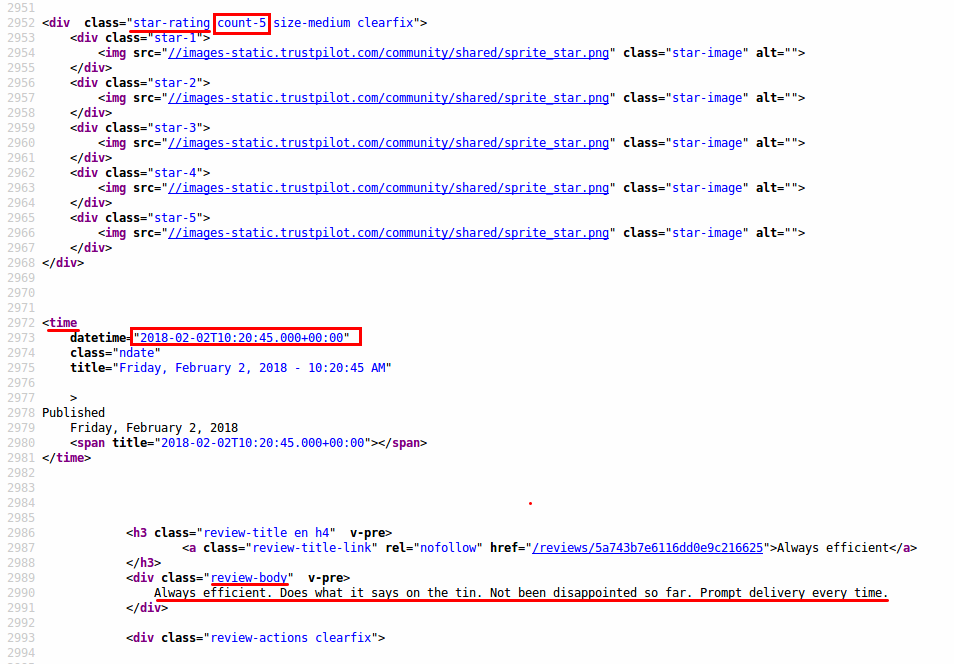
Per ognuno dei campi dati scrivi una funzione di estrazione usando i tag che hai osservato. A questo punto serve un po’ di tentativi per ottenere esattamente i dati che vuoi. A volte scoprirai che sono taggati anche elementi aggiuntivi, quindi dovrai ridurre manualmente l’output.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
Le informazioni di data e ora sono un po’ più insidiose, perché sono memorizzate come attributo.
In generale, cerchi la descrizione più ampia e poi provi a ritagliare tutte le informazioni ridondanti. Poiché le informazioni temporali non compaiono solo nelle recensioni, devi anche estrarre le informazioni di status rilevanti e filtrare per la voce corretta.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
L’ultima funzione di cui hai bisogno è l’estrattore delle valutazioni. Userai espressioni regolari per il pattern matching. La valutazione è inserita come attributo del tag. Anziché essere solo un numero, è parte di una stringa count-X, dove X è il numero che ti serve. Le espressioni regolari possono essere un po’ ostiche, ma il pacchetto rebus permette di scriverle in una forma leggibile. Inoltre, la funzionalità di piping di rebus, tramite l’operatore %R%, consente di scomporre pattern complessi in sotto-pattern più semplici per strutturare espressioni regolari più articolate.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Dopo aver testato che le singole funzioni di estrazione funzionano su un URL, le combini per creare una tibble, che è essenzialmente un data frame, per l’intera pagina. Poiché è probabile che applicherai questa funzione a più di un’azienda, aggiungerai un campo con il nome dell’azienda. Questo può essere utile in analisi successive quando vuoi confrontare aziende diverse.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Incorpori questa funzione in un comando che estrae l’HTML dall’URL in modo da rendere la gestione più comoda.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
Nell’ultimo passaggio, applichi questa funzione all’elenco di URL che hai generato in precedenza. Per farlo, usi la funzione map() del pacchetto purrr, che fa parte del tidyverse. Applica la stessa funzione agli elementi di una lista. L’hai già usata prima, però passando un numero n, che è una scorciatoia per estrarre il sottoelemento n-esimo della lista.
Infine, scrivi una funzione pratica che prende in input l’URL della landing page di un’azienda e l’etichetta che vuoi dare all’azienda. Estrae tutte le recensioni, unendole in un’unica tibble. Questo è anche un buon punto di partenza per ottimizzare il codice. La funzione map applica in sequenza la funzione get_data_from_url(), ma non è obbligatorio. Si potrebbe applicare il parallelismo, in modo che più CPU recuperino le recensioni per un sottoinsieme delle pagine e vengano combinate solo alla fine.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Salvi il risultato su disco usando un file separato da tabulazioni, invece dei comuni file separati da virgole (CSV), perché le recensioni spesso contengono virgole, che potrebbero confondere il parser.
Come esempio puoi applicare la funzione ad Amazon:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Con la funzione di web scraping della sezione precedente, puoi ottenere rapidamente molti dati. Con questi dati sono possibili molte analisi diverse.
In questo caso di studio userai solo i metadati delle recensioni, ovvero la loro valutazione e il momento della recensione.
Per prima cosa, carichi librerie aggiuntive.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
Le aziende che ti interessano sono entrambe protagoniste nello stesso settore. Entrambe usano anche i loro punteggi TrustPilot come argomento di vendita sul loro sito.
Hai fatto lo scraping dei loro dati e devi solo caricarli:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Puoi riassumere i loro numeri complessivi con l’aiuto delle funzioni group_by() e summarise() del pacchetto dplyr:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
Le valutazioni medie delle due aziende sembrano comparabili. L’azienda B, che è in attività da un po’ più tempo, sembra anche avere una valutazione leggermente più bassa.
Un buon punto di partenza per ulteriori analisi è osservare l’andamento mese per mese delle valutazioni per ciascuna azienda. Prima estrai serie temporali dai dati e poi le sottoinsiemi a un punto in cui entrambe le aziende erano operative e si generava sufficiente attività di recensione. Questo può essere individuato visualizzando le serie temporali. Se ci sono lacune molto ampie nei dati per diversi mesi di seguito, allora le conclusioni tratte dai dati sono meno affidabili.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Ora puoi applicare la media mensile con la funzione apply.monthly() del pacchetto xts. Per iniziare, raccogli le valutazioni medie mensili per ciascuna azienda. Le serie temporali possono avere più di un’osservazione per lo stesso indice. Per specificare che la media viene calcolata rispetto a un campo, qui rating, dobbiamo passare colMeans.
Poi, non dimenticare di passare length all’argomento FUN per recuperare i conteggi mensili. Questo perché la serie temporale può essere vista come un vettore. Ogni recensione aumenta la lunghezza di quel vettore di uno e la funzione length conta essenzialmente le recensioni.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Successivamente, puoi confrontare le valutazioni e i conteggi mensili. È molto semplice: tracci le valutazioni medie mensili per ciascuna azienda e i conteggi di quelle valutazioni per ciascuna azienda in grafici separati e poi li disponi in una griglia:
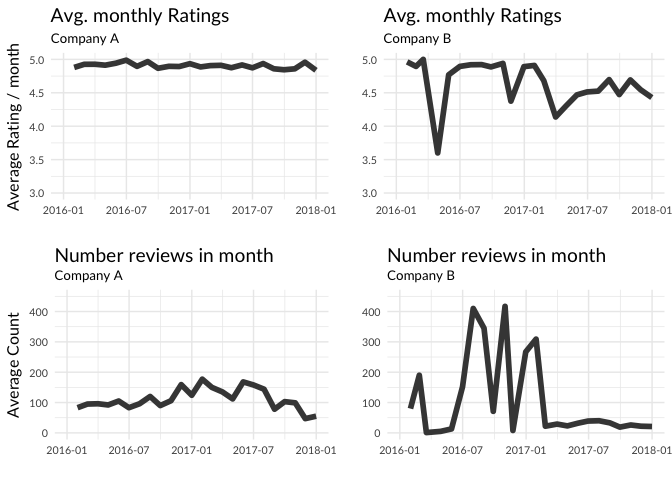
Sembra che l’azienda A abbia valutazioni costantemente più alte. Ma non solo, per l’azienda B il numero mensile di recensioni mostra picchi molto marcati, soprattutto dopo una serie di recensioni mediocri.
Potrebbe esserci del gioco sporco?
Ora che hai visto che i dati, soprattutto per l’azienda B, cambiano in modo piuttosto drastico nel tempo, è naturale chiedersi come sia distribuita l’attività di recensione all’interno di una settimana o nell’arco della giornata.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
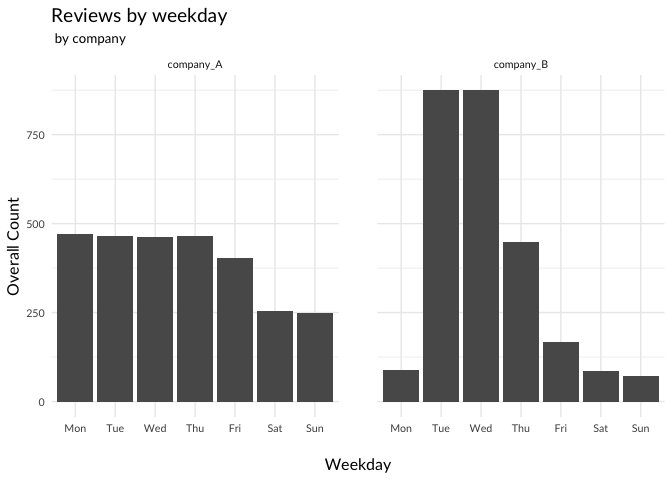
Se tracci le recensioni per giorno della settimana e ora della giornata, ottieni anche differenze notevoli:
Una suddivisione per ora della giornata delle recensioni mostra anche differenze sorprendenti tra i due concorrenti:
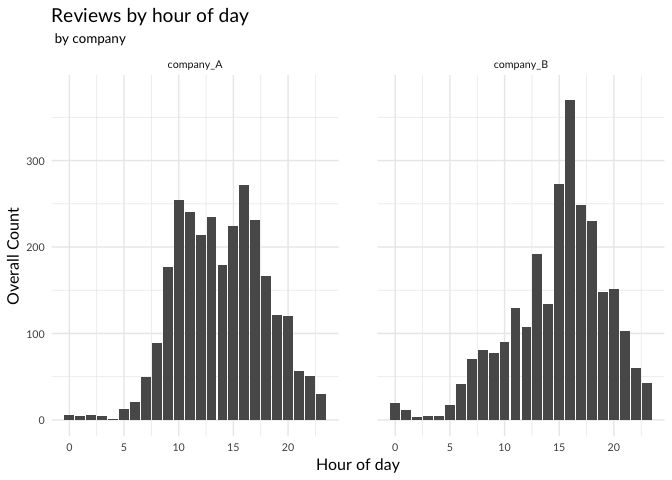
Sembra che vengano scritte più recensioni durante il giorno che di notte. L’azienda B però mostra un picco marcato nelle recensioni scritte nel pomeriggio.
Questi pattern sembrano indicare che all’azienda B stia succedendo qualcosa di poco chiaro. Forse alcune recensioni non sono scritte dagli utenti, ma da professionisti. Ti aspetteresti che queste recensioni siano, in media, migliori di quelle scritte dalle persone comuni. Dato che l’attività di recensione per l’azienda B è molto più alta durante i giorni feriali, sembra probabile che i professionisti scrivano le loro recensioni in uno di quei giorni. Ora puoi formulare un’ipotesi nulla che puoi cercare di confutare usando le evidenze dei dati.
Non c’è alcuna differenza sistematica tra le recensioni scritte in un giorno lavorativo e quelle scritte nel fine settimana.
Per testarla, dividi le recensioni dell’azienda B in quelle scritte nei giorni feriali e quelle scritte nei weekend, e controlli le loro valutazioni medie
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Sembra certamente una differenza abbastanza piccola, ma è puro caso?
Puoi estrarre la differenza tra le medie:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Se davvero non ci fosse differenza tra giorni lavorativi e weekend, potresti semplicemente permutare l’etichetta is_weekend e la differenza tra le medie dovrebbe essere dello stesso ordine di grandezza. Un modo comodo per fare questo tipo di "Hacker Statistics" è fornito dal pacchetto infer:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Qui hai specificato la relazione che vuoi testare, la tua ipotesi di indipendenza e dici alla funzione di generare 10000 permutazioni, calcolando la differenza nella valutazione media per ciascuna. Ora puoi calcolare la frequenza con cui la permutazione produce, per caso, una tale differenza nelle valutazioni medie:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
In effetti, la probabilità che l’effetto osservato sia puro caso è estremamente bassa. Questo non prova alcuna scorrettezza, tuttavia è molto sospetto. Per esempio, facendo lo stesso esperimento per l’azienda A si ottiene un valore p di 0,561, il che significa che è molto probabile ottenere un valore estremo quanto quello osservato, cosa che certamente non invalida la tua ipotesi nulla.
In questo tutorial, hai scritto un semplice programma che ti permette di fare scraping di dati dal sito TrustPilot. I dati sono strutturati in una tabella in formato tidy e offrono l’opportunità per un gran numero di ulteriori analisi.
Come esempio, hai fatto lo scraping di informazioni per due aziende che operano nello stesso settore. Hai analizzato i loro metadati e trovato pattern sospetti per una di esse. Hai usato i test d’ipotesi per mostrare che c’è un effetto sistematico del giorno della settimana sulle valutazioni di un’azienda. Questo è un indicatore che le recensioni potrebbero essere state manipolate, poiché non c’è un’altra buona spiegazione del perché ci dovrebbe essere una tale differenza. Non hai potuto verificare questo effetto per l’altra azienda, il che però non significa che le sue recensioni siano necessariamente oneste.
Ulteriori informazioni sul problema delle recensioni false che affligge i siti di recensioni si possono trovare, per esempio, sul Guardian.
Vuoi saperne di più sul Web scraping in R? Dai un’occhiata al nostro tutorial Web Scraping and Parsing Data in R.
Corsi R
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



