Kurs
Einführung in das Tidyverse
4 Std.
394.9K
Trustpilot hat sich zu einer beliebten Plattform entwickelt, auf der Kundinnen und Kunden Unternehmen und Services bewerten. In diesem kurzen Tutorial lernst du, wie du mit R nützliche Informationen von dieser Website scrapen und daraus erste Erkenntnisse gewinnen kannst. Du wirst sehen, dass TrustPilot vielleicht nicht ganz so vertrauenswürdig ist, wie es den Anschein hat.
Konkret deckt dieses Tutorial Folgendes ab:
ggplot2 und dplyr in Kombination mit xts, um die Daten weiter zu untersuchen und eine Hypothese zu formulieren, die du anschließend mit dem infer-Paket überprüfst – einem Paket für statistische Inferenz im Geist des tidyverse.Auf Trustpilot besteht eine Bewertung aus einer kurzen Beschreibung des Services, einer 5-Sterne-Wertung, einem Nutzernamen und dem Zeitpunkt der Veröffentlichung.
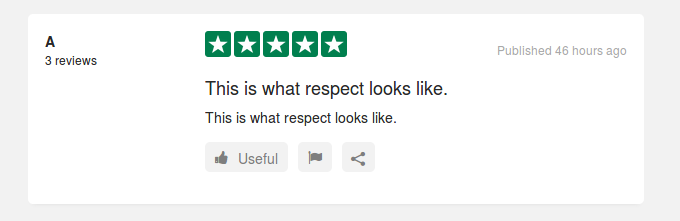
Dein Ziel ist es, eine Funktion in R zu schreiben, die diese Informationen für jedes gewünschte Unternehmen extrahiert.
Als erstes lädst du alle Bibliotheken, die du für diese Aufgabe brauchst.
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) Als Beispiel kannst du das E-Commerce-Unternehmen Amazon wählen. Das dient nur zu Demonstrationszwecken und steht in keinem Zusammenhang mit der Fallstudie im zweiten Teil des Tutorials.
Die URL der Übersichtsseite dient als Identifikator für ein Unternehmen, daher speicherst du sie in einer Variablen.
url <-'http://www.trustpilot.com/review/www.amazon.com'
Die meisten großen Unternehmen haben mehrere Bewertungsseiten. Auf der Amazon-Übersichtsseite kannst du die Seitenanzahl ablesen, hier sind es 155.
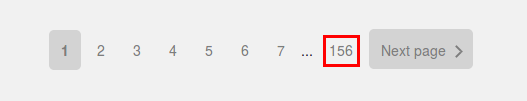
Der Klick auf eine der Unterseiten offenbart ein Muster, wie die einzelnen URLs eines Unternehmens adressiert werden: Es ist jeweils die Haupt-URL mit angehängtem ?page=n, wobei n die Seitennummer ist, hier also eine Zahl zwischen 1 und 155.
So sollte dein Programm vorgehen:
Starten wir damit, die maximale Seitenzahl zu finden. Grundsätzlich kannst du die visuellen Elemente einer Website mit den Entwicklertools deines Browsers inspizieren. Die Idee dahinter: Sämtliche Inhalte einer Website, selbst wenn sie dynamisch erzeugt werden, sind im Quelltext irgendwie ausgezeichnet. Diese Tags reichen in der Regel aus, um die gewünschten Daten gezielt anzusteuern.
Da dies nur eine Einführung ist, nimmst du die Abkürzung und schaust dir den Quelltext direkt an.
HTML-Daten haben folgende Struktur:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
Um an die Daten zu kommen, brauchst du einige Funktionen aus dem Paket rvest. Mit read_html() wandelst du eine Website in ein XML-Objekt um. Du übergibst eine Ziel-URL, die Funktion ruft den Webserver auf, sammelt die Daten und parst sie. Um die relevanten Knoten aus dem XML-Objekt zu extrahieren, nutzt du html_nodes() mit dem Klassen-Selektor als Argument, dem ein . vorangestellt wird, um eine Klasse zu kennzeichnen. Das Ergebnis ist eine Liste aller so gefundenen Knoten. Um die getaggten Daten zu extrahieren, wendest du html_text() auf die gewünschten Knoten an. Wenn du stattdessen Attribute auslesen willst, verwendest du html_attrs(). Das liefert eine Attributliste zurück, die du subsetzen kannst, um an das gewünschte Attribut zu gelangen.
Setzen wir das praktisch um. Nach einem Rechtsklick auf Amazons Übersichtsseite kannst du den Quelltext inspizieren. Suche nach der Zahl „155“, um die relevante Stelle schnell zu finden.
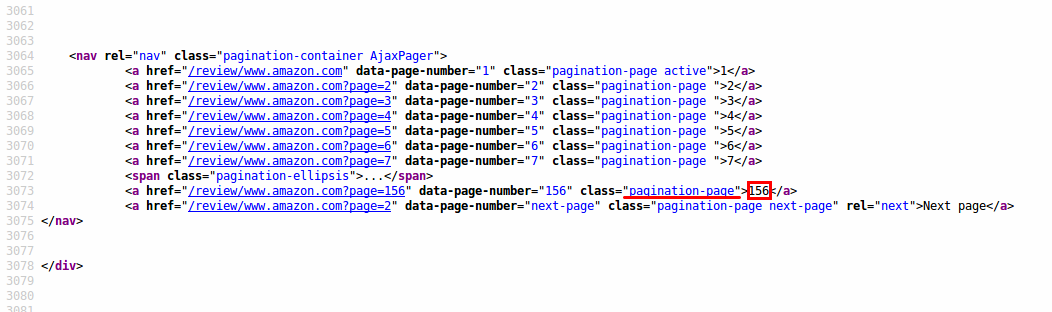
Du siehst, dass alle Seiten-Buttons als Klasse 'pagination-page' ausgezeichnet sind. Eine Funktion, die das rohe HTML der Übersichtsseite nimmt und das vorletzte Element der Klasse pagination-page extrahiert, sieht so aus:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
Der funktionsspezifische Schritt ist hier der Einsatz von html_nodes(), um alle Knoten der Klasse pagination zu extrahieren. Der letzte Teil der Funktion nimmt einfach das korrekte Listenelement, das vorletzte, und wandelt es in eine Zahl um.
Zum Testen lädst du die Startseite mit read_html() und wendest die gerade geschriebene Funktion an:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
Mit dieser Zahl kannst du nun eine Liste aller relevanten URLs erzeugen.
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
Du kannst manuell prüfen, ob die Einträge in list_of_pages gültig sind und sich im Browser aufrufen lassen.
Du möchtest Bewertungstext, Sternebewertung, Namen der Autorin bzw. des Autors und den Abgabezeitpunkt aller Bewertungen auf einer Unterseite extrahieren. Die Schritte von oben kannst du für jedes der gesuchten Felder wiederholen.
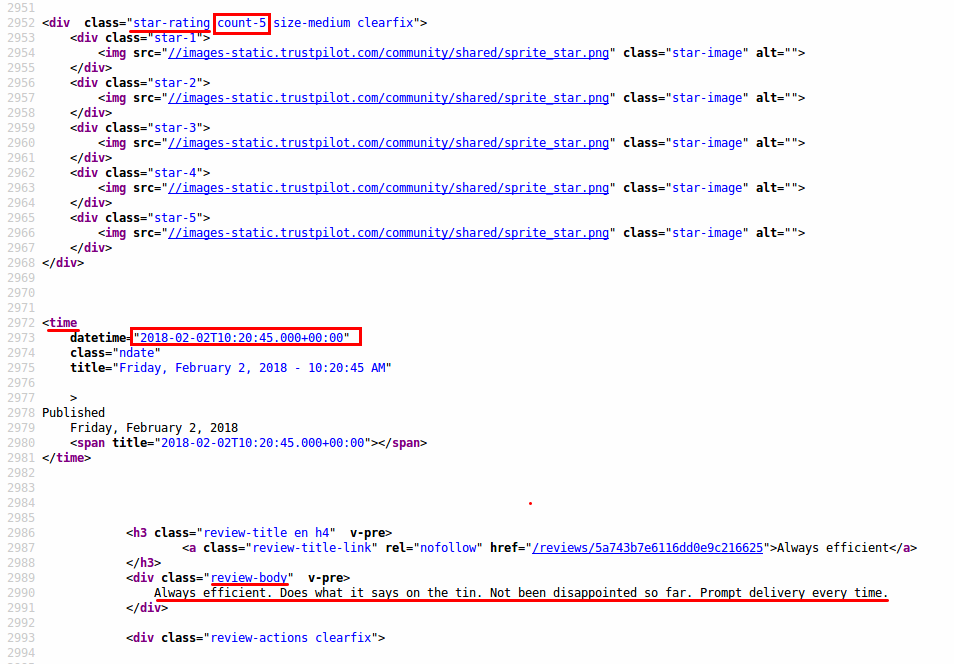
Für jedes Datenfeld schreibst du eine Extraktionsfunktion anhand der beobachteten Tags. Ein wenig Trial-and-Error ist nötig, um genau die gewünschten Daten zu treffen. Manchmal sind zusätzliche Elemente getaggt, dann musst du die Ausgabe manuell reduzieren.
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
Die Datums-/Zeitangabe ist etwas kniffliger, da sie als Attribut gespeichert ist.
Allgemein suchst du zunächst die breiteste Beschreibung und schneidest dann überflüssige Informationen weg. Da Zeitinformationen nicht nur in den Bewertungen vorkommen, musst du auch die relevante status-Information extrahieren und nach dem korrekten Eintrag filtern.
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
Die letzte benötigte Funktion extrahiert die Sternebewertung. Dafür verwendest du reguläre Ausdrücke zum Pattern Matching. Die Bewertung steckt als Attribut im Tag. Statt nur einer Zahl ist sie Teil eines Strings count-X, wobei X die gesuchte Zahl ist. Reguläre Ausdrücke können sperrig sein, aber das Paket rebus erlaubt eine lesbare Schreibweise. Außerdem kannst du mit dem %R%-Operator komplexe Muster in einfacher Teilmuster zerlegen.
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
Nachdem du getestet hast, dass die einzelnen Extraktionsfunktionen für eine einzelne URL funktionieren, kombinierst du sie zu einer Tibble, im Kern also einem Data Frame, für die ganze Seite. Da du die Funktion wahrscheinlich für mehr als ein Unternehmen verwenden wirst, fügst du ein Feld mit dem Firmennamen hinzu. Das hilft später beim Vergleich.
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
Diese Funktion kapselst du in einen Befehl, der das HTML aus der URL extrahiert – so wird die Handhabung bequemer.
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
Im letzten Schritt wendest du die Funktion auf die zuvor erzeugte URL-Liste an. Dafür nutzt du map() aus dem purrr-Paket, das Teil des tidyverse ist. Es wendet dieselbe Funktion auf alle Listenelemente an. Du hast die Funktion oben schon verwendet, dort jedoch mit einer Zahl n als Kurzschreibweise für das Extrahieren des n-ten Unterelements.
Zum Schluss schreibst du eine bequeme Funktion, die die URL der Übersichtsseite eines Unternehmens und ein Label für das Unternehmen entgegennimmt. Sie extrahiert alle Bewertungen und bindet sie zu einer Tibble zusammen. Das ist auch ein guter Startpunkt für Optimierung: map ruft get_data_from_url() sequenziell auf, das muss aber nicht so sein. Du könntest parallelisieren, sodass mehrere CPUs jeweils einen Teil der Seiten verarbeiten und erst am Ende zusammenführen.
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
Du speicherst das Ergebnis als Tab-getrennte Datei auf die Platte statt als gängige CSV, da Bewertungen häufig Kommata enthalten, die den Parser verwirren können.
Als Beispiel kannst du die Funktion auf Amazon anwenden:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
Mit der Web-Scraping-Funktion aus dem vorigen Abschnitt gelangst du schnell an viele Daten. Damit sind zahlreiche Analysen möglich.
In dieser Fallstudie verwendest du nur Metadaten der Bewertungen, nämlich deren Sternebewertung und den Zeitpunkt der Bewertung.
Zuerst lädst du zusätzliche Bibliotheken.
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
Die Unternehmen, die dich interessieren, sind beide prominente Akteure derselben Branche. Beide nutzen zudem ihre TrustPilot-Scores als Verkaufsargument auf ihren Websites.
Du hast ihre Daten bereits gescrapet und musst sie nur noch laden:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
Mit group_by() und summarise() aus dplyr kannst du die Gesamtdaten schnell zusammenfassen:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
Die durchschnittlichen Bewertungen der beiden Unternehmen wirken vergleichbar. Company B, die etwas länger am Markt ist, scheint zudem eine leicht niedrigere Bewertung zu haben.
Ein guter Einstieg ist, die monatliche Entwicklung der Bewertungen je Unternehmen anzuschauen. Dafür extrahierst du zunächst Zeitreihen aus den Daten und schneidest sie auf einen Zeitraum zu, in dem beide Unternehmen aktiv waren und genügend Bewertungen vorliegen. Das findest du, indem du die Zeitreihen visualisierst. Wenn es über mehrere Monate große Lücken gibt, sind Schlüsse aus den Daten weniger belastbar.
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
Nun kannst du mit apply.monthly() aus xts monatliche Durchschnitte berechnen. Starte mit den durchschnittlichen Monatsbewertungen je Unternehmen. Zeitreihen können mehrere Beobachtungen für denselben Index haben. Um anzugeben, dass der Mittelwert spaltenweise über das Feld rating gebildet wird, übergeben wir colMeans.
Vergiss außerdem nicht, length an das Argument FUN zu übergeben, um die monatlichen Anzahlen zu erhalten. Eine Zeitreihe lässt sich als Vektor sehen: Jede Bewertung erhöht dessen Länge um eins, und length zählt entsprechend die Bewertungen.
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
Als Nächstes kannst du die monatlichen Bewertungen und Anzahlen vergleichen. Am einfachsten, indem du die monatlichen Durchschnittsbewertungen und die jeweiligen Counts je Unternehmen getrennt plottest und anschließend in einem Raster anordnest:
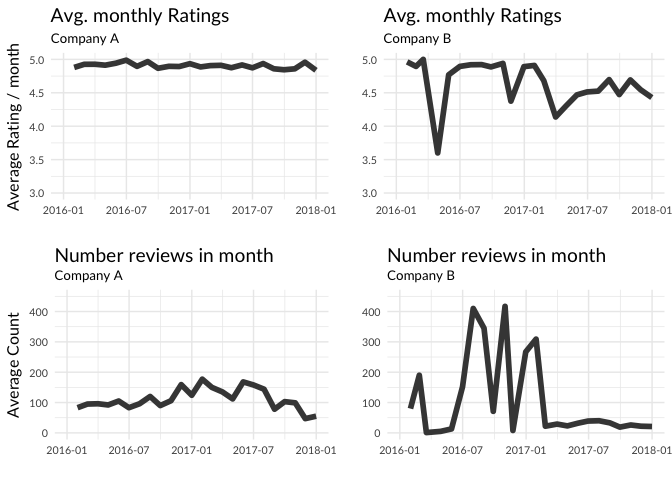
Es scheint, als habe Company A deutlich konstanter hohe Bewertungen. Bei Company B zeigen die monatlichen Anzahlen hingegen deutliche Spitzen – besonders nach Phasen mittelmäßiger Bewertungen.
Könnte da etwas nicht mit rechten Dingen zugehen?
Nachdem du gesehen hast, dass sich die Daten – vor allem bei Company B – im Zeitverlauf stark verändern, liegt die Frage nahe, wie sich die Bewertungsaktivität innerhalb einer Woche bzw. eines Tages verteilt.
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
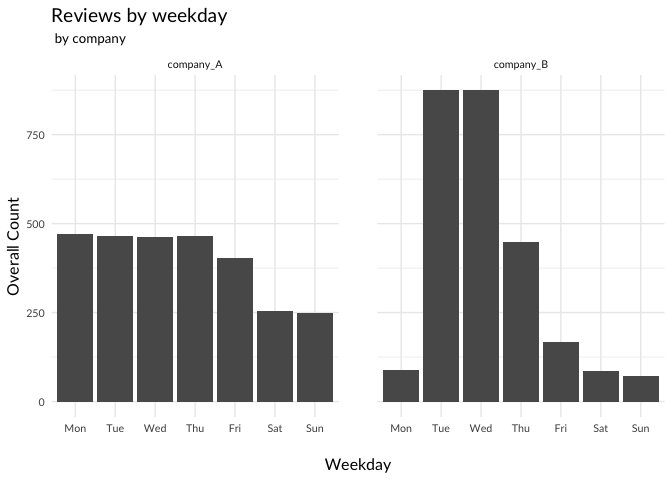
Wenn du die Bewertungen nach Wochentag und Stunde darstellst, zeigen sich ebenfalls bemerkenswerte Unterschiede:
Auch die Aufteilung nach Tageszeit zeigt deutliche Unterschiede zwischen den beiden Wettbewerbern:
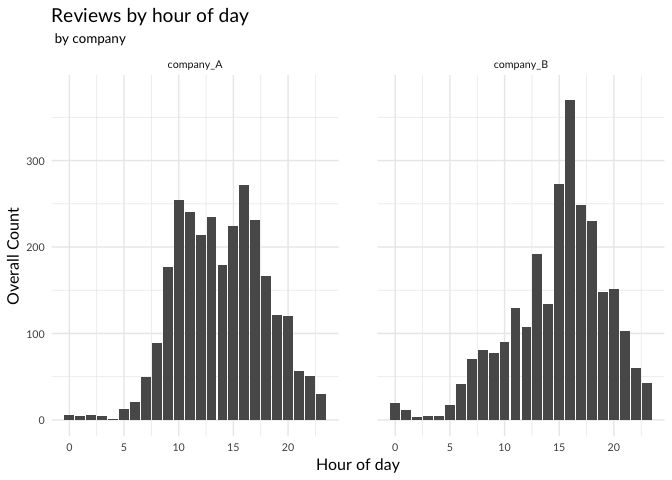
Es wirkt, als würden mehr Bewertungen tagsüber als nachts geschrieben. Bei Company B zeigt sich jedoch ein ausgeprägter Peak am Nachmittag.
Diese Muster deuten darauf hin, dass bei Company B etwas im Argen ist. Möglicherweise stammen manche Bewertungen nicht von Nutzerinnen und Nutzern, sondern von Profis. Du würdest erwarten, dass diese im Schnitt besser ausfallen als Bewertungen normaler Personen. Da die Aktivität bei Company B unter der Woche deutlich höher ist, liegt es nahe, dass Profis ihre Bewertungen an Werktagen schreiben. Formuliere nun eine Nullhypothese, die du anhand der Daten zu widerlegen versuchst.
Es gibt keinen systematischen Unterschied zwischen Bewertungen, die an Werktagen geschrieben werden, und solchen vom Wochenende.
Dazu teilst du die Bewertungen von Company B in Werktage und Wochenende auf und prüfst deren Durchschnittsbewertungen.
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
Das sieht nach einem kleinen Unterschied aus – aber ist er zufällig?
Du kannst die Differenz der Mittelwerte extrahieren:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
Wenn es wirklich keinen Unterschied zwischen Werktagen und Wochenenden gäbe, könntest du das Label is_weekend einfach permutieren, und die Differenz der Mittelwerte sollte in derselben Größenordnung liegen. Eine bequeme Umsetzung dieser „Hacker-Statistik“ bietet das Paket infer:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
Hier spezifizierst du die zu testende Beziehung, die Unabhängigkeitshypothese, und lässt 10.000 Permutationen erzeugen, wobei jeweils die Differenz der mittleren Bewertungen berechnet wird. Nun kannst du die Häufigkeit berechnen, mit der die Permutation zufällig eine so große Differenz erzeugt:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
Die Wahrscheinlichkeit, dass der beobachtete Effekt reiner Zufall ist, ist tatsächlich verschwindend gering. Das beweist kein Fehlverhalten, ist aber sehr verdächtig. Führst du denselben Test für Company A durch, erhältst du zum Beispiel einen p-Wert von 0.561. Das bedeutet, ein so extremer Wert ist ziemlich wahrscheinlich – die Nullhypothese bleibt also bestehen.
In diesem Tutorial hast du ein einfaches Programm geschrieben, mit dem du Daten von TrustPilot scrapen kannst. Die Daten liegen als tidy Datentabelle vor und eröffnen viele weitere Analysemöglichkeiten.
Als Beispiel hast du Informationen für zwei Unternehmen derselben Branche gescrapet. Du hast ihre Metadaten analysiert und bei einem davon verdächtige Muster gefunden. Mit einem Hypothesentest hast du gezeigt, dass der Wochentag systematisch die Bewertungen eines Unternehmens beeinflusst. Das ist ein Hinweis auf manipulierte Bewertungen, denn es gibt keine gute alternative Erklärung für einen derartigen Unterschied. Für das andere Unternehmen konntest du diesen Effekt nicht nachweisen – was nicht automatisch bedeutet, dass dort alle Bewertungen ehrlich sind.
Mehr zum Thema gefälschte Bewertungen auf Review-Plattformen findest du zum Beispiel im Guardian.
Du willst mehr über Web Scraping in R lernen? Schau dir unser Web Scraping and Parsing Data in R-Tutorial an.
R-Kurse
Kurs
Kurs
Kurs