{count, plural, one {कोर्स} other {कोर्स}}
Tidyverse परिचय
{hours} घंटा
398K
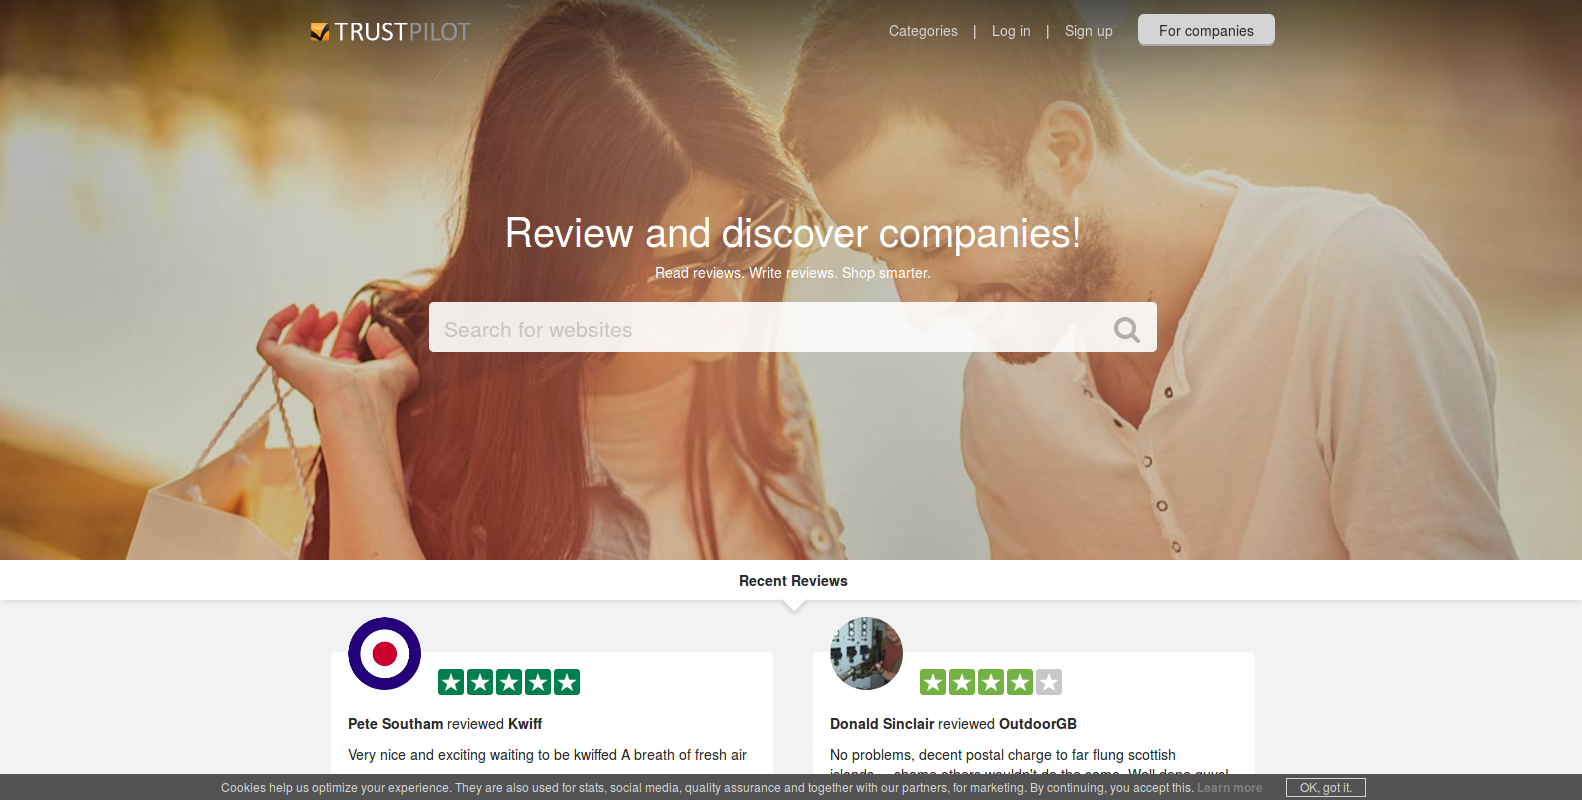
Trustpilot व्यवसायों और सेवाओं की ग्राहक समीक्षाओं के लिए एक लोकप्रिय वेबसाइट बन गई है। इस छोटे से ट्यूटोरियल में, आप सीखेंगे कि R की मदद से इस वेबसाइट से उपयोगी जानकारी कैसे स्क्रैप करें और उससे कुछ बुनियादी इनसाइट्स कैसे निकालें। आप पाएंगे कि TrustPilot उतना भरोसेमंद नहीं भी हो सकता जितना दावा किया जाता है।
विशेष रूप से, यह ट्यूटोरियल निम्नलिखित को कवर करेगा:
ggplot2 और dplyr का, xts के साथ मिलाकर, डेटा की आगे जाँच करने और एक परिकल्पना बनाने में कैसे उपयोग किया जा सकता है, जिसे आप tidyverse दर्शन का पालन करने वाले सांख्यिकीय अनुमInference पैकेज infer से और जांच सकते हैं।Trustpilot पर एक समीक्षा में सेवा का संक्षिप्त विवरण, 5-स्टार रेटिंग, एक यूज़र नाम और पोस्ट किए जाने का समय होता है।
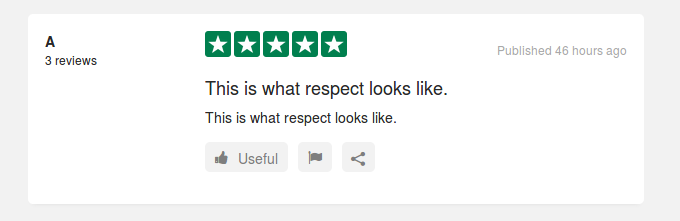
आपका लक्ष्य R में एक फ़ंक्शन लिखना है जो आपकी चुनी हुई किसी भी कंपनी के लिए यह जानकारी निकाल देगा।
सबसे पहले, आपको इस कार्य के लिए सभी लाइब्रेरी लोड करनी होंगी।
    # General-purpose data wrangling
    library(tidyverse)

    # Parsing of HTML/XML files
    library(rvest)

    # String manipulation
    library(stringr)

    # Verbose regular expressions
    library(rebus)

    # Eases DateTime manipulation
library(lubridate) उदाहरण के तौर पर, आप ई-कॉमर्स कंपनी Amazon चुन सकते हैं। यह केवल डेमो उद्देश्यों के लिए है और किसी भी तरह ट्यूटोरियल के दूसरे हिस्से में आने वाले केस स्टडी से संबंधित नहीं है।
लैंडिंग पेज URL किसी कंपनी के लिए पहचानकर्ता होगा, इसलिए आप इसे एक वेरिएबल के रूप में सहेजेंगे।
url <-'http://www.trustpilot.com/review/www.amazon.com'
अधिकांश बड़ी कंपनियों की कई समीक्षा पेज होते हैं। Amazon के लैंडिंग पेज पर आप पेजों की संख्या पढ़ सकते हैं, यहाँ यह 155 है।
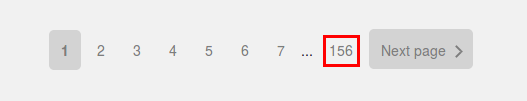
किसी भी सबपेज पर क्लिक करने से यह पैटर्न पता चलता है कि किसी कंपनी के व्यक्तिगत URL कैसे बनाए जाते हैं। प्रत्येक URL मुख्य URL में ?page=n जोड़कर बनता है, जहाँ n समीक्षा पेज का नंबर है, जो यहाँ 1 से 155 तक कोई भी संख्या हो सकती है।
आपके प्रोग्राम को इस तरह काम करना चाहिए:
आइए पेजों की अधिकतम संख्या ढूँढने से शुरू करें। सामान्यतः, आप अपने ब्राउज़र के वेब डेवलपमेंट टूल्स का उपयोग करके किसी वेबसाइट के विज़ुअल एलिमेंट्स का निरीक्षण कर सकते हैं। इसके पीछे विचार यह है कि किसी वेबसाइट की सारी सामग्री, भले ही डायनामिक रूप से बनी हो, सोर्स कोड में किसी न किसी तरह टैग की जाती है। ये टैग आमतौर पर उस डेटा को सटीक रूप से इंगित करने के लिए पर्याप्त होते हैं जिसे आप निकालना चाह रहे हैं।
चूँकि यह केवल एक परिचय है, आप आसानी से सीधे सोर्स कोड पर नज़र डाल सकते हैं।
HTML डेटा की संरचना इस प्रकार होती है:
    < Tag  Attribute_1 = Value_1 Attribute_2 = Value_2 ...>
        The tagged data
        <\Tag>
डेटा तक पहुँचने के लिए, आपको rvest पैकेज के कुछ फ़ंक्शंस की आवश्यकता होगी। किसी वेबसाइट को XML ऑब्जेक्ट में बदलने के लिए read_html() फ़ंक्शन का उपयोग करें। आपको एक टार्गेट URL देना होगा और यह फ़ंक्शन वेब सर्वर को कॉल करता है, डेटा एकत्र करता है और उसे पार्स करता है। XML ऑब्जेक्ट से प्रासंगिक नोड्स निकालने के लिए html_nodes() का उपयोग करें, जिसका आर्ग्युमेंट क्लास डिस्क्रिप्टर होता है, और उसके पहले . लगाया जाता है ताकि यह संकेत मिले कि यह एक क्लास है। आउटपुट इस तरह मिले सभी नोड्स की सूची होगी। टैग किए गए डेटा को निकालने के लिए, जिन नोड्स की आपको आवश्यकता है उन पर html_text() लगाएँ। जहाँ आपको एट्रिब्यूट्स निकालने हों, वहाँ html_attrs() का उपयोग करें। यह एट्रिब्यूट्स की सूची लौटाएगा, जिसे आप इच्छित एट्रिब्यूट पाने के लिए सबसेट कर सकते हैं।
इसे व्यवहार में लागू करें। Amazon के लैंडिंग पेज पर राइट-क्लिक करने के बाद आप सोर्स कोड का निरीक्षण चुन सकते हैं। संबंधित सेक्शन जल्दी खोजने के लिए आप '155' संख्या ढूँढ सकते हैं।
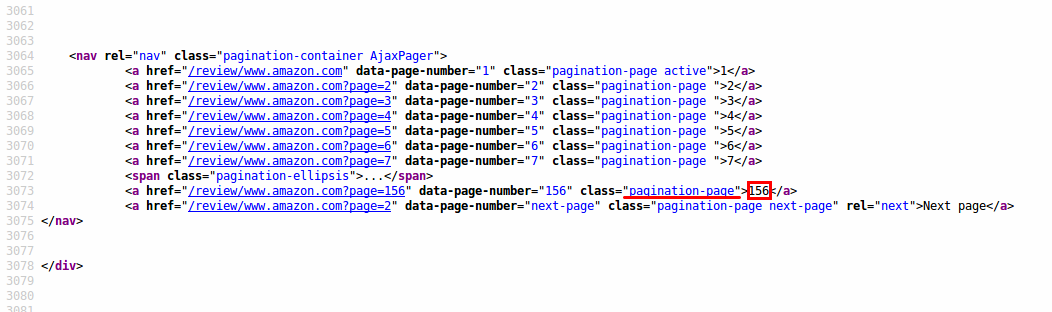
आप देख सकते हैं कि सभी पेज बटन जानकारी 'pagination-page' क्लास के रूप में टैग की गई है। एक फ़ंक्शन जो लैंडिंग पेज के रॉ HTML को लेता है और pagination-page क्लास की दूसरी आखिरी आइटम निकालता है, इस तरह दिखता है:
    get_last_page <- function(html){

      pages_data <- html %>%
                      # The '.' indicates the class
                      html_nodes('.pagination-page') %>%
                      # Extract the raw text as a list
                      html_text()

      # The second to last of the buttons is the one
      pages_data[(length(pages_data)-1)] %>%
        # Take the raw string
        unname() %>%
        # Convert to number
        as.numeric()
    }
इस फ़ंक्शन के लिए विशिष्ट कदम html_nodes() का उपयोग है जो pagination क्लास के सभी नोड्स निकालता है। फ़ंक्शन का आख़िरी भाग सूची की सही आइटम, यानी दूसरी आखिरी, लेता है और उसे संख्यात्मक मान में बदलता है।
फ़ंक्शन का परीक्षण करने के लिए, आप read_html() फ़ंक्शन से शुरुआती पेज लोड कर सकते हैं और अभी जो फ़ंक्शन लिखा है उसे लागू कर सकते हैं:
    first_page <- read_html(url)
    (latest_page_number <- get_last_page(first_page))
[1] 155
अब जबकि आपके पास यह संख्या है, आप सभी प्रासंगिक URL की सूची जनरेट कर सकते हैं
list_of_pages <- str_c(url, '?page=', 1:latest_page_number)
आप मैन्युअली जाँच सकते हैं कि list_of_pages की एंट्रियाँ वास्तव में वैध हैं और वेब ब्राउज़र से खोली जा सकती हैं।
आप किसी सबपेज पर सभी समीक्षाओं का टेक्स्ट, रेटिंग, लेखक का नाम और सबमिशन का समय निकालना चाहते हैं। जिन फ़ील्ड्स की आप तलाश कर रहे हैं, उनके लिए आप पहले जैसे चरण दोहरा सकते हैं।
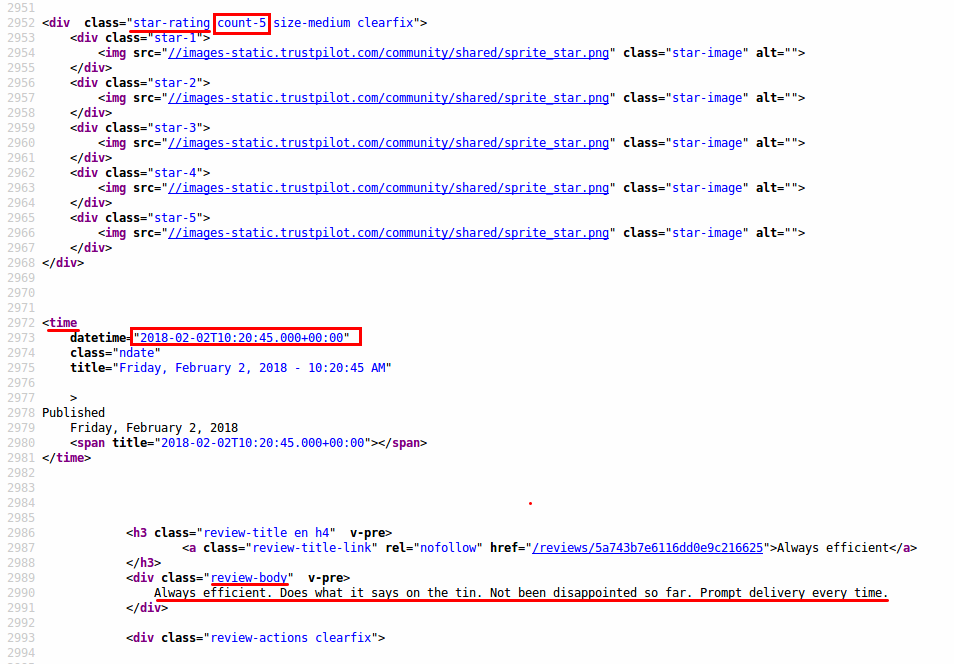
प्रत्येक डेटा फ़ील्ड के लिए आप एक एक्सट्रैक्शन फ़ंक्शन लिखते हैं, जिन टैग्स का आपने निरीक्षण किया है उनका उपयोग करते हुए। इस चरण पर, सटीक डेटा पाने के लिए थोड़ी कोशिश–गलती की आवश्यकता हो सकती है। कभी-कभी आपको अतिरिक्त आइटम भी टैग किए हुए मिलेंगे, तो आपको आउटपुट को मैन्युअली घटाना होगा।
    get_reviews <- function(html){
      html %>%
        # The relevant tag
        html_nodes('.review-body') %>%
        html_text() %>%
        # Trim additional white space
        str_trim() %>%
        # Convert the list into a vector
        unlist()
    }

    get_reviewer_names <- function(html){
      html %>%
        html_nodes('.user-review-name-link') %>%
        html_text() %>%
        str_trim() %>%
        unlist()
    }
दिनांक–समय की जानकारी थोड़ी पेचीदा है, क्योंकि वह एक एट्रिब्यूट के रूप में संग्रहीत है।
आम तौर पर, आप सबसे व्यापक विवरण ढूँढते हैं और फिर सारी अनावश्यक जानकारी काटते हैं। क्योंकि समय की जानकारी सिर्फ़ समीक्षाओं में ही नहीं आती, आपको प्रासंगिक status जानकारी भी निकालनी होगी और सही एंट्री पर फ़िल्टर करना होगा।
    get_review_dates <- function(html){

      status <- html %>%
                  html_nodes('time') %>%
                  # The status information is this time a tag attribute
                  html_attrs() %>%
                  # Extract the second element
                  map(2) %>%
                  unlist()

      dates <- html %>%
                  html_nodes('time') %>%
                  html_attrs() %>%
                  map(1) %>%
                  # Parse the string into a datetime object with lubridate
                  ymd_hms() %>%
                  unlist()

      # Combine the status and the date information to filter one via the other
      return_dates <- tibble(status = status, dates = dates) %>%
                        # Only these are actual reviews
                        filter(status == 'ndate') %>%
                        # Select and convert to vector
                        pull(dates) %>%
                        # Convert DateTimes to POSIX objects
                        as.POSIXct(origin = '1970-01-01 00:00:00')

      # The lengths still occasionally do not lign up. You then arbitrarily crop the dates to fit
      # This can cause data imperfections, however reviews on one page are generally close in time)

      length_reviews <- length(get_reviews(html))

      return_reviews <- if (length(return_dates)> length_reviews){
          return_dates[1:length_reviews]
        } else{
          return_dates
        }
      return_reviews
    }
आख़िरी फ़ंक्शन जो आपको चाहिए, वह रेटिंग्स का एक्सट्रैक्टर है। आप पैटर्न मिलान के लिए रेगुलर एक्सप्रेशन का उपयोग करेंगे। रेटिंग टैग के एक एट्रिब्यूट के रूप में रखी जाती है। यह केवल एक संख्या न होकर count-X स्ट्रिंग का हिस्सा होती है, जहाँ X वह संख्या है जो आपको चाहिए। रेगुलर एक्सप्रेशन थोड़े कठिन हो सकते हैं, लेकिन rebus पैकेज उन्हें मानव-पठनीय रूप में लिखने की सुविधा देता है। इसके अलावा, rebus का पाइपिंग ऑपरेटर %R% जटिल पैटर्न को छोटे उप-पैटर्न में बाँटकर रेगुलर एक्सप्रेशन को संरचित करने में मदद करता है।
    get_star_rating <- function(html){

      # The pattern you look for: the first digit after `count-`
      pattern = 'count-'%R% capture(DIGIT)

      ratings <-  html %>%
        html_nodes('.star-rating') %>%
        html_attrs() %>%
        # Apply the pattern match to all attributes
        map(str_match, pattern = pattern) %>%
        # str_match[1] is the fully matched string, the second entry
        # is the part you extract with the capture in your pattern
        map(2) %>%

        unlist()

      # Leave out the first instance, as it is not part of a review
      ratings[2:length(ratings)]
    }
जब आप जाँच लें कि व्यक्तिगत एक्सट्रैक्टर फ़ंक्शन एकल URL पर काम करते हैं, तो आप उन्हें मिलाकर पूरे पेज के लिए एक टिबल बनाएँगे, जो मूलतः एक डेटा फ्रेम है। क्योंकि आप संभवतः इस फ़ंक्शन को एक से अधिक कंपनियों पर लागू करेंगे, आप कंपनी नाम के साथ एक फ़ील्ड जोड़ेंगे। यह बाद के विश्लेषण में मददगार हो सकता है जब आप अलग-अलग कंपनियों की तुलना करना चाहें।
    get_data_table <- function(html, company_name){

      # Extract the Basic information from the HTML
      reviews <- get_reviews(html)
      reviewer_names <- get_reviewer_names(html)
      dates <- get_review_dates(html)
      ratings <- get_star_rating(html)

      # Combine into a tibble
      combined_data <- tibble(reviewer = reviewer_names,
                              date = dates,
                              rating = ratings,
                              review = reviews)

      # Tag the individual data with the company name
      combined_data %>%
        mutate(company = company_name) %>%
        select(company, reviewer, date, rating, review)
    }
आप इस फ़ंक्शन को एक ऐसे कमांड में लपेटते हैं जो URL से HTML निकालता है ताकि हैंडलिंग और सुविधाजनक हो जाए।
    get_data_from_url <- function(url, company_name){
      html <- read_html(url)
      get_data_table(html, company_name)
    }
आख़िरी चरण में, आप इस फ़ंक्शन को पहले जनरेट की गई URL सूची पर लागू करते हैं। ऐसा करने के लिए, आप tidyverse के हिस्से purrr पैकेज की map() फ़ंक्शन का उपयोग करते हैं। यह एक सूची की सभी आइटम्स पर वही फ़ंक्शन लागू करती है। आपने पहले भी इस फ़ंक्शन का उपयोग किया था, हालाँकि तब आपने एक संख्या n पास की थी, जो सूची के n-वें उप-आइटम को निकालने का शॉर्ट-हैंड है।
अंततः, आप एक सुविधाजनक फ़ंक्शन लिखते हैं जो इनपुट के रूप में किसी कंपनी के लैंडिंग पेज का URL और कंपनी को दिया जाने वाला लेबल लेता है। यह सभी समीक्षाएँ निकालता है और उन्हें एक टिबल में बाँध देता है। यह कोड को ऑप्टिमाइज़ करने की एक अच्छी शुरुआत भी है। map फ़ंक्शन अनुक्रम में get_data_from_url() लागू करता है, पर ऐसा होना ज़रूरी नहीं है। यहाँ पैरेललाइज़ेशन करके कई CPU को पेजों के सबसेट की समीक्षाएँ निकालने दी जा सकती हैं और अंत में उन्हें जोड़ा जा सकता है।
    scrape_write_table <- function(url, company_name){

      # Read first page
      first_page <- read_html(url)

      # Extract the number of pages that have to be queried
      latest_page_number <- get_last_page(first_page)

      # Generate the target URLs
      list_of_pages <- str_c(url, '?page=', 1:latest_page_number)

      # Apply the extraction and bind the individual results back into one table,
      # which is then written as a tsv file into the working directory
      list_of_pages %>%
        # Apply to all URLs
        map(get_data_from_url, company_name) %>%
        # Combine the tibbles into one tibble
        bind_rows() %>%
        # Write a tab-separated file
        write_tsv(str_c(company_name,'.tsv'))
    }
आप परिणाम को टैब-सेपरेटेड फ़ाइल के रूप में डिस्क पर सहेजते हैं, सामान्य कॉमा-सेपरेटेड फ़ाइल (CSV) के बजाय, क्योंकि समीक्षाओं में अक्सर कॉमा होते हैं, जो पार्सर को भ्रमित कर सकते हैं।
उदाहरण के लिए आप इस फ़ंक्शन को Amazon पर लागू कर सकते हैं:
    scrape_write_table(url, 'amazon')

    amz_tbl <- read_tsv('amazon.tsv')
    tail(amz_tbl, 5)
    # A tibble: 5 x 5
      company            reviewer                date rating
        <chr>               <chr>              <dttm>  <int>
    1  amazon            Anders T 2009-03-22 13:14:12      5
    2  amazon             David E 2008-12-31 18:57:31      5
    3  amazon      Joseph Harding 2008-09-16 13:05:05      3
    4  amazon   "Mads D\u00f8rup" 2008-04-28 11:09:05      5
    5  amazon Kim Fuglsang Kramer 2007-08-27 17:25:01      4
    # ... with 1 more variables: review <chr>
पिछले सेक्शन के वेबस्क्रैपिंग फ़ंक्शन से आप जल्दी ही बहुत सारा डेटा प्राप्त कर सकते हैं। इस डेटा से कई तरह के विश्लेषण संभव हैं।
इस केस स्टडी में, आप केवल समीक्षाओं के मेटाडेटा का उपयोग करेंगे, यानी उनकी रेटिंग और समीक्षा का समय।
सबसे पहले, आप अतिरिक्त लाइब्रेरी लोड करें।
    # For working with time series
    library(xts)

    # For hypothesis testing
    library(infer)
जिन कंपनियों में आपकी रुचि है, वे एक ही उद्योग की प्रमुख खिलाड़ी हैं। वे अपनी वेबसाइट पर भी अपने TrustPilot स्कोर को बिक्री बिंदु के रूप में इस्तेमाल करती हैं।
आपने उनका डेटा स्क्रैप कर लिया है और अब केवल उसे लोड करना है:
    data_company_a <- read_tsv('company_A.tsv')
    data_company_b <- read_tsv('company_B.tsv')
आप dplyr पैकेज के group_by() और summarise() फ़ंक्शंस की मदद से उनके समग्र आँकड़े संक्षेपित कर सकते हैं:
    full_data <- rbind(data_company_a, data_company_b)

    full_data%>%
      group_by(company) %>%
      summarise(count = n(), mean_rating = mean(rating))
| company | count | mean_rating |
|---|---|---|
| company_A | 3628 | 4.908214 |
| company_B | 2615 | 4.852773 |
दोनों कंपनियों की औसत रेटिंग्स तुलनीय दिखती हैं। कंपनी B, जो थोड़े लंबे समय से व्यवसाय में है, की रेटिंग भी थोड़ा कम लगती है।
आगे के विश्लेषण की एक अच्छी शुरुआत यह देखना है कि प्रत्येक कंपनी के लिए महीने-दर-महीने रेटिंग के हिसाब से प्रदर्शन कैसा रहा। सबसे पहले, आप डेटा से टाइम सीरीज़ निकालते हैं और फिर उन्हें उस बिंदु तक सबसेट करते हैं जहाँ दोनों कंपनियाँ व्यवसाय में थीं और पर्याप्त समीक्षा गतिविधि उत्पन्न हुई। यह टाइम सीरीज़ को विज़ुअलाइज़ करके पाया जा सकता है। यदि कई महीनों तक डेटा में बहुत बड़े गैप्स हैं, तो डेटा से निकाले गए निष्कर्ष कम विश्वसनीय होते हैं।
    company_a_ts <- xts(data_company_a$rating, data_company_a$date)
    colnames(company_a_ts) <- 'rating'
    company_b_ts <- xts(data_company_b$rating, data_company_b$date)
    colnames(company_b_ts) <- 'rating'

    open_ended_interval <- '2016-01-01/'

    # Subsetting the time series
    company_a_sts <- company_a_ts[open_ended_interval]
    company_b_sts <- company_b_ts[open_ended_interval]
अब आप xts पैकेज के apply.monthly() फ़ंक्शन से मासिक औसत लागू कर सकते हैं। शुरुआत में, प्रत्येक कंपनी की मासिक औसत रेटिंग्स इकट्ठा करें। टाइम सीरीज़ में एक ही इंडेक्स के लिए एक से अधिक ऑब्ज़र्वेशन हो सकते हैं। यह बताने के लिए कि औसत एक फ़ील्ड के संदर्भ में लिया जा रहा है, यहाँ rating, हमें colMeans पास करना होगा।
इसके बाद, मासिक काउंट्स निकालने के लिए FUN आर्ग्युमेंट में length पास करना न भूलें। ऐसा इसलिए क्योंकि टाइम सीरीज़ को एक वेक्टर की तरह देखा जा सकता है। हर समीक्षा उस वेक्टर की लंबाई एक से बढ़ाती है और length फ़ंक्शन मूलतः समीक्षाओं की गिनती करता है।
    company_a_month_avg <-  apply.monthly(company_a_sts, colMeans, na.rm = T)
    company_a_month_count  <-  apply.monthly(company_a_sts, FUN = length)

    company_b_month_avg <-  apply.monthly(company_b_sts, colMeans, na.rm = T)
    company_b_month_count  <-  apply.monthly(company_b_sts, FUN = length)
इसके आगे, आप मासिक रेटिंग्स और काउंट्स की तुलना कर सकते हैं। यह बहुत आसानी से किया जा सकता है: प्रत्येक कंपनी की मासिक औसत रेटिंग्स और उन्हीं रेटिंग्स के काउंट्स को अलग-अलग प्लॉट में प्लॉट करें और फिर उन्हें एक ग्रिड में सजाएँ:
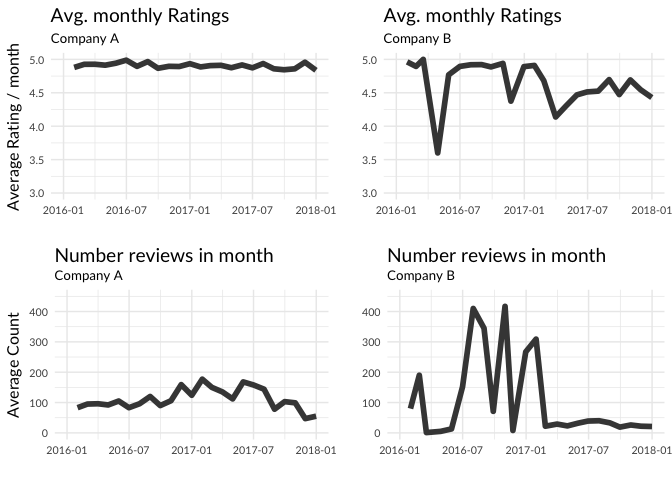
ऐसा लगता है कि कंपनी A की रेटिंग्स लगातार अधिक हैं। सिर्फ़ इतना ही नहीं, कंपनी B के लिए मासिक समीक्षा संख्या में बहुत तेज़ स्पाइक्स दिखते हैं, खासकर औसत दर्जे की समीक्षाओं के बाद।
क्या यहाँ किसी गड़बड़ी की गुंजाइश हो सकती है?
अब जब आपने देखा कि डेटा, विशेषकर कंपनी B का, समय के साथ काफ़ी नाटकीय रूप से बदलता है, तो स्वाभाविक प्रश्न यह है कि सप्ताह में या दिन के भीतर समीक्षा गतिविधि कैसे वितरित है।
    full_data <- full_data %>%
      filter(date >= start_date) %>%
      mutate(weekday = weekdays(date, abbreviate = T),
             hour = hour(date))

    # Treat the weekdays as factor.
    # The order is for the plotting only
    full_data$weekday <-  factor(full_data$weekday,
                                 levels = c('Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun'))
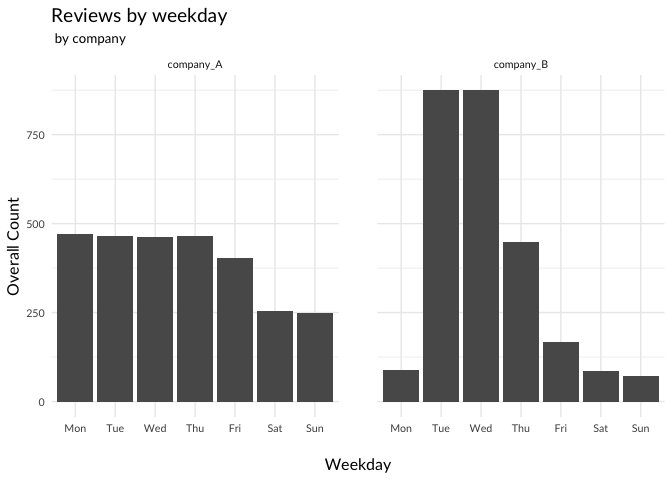
यदि आप सप्ताह के दिन और दिन के घंटे के हिसाब से समीक्षाओं का प्लॉट बनाते हैं, तो भी उल्लेखनीय अंतर मिलते हैं:
दिन के समय के अनुसार विभाजन भी दोनों प्रतिद्वंद्वियों के बीच चौंकाने वाले अंतर दिखाता है:
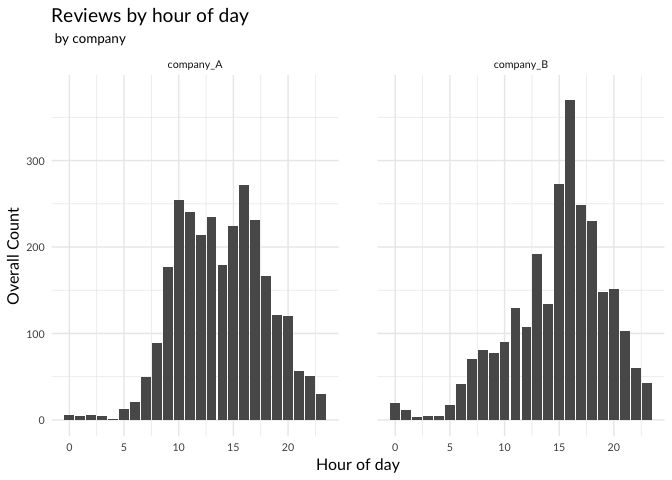
ऐसा लगता है कि दिन में रात की तुलना में अधिक समीक्षाएँ लिखी जाती हैं। हालांकि कंपनी B में दोपहर के समय लिखी गई समीक्षाओं में स्पष्ट पीक दिखता है।
ये पैटर्न संकेत देते हैं कि कंपनी B में कुछ संदिग्ध हो सकता है। शायद कुछ समीक्षाएँ उपयोगकर्ताओं द्वारा नहीं, बल्कि पेशेवरों द्वारा लिखी जाती हैं। आप अपेक्षा करेंगे कि ऐसी समीक्षाएँ, औसतन, आम लोगों द्वारा लिखी गई समीक्षाओं से बेहतर होंगी। चूँकि कंपनी B की समीक्षा गतिविधि कार्यदिवसों में बहुत अधिक है, यह संभव लगता है कि पेशेवर अपनी समीक्षाएँ उन्हीं दिनों में लिखते हों। अब आप एक शून्य परिकल्पना बना सकते हैं जिसे आप डेटा के साक्ष्यों से खारिज करने की कोशिश कर सकते हैं।
कार्यदिवस में लिखी गई समीक्षाओं और सप्ताहांत में लिखी गई समीक्षाओं के बीच कोई व्यवस्थित अंतर नहीं है।
इसे परखने के लिए, आप कंपनी B की समीक्षाओं को कार्यदिवस और सप्ताहांत में लिखी गई में बाँटते हैं, और उनकी औसत रेटिंग्स जाँचते हैं
    hypothesis_data <- full_data %>%
      mutate(is_weekend = ifelse(weekday %in% c('Sat', 'Sun'), 1, 0)) %>%
      select(company, is_weekend, rating)

    hypothesis_data %>%
      group_by(company, is_weekend) %>%
      summarise(avg_rating = mean(rating)) %>%
      spread(key = is_weekend, value = avg_rating) %>%
      rename(weekday = '0', weekend = '1)
| company | weekday | weekend |
|---|---|---|
| company_A | 4.898103 | 4.912176 |
| company_B | 4.864545 | 4.666667 |
यह निश्चित रूप से पर्याप्त छोटा अंतर लगता है, पर क्या यह महज़ संयोग है?
आप औसत में अंतर निकाल सकते हैं:
    weekend_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 1) %>%
      summarise(mean(rating)) %>%
      pull()

    workday_rating <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      filter(is_weekend == 0) %>%
      summarise(mean(rating)) %>%
      pull()

    (diff_work_we <- workday_rating - weekend_rating)
[1] 0.1978784
यदि वास्तव में कार्यदिवस और सप्ताहांत के बीच कोई अंतर न होता, तो आप is_weekend लेबल को सरलता से परमीट कर सकते और औसत के बीच का अंतर समान परिमाण का होना चाहिए था। ऐसे 'हैकर स्टैटिस्टिक्स' के लिए सुविधाजनक तरीका infer पैकेज देता है:
    permutation_tests <- hypothesis_data %>%
      filter(company == 'company_B') %>%
      specify(rating ~ is_weekend ) %>%
      hypothesize(null = 'independence') %>%
      generate(reps = 10000, type = 'permute') %>%
      calculate(stat = 'diff in means', order = c(0,1))
यहाँ आपने वह संबंध निर्दिष्ट किया है जिसे आप परखना चाहते हैं, स्वतंत्रता की परिकल्पना दी है और फ़ंक्शन को 10000 परमीटेशन जनरेट करने को कहा है, हर बार औसत रेटिंग का अंतर निकालते हुए। अब आप उस परमीटेशन की आवृत्ति निकाल सकते हैं जो महज़ संयोग से इतना अंतर पैदा करती है:
    permutation_tests %>%
      summarise(p = mean(abs(stat)>= diff_work_we))
    # A tibble: 1 x 1
          p
      <dbl>
    1 7e-04
वास्तव में, देखे गए प्रभाव का महज़ संयोग होना अत्यंत असंभाव्य है। यह किसी गलत काम को सिद्ध नहीं करता, लेकिन संदेह अवश्य पैदा करता है। उदाहरण के लिए, कंपनी A के लिए यही प्रयोग करने पर p मान 0.561 आता है, जिसका अर्थ है कि देखा गया जितना चरम मान मिलना काफ़ी संभव है, जो आपकी शून्य परिकल्पना को निश्चित रूप से निरस्त नहीं करता।
इस ट्यूटोरियल में, आपने एक सरल प्रोग्राम लिखा जो TrustPilot वेबसाइट से डेटा स्क्रैप करने देता है। यह डेटा एक सुसंगत, टाइडी डेटा टेबल में संरचित है और आगे के अनेक विश्लेषणों का अवसर देता है।
उदाहरण के तौर पर, आपने एक ही उद्योग में काम करने वाली दो कंपनियों की जानकारी स्क्रैप की। आपने उनके मेटाडेटा का विश्लेषण किया और एक में संदिग्ध पैटर्न पाए। आपने परिकल्पना परीक्षण का उपयोग करके दिखाया कि सप्ताह के दिन का एक कंपनी की रेटिंग्स पर व्यवस्थित प्रभाव है। यह इस बात का संकेतक है कि समीक्षाओं में हेरफेर किया गया हो सकता है, क्योंकि इतने अंतर का कोई और अच्छा स्पष्टीकरण नहीं है। दूसरी कंपनी के लिए आप इस प्रभाव की पुष्टि नहीं कर पाए, जो यह नहीं दर्शाता कि उनकी समीक्षाएँ अनिवार्य रूप से ईमानदार हैं।
फेक समीक्षाओं से ग्रस्त रिव्यू वेबसाइट्स पर अधिक जानकारी उदाहरण के लिए Guardian में मिल सकती है।
R में वेब स्क्रैपिंग के बारे में और सीखना चाहते हैं? हमारा R में वेब स्क्रैपिंग और डेटा पार्सिंग ट्यूटोरियल देखें।
R पाठ्यक्रम
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}