

Apa itu ScrapeGraphAI?
ScrapeGraphAI adalah alat web scraping yang andal yang menggunakan model bahasa besar (LLM) dan logika graf langsung untuk membangun pipeline scraping.
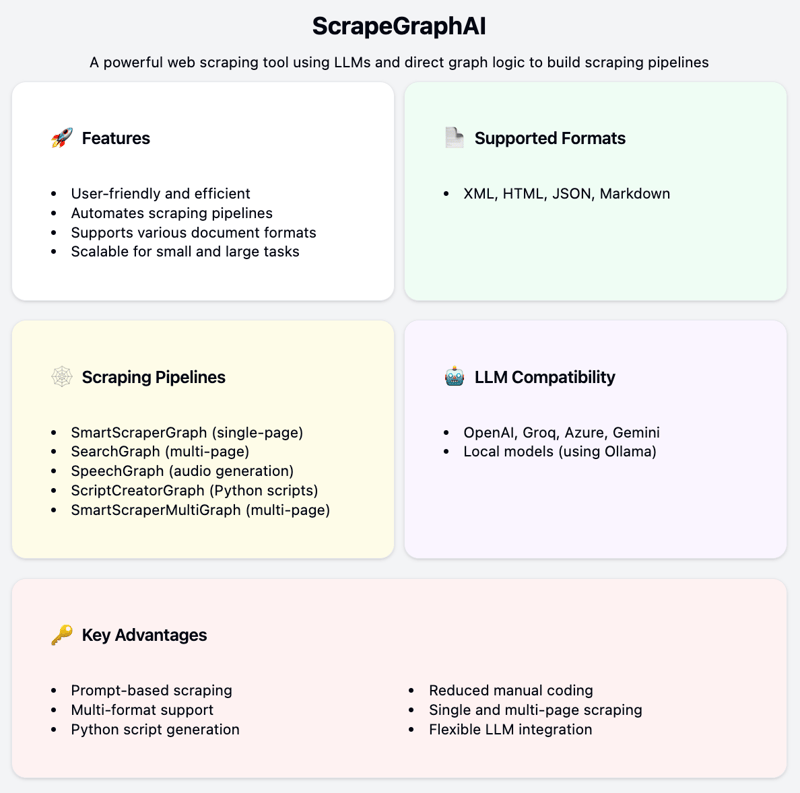
Alat ini dapat mengekstrak informasi dari situs web dan berbagai format dokumen lokal, seperti XML, HTML, JSON, dan Markdown.
Fitur
ScrapeGraphAI dirancang agar mudah digunakan dan efisien. Pengguna cukup menentukan informasi yang dibutuhkan, dan ScrapeGraphAI menangani sisanya. Alat ini mengotomatiskan pembuatan pipeline scraping berdasarkan prompt pengguna, sehingga mengurangi kebutuhan pengodean manual.
Alat ini mendukung berbagai format dokumen dan dapat terintegrasi dengan berbagai LLM melalui API. Skalabel, dengan kemampuan scraping satu halaman maupun multi-halaman, sehingga cocok untuk tugas ekstraksi data skala kecil hingga besar.
Terakhir, alat ini kompatibel dengan berbagai penyedia LLM seperti OpenAI, Groq, Azure, dan Gemini, serta model lokal menggunakan Ollama.
Pipeline scraping
ScrapeGraphAI mencakup beberapa jenis pipeline scraping:
- SmartScraperGraph: Scraper satu halaman yang hanya memerlukan prompt pengguna dan sumber masukan.
- SearchGraph: Scraper multi-halaman yang mengekstrak informasi dari hasil pencarian teratas.
- SpeechGraph: Scraper satu halaman yang menghasilkan berkas audio dari konten situs web.
- ScriptCreatorGraph: Scraper satu halaman yang membuat skrip Python untuk data yang diekstrak.
- SmartScraperMultiGraph: Scraper multi-halaman yang bekerja pada beberapa halaman dengan satu prompt dan daftar sumber.
- ScriptCreatorMultiGraph: Scraper multi-halaman yang membuat skrip Python untuk mengekstrak informasi dari banyak halaman dan sumber.
Instalasi ScrapeGraphAI
ScrapeGraphAI memudahkan penyiapan dan menjalankan tugas ekstraksi data dari situs web dan dokumen lokal. Berikut cara cepat memasang library ini dan membangun aplikasi scraping dasar.
Instal cepat
Untuk memasang ScrapeGraphAI, jalankan:
pip install scrapegraphaiMembangun Aplikasi ScrapeGraphAI Sederhana
Kita akan membangun pipeline scraping sederhana menggunakan SmartScraperGraph. Pertama, saya akan menjelaskan langkah-langkahnya, lalu saya berikan kodenya.
Langkah 1: Definisikan tugas
Tentukan informasi yang ingin Anda ekstrak. Pada contoh ini, kita akan mengekstrak semua judul artikel dan URL dari buletin Substack saya sendiri The Limitless Playbook 🧬.
Langkah 2: Pilih pipeline scraping
Pilih pipeline yang tepat. Untuk satu halaman, kita akan menggunakan SmartScraperGraph. Silakan jelajahi pipeline lain untuk kasus penggunaan yang berbeda.
Langkah 3: Jalankan pipeline
Jalankan pipeline menggunakan metode .run() untuk mengekstrak data.
Langkah 4: Tinjau dan gunakan data:
Validasi data yang diekstrak. LLM kuat tetapi mungkin tidak selalu memberikan hasil sempurna pada awalnya. Sesuaikan prompt sesuai kebutuhan untuk mendapatkan keluaran yang diinginkan.
Kode
Berikut potongan kode lengkap yang mencakup langkah-langkah yang diuraikan sebelumnya:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "gpt-3.5-turbo-0125",
"temperature": 0,
},
"verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
prompt="List me all the articles with their respective urls",
source="<https://ryanocm.substack.com/archive>",
config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
json.dump(articles_data, json_file, indent=4)Dan berikut adalah hasil akhirnya. Cukup bagus, bukan?
{
"articles": [
{
"title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
"url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
},
{
"title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
"url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
},
{
"title": "#110 | How to process past fights in relationships",
"url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
},
{
"title": "#109 | AI x Crypto(graphy)",
"url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
},
{
"title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
"url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
},
{
"title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
},
{
"title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
"url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
},
{
"title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
"url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
},
{
"title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
},
{
"title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
"url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
},
{
"title": "#102 | 7 Principles to Writing Well",
"url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
},
{
"title": "#101 | How to Remember More from Books",
"url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
}
]
}Kesimpulan
ScrapeGraphAI menyederhanakan dan mengotomatiskan scraping web dan dokumen, sehingga ekstraksi data menjadi lebih mudah dan cepat. Kompatibilitasnya dengan berbagai LLM dan format dokumen menjadikannya alat serbaguna untuk beragam tugas data. Dengan ScrapeGraphAI, Anda bisa fokus menganalisis dan menggunakan data, bukan sekadar mengumpulkannya.
Untuk mempelajari lebih lanjut, lihat sumber berikut:
Terakhir, mohon gunakan ScrapeGraphAI secara bertanggung jawab dan pahami aturan scraping untuk situs web yang Anda tuju. Selalu ikuti ketentuan layanan dan pedoman hukum untuk web scraping.

Ryan adalah lead data scientist yang mengkhususkan diri dalam membangun aplikasi AI menggunakan LLM. Ia adalah kandidat PhD di bidang Pemrosesan Bahasa Alami dan Knowledge Graph di Imperial College London, tempat ia juga menyelesaikan gelar Master di Ilmu Komputer. Di luar data science, ia menulis newsletter Substack mingguan, The Limitless Playbook, di mana ia membagikan satu ide yang dapat langsung dipraktikkan dari para pemikir top dunia dan sesekali menulis tentang konsep inti AI.



Menarik dan mengatur data dari berbagai sumber, seperti situs web dan dokumen lokal (XML, HTML, JSON, Markdown), bisa rumit dan memakan waktu. Baik Anda sedang melakukan riset, analitik bisnis, atau agregasi konten, upaya manualnya bisa sangat besar.
ScrapeGraphAI, sebuah library Python untuk web scraping, menyederhanakan proses ini.
Alat ini menggunakan model bahasa besar (LLM) dan logika graf langsung untuk membuat pipeline scraping yang efisien, mengotomatiskan ekstraksi data dan meminimalkan kebutuhan pengodean ekstensif.
Dalam artikel ini, saya akan memberikan pengantar singkat tentang ScrapeGraphAI dan memandu Anda menyiapkan pipeline pertama Anda.