Cours
Implémentation IA en entreprise
2 h
54.9K
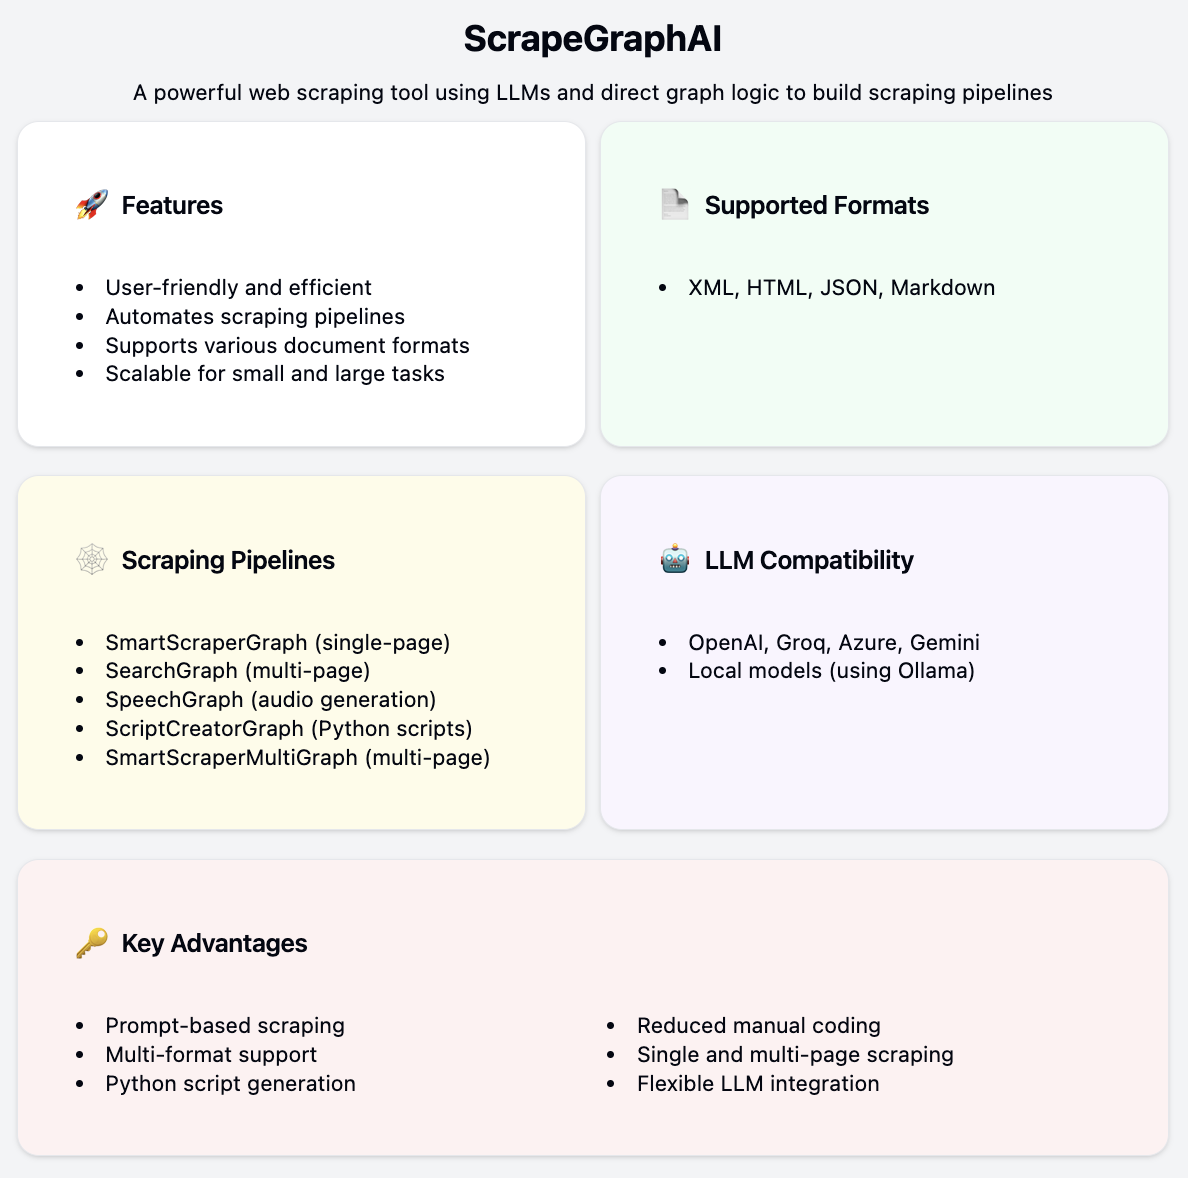
ScrapeGraphAI est un puissant outil de web scraping qui exploite des LLM et une logique de graphe pour construire des pipelines d’extraction.
Il peut extraire des informations depuis des sites web et divers formats de documents locaux, comme XML, HTML, JSON et Markdown.
ScrapeGraphAI a été conçu pour être à la fois simple d’usage et efficace. Il vous suffit d’indiquer les informations recherchées, et ScrapeGraphAI s’occupe du reste. Il automatise la création des pipelines de scraping à partir d’invites, ce qui réduit fortement le besoin de coder manuellement.
L’outil prend en charge plusieurs formats de documents et peut s’intégrer à différents LLM via des API. Il est évolutif, proposant des capacités de scraping sur une seule page ou sur plusieurs pages, ce qui le rend adapté aux tâches d’extraction de données à petite comme à grande échelle.
Enfin, il est compatible avec de nombreux fournisseurs de LLM comme OpenAI, Groq, Azure et Gemini, ainsi qu’avec des modèles locaux via Ollama.
ScrapeGraphAI propose plusieurs types de pipelines :
ScrapeGraphAI facilite la configuration et l’exécution de tâches d’extraction depuis des sites web et des documents locaux. Voici comment installer rapidement la bibliothèque et créer une application de scraping basique.
Pour installer ScrapeGraphAI, exécutez :
pip install scrapegraphaiNous allons construire un pipeline de scraping simple avec SmartScraperGraph. Je décris d’abord les étapes, puis je fournis le code.
Précisez les informations à extraire. Dans cet exemple, nous allons récupérer tous les titres d’articles et leurs URL depuis ma newsletter Substack The Limitless Playbook 🧬.
Sélectionnez le pipeline adapté. Pour une page unique, nous utiliserons SmartScraperGraph. N’hésitez pas à explorer les autres pipelines selon vos cas d’usage.
Lancez le pipeline avec la méthode .run() pour extraire les données.
Validez les données extraites. Les LLM sont puissants mais les premiers résultats peuvent être perfectibles. Ajustez l’invite si nécessaire pour obtenir la sortie souhaitée.
Voici l’extrait de code complet couvrant les étapes décrites plus haut :
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "gpt-3.5-turbo-0125",
        "temperature": 0,
    },
    "verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
    prompt="List me all the articles with their respective urls",
    source="<https://ryanocm.substack.com/archive>",
    config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
    json.dump(articles_data, json_file, indent=4)
Et voici les résultats finaux. Plutôt convaincant, n’est-ce pas ?
{
    "articles": [
        {
            "title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
            "url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
        },
        {
            "title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
            "url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
        },
        {
            "title": "#110 | How to process past fights in relationships",
            "url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
        },
        {
            "title": "#109 | AI x Crypto(graphy)",
            "url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
        },
        {
            "title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
            "url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
        },
        {
            "title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
        },
        {
            "title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
            "url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
        },
        {
            "title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
            "url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
        },
        {
            "title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
        },
        {
            "title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
            "url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
        },
        {
            "title": "#102 | 7 Principles to Writing Well",
            "url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
        },
        {
            "title": "#101 | How to Remember More from Books",
            "url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
        }
    ]
}ScrapeGraphAI simplifie et automatise le scraping web et documentaire, rendant l’extraction de données plus simple et plus rapide. Sa compatibilité avec divers LLM et formats de documents en fait un outil polyvalent pour tous types de tâches data. Avec ScrapeGraphAI, vous pouvez vous concentrer sur l’analyse et l’exploitation de vos données plutôt que sur leur collecte.
Pour aller plus loin, consultez :
Enfin, utilisez ScrapeGraphAI de manière responsable et informez-vous sur les règles de scraping des sites ciblés. Respectez toujours les conditions d’utilisation et le cadre légal.
Apprenez l’IA avec ces cours !
Cours
Cours
Cours