Curso
Implantar soluciones de IA en las empresas
2 h
54.9K
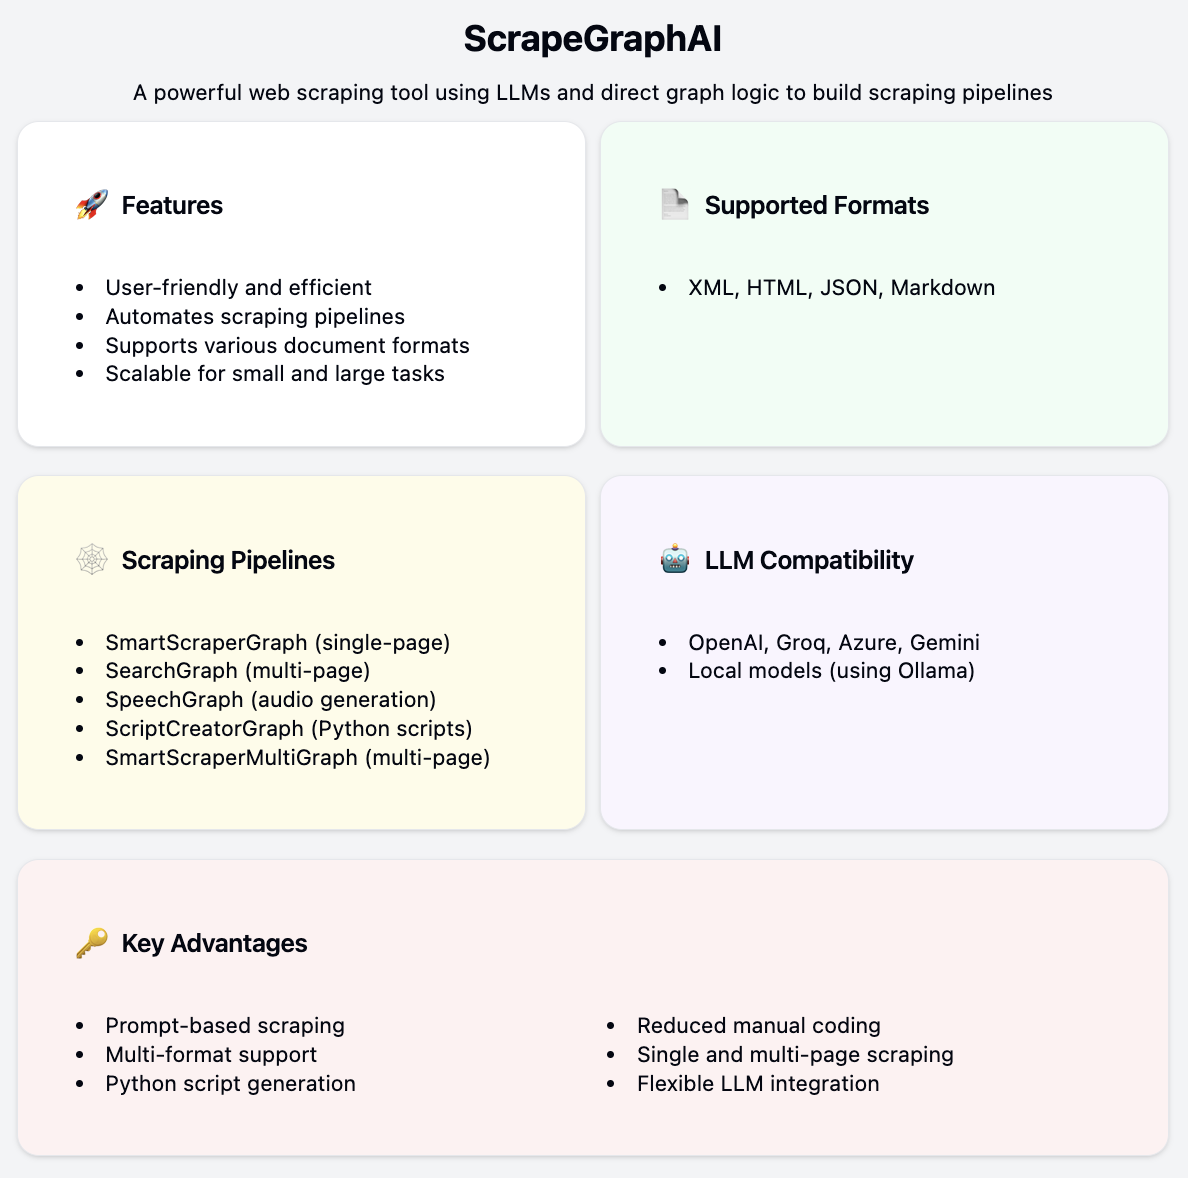
ScrapeGraphAI es una potente herramienta de web scraping que utiliza modelos de lenguaje grandes (LLMs) y lógica de grafos directa para construir pipelines de scraping.
Puede extraer información de sitios web y de varios formatos de documentos locales, como XML, HTML, JSON y Markdown.
ScrapeGraphAI está diseñado para ser fácil de usar y eficiente. Tú solo indicas la información que necesitas y ScrapeGraphAI se encarga del resto. Automatiza la creación de pipelines de scraping a partir de tus prompts, lo que reduce la necesidad de programar manualmente.
La herramienta admite distintos formatos de documentos y puede integrarse con diferentes LLMs mediante APIs. Es escalable, con scraping de una sola página o multipágina, por lo que se adapta a tareas de extracción de datos tanto pequeñas como a gran escala.
Por último, es compatible con varios proveedores de LLM como OpenAI, Groq, Azure y Gemini, además de con modelos locales con Ollama.
ScrapeGraphAI incluye varios tipos de pipelines de scraping:
ScrapeGraphAI facilita la configuración y ejecución de tareas de extracción de datos desde sitios web y documentos locales. Así puedes instalar rápidamente la librería y crear una aplicación básica de scraping.
Para instalar ScrapeGraphAI, ejecuta:
pip install scrapegraphaiVamos a construir un pipeline de scraping sencillo con SmartScraperGraph. Primero te explico los pasos y luego te dejo el código.
Indica qué información quieres extraer. En este ejemplo, extraeremos todos los títulos de artículos y sus URLs de mi newsletter en Substack The Limitless Playbook 🧬.
Selecciona el pipeline adecuado. Para una sola página, usaremos SmartScraperGraph. Si quieres, explora otros pipelines para diferentes casos de uso.
Ejecuta el pipeline con el método .run() para extraer los datos.
Valida los datos extraídos. Los LLMs son potentes, pero puede que al principio no den resultados perfectos. Ajusta el prompt según sea necesario para obtener la salida deseada.
Aquí tienes el fragmento de código completo que cubre los pasos descritos antes:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "gpt-3.5-turbo-0125",
        "temperature": 0,
    },
    "verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
    prompt="List me all the articles with their respective urls",
    source="<https://ryanocm.substack.com/archive>",
    config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
    json.dump(articles_data, json_file, indent=4)
Y estos son los resultados finales. Nada mal, ¿verdad?
{
    "articles": [
        {
            "title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
            "url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
        },
        {
            "title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
            "url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
        },
        {
            "title": "#110 | How to process past fights in relationships",
            "url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
        },
        {
            "title": "#109 | AI x Crypto(graphy)",
            "url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
        },
        {
            "title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
            "url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
        },
        {
            "title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
        },
        {
            "title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
            "url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
        },
        {
            "title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
            "url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
        },
        {
            "title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
        },
        {
            "title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
            "url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
        },
        {
            "title": "#102 | 7 Principles to Writing Well",
            "url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
        },
        {
            "title": "#101 | How to Remember More from Books",
            "url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
        }
    ]
}ScrapeGraphAI simplifica y automatiza el scraping de webs y documentos, haciendo la extracción de datos más fácil y rápida. Su compatibilidad con distintos LLMs y formatos de documentos lo convierte en una herramienta versátil para todo tipo de tareas con datos. Con ScrapeGraphAI, puedes centrarte en analizar y utilizar tus datos en lugar de recogerlos.
Si quieres saber más, echa un vistazo a estos recursos:
Y, por último, usa ScrapeGraphAI de forma responsable y ten en cuenta las normas de scraping de los sitios que elijas. Respeta siempre los términos de servicio y las directrices legales sobre web scraping.
¡Aprende IA con estos cursos!
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Matt Crabtree
6 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
12 min