

ScrapeGraphAI Nedir?
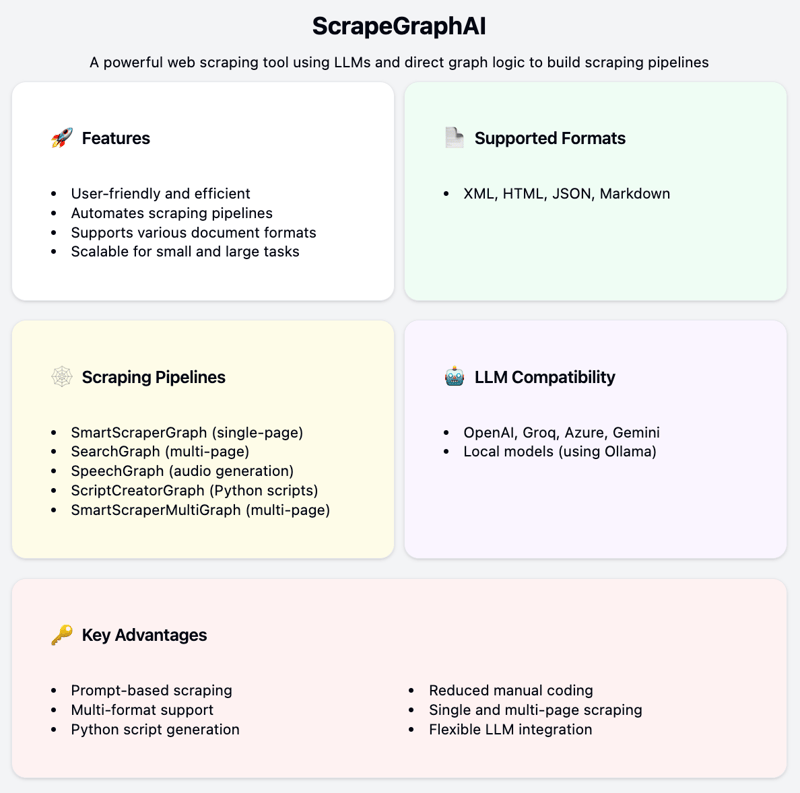
ScrapeGraphAI, kazıma ardışıkları oluşturmak için büyük dil modelleri (LLM’ler) ve doğrudan graf mantığı kullanan güçlü bir web kazıma aracıdır.
Web sitelerinden ve XML, HTML, JSON ve Markdown gibi çeşitli yerel belge formatlarından bilgi çıkarabilir.
Özellikler
ScrapeGraphAI kullanıcı dostu ve verimli olacak şekilde tasarlanmıştır. Kullanıcılar sadece ihtiyaç duydukları bilgiyi belirtir, gerisini ScrapeGraphAI halleder. Kullanıcı istemlerine dayalı olarak kazıma ardışıklarını otomatikleştirir; bu da manuel kodlama ihtiyacını azaltır.
Araç, çeşitli belge formatlarını destekler ve API’ler aracılığıyla farklı LLM’lerle entegre olabilir. Tek sayfalık ve çok sayfalı kazıma yetenekleri sunarak hem küçük hem de büyük ölçekli veri çıkarım görevleri için ölçeklenebilirlik sağlar.
Son olarak, OpenAI, Groq, Azure ve Gemini gibi birden çok LLM sağlayıcısıyla ve Ollama kullanarak yerel modeller ile uyumludur.
Kazıma ardışıkları
ScrapeGraphAI, çeşitli türlerde kazıma ardışıkları içerir:
- SmartScraperGraph: Bu, yalnızca bir kullanıcı istemi ve bir giriş kaynağı gerektiren tek sayfalık bir kazıyıcıdır.
- SearchGraph: Bu çok sayfalı kazıyıcı, en üst arama sonuçlarından bilgi çıkarır.
- SpeechGraph: Bu tek sayfalık kazıyıcı, web sitesi içeriğinden ses dosyaları oluşturur.
- ScriptCreatorGraph: Bu tek sayfalık kazıyıcı, çıkarılan veriler için Python betikleri oluşturur.
- SmartScraperMultiGraph: Bu çok sayfalı kazıyıcı, tek bir istem ve kaynak listesiyle birden çok sayfada çalışır.
- ScriptCreatorMultiGraph: Bu çok sayfalı kazıyıcı, birden çok sayfa ve kaynaktan bilgi çıkarmak için Python betikleri oluşturur.
ScrapeGraphAI Kurulumu
ScrapeGraphAI, web sitelerinden ve yerel belgelerden veri çıkarma görevlerini kurmayı ve çalıştırmayı kolaylaştırır. İşte kütüphaneyi hızla kurma ve temel bir kazıma uygulaması oluşturma yolu.
Hızlı kurulum
ScrapeGraphAI’yi kurmak için şu komutu çalıştırın:
pip install scrapegraphaiBasit Bir ScrapeGraphAI Uygulaması Oluşturma
SmartScraperGraph kullanarak basit bir kazıma ardışı oluşturacağız. Önce adımları açıklayacak, ardından kodu paylaşacağım.
Adım 1: Görevi tanımlayın
Hangi bilgiyi çıkarmak istediğinizi belirtin. Bu örnekte, kendi Substack bültenim The Limitless Playbook 🧬’daki tüm makale başlıklarını ve URL’lerini çıkaracağız.
Adım 2: Kazıma ardışığını seçin
Uygun ardışığı seçin. Tek bir sayfa için SmartScraperGraph kullanacağız. Farklı kullanım durumları için diğer ardışıkları da keşfetmekten çekinmeyin.
Adım 3: Ardışığı çalıştırın
Verileri çıkarmak için .run() metodunu kullanarak ardışığı çalıştırın.
Adım 4: Verileri gözden geçirin ve kullanın:
Çıkarılan verileri doğrulayın. LLM’ler güçlüdür ancak ilk seferde her zaman mükemmel sonuç vermeyebilir. İstediğiniz çıktıyı almak için istemi gerektiği gibi ayarlayın.
Kod
İşte yukarıda özetlenen adımları kapsayan tam kod parçacığı:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "gpt-3.5-turbo-0125",
"temperature": 0,
},
"verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
prompt="List me all the articles with their respective urls",
source="<https://ryanocm.substack.com/archive>",
config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
json.dump(articles_data, json_file, indent=4)Ve işte nihai sonuçlar. Fena değil, değil mi?
{
"articles": [
{
"title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
"url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
},
{
"title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
"url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
},
{
"title": "#110 | How to process past fights in relationships",
"url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
},
{
"title": "#109 | AI x Crypto(graphy)",
"url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
},
{
"title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
"url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
},
{
"title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
},
{
"title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
"url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
},
{
"title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
"url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
},
{
"title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
},
{
"title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
"url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
},
{
"title": "#102 | 7 Principles to Writing Well",
"url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
},
{
"title": "#101 | How to Remember More from Books",
"url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
}
]
}Sonuç
ScrapeGraphAI, web ve belge kazımayı basitleştirip otomatikleştirerek veri çıkarımını daha kolay ve hızlı hale getirir. Çeşitli LLM’lerle ve belge formatlarıyla uyumluluğu, onu her türlü veri görevi için çok yönlü bir araç yapar. ScrapeGraphAI ile veriyi toplamaktan ziyade verinizi analiz etmeye ve kullanmaya odaklanabilirsiniz.
Daha fazlasını öğrenmek için şu kaynaklara göz atın:
Ve son olarak, lütfen ScrapeGraphAI’yi sorumlu bir şekilde kullanın ve hedeflediğiniz web sitelerinin kazıma kurallarının farkında olun. Her zaman hizmet şartlarını ve web kazımaya ilişkin yasal yönergeleri takip edin.

Ryan, LLM'ler kullanarak yapay zeka uygulamaları geliştirme konusunda uzmanlaşmış kıdemli bir veri bilimcisidir. Imperial College London'da Doğal Dil İşleme ve Bilgi Grafiklerinde doktora adayıdır ve aynı kurumda Bilgisayar Bilimleri alanında yüksek lisansını tamamlamıştır. Veri bilimi dışında, haftalık Substack bülteni The Limitless Playbook'u yayımlar; burada dünyanın önde gelen düşünürlerinden uygulanabilir tek bir fikri paylaşır ve zaman zaman temel yapay zeka kavramları hakkında yazar.



Web siteleri ve yerel belgeler (XML, HTML, JSON, Markdown) gibi çeşitli kaynaklardan veri çıkarmak ve düzenlemek karmaşık ve zaman alıcı olabilir. İster araştırma, iş analitiği ister içerik birleştirme yapın, manuel çaba bunaltıcı olabilir.
ScrapeGraphAI, web kazıma için bir Python kütüphanesi olarak bu süreci basitleştirir.
Veri çıkarımını otomatikleştirmek ve kapsamlı kod yazma ihtiyacını en aza indirmek için büyük dil modelleri (LLM’ler) ve doğrudan graf mantığı kullanır ve verimli kazıma ardışıkları oluşturur.
Bu yazıda ScrapeGraphAI’ye kısa bir giriş yapacak ve ilk ardışık düzeninizi kurmanızda size rehberlik edeceğim.