
Our biggest-ever sale. 60% off AI & data skills
Buy Now
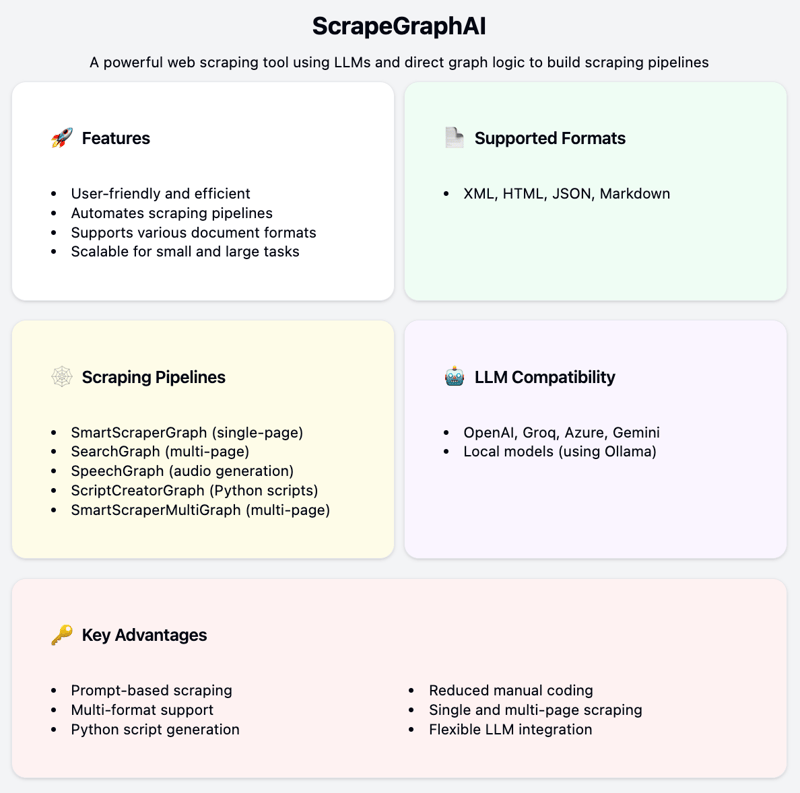
ScrapeGraphAI è un potente strumento di web scraping che utilizza LLM e logica a grafi diretta per costruire pipeline di scraping.
Può estrarre informazioni da siti web e da vari formati di documenti locali, come XML, HTML, JSON e Markdown.
ScrapeGraphAI è progettato per essere intuitivo ed efficiente. Gli utenti devono solo specificare le informazioni di cui hanno bisogno e ScrapeGraphAI si occupa del resto. Automatizza la creazione di pipeline di scraping a partire dai prompt dell’utente, riducendo la necessità di codifica manuale.
Lo strumento supporta vari formati di documenti e può integrarsi con diversi LLM tramite API. È scalabile, con funzionalità di scraping su singola pagina e su più pagine, rendendolo adatto sia a estrazioni di piccola che di grande scala.
Infine, è compatibile con più provider di LLM come OpenAI, Groq, Azure e Gemini, oltre ai modelli locali tramite Ollama.
ScrapeGraphAI include diversi tipi di pipeline di scraping:
ScrapeGraphAI rende semplice configurare ed eseguire attività di estrazione dati da siti web e documenti locali. Ecco come installare rapidamente la libreria e creare un’applicazione di scraping di base.
Per installare ScrapeGraphAI, esegui:
pip install scrapegraphaiCostruiremo una pipeline di scraping semplice usando SmartScraperGraph. Prima descriverò i passaggi e poi fornirò il codice.
Specifica quali informazioni vuoi estrarre. In questo esempio, estrarremo tutti i titoli degli articoli e gli URL dalla mia newsletter Substack The Limitless Playbook 🧬.
Scegli la pipeline appropriata. Per una singola pagina useremo SmartScraperGraph. Sentiti libero di esplorare altre pipeline per casi d’uso diversi.
Esegui la pipeline usando il metodo .run() per estrarre i dati.
Verifica i dati estratti. Gli LLM sono potenti ma potrebbero non fornire sempre risultati perfetti al primo tentativo. Modifica il prompt secondo necessità per ottenere l’output desiderato.
Ecco lo snippet di codice completo che copre i passaggi descritti in precedenza:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "gpt-3.5-turbo-0125",
"temperature": 0,
},
"verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
prompt="List me all the articles with their respective urls",
source="<https://ryanocm.substack.com/archive>",
config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
json.dump(articles_data, json_file, indent=4)E questi sono i risultati finali. Niente male, vero?
{
"articles": [
{
"title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
"url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
},
{
"title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
"url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
},
{
"title": "#110 | How to process past fights in relationships",
"url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
},
{
"title": "#109 | AI x Crypto(graphy)",
"url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
},
{
"title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
"url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
},
{
"title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
},
{
"title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
"url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
},
{
"title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
"url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
},
{
"title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
},
{
"title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
"url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
},
{
"title": "#102 | 7 Principles to Writing Well",
"url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
},
{
"title": "#101 | How to Remember More from Books",
"url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
}
]
}ScrapeGraphAI semplifica e automatizza lo scraping da web e documenti, rendendo l’estrazione dei dati più facile e veloce. La compatibilità con vari LLM e formati di documento lo rende uno strumento versatile per ogni tipo di attività sui dati. Con ScrapeGraphAI puoi concentrarti sull’analisi e sull’uso dei dati, invece che sulla loro raccolta.
Per saperne di più, dai un’occhiata a queste risorse:
Infine, usa ScrapeGraphAI in modo responsabile e informati sulle regole di scraping dei siti che prendi di mira. Segui sempre i termini di servizio e le linee guida legali sul web scraping.
Ryan è un lead data scientist specializzato nello sviluppo di applicazioni di IA con LLM. È dottorando in Elaborazione del Linguaggio Naturale e Knowledge Graph all’Imperial College London, dove ha anche conseguito la laurea magistrale in Informatica. Oltre alla data science, scrive una newsletter settimanale su Substack, The Limitless Playbook, in cui condivide un’idea pratica dei migliori pensatori al mondo e, di tanto in tanto, scrive sui concetti fondamentali dell’IA.

blog
 Abid Ali Awan• 15 min

blog
 Tim Lu• 12 min

blog
Abid Ali Awan• 10 minImpara l’IA con questi corsi!
Corso
Esplora l'Etica dell'IA concentrandoti su principi, equità, riduzione dei bias e fiducia nel design dell'IA.
Corso
Impara a conoscere le pratiche di AI responsabile con questo corso completo, che presenta casi di studio reali e contenuti interattivi.


Estrarre e organizzare dati da varie fonti, come siti web e documenti locali (XML, HTML, JSON, Markdown), può essere complesso e richiedere molto tempo. Che tu stia facendo ricerca, analisi di business o aggregazione di contenuti, il lavoro manuale può diventare travolgente.
ScrapeGraphAI, una libreria Python per il web scraping, semplifica questo processo.
Utilizza modelli linguistici di grandi dimensioni (LLM) e logica a grafi diretta per creare pipeline di scraping efficienti, automatizzando l’estrazione dei dati e riducendo al minimo la necessità di molto codice.
In questo articolo ti darò una breve introduzione a ScrapeGraphAI e ti guiderò nella configurazione della tua prima pipeline.