

ScrapeGraphAI là gì?
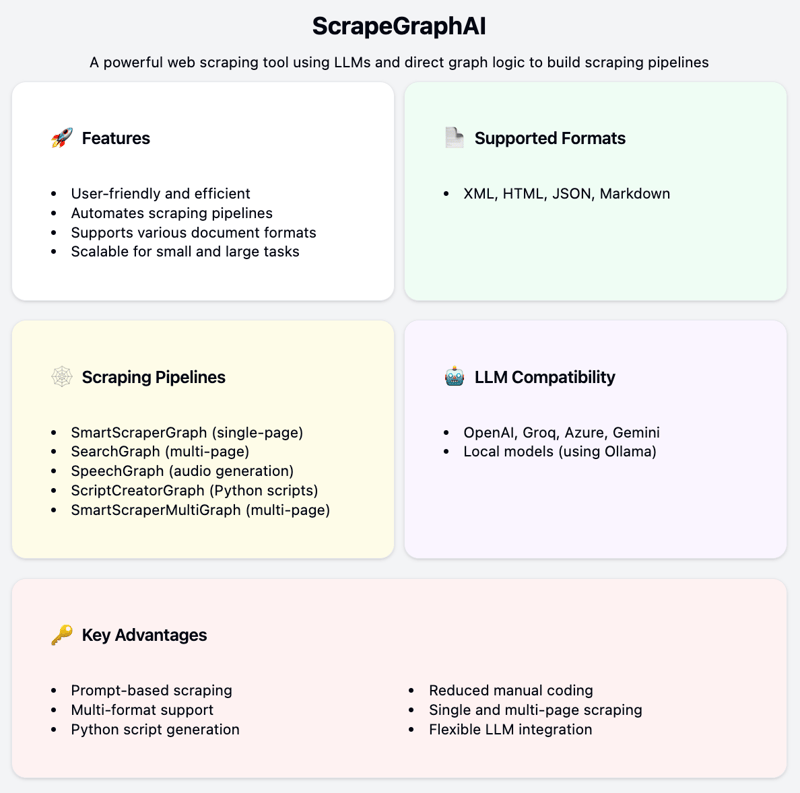
ScrapeGraphAI là một công cụ web scraping mạnh mẽ sử dụng các mô hình ngôn ngữ lớn (LLM) và logic đồ thị trực tiếp để xây dựng các pipeline scraping.
Công cụ có thể trích xuất thông tin từ website và nhiều định dạng tài liệu cục bộ như XML, HTML, JSON và Markdown.
Tính năng
ScrapeGraphAI được thiết kế thân thiện và hiệu quả. Người dùng chỉ cần chỉ định thông tin cần lấy, phần còn lại ScrapeGraphAI sẽ xử lý. Công cụ tự động tạo các pipeline scraping dựa trên prompt của người dùng, nhờ đó giảm nhu cầu viết mã thủ công.
Công cụ hỗ trợ nhiều định dạng tài liệu và có thể tích hợp với các LLM khác nhau thông qua API. Nó có khả năng mở rộng, cung cấp tính năng scraping một trang hoặc đa trang, phù hợp cho cả tác vụ trích xuất dữ liệu quy mô nhỏ lẫn lớn.
Cuối cùng, công cụ tương thích với nhiều nhà cung cấp LLM như OpenAI, Groq, Azure và Gemini, cũng như các mô hình chạy cục bộ bằng Ollama.
Các pipeline scraping
ScrapeGraphAI bao gồm một số loại pipeline scraping:
- SmartScraperGraph: Trình thu thập dữ liệu một trang chỉ cần prompt của người dùng và nguồn đầu vào.
- SearchGraph: Trình thu thập dữ liệu đa trang trích xuất thông tin từ các kết quả tìm kiếm hàng đầu.
- SpeechGraph: Trình thu thập dữ liệu một trang tạo tệp âm thanh từ nội dung website.
- ScriptCreatorGraph: Trình thu thập dữ liệu một trang tạo các script Python cho dữ liệu được trích xuất.
- SmartScraperMultiGraph: Trình thu thập dữ liệu đa trang hoạt động trên nhiều trang với một prompt và một danh sách nguồn.
- ScriptCreatorMultiGraph: Trình thu thập dữ liệu đa trang tạo các script Python để trích xuất thông tin từ nhiều trang và nguồn.
Cài đặt ScrapeGraphAI
ScrapeGraphAI giúp đơn giản hóa việc thiết lập và chạy các tác vụ trích xuất dữ liệu từ website và tài liệu cục bộ. Dưới đây là cách cài đặt nhanh thư viện và xây dựng một ứng dụng scraping cơ bản.
Cài đặt nhanh
Để cài đặt ScrapeGraphAI, chạy:
pip install scrapegraphaiXây dựng ứng dụng ScrapeGraphAI đơn giản
Chúng ta sẽ xây dựng một pipeline scraping đơn giản bằng SmartScraperGraph. Trước tiên, tôi sẽ mô tả các bước, sau đó cung cấp mã nguồn.
Bước 1: Xác định nhiệm vụ
Chỉ định thông tin bạn muốn trích xuất. Trong ví dụ này, chúng ta sẽ trích xuất tất cả tiêu đề bài viết và URL từ bản tin Substack của chính tôi The Limitless Playbook 🧬.
Bước 2: Chọn pipeline scraping
Chọn pipeline phù hợp. Với một trang, chúng ta sẽ dùng SmartScraperGraph. Bạn có thể khám phá các pipeline khác cho những trường hợp sử dụng khác nhau.
Bước 3: Thực thi pipeline
Chạy pipeline bằng phương thức .run() để trích xuất dữ liệu.
Bước 4: Rà soát và sử dụng dữ liệu
Xác thực dữ liệu đã trích xuất. LLM rất mạnh nhưng có thể chưa cho kết quả hoàn hảo ngay từ đầu. Hãy điều chỉnh prompt khi cần để đạt được đầu ra mong muốn.
Mã nguồn
Dưới đây là đoạn mã hoàn chỉnh bao quát các bước đã nêu ở trên:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "gpt-3.5-turbo-0125",
"temperature": 0,
},
"verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
prompt="List me all the articles with their respective urls",
source="<https://ryanocm.substack.com/archive>",
config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
json.dump(articles_data, json_file, indent=4)Và đây là kết quả cuối cùng. Khá ổn phải không?
{
"articles": [
{
"title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
"url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
},
{
"title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
"url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
},
{
"title": "#110 | How to process past fights in relationships",
"url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
},
{
"title": "#109 | AI x Crypto(graphy)",
"url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
},
{
"title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
"url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
},
{
"title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
},
{
"title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
"url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
},
{
"title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
"url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
},
{
"title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
"url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
},
{
"title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
"url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
},
{
"title": "#102 | 7 Principles to Writing Well",
"url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
},
{
"title": "#101 | How to Remember More from Books",
"url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
}
]
}Kết luận
ScrapeGraphAI giúp đơn giản hóa và tự động hóa việc thu thập dữ liệu từ web và tài liệu, khiến quá trình trích xuất dữ liệu trở nên dễ dàng và nhanh chóng hơn. Khả năng tương thích với nhiều LLM và định dạng tài liệu khiến nó trở thành công cụ linh hoạt cho mọi loại tác vụ dữ liệu. Với ScrapeGraphAI, bạn có thể tập trung phân tích và sử dụng dữ liệu thay vì chỉ thu thập dữ liệu.
Để tìm hiểu thêm, hãy xem các tài nguyên sau:
Cuối cùng, vui lòng sử dụng ScrapeGraphAI một cách có trách nhiệm và lưu ý các quy định scraping của những website bạn nhắm đến. Luôn tuân thủ điều khoản dịch vụ và các nguyên tắc pháp lý về web scraping.

Ryan là trưởng nhóm khoa học dữ liệu, chuyên xây dựng các ứng dụng AI sử dụng LLM. Anh là nghiên cứu sinh Tiến sĩ về Xử lý Ngôn ngữ Tự nhiên và Đồ thị Tri thức tại Imperial College London, nơi anh cũng hoàn thành bằng Thạc sĩ Khoa học Máy tính. Ngoài lĩnh vực khoa học dữ liệu, anh viết bản tin Substack hàng tuần, The Limitless Playbook, nơi anh chia sẻ một ý tưởng có thể áp dụng ngay từ các tư tưởng gia hàng đầu thế giới và đôi khi viết về những khái niệm cốt lõi của AI.


Việc trích xuất và sắp xếp dữ liệu từ nhiều nguồn khác nhau, như website và tài liệu cục bộ (XML, HTML, JSON, Markdown), có thể phức tạp và tốn thời gian. Dù bạn đang nghiên cứu, phân tích kinh doanh hay tổng hợp nội dung, khối lượng công việc thủ công có thể trở nên quá tải.
ScrapeGraphAI, một thư viện Python dành cho web scraping, giúp đơn giản hóa quy trình này.
Công cụ sử dụng mô hình ngôn ngữ lớn (LLM) và logic đồ thị trực tiếp để tạo các pipeline scraping hiệu quả, tự động hóa việc trích xuất dữ liệu và giảm thiểu nhu cầu viết mã phức tạp.
Trong bài viết này, tôi sẽ giới thiệu ngắn gọn về ScrapeGraphAI và hướng dẫn bạn thiết lập pipeline đầu tiên.