
Kursus
Konsep Generative AI
2 jam
119.4K
Jika Anda pernah frustrasi menunggu respons ChatGPT, Anda akan senang mengetahui tentang Groq Language Processing Unit (LPU) Inference Engine.
Dengan Groq, Anda bisa mendapatkan jawaban atas pertanyaan Anda dengan cepat, memangkas waktu tunggu dari 40 detik menjadi hanya 2 detik.
Dalam tutorial ini, kita akan:
Jika Anda baru mengenal large language models (LLM), kami merekomendasikan mengikuti jalur keterampilan Developing Large Language Models untuk mempelajari dasar-dasar fine-tuning LLM dan membangun model Anda sendiri dari nol.
LPU (language processing unit) Inference Engine oleh Groq adalah sistem pemrosesan baru yang menangani tugas komputasi berat dengan komponen berurutan, khususnya dalam menghasilkan respons untuk large language models. Teknologi inovatif ini mengubah cara kita memproses dan menghasilkan teks, menawarkan performa dan ketepatan yang tak tertandingi.
Dibandingkan dengan central processing unit (CPU) dan graphics processing unit (GPU) tradisional, LPU memiliki kapasitas komputasi yang lebih besar. Artinya, waktu untuk memprediksi sebuah kata berkurang secara signifikan, sehingga deret teks dapat dihasilkan jauh lebih cepat. Selain itu, LPU juga mengatasi hambatan memori, keterbatasan umum pada GPU saat menangani LLM.
Groq merancang LPU untuk mengatasi tantangan seperti kerapatan komputasi, bandwidth memori, latensi rendah, dan throughput tinggi. Ini memberikan peningkatan performa yang melampaui GPU dan TPU (tensor processing unit). Misalnya, LPU dapat menghasilkan lebih dari 310 token per detik per pengguna pada Llama-3 70B.
Anda dapat mempelajari lebih lanjut tentang arsitektur LPU dengan membaca makalah riset resmi Groq ISCA 2022 Paper.
Saat ini, kita hanya dapat mengakses LLM Groq melalui groq.com, Groq Cloud API, Groq Playground, dan platform pihak ketiga seperti Poe.
Di bagian ini, kita akan mempelajari fitur dan model yang ditawarkan oleh OpenAI dan Groq Cloud. Selain itu, kita akan menguji kecepatan panggilan API menggunakan CURL dan membandingkan desain API-nya.
OpenAI API menyediakan beragam fitur dan model. Ini menawarkan:
OpenAI API cepat dan semakin murah dari waktu ke waktu.
Kita dapat mengakses model OpenAI terbaru dengan mengetik perintah berikut di terminal. API memerlukan API key OpenAI, nama model, dan messages yang berisi system prompt dan pertanyaan pengguna.
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
Permintaan tersebut selesai dalam 13 detik.
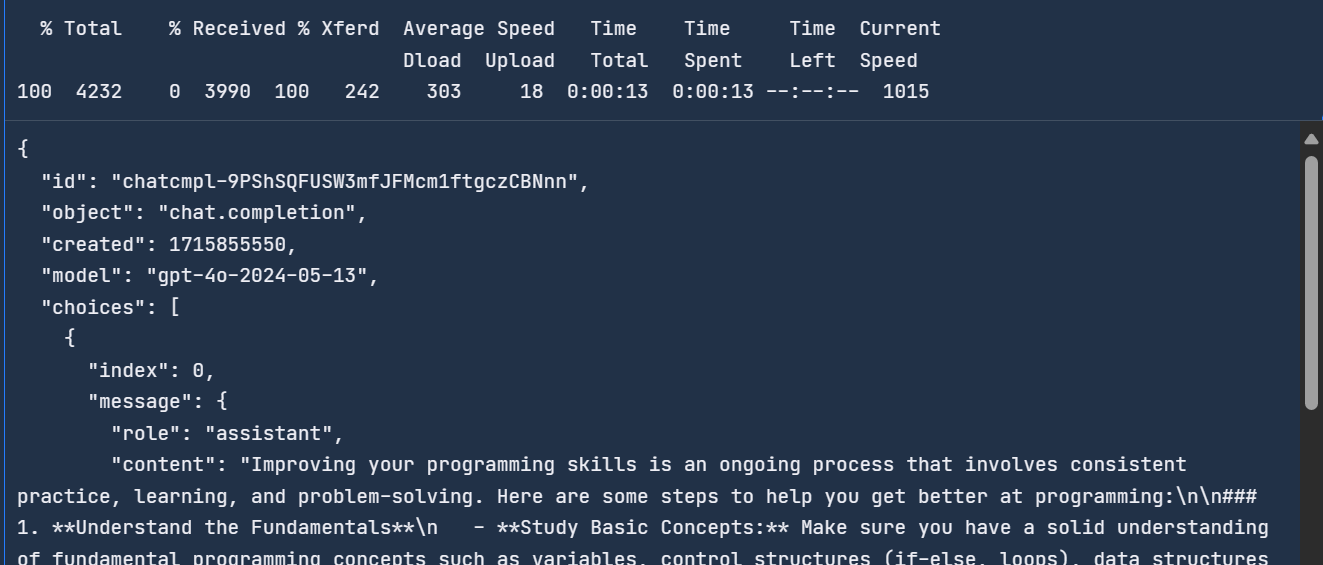
Untuk mempelajari lebih lanjut tentang API dan fitur OpenAI, lihat Panduan Pemula untuk OpenAI API: Tutorial Praktis dan Praktik Terbaik ini.
Groq masih baru di industri AI dan saat ini menawarkan fitur serta model yang terbatas. Ini menawarkan:
Groq Cloud API memberikan waktu respons yang lebih cepat dibandingkan OpenAI API. Untuk mengujinya, kita akan menggunakan perintah CURL di terminal dan memberikan pesan yang sama ke Groq API.
Groq API mirip dengan OpenAI API, satu-satunya perbedaan adalah URL-nya.
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
Dibutuhkan dua detik untuk merespons, dibandingkan OpenAI API, yang 6,5 kali lebih cepat.
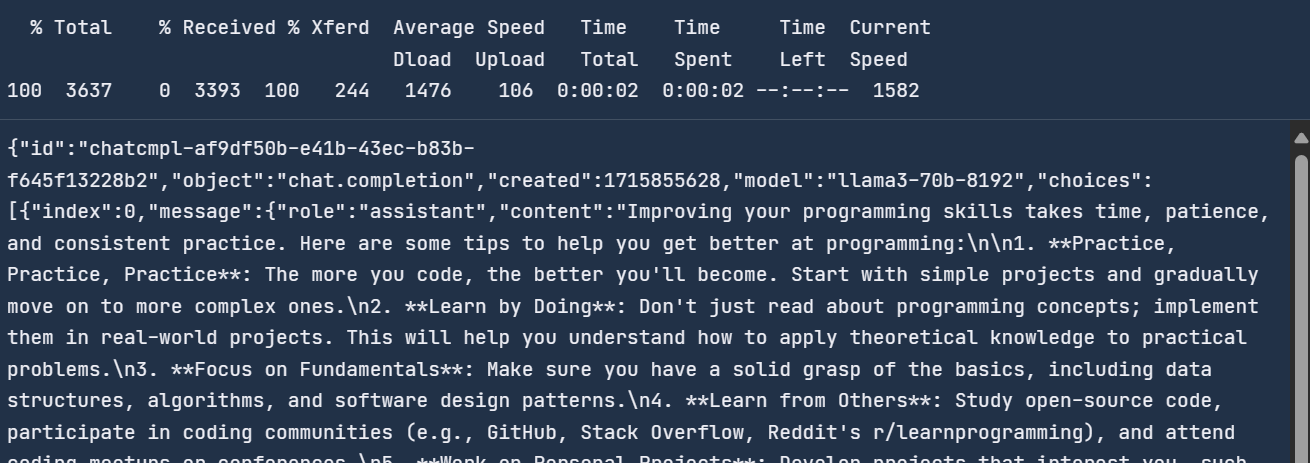
Dengan Groq, Anda mendapatkan pembuatan respons secara real time yang krusial untuk beberapa aplikasi.
Groq Cloud hadir dengan AI playground di mana Anda dapat menguji semua model dan API yang dapat Anda gunakan untuk membangun produk dan aplikasi AI.
Untuk mengakses Groq Cloud, Anda harus membuat akun terlebih dahulu melalui tautan ini.
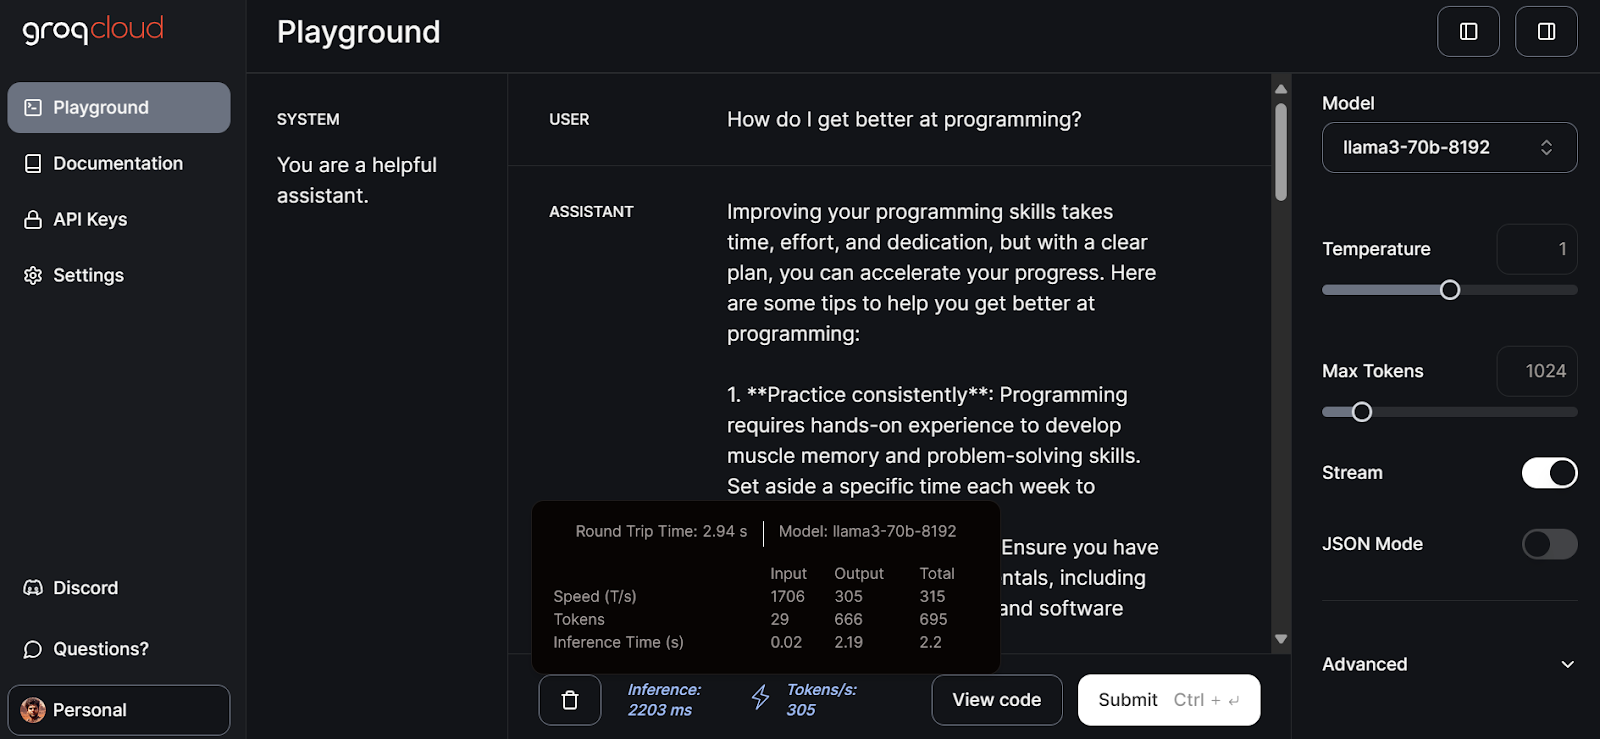
Setelah itu, klik tab playground di panel kiri, pilih model llama3-70b-8192, dan mulai menulis prompt untuk input USER.
Dibutuhkan 2,94 detik untuk menghasilkan respons penuh dengan kecepatan 305 token per detik. Ini adalah performa puncak yang tidak akan kita dapatkan dari ChatGPT.
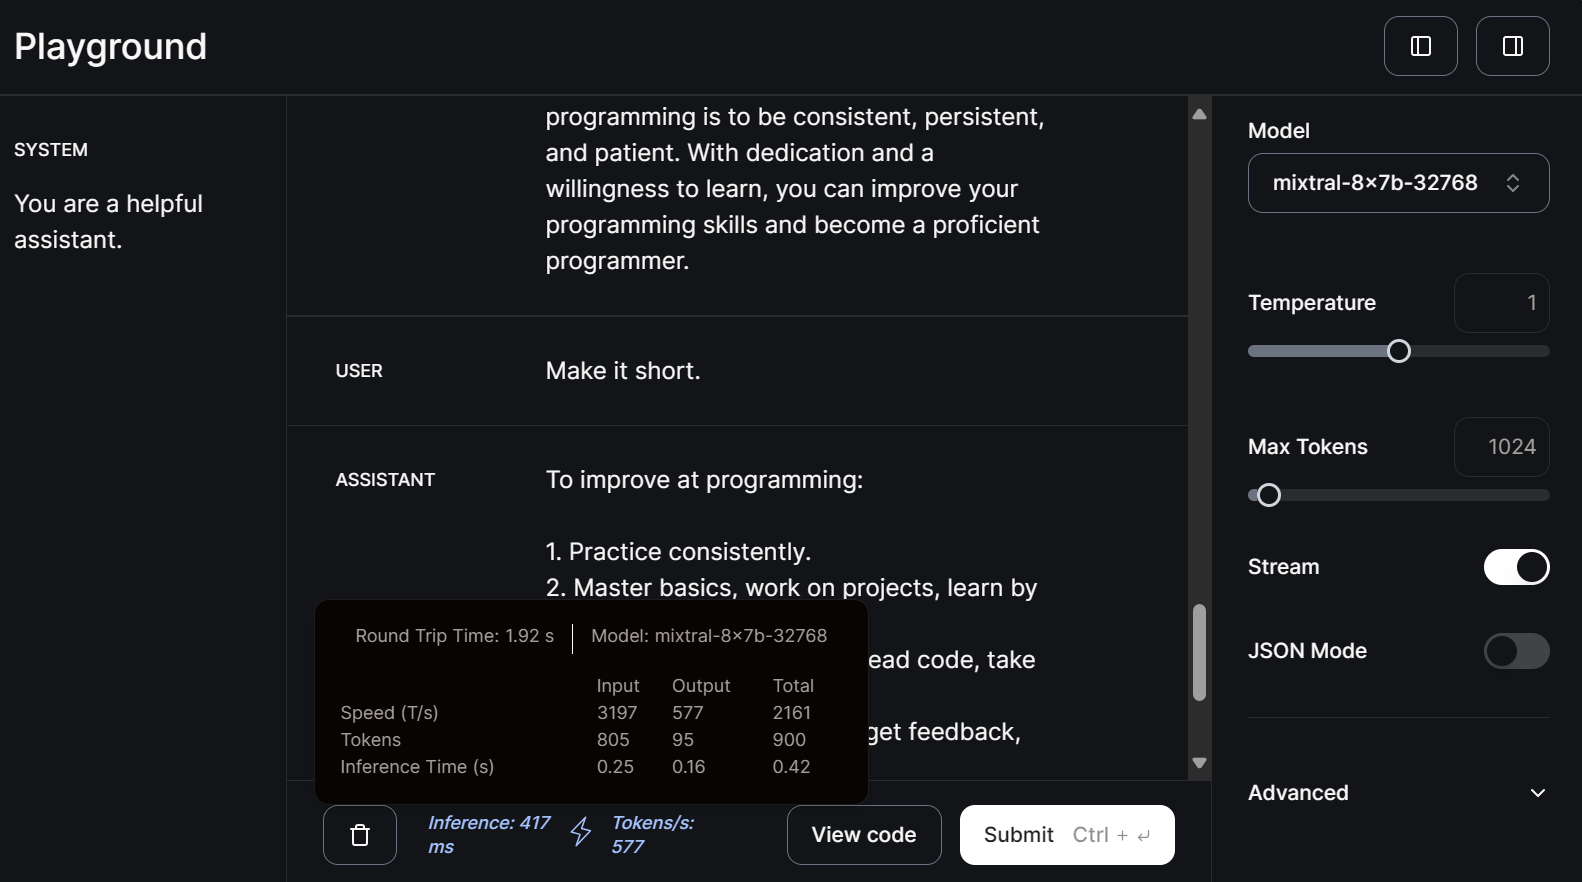
Sekarang mari kita pilih model kecil mitral-8x7b-32768 dan menulis prompt lanjutan.
Model yang lebih kecil bahkan lebih cepat menghasilkan respons dengan kecepatan 577 token per detik.
Anda dapat membaca tutorial tentang Klasifikasi LLM: Cara Memilih LLM Terbaik untuk Aplikasi Anda untuk mempelajari opsi LLM yang tersedia dan faktor yang perlu dipertimbangkan saat memilihnya.
Untuk mengakses LLM Groq secara lokal, kita harus membuat API key dengan menuju tab API Keys dan klik tombol Create API Key.
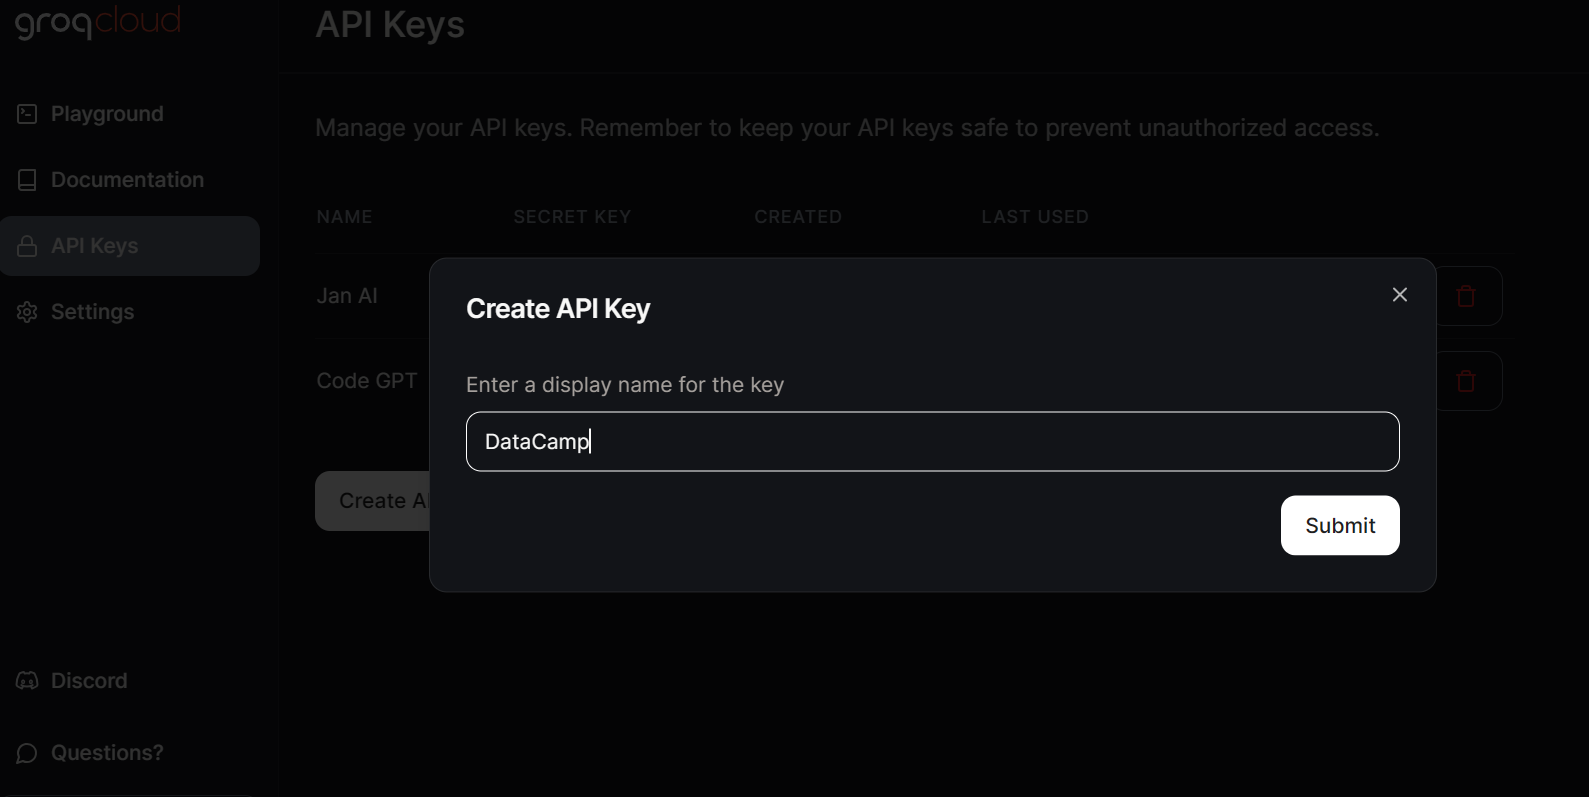
Jan AI memungkinkan kita menggunakan LLM secara lokal—baik model open-source maupun proprietari. Ini mendukung penyedia model seperti OpenAI, Anthropic, Cohere, MistralAI, dan Groq.
Kita akan mengunduh dan memasang Jan AI dengan mengunjungi situs resmi. Lalu, kita dapat meluncurkan aplikasinya.
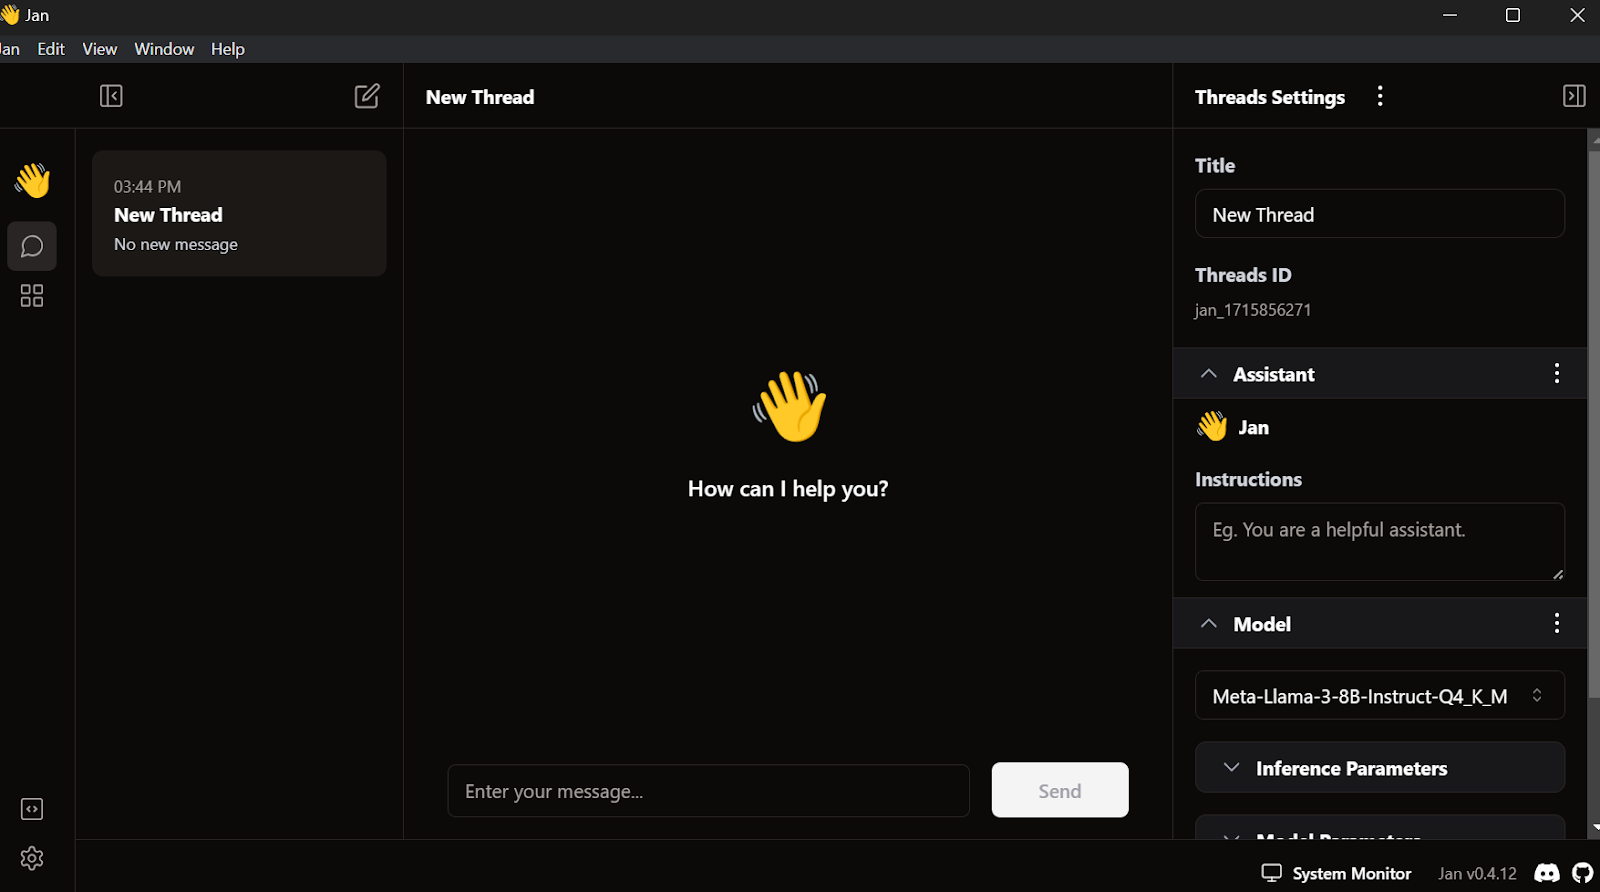
Buka pengaturan, pilih tab Groq Inference Engine, dan tempelkan API key yang baru saja kita buat.
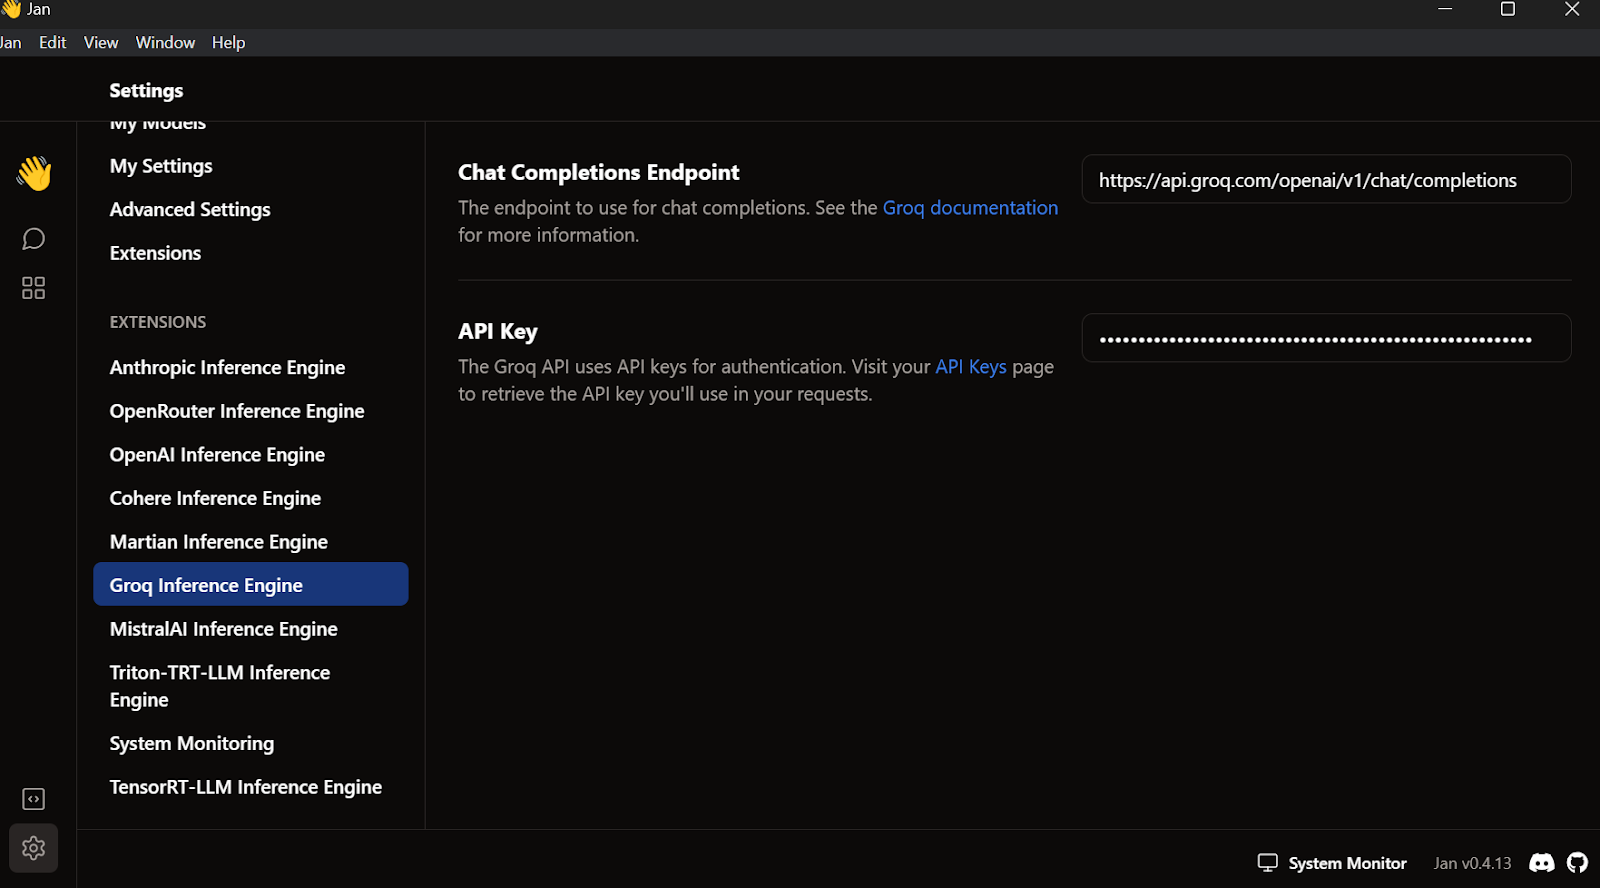
Keluar dari menu pengaturan, masuk ke Thread, dan pilih model Groq Llama 3 70b.
Tulis pertanyaan atau prompt untuk menghasilkan respons secara real time:
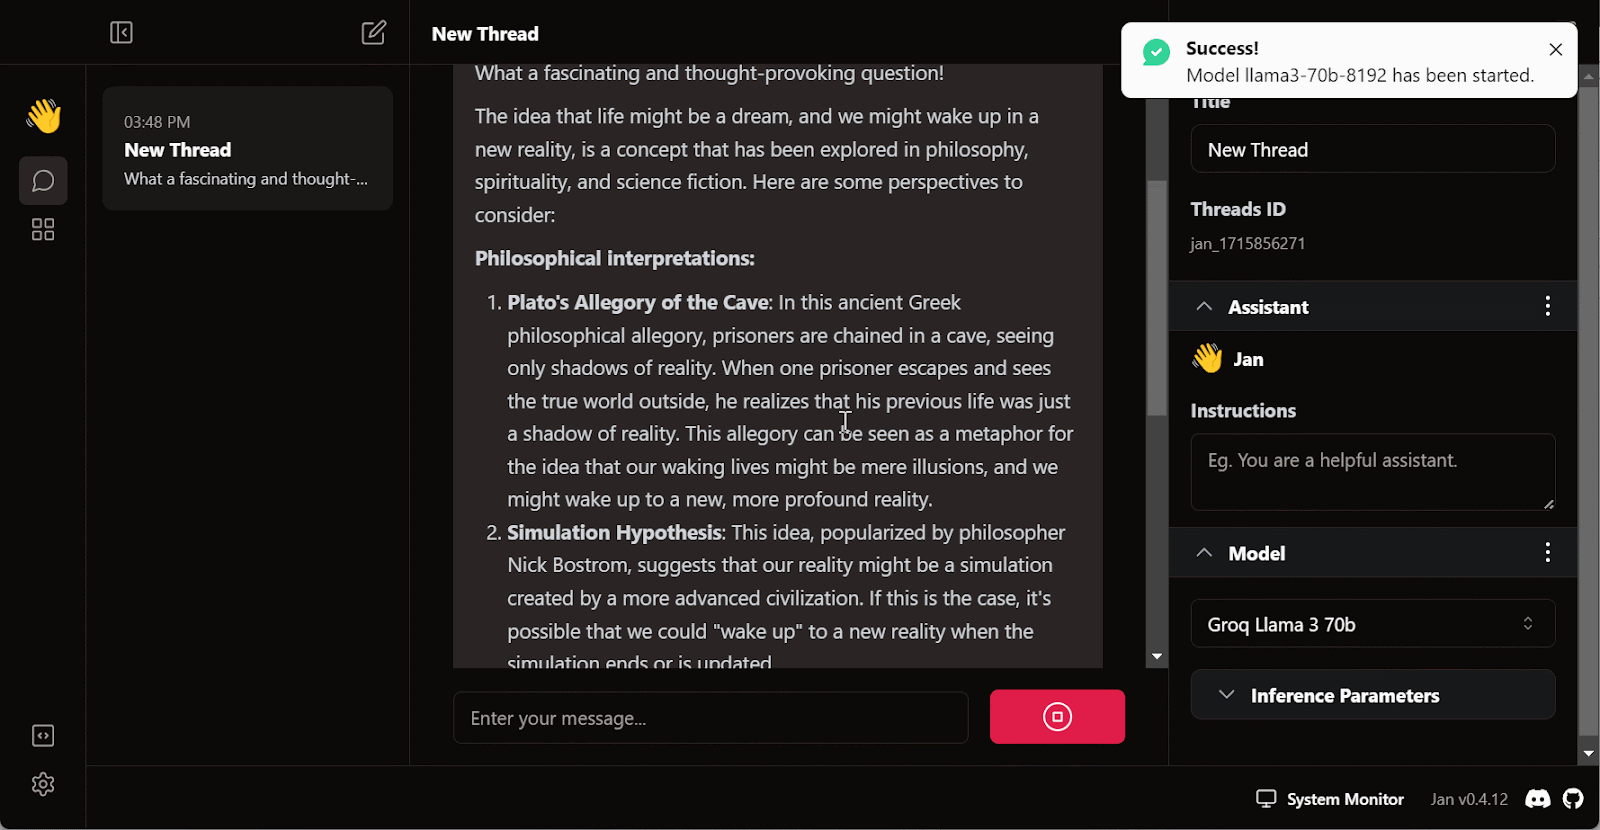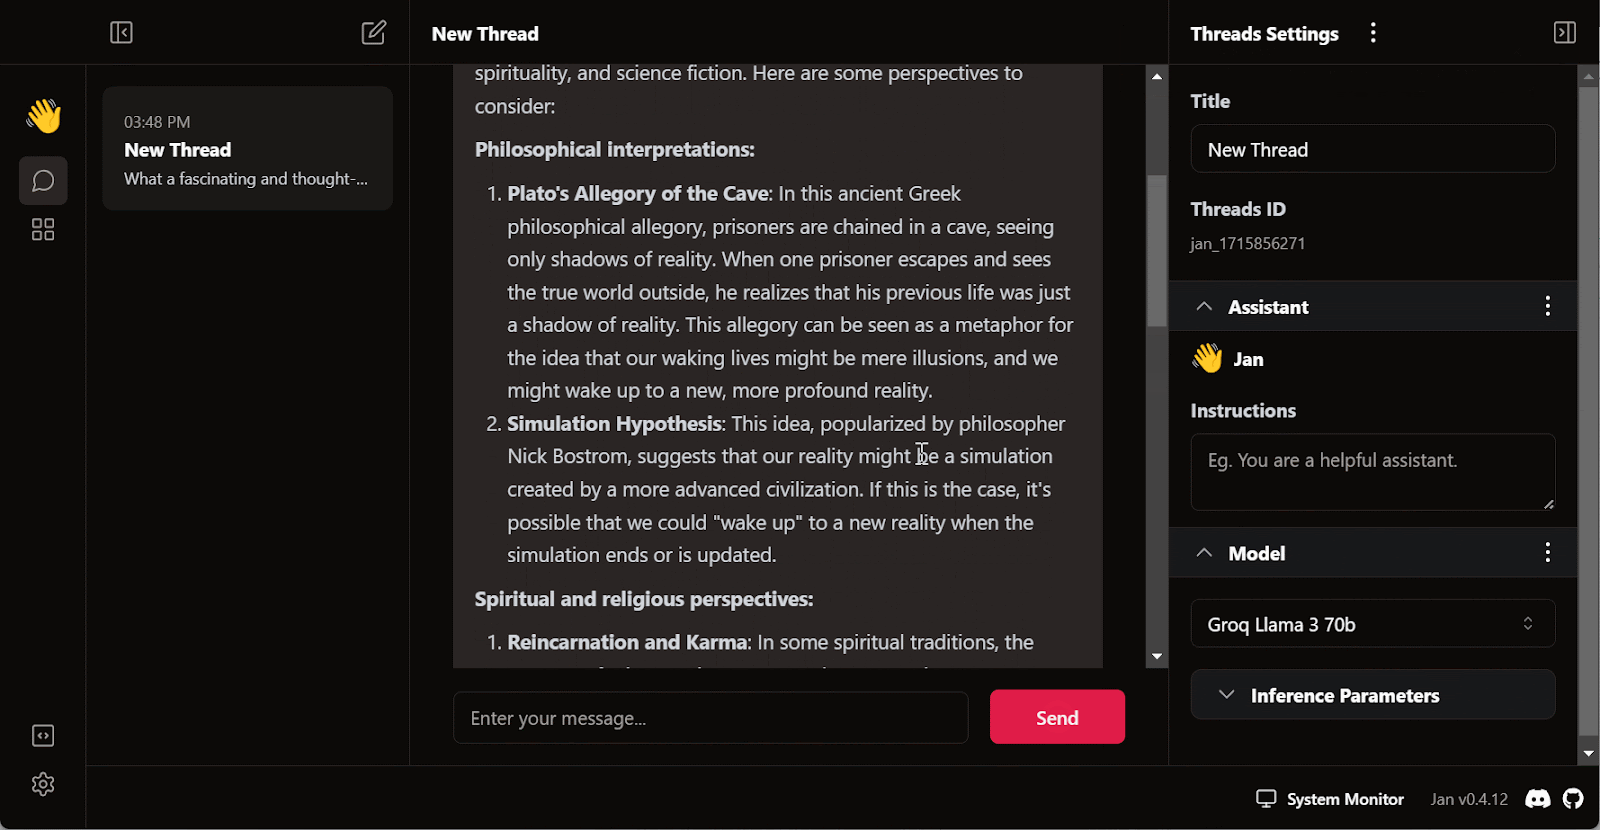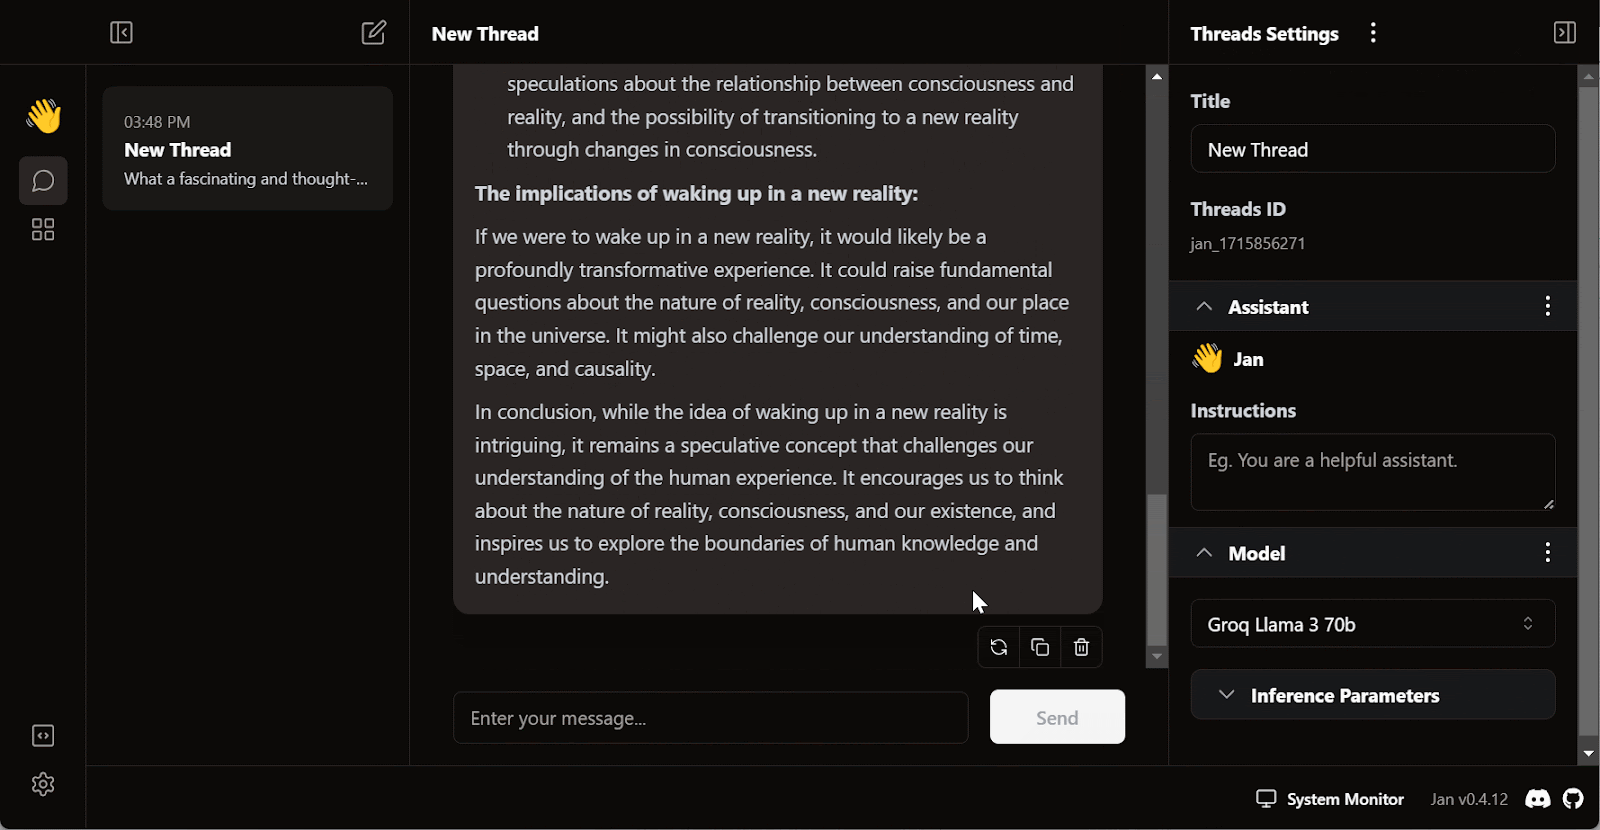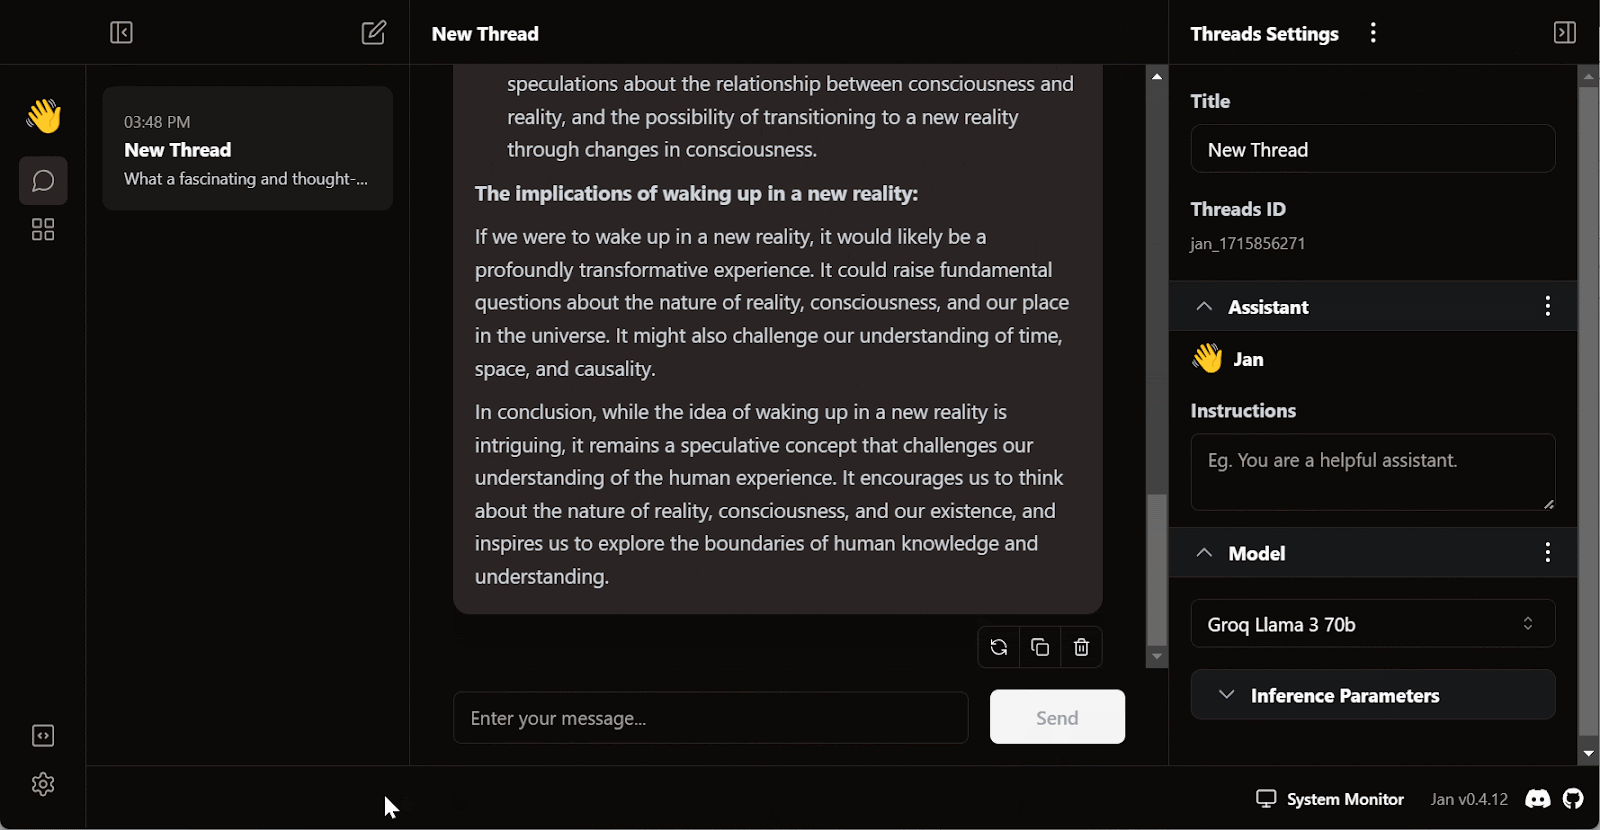
Langganan gratis untuk Groq Cloud memiliki batasan laju tertentu. Misalnya, paket llama3-70b-8192 mengizinkan 30 permintaan per menit, 14.400 permintaan per hari, dan 6.000 token per menit. Meskipun batasan ini cukup longgar, jika Anda berniat membangun aplikasi AI yang andal menggunakan Groq API, Anda mungkin perlu mempertimbangkan untuk meningkatkan ke paket On Demand atau Enterprise.
Anda dapat membaca tutorial tentang menjalankan LLM secara lokal untuk mengeksplorasi tujuh cara sederhana menjalankan aplikasi AI secara lokal.
Selain menggunakan Groq API dalam aplikasi chatbot, kita juga dapat mengintegrasikannya ke VSCode menggunakan ekstensi CodeGPT. Ini akan menjadi asisten pengkodean AI super cepat kita.
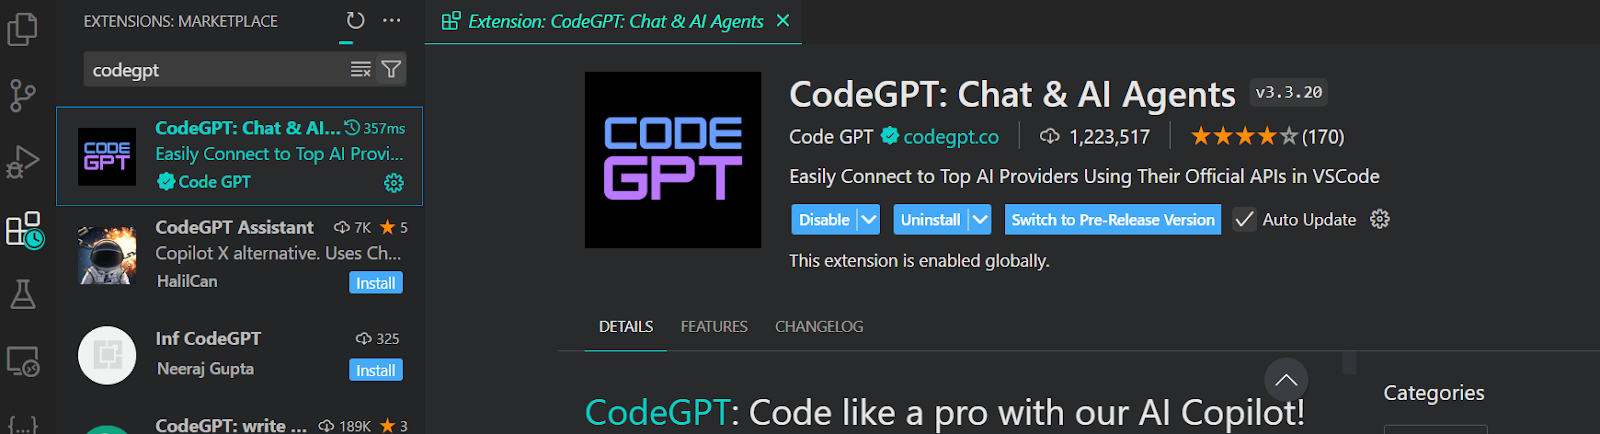
Untuk mengakses model Groq di VSCode, kita harus memasang ekstensi CodeGPT melalui marketplace ekstensi.
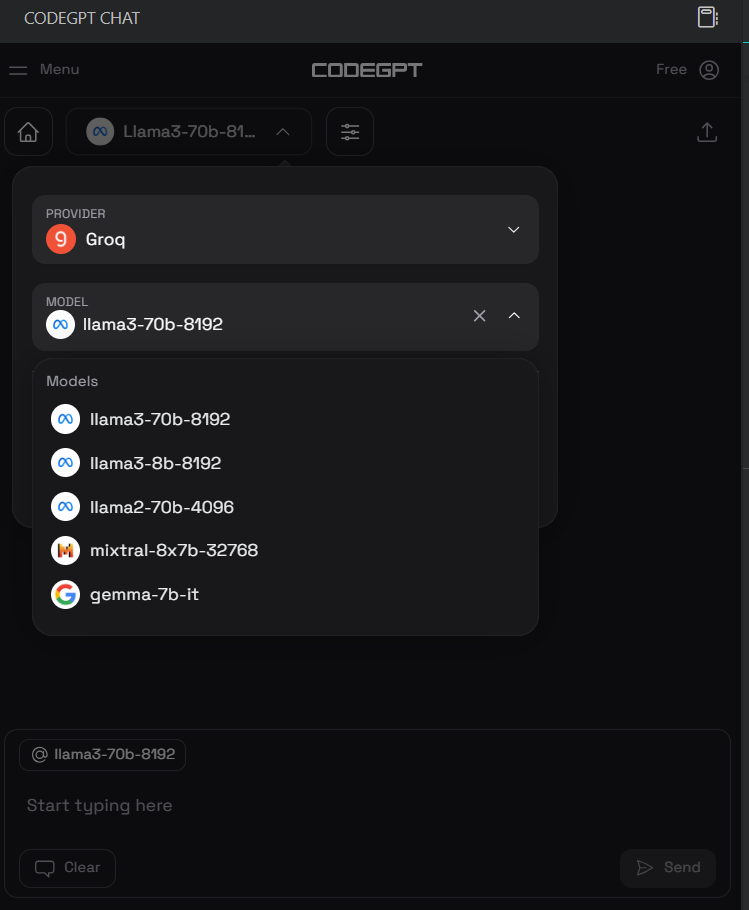
Setelah terpasang, kita akan menyiapkan Groq API key dengan mengklik ikon obrolan CodeGPT di panel kiri dan memilih penyedia serta modelnya. Kami memilih Groq sebagai penyedia dan llama3-70b-8192 sebagai model.
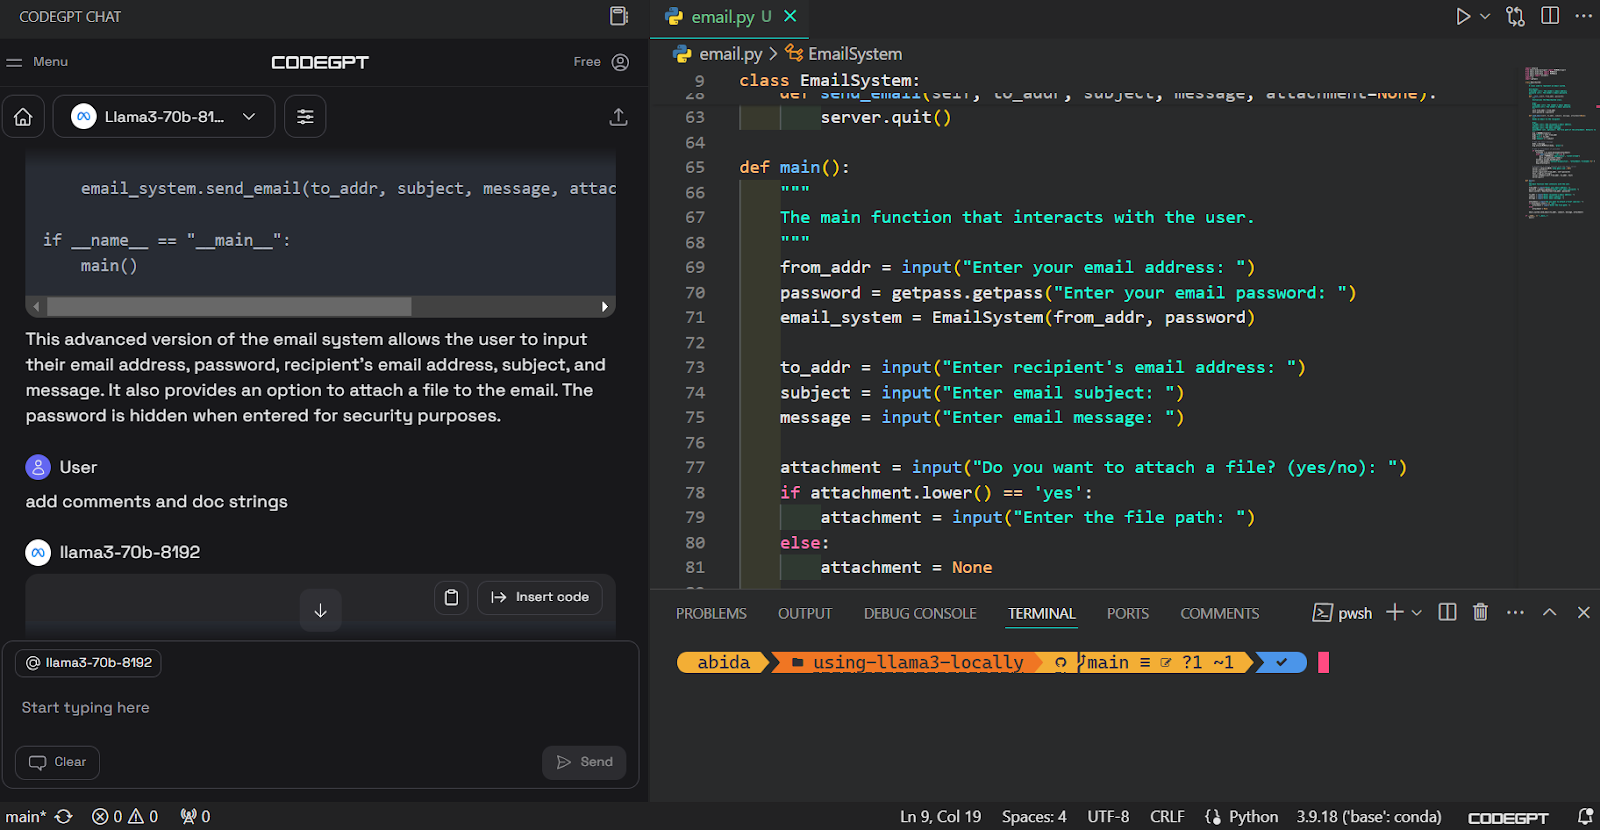
Setelah itu, kita dapat menulis prompt di kotak obrolan dan menghasilkan kode. Hanya butuh beberapa detik bagi kami untuk menghasilkan kode yang tepat dan membangun sistem email.
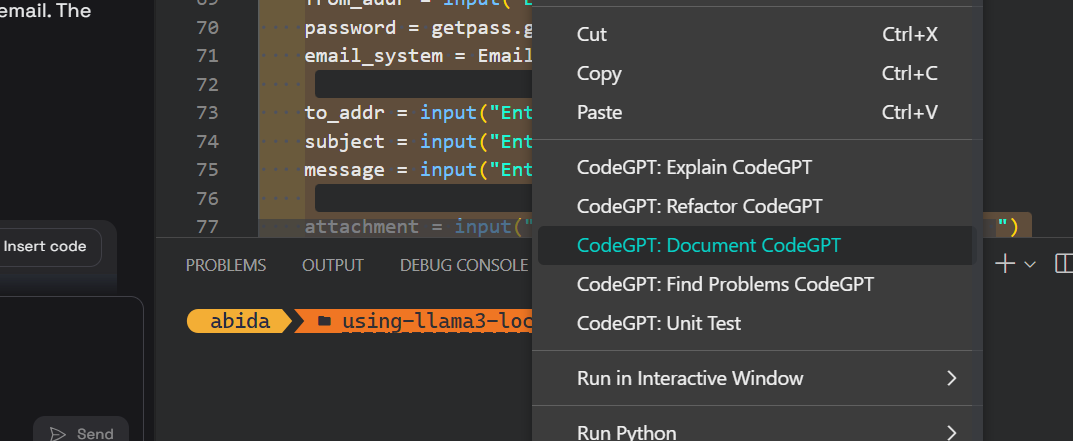
Selanjutnya, kita dapat mendokumentasikan kode, merapikannya (refactor), dan membuat unit test dengan perintah bawaan.
Anda dapat mempelajari tentang VSCode dengan membaca tutorial menyiapkan VSCode untuk Python ini.
Di bagian ini, kita akan mempelajari dasar-dasar Groq Python API dan fitur utamanya seperti streaming dan async chat completion.
Untuk panduan ini, kami menggunakan DataLab dari DataCamp. DataLab adalah AI Cloud Jupyter Notebook yang hadir dengan banyak fitur untuk menulis kode, analisis data, dan berbagi insight.
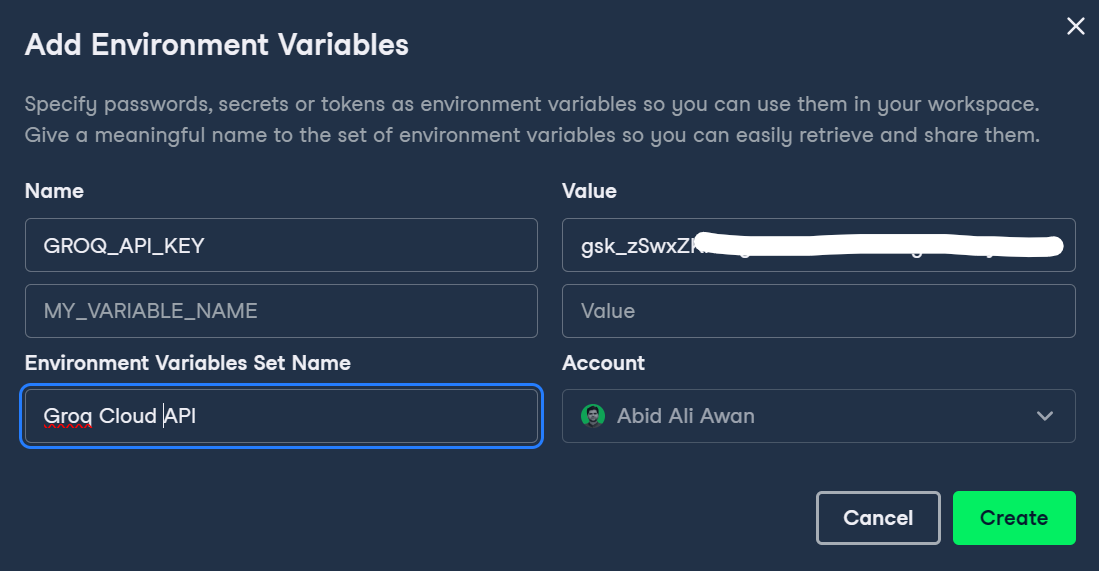
Pertama, kita harus menyiapkan Groq API key di DataLab dengan mengklik tombol Environment di panel kiri dan menambahkan variabel lingkungan dengan mengklik tombol plus +.
Kita dapat menulis nama variabel dan menempelkan Groq API key seperti di bawah ini.
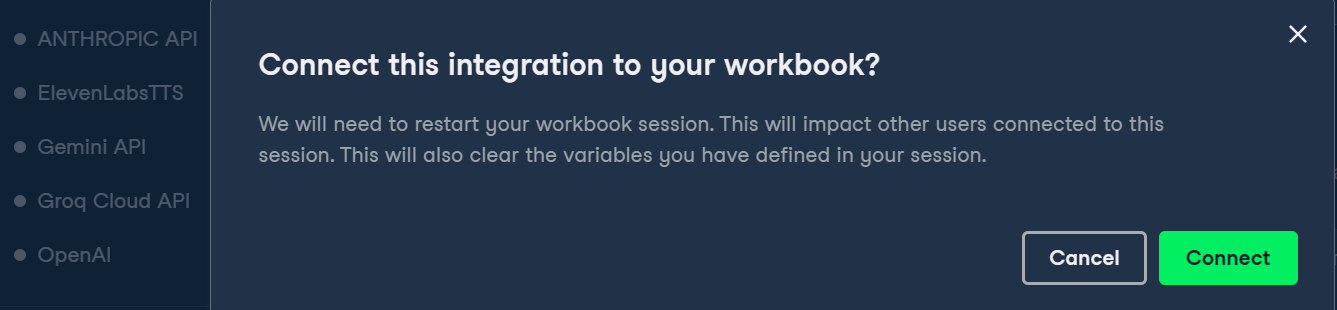
Kemudian, kita dapat mengaktifkan variabel lingkungan dengan mengklik tiga titik di samping variabel lingkungan Groq dan klik Connect.
Terakhir, kita akan memasang paket Python Groq menggunakan perintah pip.
%pip install groq -qJika Anda pernah menggunakan OpenAI Python API, Anda mungkin menemukan struktur kodenya serupa. Untuk menjalankan chat completion:
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

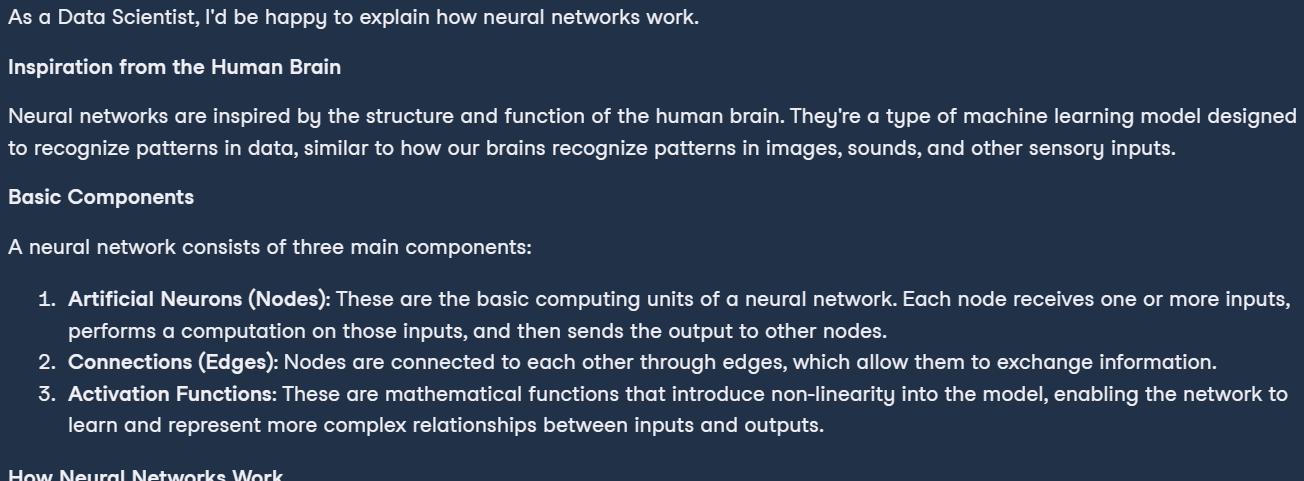
Markdown(chat_completion.choices[0].message.content)
Hasilnya, kita mendapatkan penjelasan yang terformat dengan baik tentang apa itu neural network.
Streaming pada LLM mengacu pada pemrosesan dan pembuatan teks satu token pada satu waktu, yang memungkinkan penggunaan memori yang efisien dan meningkatkan kecepatan yang dirasakan aplikasi AI.
Dalam contoh ini, kita mengaktifkan streaming dan menyesuaikan model dengan mengubah hiperparameter seperti temperature, max_tokens, dan top_p.
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
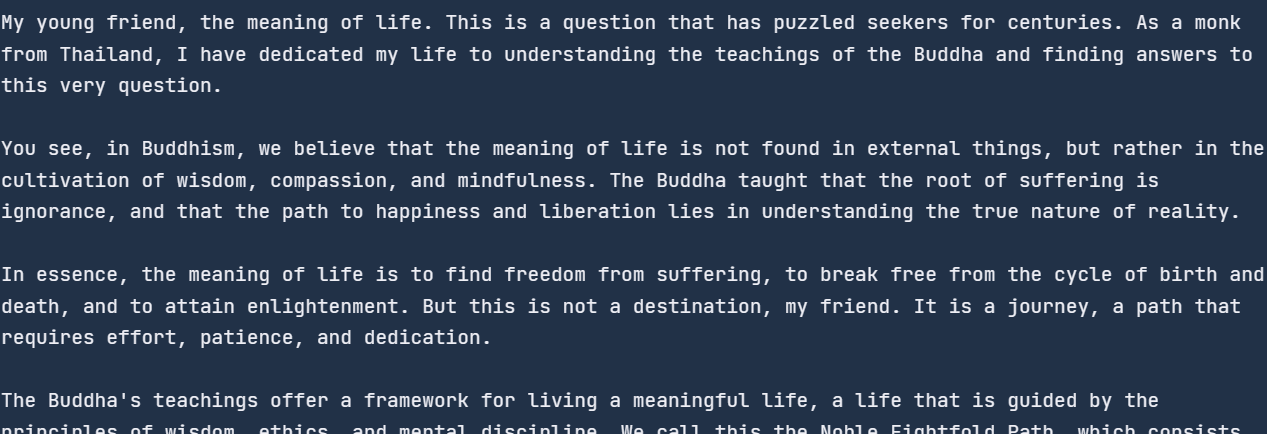
    print(chunk.choices[0].delta.content, end="")
Hasilnya, kita mulai menerima respons segera setelah menjalankan kode ini.
API asinkron memungkinkan penanganan beberapa permintaan secara bersamaan tanpa blocking, sehingga sistem dapat memproses dan merespons setiap permintaan secara mandiri. Pendekatan ini lebih efisien dan skalabel karena dapat menangani volume permintaan yang lebih besar dan memberikan waktu respons yang lebih cepat.
Untuk mengaktifkan pemanggilan API async, kita harus mengubah struktur kode. Kita:
Sebagai catatan, kode di bawah ini berfungsi di Jupyter Notebook, tetapi jika Anda menjalankannya di berkas Python, Anda mungkin harus mengganti baris terakhir dengan asyncio.run(main()).
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())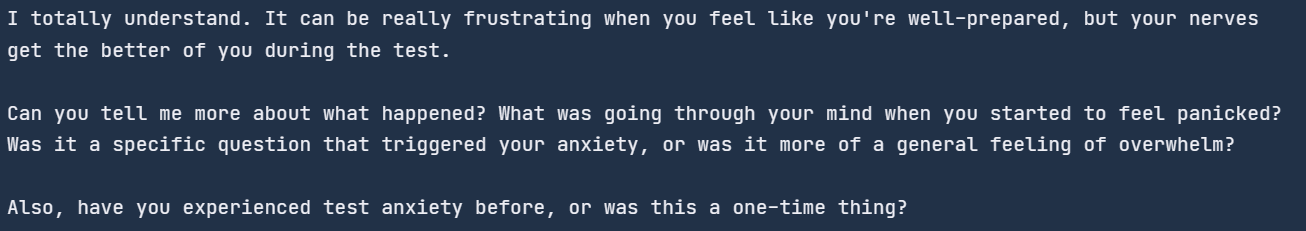
Kita juga dapat melakukan streaming API async dengan mengaktifkan argumen stream di fungsi chat completion dan mengubah cara kita mencetak hasilnya. Kita akan mencetak setiap potongan menggunakan for loop dengan perintah async.
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())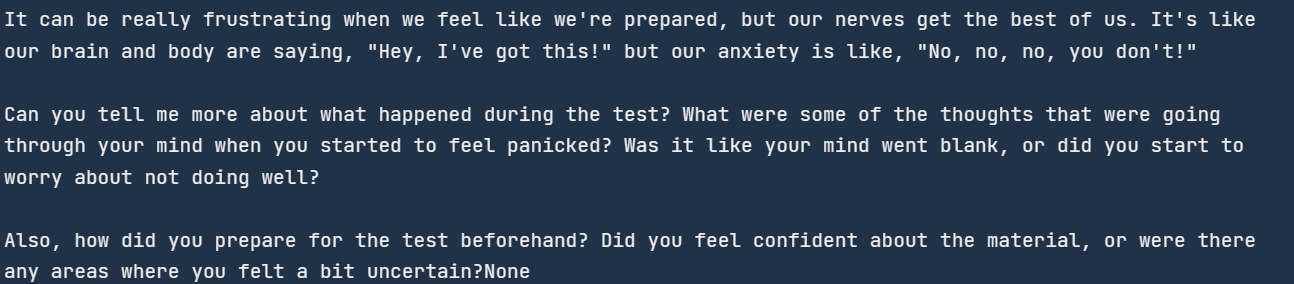
Jika Anda mengalami kesulitan menjalankan kode, silakan merujuk ke notebook DataLab ini: Groq Cloud API.
Dalam panduan ini, kita akan melangkah lebih jauh dan belajar membangun aplikasi AI menggunakan Groq API dan LlamaIndex, yang merupakan kerangka kerja LLM. Kita akan membangun aplikasi yang akan memuat teks dari file PDF, mengonversinya menjadi embedding, dan menyimpannya ke dalam vector store. Setelah itu, kita akan mengonversi vector store menjadi retriever yang akan digunakan untuk membangun mesin obrolan RAG dengan histori.
Singkatnya, kita membangun aplikasi ChatPDF yang peka konteks untuk membantu Anda memahami dokumen jauh lebih cepat.
Untuk mempelajari cara mengimpor, mengelola, dan mengambil data privat serta data spesifik domain menggunakan bahasa alami, lihat tutorial ini: LlamaIndex: Kerangka Data untuk Large Language Models (LLM).
Pertama, kita akan memasang semua Paket Python yang diperlukan menggunakan pip. Kita menggunakan fungsi magic %%capture untuk menyembunyikan log.
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfaceKita akan membuat klien Groq LLM menggunakan fungsi llama_index. Klien LLM memerlukan nama model dan API key.
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))Sekarang kita akan mengunduh dan memuat model embedding Hugging Face menggunakan LlamaIndex embeddings API.
Dalam kasus kami, kami memuat model embedding paling populer di Hugging Face bernama mxbai-embed-large-v1.
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")LlamaIndex memungkinkan kita menetapkan konfigurasi global, sehingga tidak perlu meneruskan objek LLM atau model embedding ke mana-mana.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelUntuk datanya, kami menggunakan posting blog 14 Essential Data Engineering Tools to Use in 2024 dan mengonversinya menjadi PDF menggunakan perintah print.
Dengan fungsi SimpleDirectoryReader, Anda dapat memuat berbagai jenis dokumen dari folder. Cukup berikan direktori folder dan ekstensi file yang diperlukan.
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex menyediakan cara tercepat untuk membuat vector store dengan memuat dokumen dan membangun indeks. Indeks dapat digunakan untuk query engine, retriever, dan query pipeline.
Dalam kasus kita, kita membuat indeks dengan menyediakan dokumen ke vector store, yang akan mengonversi teks menjadi embedding dan kemudian menyimpannya di vector store.
Setelah itu, kita akan mengonversi indeks menjadi query engine untuk melakukan RAG dasar (retrieval augmented generation), yang menggabungkan retrieval dan model AI untuk menghasilkan jawaban yang peka konteks.
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
Sekarang kita akan membuat mesin chat RAG dengan histori. Menambahkan histori akan memungkinkan mesin chat mengingat pesan pengguna dan respons yang dihasilkan, serta memberikan jawaban yang peka konteks.
Untuk membangun aplikasi ini, kita perlu membuat ChatMemoryBuffer sebesar 3900 token dan memberikannya ke mesin chat bersama dengan retriever dan objek LLM.
Saat Anda mengajukan pertanyaan, mesin chat akan menggunakan dokumen PDF dan pesan sebelumnya sebagai konteks dan merespons sesuai.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))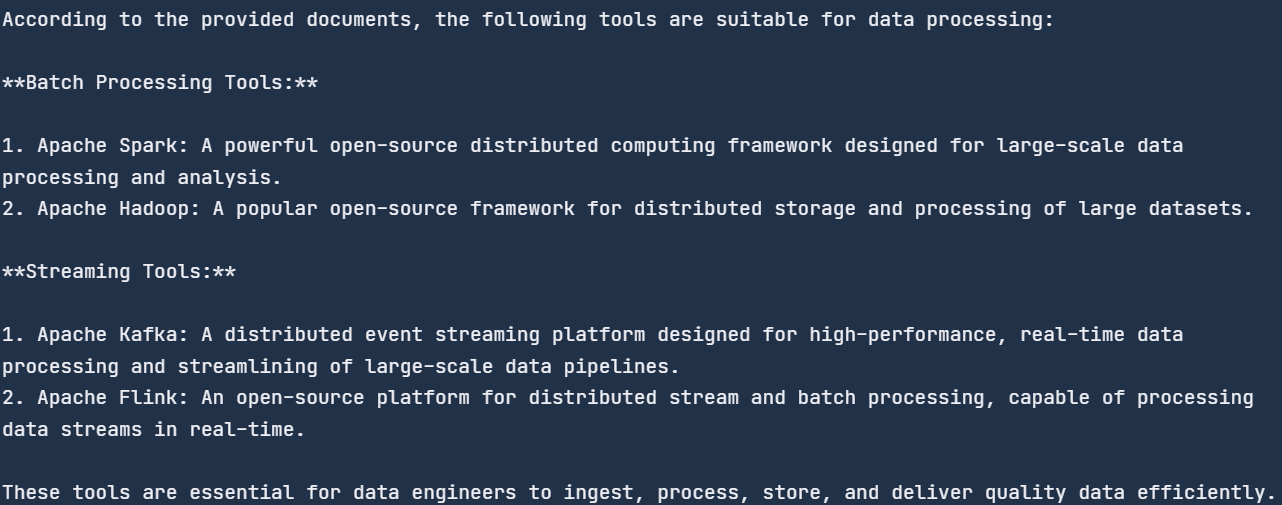
Kami mengajukan pertanyaan umum, dan mesin tersebut menelusuri dokumen untuk alat pemrosesan data dan memberikan daftar kepada kami. Semua alat tersebut disebutkan dalam blog.
Mari ajukan pertanyaan lanjutan untuk menguji bagian memori dari mesin chat.
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))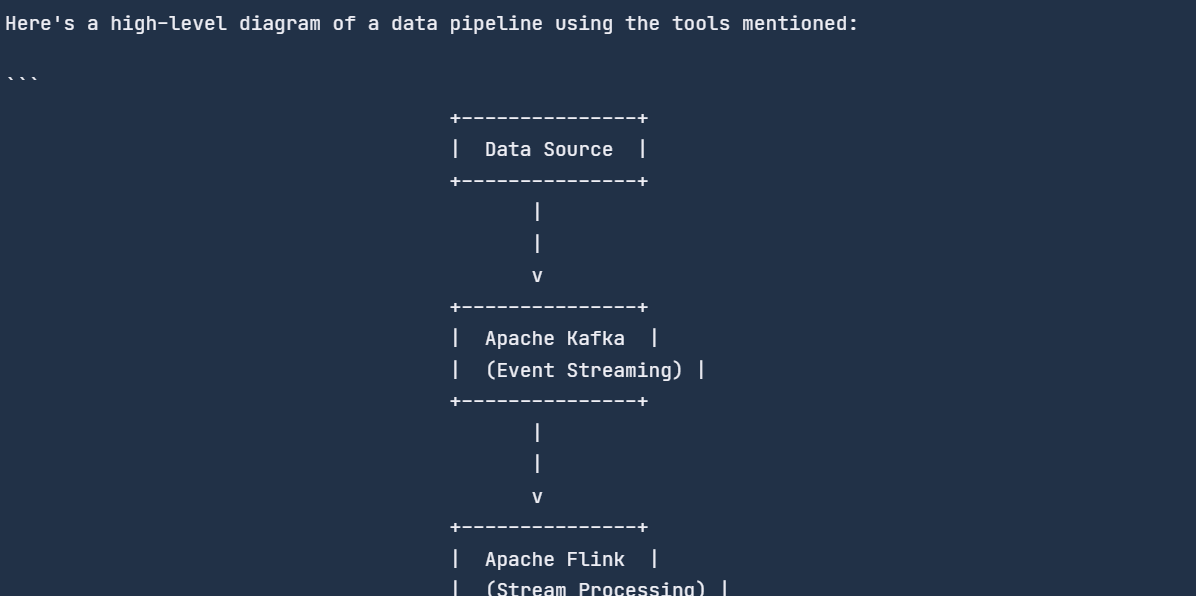
Mesin chat mengingat percakapan sebelumnya dan merespons sesuai.
Seluruh kode yang kami gunakan tersedia di notebook DataLab ini: Groq Cloud API — DataLab.
Groq LPU inference engine adalah pengubah permainan di bidang AI. Sementara para pemain besar seperti OpenAI dan Google berfokus mengembangkan LLM berkualitas tinggi, Groq membuat model-model ini menjadi lebih cepat. Meski masih baru di ranah AI, Groq membuat gebrakan signifikan di komunitas AI.
Dalam blog ini, kita telah mempelajari Groq LPU inference engine, menjelajahi Groq Cloud, dan mengintegrasikan Groq API ke VSCode dan aplikasi Jan AI. Selain itu, kita telah membahas paket Python Groq dengan contoh kode dan mempelajari cara membangun aplikasi AI yang peka konteks yang dapat belajar dari histori chat dan dokumen PDF.
Langkah selanjutnya yang mungkin dalam perjalanan belajar Anda adalah melakukan fine-tuning LLM pada dataset kustom. Anda dapat mempelajari caranya dengan mengikuti tutorial ini: Fine Tuning Google Gemma: Meningkatkan LLM dengan Instruksi yang Disesuaikan.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




