Curso
Implementação de Soluções de IA nos Negócios
2 h
54.8K
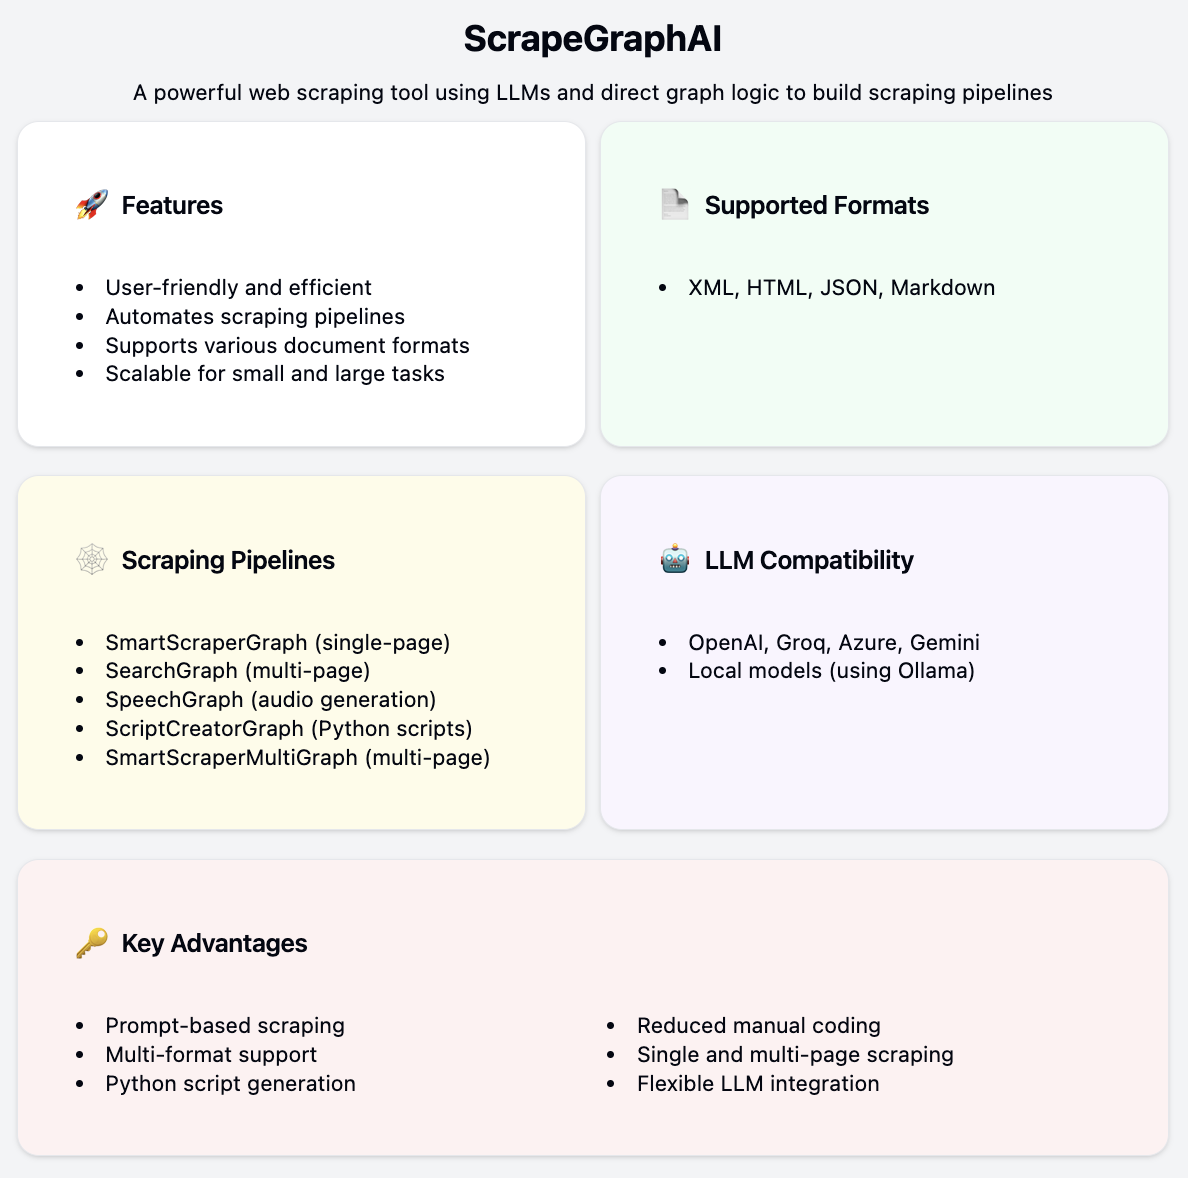
ScrapeGraphAI é uma ferramenta poderosa de web scraping que usa LLMs e lógica de grafos direta para construir pipelines de scraping.
Ela consegue extrair informações de sites e de vários formatos de documentos locais, como XML, HTML, JSON e Markdown.
O ScrapeGraphAI foi pensado para ser prático e eficiente. Você só precisa dizer que informação quer e o ScrapeGraphAI faz o resto. Ele automatiza a criação de pipelines de scraping a partir de prompts do usuário, reduzindo a necessidade de codificação manual.
A ferramenta suporta diversos formatos de documentos e pode se integrar a diferentes LLMs via APIs. É escalável, oferecendo scraping de página única e multipágina, o que a torna adequada tanto para tarefas pequenas quanto para extração de dados em larga escala.
Por fim, é compatível com vários provedores de LLMs como OpenAI, Groq, Azure e Gemini, além de modelos locais com Ollama.
O ScrapeGraphAI inclui vários tipos de pipelines de scraping:
O ScrapeGraphAI simplifica a configuração e a execução de tarefas de extração de dados de sites e documentos locais. Veja como instalar rapidamente a biblioteca e criar um aplicativo básico de scraping.
Para instalar o ScrapeGraphAI, execute:
pip install scrapegraphaiVamos criar um pipeline simples usando o SmartScraperGraph. Primeiro, vou descrever as etapas e, em seguida, apresentar o código.
Especifique quais informações você quer extrair. Neste exemplo, vamos extrair todos os títulos de artigos e URLs da minha newsletter no Substack The Limitless Playbook 🧬.
Selecione o pipeline apropriado. Para uma única página, usaremos o SmartScraperGraph. Fique à vontade para explorar outros pipelines para diferentes casos de uso.
Execute o pipeline usando o método .run() para extrair os dados.
Valide os dados extraídos. LLMs são poderosos, mas podem não acertar de primeira. Ajuste o prompt conforme necessário para chegar ao resultado desejado.
Aqui está o trecho de código completo que cobre as etapas descritas acima:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "gpt-3.5-turbo-0125",
        "temperature": 0,
    },
    "verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
    prompt="List me all the articles with their respective urls",
    source="<https://ryanocm.substack.com/archive>",
    config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
    json.dump(articles_data, json_file, indent=4)
E aqui estão os resultados finais. Nada mal, né?
{
    "articles": [
        {
            "title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
            "url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
        },
        {
            "title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
            "url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
        },
        {
            "title": "#110 | How to process past fights in relationships",
            "url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
        },
        {
            "title": "#109 | AI x Crypto(graphy)",
            "url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
        },
        {
            "title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
            "url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
        },
        {
            "title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
        },
        {
            "title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
            "url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
        },
        {
            "title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
            "url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
        },
        {
            "title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
        },
        {
            "title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
            "url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
        },
        {
            "title": "#102 | 7 Principles to Writing Well",
            "url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
        },
        {
            "title": "#101 | How to Remember More from Books",
            "url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
        }
    ]
}O ScrapeGraphAI simplifica e automatiza o scraping de sites e documentos, deixando a extração de dados mais fácil e rápida. Sua compatibilidade com vários LLMs e formatos de documentos o torna uma ferramenta versátil para todo tipo de tarefa com dados. Com o ScrapeGraphAI, você pode focar em analisar e usar seus dados, e não em coletá-los.
Para saber mais, confira estes recursos:
E, por fim, use o ScrapeGraphAI com responsabilidade e fique atento às regras de scraping dos sites que você pretende acessar. Sempre siga os termos de uso e as diretrizes legais para web scraping.
Aprenda IA com estes cursos!
Curso
Curso
Curso
blog
Javier Canales Luna
9 min
blog
DataCamp Team
4 min
blog
Adel Nehme
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Tutorial
Abid Ali Awan
12 min