Kurs
KI-Lösungen im Unternehmen implementieren
2 Std.
54.8K
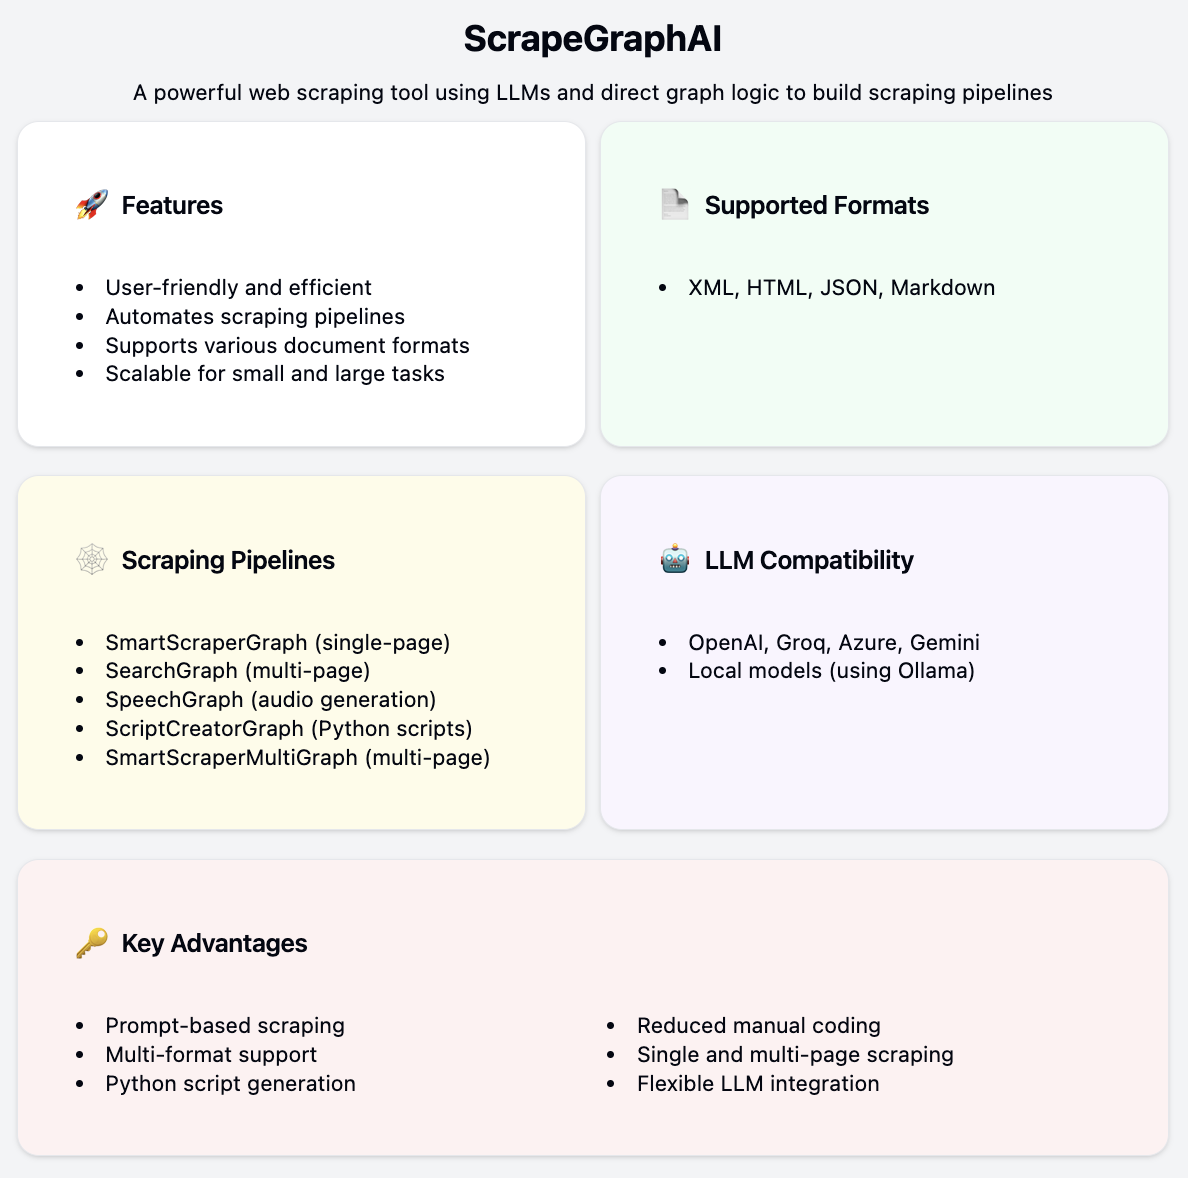
ScrapeGraphAI ist ein leistungsstarkes Webscraping-Tool, das große Sprachmodelle (LLMs) und direkte Graph-Logik nutzt, um Scraping-Pipelines zu erstellen.
Es kann Informationen von Websites sowie aus verschiedenen lokalen Dokumentformaten wie XML, HTML, JSON und Markdown extrahieren.
ScrapeGraphAI ist benutzerfreundlich und effizient. Du gibst einfach an, welche Informationen du benötigst, und ScrapeGraphAI übernimmt den Rest. Die Erstellung der Scraping-Pipelines wird auf Basis deiner Prompts automatisiert, wodurch du kaum noch manuell coden musst.
Das Tool unterstützt verschiedene Dokumentformate und lässt sich über APIs mit unterschiedlichen LLMs integrieren. Es ist skalierbar und bietet Single-Page- sowie Multi-Page-Scraping – ideal für kleine wie große Extraktionsaufgaben.
Außerdem ist es mit mehreren LLM-Anbietern kompatibel, etwa OpenAI, Groq, Azure und Gemini sowie mit lokalen Modellen über Ollama.
ScrapeGraphAI bietet mehrere Arten von Scraping-Pipelines:
ScrapeGraphAI vereinfacht das Einrichten und Ausführen von Datenextraktionen aus Websites und lokalen Dokumenten. So installierst du die Bibliothek schnell und baust eine einfache Scraping-Anwendung.
Für die Installation führe Folgendes aus:
pip install scrapegraphaiWir bauen eine einfache Scraping-Pipeline mit SmartScraperGraph. Zuerst beschreibe ich die Schritte, dann folgt der Code.
Lege fest, welche Informationen du extrahieren willst. Im Beispiel ziehen wir alle Artikeltitel und URLs aus meinem eigenen Substack-Newsletter The Limitless Playbook 🧬.
Wähle die passende Pipeline. Für eine einzelne Seite nutzen wir SmartScraperGraph. Fühle dich frei, weitere Pipelines für andere Anwendungsfälle auszuprobieren.
Starte die Pipeline mit der Methode .run(), um die Daten zu extrahieren.
Prüfe die extrahierten Daten. LLMs sind mächtig, liefern anfangs aber nicht immer perfekte Ergebnisse. Passe den Prompt bei Bedarf an, um das gewünschte Ergebnis zu erhalten.
Hier ist das komplette Codebeispiel, das die oben skizzierten Schritte abdeckt:
import json
import nest_asyncio
nest_asyncio.apply()
from scrapegraphai.graphs import SmartScraperGraph
# Define the configuration for the scraping pipeline
OPENAI_API_KEY = "YOUR_OPENAI_API_KEY"
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "gpt-3.5-turbo-0125",
        "temperature": 0,
    },
    "verbose": True,
}
# Create the SmartScraperGraph instance
smart_scraper_graph = SmartScraperGraph(
    prompt="List me all the articles with their respective urls",
    source="<https://ryanocm.substack.com/archive>",
    config=graph_config
)
# Run the pipeline
articles_data = smart_scraper_graph.run()
# Save the result to a JSON file
with open('articles_data.json', 'w') as json_file:
    json.dump(articles_data, json_file, indent=4)
Und so sehen die finalen Ergebnisse aus. Ziemlich gut, oder?
{
    "articles": [
        {
            "title": "#112 | I Built an AI Tool to Help You Learn More and Take Action Faster",
            "url": "<https://ryanocm.substack.com/p/112-i-built-an-ai-tool-to-help-you>"
        },
        {
            "title": "#111 | Don't Fight When You Are Getting Flooded \\ud83c\\udf0a",
            "url": "<https://ryanocm.substack.com/p/111-dont-fight-when-you-are-getting>"
        },
        {
            "title": "#110 | How to process past fights in relationships",
            "url": "<https://ryanocm.substack.com/p/110-how-to-process-past-fights-in>"
        },
        {
            "title": "#109 | AI x Crypto(graphy)",
            "url": "<https://ryanocm.substack.com/p/109-ai-x-cryptography>"
        },
        {
            "title": "#108 | How to Love Intentionally \\u2764\\ufe0f",
            "url": "<https://ryanocm.substack.com/p/108-how-to-love-intentionally>"
        },
        {
            "title": "#107 | 16 Questions To Better Understand Who You Are \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/107-16-questions-to-better-understand>"
        },
        {
            "title": "#106 | Three Types of Burnouts \\ud83e\\udd15",
            "url": "<https://ryanocm.substack.com/p/106-three-types-of-burnouts>"
        },
        {
            "title": "#105 | The Bagel Method in Relationships \\ud83e\\udd6f",
            "url": "<https://ryanocm.substack.com/p/105-the-bagel-method-in-relationships>"
        },
        {
            "title": "#104 | The 8 Play Personalities \\ud83c\\udfad",
            "url": "<https://ryanocm.substack.com/p/104-the-8-play-personalities>"
        },
        {
            "title": "#103 | The Top Ten Myths About Conflict by Relationship Experts Julie and John Gottman",
            "url": "<https://ryanocm.substack.com/p/103-the-top-ten-myths-about-conflict>"
        },
        {
            "title": "#102 | 7 Principles to Writing Well",
            "url": "<https://ryanocm.substack.com/p/102-7-principles-to-writing-well>"
        },
        {
            "title": "#101 | How to Remember More from Books",
            "url": "<https://ryanocm.substack.com/p/101-how-to-remember-more-from-books>"
        }
    ]
}ScrapeGraphAI vereinfacht und automatisiert Web- und Dokumentenscraping, sodass du Daten schneller und einfacher extrahieren kannst. Dank der Kompatibilität mit verschiedenen LLMs und Dokumentformaten ist es ein vielseitiges Tool für unterschiedlichste Datenaufgaben. Mit ScrapeGraphAI kannst du dich auf die Analyse und Nutzung deiner Daten konzentrieren – statt auf das Sammeln.
Mehr dazu findest du hier:
Nutze ScrapeGraphAI verantwortungsvoll und beachte die Scraping-Regeln der Zielseiten. Halte dich stets an Nutzungsbedingungen und rechtliche Vorgaben.
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs