
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
LLM sangat kuat, tetapi sering kali agak lambat, dan ini tidak ideal pada skenario yang membutuhkan kecepatan. Speculative decoding adalah teknik yang dirancang untuk mempercepat LLM dengan menghasilkan respons lebih cepat tanpa mengorbankan kualitas.
Intinya, ini adalah cara untuk “menduga di depan” dalam proses generasi teks, membuat prediksi tentang kata-kata yang mungkin muncul berikutnya sambil tetap menjaga akurasi dan kedalaman yang kita harapkan dari LLM.
Dalam blog ini, saya akan menjelaskan apa itu speculative decoding, cara kerjanya, dan cara mengimplementasikannya dengan model Gemma 2.
Speculative decoding mempercepat LLM dengan memasukkan model yang lebih kecil dan lebih cepat untuk menghasilkan prediksi awal. Model kecil ini, sering disebut model “draft”, menghasilkan satu batch token yang dapat dikonfirmasi atau disempurnakan oleh LLM utama yang lebih kuat. Model draft bertindak sebagai lintasan pertama, menghasilkan banyak token yang mempercepat proses generasi.
Alih-alih LLM utama menghasilkan token secara berurutan, model draft menyediakan sekumpulan kandidat yang mungkin, dan model utama mengevaluasinya secara paralel. Metode ini mengurangi beban komputasi pada LLM utama dengan mengalihkan prediksi awal, sehingga model utama hanya fokus pada koreksi atau validasi.
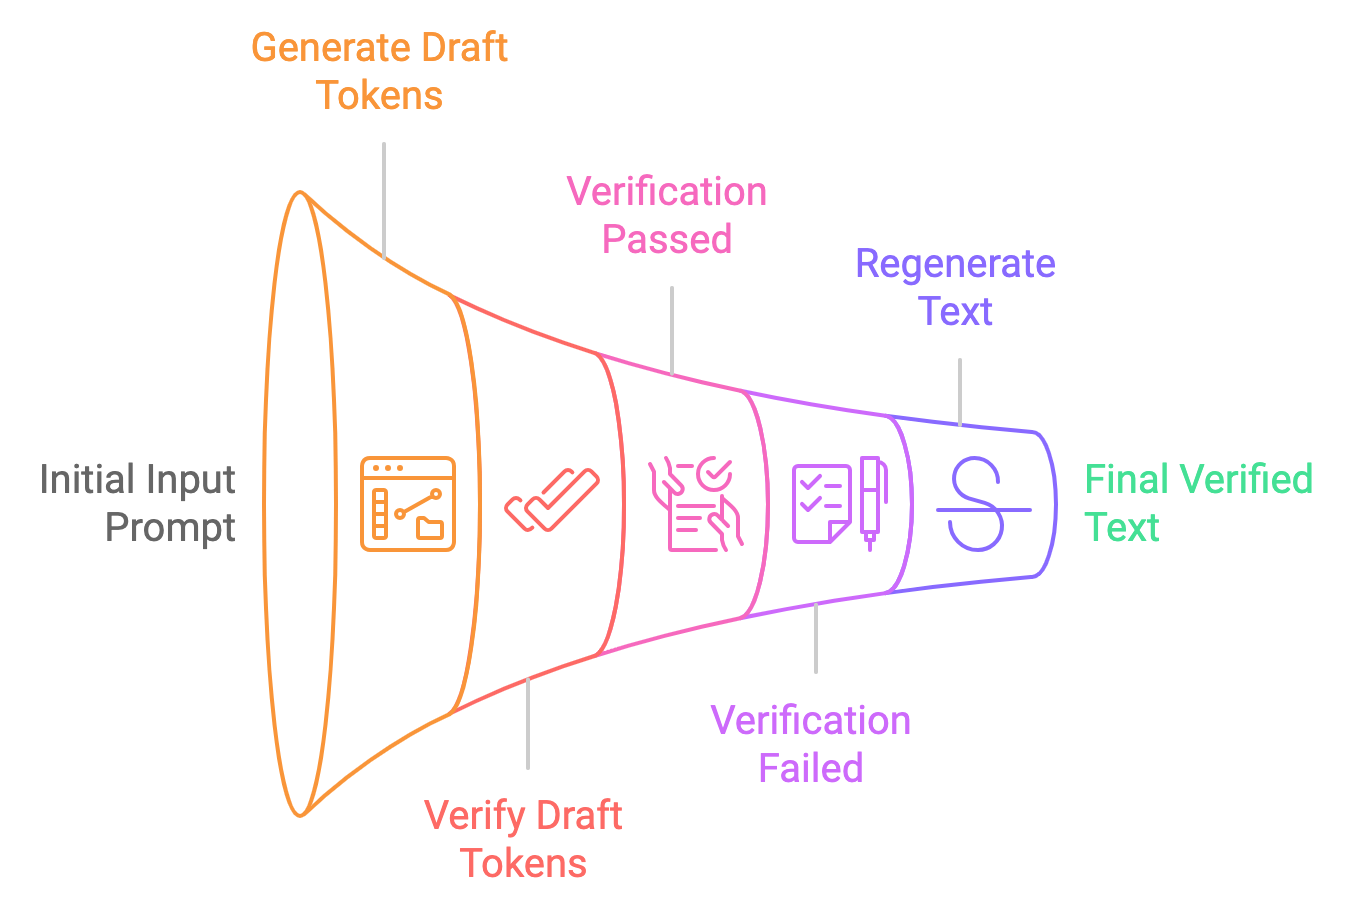
Anggap saja seperti penulis dengan editor. LLM utama adalah penulis, mampu menghasilkan teks berkualitas tinggi namun dengan tempo lebih lambat. Model "draft" yang lebih kecil dan lebih cepat bertindak sebagai editor, dengan cepat menghasilkan kemungkinan kelanjutan teks. LLM utama kemudian mengevaluasi saran ini, memasukkan yang akurat dan membuang sisanya. Ini memungkinkan LLM memproses banyak token secara bersamaan, sehingga mempercepat generasi teks.
Mari kita uraikan proses speculative decoding menjadi langkah-langkah sederhana:
Decoding tradisional memproses token satu per satu, sehingga latensi tinggi, sedangkan speculative decoding memungkinkan model yang lebih kecil menghasilkan token secara massal, dengan model yang lebih besar memverifikasinya. Ini dapat mengurangi waktu respons sebesar 30–40%, memotong latensi dari 25–30 detik menjadi hanya 15–18 detik.
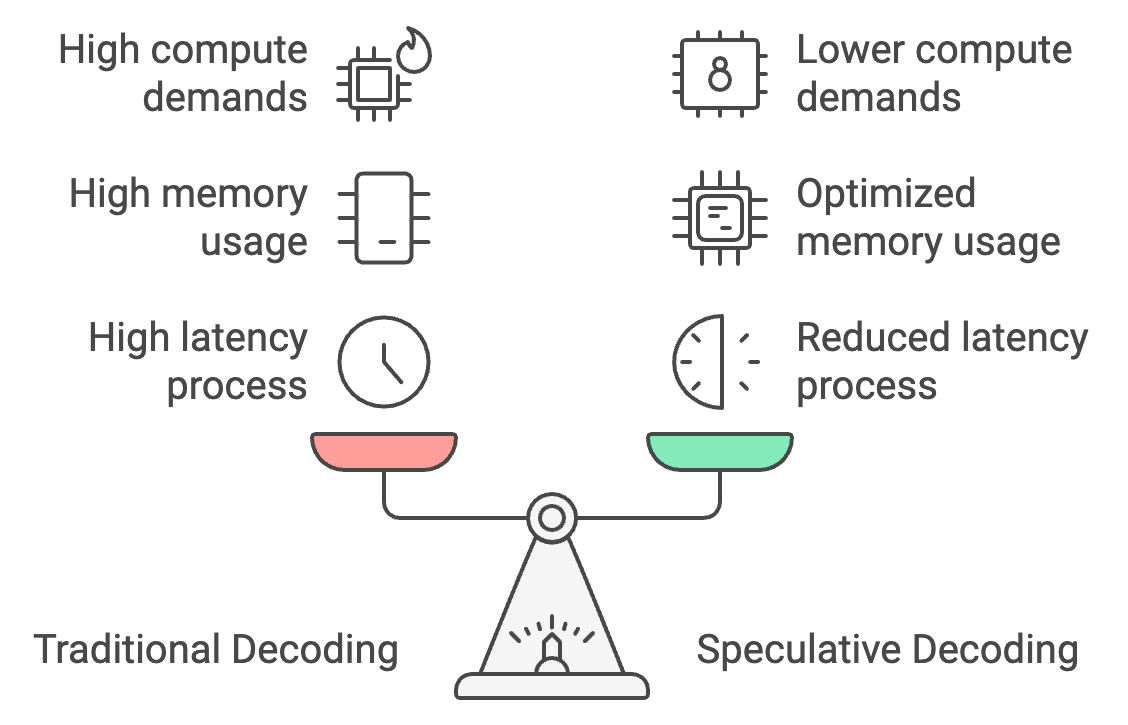
Selain itu, speculative decoding mengoptimalkan penggunaan memori dengan mengalihkan sebagian besar generasi token ke model yang lebih kecil, mengurangi kebutuhan memori dari 26 GB menjadi sekitar 14 GB dan membuat inferensi on-device lebih mudah diakses.
Terakhir, ini menurunkan kebutuhan komputasi hingga 50%, karena model yang lebih besar hanya memverifikasi alih-alih menghasilkan token, sehingga kinerja lebih mulus pada perangkat seluler dengan daya terbatas dan mencegah overheat.
Untuk mengimplementasikan contoh praktis speculative decoding menggunakan model Gemma2. Kita akan melihat perbandingan speculative decoding dengan inferensi standar dari sisi latensi dan kinerja.
Mulailah dengan mengimpor dependensi dan menetapkan seed.
Selanjutnya, periksa apakah GPU tersedia pada mesin yang Anda gunakan. Ini terutama diperlukan untuk model besar seperti Gemma 2-9B-it atau LLama2-13B.
Terakhir, kita memuat model kecil dan besar beserta tokenizer-nya. Di sini, kita menggunakan model Gemma2-2b-it (instruct) untuk model draft dan model Gemma2-9b-it untuk verifikasi.
Ada beberapa model lain yang juga dapat digunakan sebagai alternatif. Misalnya:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

# Set Seed
set_seed(42)

# Check if GPU is available
device = "cuda" if torch.cuda.is_available() else "cpu"

# Load the smaller Gemma2 model (draft generation)
small_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-2b-it", device_map="auto")
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", torch_dtype=torch.bfloat16)

# Load the larger Gemma2 model (verification)
big_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-9b-it", device_map="auto")
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", torch_dtype=torch.bfloat16)Pertama, kita melakukan inferensi hanya pada model besar (Gemma2-9b-it) dan menghasilkan keluaran. Mulailah dengan tokenisasi prompt masukan dan memindahkan token ke perangkat yang tepat (GPU jika tersedia). Metode generate menghasilkan keluaran model, hingga max_new_tokens. Hasilnya lalu didekode dari ID token kembali ke teks yang dapat dibaca manusia.
def normal_inference(big_model, big_tokenizer, prompt, max_new_tokens=50):
    inputs = big_tokenizer(prompt, return_tensors='pt').to(device)
    outputs = big_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
return big_tokenizer.decode(outputs[0], skip_special_tokens=True)Berikutnya, kita mencoba metode speculative decoding, dengan langkah-langkah berikut:
def speculative_decoding(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Step 1: Use the small model to generate the draft
    inputs = small_tokenizer(prompt, return_tensors='pt').to(device)
    small_outputs = small_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
    draft = small_tokenizer.decode(small_outputs[0], skip_special_tokens=True)

    # Step 2: Verify the draft with the big model
    big_inputs = big_tokenizer(draft, return_tensors='pt').to(device)

    # Step 3: Calculate log-likelihood of the draft tokens under the large model
    with torch.no_grad():
        outputs = big_model(big_inputs['input_ids'])
        log_probs = torch.log_softmax(outputs.logits, dim=-1)

    draft_token_ids = big_inputs['input_ids']
    log_likelihood = 0
    for i in range(draft_token_ids.size(1) - 1):
        token_id = draft_token_ids[0, i + 1]
        log_likelihood += log_probs[0, i, token_id].item()

    avg_log_likelihood = log_likelihood / (draft_token_ids.size(1) - 1)

    # Return the draft and its log-likelihood score
    return draft, avg_log_likelihood
Catatan: Log-likelihood adalah logaritma dari probabilitas yang diberikan model pada suatu urutan token tertentu. Di sini, ini mencerminkan seberapa mungkin atau “percaya diri” model bahwa urutan token (teks yang dihasilkan) valid berdasarkan token sebelumnya.
Setelah mengimplementasikan kedua teknik, kita dapat mengukur latensinya masing-masing. Untuk speculative decoding, kita menilai kinerja dengan memeriksa nilai log-likelihood. Nilai log-likelihood yang mendekati nol, khususnya pada rentang negatif, menunjukkan bahwa teks yang dihasilkan akurat.
def measure_latency(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Measure latency for normal inference (big model only)
    start_time = time.time()
    normal_output = normal_inference(big_model, big_tokenizer, prompt, max_new_tokens)
    normal_inference_latency = time.time() - start_time
    print(f"Normal Inference Output: {normal_output}")
    print(f"Normal Inference Latency: {normal_inference_latency:.4f} seconds")
    print("\n\n")

    # Measure latency for speculative decoding
    start_time = time.time()
    speculative_output, log_likelihood = speculative_decoding(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    speculative_decoding_latency = time.time() - start_time
    print(f"Speculative Decoding Output: {speculative_output}")
    print(f"Speculative Decoding Latency: {speculative_decoding_latency:.4f} seconds")
    print(f"Log Likelihood (Verification Score): {log_likelihood:.4f}")

    return normal_inference_latency, speculative_decoding_latency
Ini menghasilkan:
Latensi yang lebih rendah ini berkat waktu yang lebih singkat yang diperlukan model kecil untuk menghasilkan teks dan waktu yang lebih singkat yang diperlukan model besar untuk hanya memverifikasi teks yang dihasilkan.
Mari bandingkan speculative decoding dengan inferensi autoregresif menggunakan lima prompt:
# List of 5 prompts
prompts = [
    "The future of artificial intelligence is ",
    "Machine learning is transforming the world by ",
    "Natural language processing enables computers to understand ",
    "Generative models like GPT-3 can create ",
    "AI ethics and fairness are important considerations for "
]

# Inference settings
max_new_tokens = 200

# Initialize accumulators for latency, memory, and tokens per second
total_tokens_per_sec_normal = 0
total_tokens_per_sec_speculative = 0
total_normal_latency = 0
total_speculative_latency = 0

# Perform inference on each prompt and accumulate the results
for prompt in prompts:
    normal_latency, speculative_latency, _, _, tokens_per_sec_normal, tokens_per_sec_speculative = measure_latency_and_memory(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    total_tokens_per_sec_normal += tokens_per_sec_normal
    total_tokens_per_sec_speculative += tokens_per_sec_speculative
    total_normal_latency += normal_latency
    total_speculative_latency += speculative_latency

# Calculate averages
average_tokens_per_sec_normal = total_tokens_per_sec_normal / len(prompts)
average_tokens_per_sec_speculative = total_tokens_per_sec_speculative / len(prompts)
average_normal_latency = total_normal_latency / len(prompts)
average_speculative_latency = total_speculative_latency / len(prompts)

# Output the averages
print(f"Average Normal Inference Latency: {average_normal_latency:.4f} seconds")
print(f"Average Speculative Decoding Latency: {average_speculative_latency:.4f} seconds")
print(f"Average Normal Inference Tokens per second: {average_tokens_per_sec_normal:.2f} tokens/second")
print(f"Average Speculative Decoding Tokens per second: {average_tokens_per_sec_speculative:.2f} tokens/second")
Average Normal Inference Latency: 25.0876 seconds
Average Speculative Decoding Latency: 15.7802 seconds
Average Normal Inference Tokens per second: 7.97 tokens/second
Average Speculative Decoding Tokens per second: 12.68 tokens/secondIni menunjukkan bahwa speculative decoding lebih efisien, menghasilkan lebih banyak token per detik dibanding inferensi normal. Peningkatan ini terjadi karena model kecil menangani sebagian besar generasi teks, sementara peran model besar terbatas pada verifikasi, sehingga mengurangi beban komputasi secara keseluruhan dari sisi latensi dan memori.
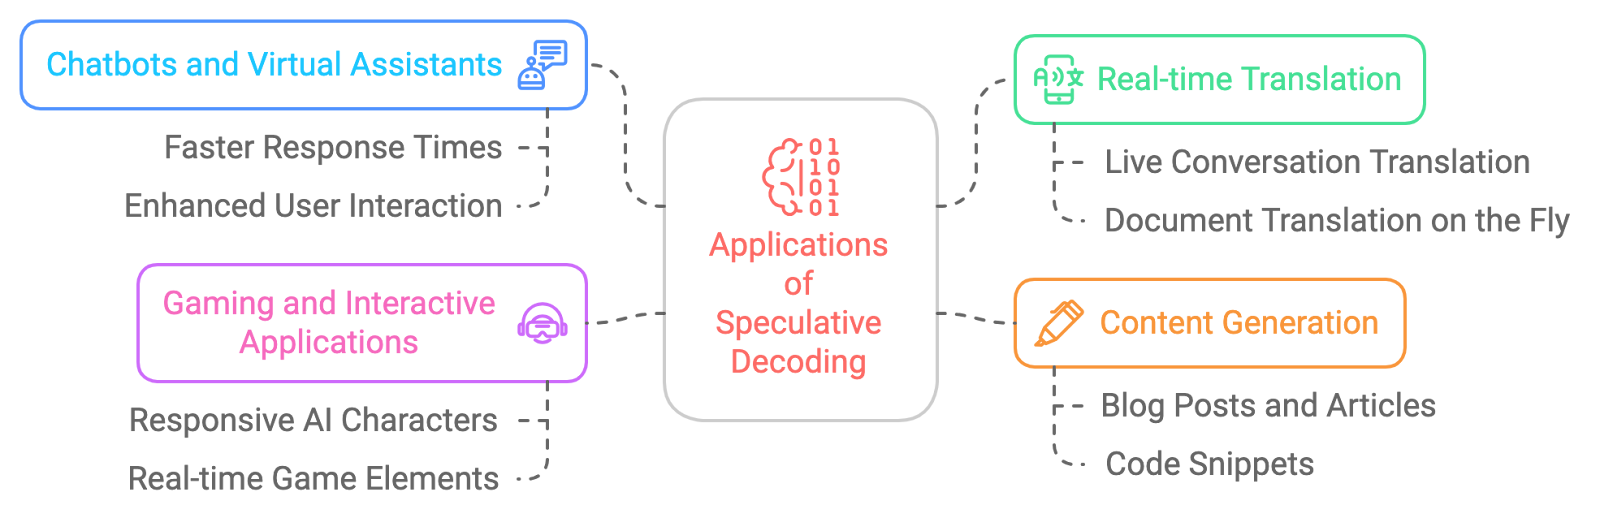
Dengan kebutuhan memori ini, kita dapat dengan mudah menerapkan teknik speculative decoding pada perangkat edge dan memperoleh peningkatan kecepatan pada aplikasi on-device seperti chatbot, penerjemah bahasa, gim, dan lainnya.
Pendekatan di atas efisien, tetapi ada trade-off antara latensi dan optimasi memori untuk inferensi on-device. Untuk mengatasinya, mari terapkan kuantisasi pada model kecil dan besar. Anda dapat bereksperimen dan mencoba menerapkan kuantisasi hanya pada model besar karena model kecil sudah memakan ruang paling sedikit.
Kuantisasi diterapkan pada model yang lebih kecil dan lebih besar menggunakan konfigurasi BitsAndBytesConfig dari pustaka transformers Hugging Face. Kuantisasi memungkinkan kita secara signifikan mengurangi penggunaan memori dan, dalam banyak kasus, meningkatkan kecepatan inferensi dengan mengonversi bobot model ke bentuk yang lebih ringkas.
Tambahkan potongan kode berikut ke kode di atas untuk melihat efek kuantisasi.
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # Enables 4-bit quantization
    bnb_4bit_quant_type="nf4",  # Specifies the quantization type (nf4)
    bnb_4bit_compute_dtype=torch.bfloat16,  # Uses bfloat16 for computation
    bnb_4bit_use_double_quant=False,  # Disables double quantization to avoid additional overhead
)

# Load the smaller and larger Gemma2 models with quantization applied
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", quantization_config=bnb_config)
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", quantization_config=bnb_config)
Berikut perbandingan cepat keluaran untuk menunjukkan efek speculative decoding dengan dan tanpa kuantisasi:
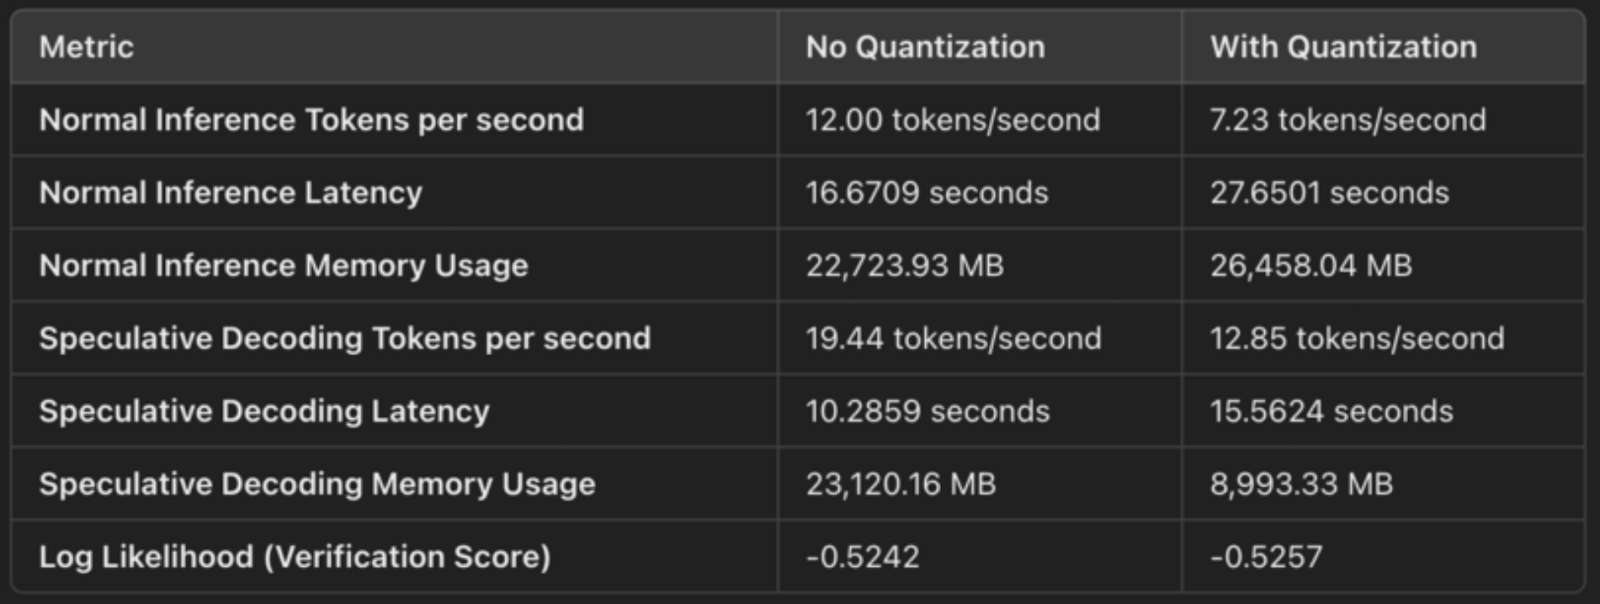
Konfigurasi menetapkan load_in_4bit=True, yang berarti bobot model dikuantisasi dari format floating-point 32-bit atau 16-bit asli menjadi integer 4-bit. Ini mengurangi jejak memori model. Kuantisasi mengompresi bobot model, memungkinkan kita menyimpan dan mengoperasikannya dengan lebih efisien. Berikut penghematan memori yang konkret:
Konfigurasi bnb_4bit_compute_dtype=torch.bfloat16 menetapkan bahwa komputasi dilakukan dalam bfloat16 (BF16), format floating-point yang lebih efisien. BF16 memiliki rentang dinamis lebih lebar daripada FP16 namun memakan separuh memori dibanding FP32, sehingga menjadi keseimbangan yang baik antara presisi dan performa.
Penggunaan BF16, khususnya pada GPU NVIDIA (seperti A100), memanfaatkan Tensor Cores yang dioptimalkan untuk operasi BF16. Ini menghasilkan perkalian matriks dan komputasi lain yang lebih cepat selama inferensi.
Untuk speculative decoding, kita melihat latensi yang membaik:
Jejak memori yang lebih kecil berarti akses memori lebih cepat dan pemanfaatan sumber daya GPU yang lebih efisien, sehingga menghasilkan generasi yang lebih cepat.
Opsi bnb_4bit_quant_type="nf4" menentukan Norm-Four Quantization (NF4), yang dioptimalkan untuk jaringan saraf. Kuantisasi NF4 membantu mempertahankan presisi pada bagian penting model, meskipun bobot direpresentasikan dalam 4 bit. Ini meminimalkan degradasi kinerja model dibanding kuantisasi 4-bit sederhana.
NF4 membantu mencapai keseimbangan antara kepadatan kuantisasi 4-bit dan akurasi prediksi model, memastikan kinerja tetap mendekati aslinya sambil memangkas penggunaan memori secara drastis.
Double quantization (bnb_4bit_use_double_quant=False) menambahkan lapisan kuantisasi tambahan di atas bobot 4-bit, yang dapat semakin mengurangi penggunaan memori namun juga menambah overhead komputasi. Dalam kasus ini, double quantization dinonaktifkan untuk menghindari perlambatan inferensi.
Potensi aplikasi speculative decoding sangat luas dan menarik. Berikut beberapa contohnya:
Meski speculative decoding sangat menjanjikan, bukan berarti tanpa tantangan:
Speculative decoding adalah teknik yang kuat dan berpotensi merevolusi cara kita berinteraksi dengan model bahasa besar. Teknik ini dapat secara signifikan mempercepat inferensi LLM tanpa mengorbankan kualitas teks yang dihasilkan. Meski ada tantangan yang perlu diatasi, manfaat speculative decoding tidak terbantahkan, dan kita dapat berharap adopsinya tumbuh dalam beberapa tahun ke depan, memampukan generasi baru aplikasi AI yang lebih cepat, lebih responsif, dan lebih efisien.
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




