
Programma
Sviluppare applicazioni AI
21 ore
Gli LLM sono potentissimi, ma spesso possono risultare un po' lenti, e questo non è ideale quando serve velocità. Lo speculative decoding è una tecnica pensata per accelerare gli LLM generando risposte più rapidamente senza compromettere la qualità.
In sostanza, è un modo per "indovinare in anticipo" nel processo di generazione del testo, facendo previsioni sulle parole che potrebbero arrivare dopo pur mantenendo l'accuratezza e la profondità che ci aspettiamo dagli LLM.
In questo blog ti spiegherò cos'è lo speculative decoding, come funziona e come implementarlo con i modelli Gemma 2.
Lo speculative decoding accelera gli LLM integrando un modello più piccolo e veloce che genera previsioni preliminari. Questo modello più piccolo, spesso chiamato modello di "bozza", produce un batch di token che l'LLM principale, più potente, può confermare o affinare. Il modello di bozza funge da primo passaggio, producendo più token che velocizzano il processo di generazione.
Invece di generare i token in sequenza con l'LLM principale, il modello di bozza fornisce un insieme di candidati probabili e il modello principale li valuta in parallelo. Questo metodo riduce il carico computazionale sull'LLM principale delegando le previsioni iniziali, permettendogli di concentrarsi solo su correzioni o validazioni.
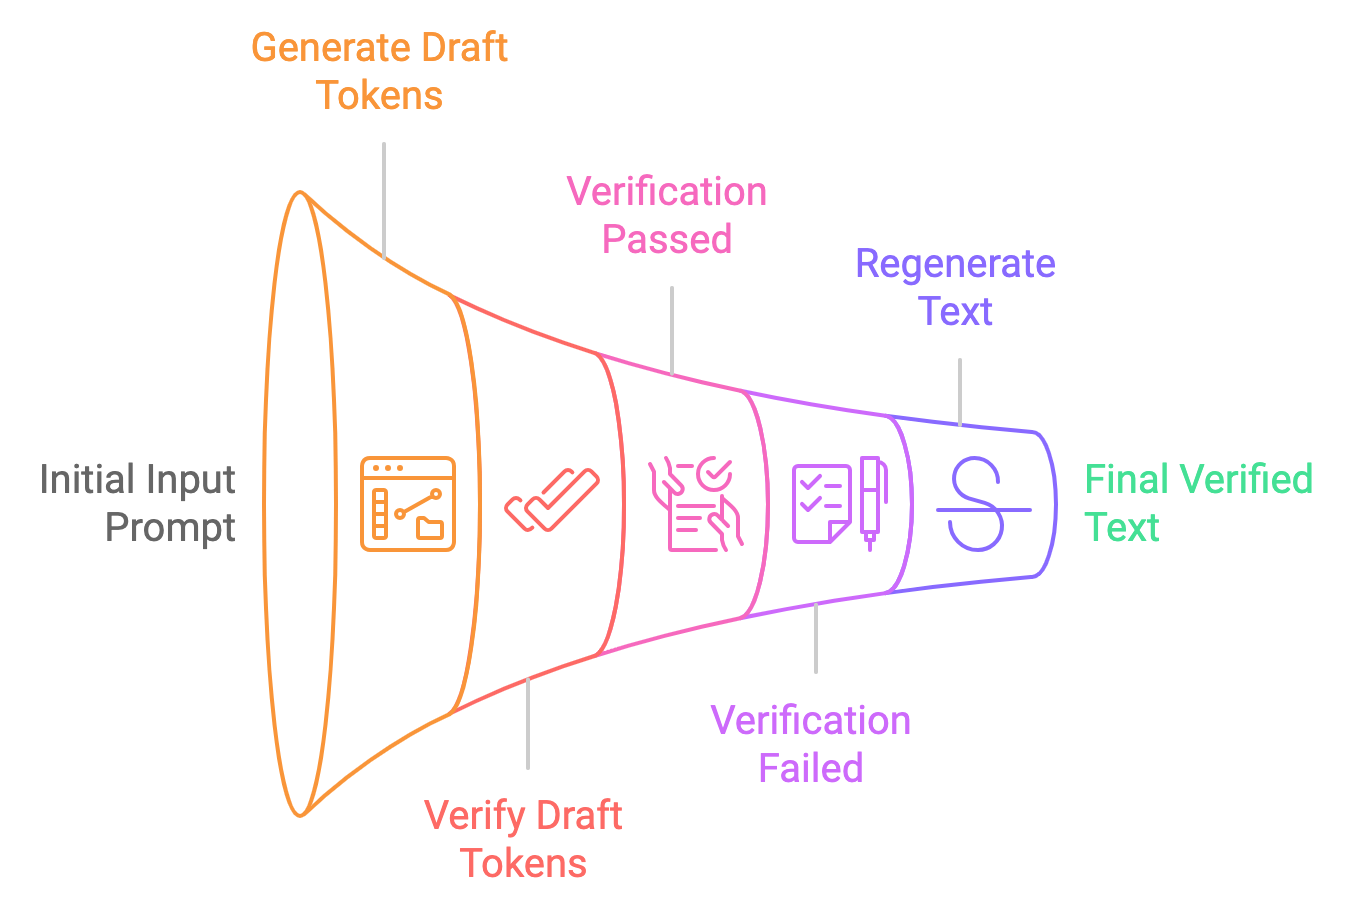
Pensalo come uno scrittore con un editor. L'LLM principale è lo scrittore, capace di produrre testo di alta qualità ma a un ritmo più lento. Un modello "di bozza" più piccolo e veloce fa da editor, generando rapidamente possibili continuazioni del testo. L'LLM principale poi valuta questi suggerimenti, incorporando quelli accurati e scartando gli altri. Questo consente all'LLM di elaborare più token in contemporanea, accelerando la generazione del testo.
Vediamo il processo di speculative decoding in semplici passaggi:
Il decoding tradizionale elabora i token uno alla volta, causando un'elevata latenza, mentre lo speculative decoding consente a un modello più piccolo di generare token in blocco, con il modello più grande che li verifica. Questo può ridurre i tempi di risposta del 30-40%, tagliando la latenza da 25-30 secondi fino a 15-18 secondi.
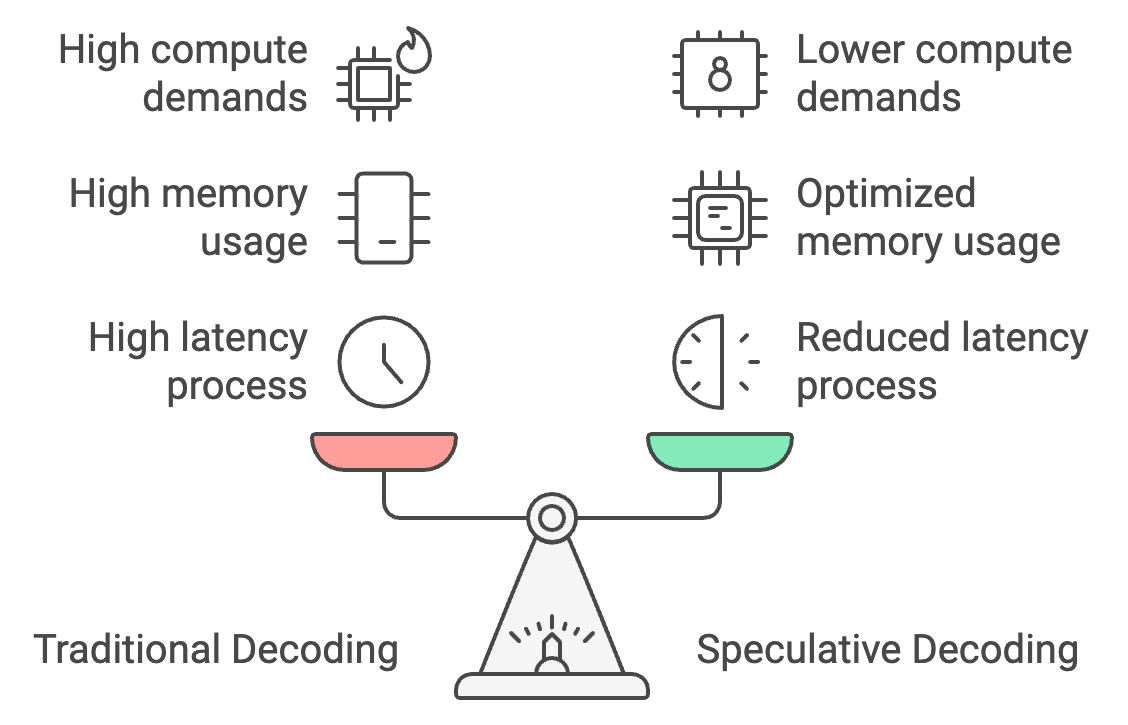
Inoltre, lo speculative decoding ottimizza l'uso della memoria spostando la maggior parte della generazione dei token sul modello più piccolo, riducendo i requisiti da 26 GB a circa 14 GB e rendendo l'inferenza on-device più accessibile.
Infine, riduce del 50% le esigenze di calcolo, poiché il modello più grande si limita a verificare invece di generare token, abilitando prestazioni più fluide su dispositivi mobili con potenza limitata ed evitando il surriscaldamento.
Per implementare un esempio pratico di speculative decoding usando i modelli Gemma2. Confronteremo lo speculative decoding con l'inferenza standard sia in termini di latenza sia di prestazioni.
Per iniziare, importa le dipendenze e imposta il seed.
Poi verifica se sulla macchina è disponibile la GPU. Questo è particolarmente necessario per modelli grandi come Gemma 2-9B-it o LLama2-13B.
Infine, carichiamo sia il modello piccolo che quello grande insieme ai rispettivi tokenizer. Qui usiamo il modello Gemma2-2b-it (instruct) come modello di bozza e il modello Gemma2-9b-it per la verifica.
Esistono anche altri modelli utilizzabili in alternativa. Ad esempio:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

# Set Seed
set_seed(42)

# Check if GPU is available
device = "cuda" if torch.cuda.is_available() else "cpu"

# Load the smaller Gemma2 model (draft generation)
small_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-2b-it", device_map="auto")
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", torch_dtype=torch.bfloat16)

# Load the larger Gemma2 model (verification)
big_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-9b-it", device_map="auto")
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", torch_dtype=torch.bfloat16)Per prima cosa, eseguiamo l'inferenza solo sul modello grande (Gemma2-9b-it) e generiamo l'output. Inizia tokenizzando il prompt di input e spostando i token sul dispositivo corretto (GPU se disponibile). Il metodo generate produce l'output del modello, generando fino a max_new_tokens. Il risultato viene poi decodificato dagli ID dei token in testo leggibile.
def normal_inference(big_model, big_tokenizer, prompt, max_new_tokens=50):
    inputs = big_tokenizer(prompt, return_tensors='pt').to(device)
    outputs = big_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
return big_tokenizer.decode(outputs[0], skip_special_tokens=True)Successivamente proviamo il metodo dello speculative decoding, in cui seguiamo questi passaggi:
def speculative_decoding(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Step 1: Use the small model to generate the draft
    inputs = small_tokenizer(prompt, return_tensors='pt').to(device)
    small_outputs = small_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
    draft = small_tokenizer.decode(small_outputs[0], skip_special_tokens=True)

    # Step 2: Verify the draft with the big model
    big_inputs = big_tokenizer(draft, return_tensors='pt').to(device)

    # Step 3: Calculate log-likelihood of the draft tokens under the large model
    with torch.no_grad():
        outputs = big_model(big_inputs['input_ids'])
        log_probs = torch.log_softmax(outputs.logits, dim=-1)

    draft_token_ids = big_inputs['input_ids']
    log_likelihood = 0
    for i in range(draft_token_ids.size(1) - 1):
        token_id = draft_token_ids[0, i + 1]
        log_likelihood += log_probs[0, i, token_id].item()

    avg_log_likelihood = log_likelihood / (draft_token_ids.size(1) - 1)

    # Return the draft and its log-likelihood score
    return draft, avg_log_likelihood
Nota: la log-verosimiglianza è il logaritmo della probabilità che un modello assegna a una specifica sequenza di token. Qui riflette quanto il modello ritenga probabile o "sicura" la sequenza di token (il testo generato) dato ciò che la precede.
Dopo aver implementato entrambe le tecniche, possiamo misurarne le rispettive latenze. Per lo speculative decoding, valutiamo le prestazioni osservando il valore della log-verosimiglianza. Un valore vicino allo zero, in particolare negativo, indica che il testo generato è accurato.
def measure_latency(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Measure latency for normal inference (big model only)
    start_time = time.time()
    normal_output = normal_inference(big_model, big_tokenizer, prompt, max_new_tokens)
    normal_inference_latency = time.time() - start_time
    print(f"Normal Inference Output: {normal_output}")
    print(f"Normal Inference Latency: {normal_inference_latency:.4f} seconds")
    print("\n\n")

    # Measure latency for speculative decoding
    start_time = time.time()
    speculative_output, log_likelihood = speculative_decoding(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    speculative_decoding_latency = time.time() - start_time
    print(f"Speculative Decoding Output: {speculative_output}")
    print(f"Speculative Decoding Latency: {speculative_decoding_latency:.4f} seconds")
    print(f"Log Likelihood (Verification Score): {log_likelihood:.4f}")

    return normal_inference_latency, speculative_decoding_latency
Questo restituisce:
La latenza più bassa è dovuta al minor tempo impiegato dal modello più piccolo per generare il testo e al minor tempo impiegato dal modello più grande per limitarsi a verificare il testo generato.
Confrontiamo lo speculative decoding con l'inferenza autoregressiva usando cinque prompt:
# List of 5 prompts
prompts = [
    "The future of artificial intelligence is ",
    "Machine learning is transforming the world by ",
    "Natural language processing enables computers to understand ",
    "Generative models like GPT-3 can create ",
    "AI ethics and fairness are important considerations for "
]

# Inference settings
max_new_tokens = 200

# Initialize accumulators for latency, memory, and tokens per second
total_tokens_per_sec_normal = 0
total_tokens_per_sec_speculative = 0
total_normal_latency = 0
total_speculative_latency = 0

# Perform inference on each prompt and accumulate the results
for prompt in prompts:
    normal_latency, speculative_latency, _, _, tokens_per_sec_normal, tokens_per_sec_speculative = measure_latency_and_memory(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    total_tokens_per_sec_normal += tokens_per_sec_normal
    total_tokens_per_sec_speculative += tokens_per_sec_speculative
    total_normal_latency += normal_latency
    total_speculative_latency += speculative_latency

# Calculate averages
average_tokens_per_sec_normal = total_tokens_per_sec_normal / len(prompts)
average_tokens_per_sec_speculative = total_tokens_per_sec_speculative / len(prompts)
average_normal_latency = total_normal_latency / len(prompts)
average_speculative_latency = total_speculative_latency / len(prompts)

# Output the averages
print(f"Average Normal Inference Latency: {average_normal_latency:.4f} seconds")
print(f"Average Speculative Decoding Latency: {average_speculative_latency:.4f} seconds")
print(f"Average Normal Inference Tokens per second: {average_tokens_per_sec_normal:.2f} tokens/second")
print(f"Average Speculative Decoding Tokens per second: {average_tokens_per_sec_speculative:.2f} tokens/second")
Average Normal Inference Latency: 25.0876 seconds
Average Speculative Decoding Latency: 15.7802 seconds
Average Normal Inference Tokens per second: 7.97 tokens/second
Average Speculative Decoding Tokens per second: 12.68 tokens/secondQuesto mostra che lo speculative decoding è più efficiente, generando più token al secondo rispetto all'inferenza normale. Il miglioramento è dovuto al fatto che il modello più piccolo gestisce la maggior parte della generazione del testo, mentre il ruolo del modello più grande si limita alla verifica, riducendo il carico computazionale complessivo in termini di latenza e memoria.
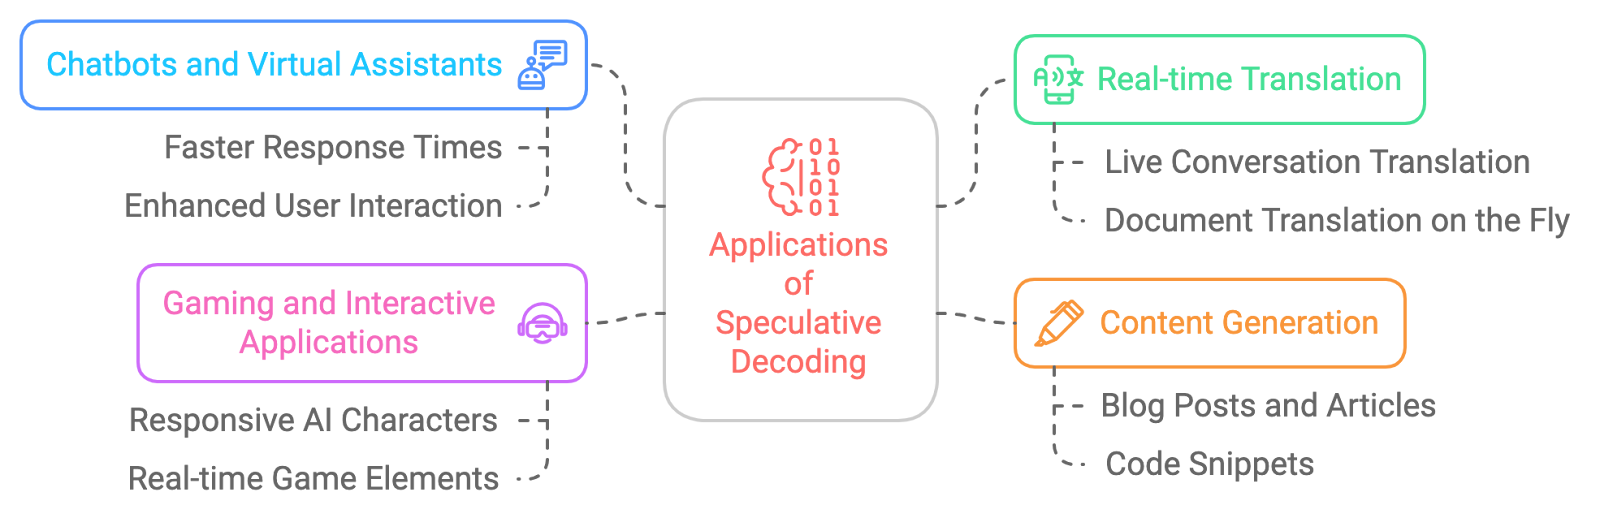
Con questi requisiti di memoria, possiamo facilmente distribuire tecniche di speculative decoding su dispositivi edge e ottenere accelerazioni nelle nostre applicazioni on-device come chatbot, traduttori, giochi e altro ancora.
L'approccio sopra è efficiente, ma esiste un compromesso tra latenza e ottimizzazione della memoria per l'inferenza on-device. Per affrontarlo, applichiamo la quantizzazione sia al modello piccolo che a quello grande. Puoi sperimentare applicandola solo al modello grande, dato che quello piccolo occupa già meno spazio.
La quantizzazione viene applicata ai modelli piccolo e grande usando la configurazione BitsAndBytesConfig della libreria transformers di Hugging Face. La quantizzazione consente di ridurre significativamente l'uso di memoria e, in molti casi, di migliorare la velocità di inferenza convertendo i pesi del modello in una forma più compatta.
Aggiungi il seguente snippet al codice sopra per vedere gli effetti della quantizzazione.
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # Enables 4-bit quantization
    bnb_4bit_quant_type="nf4",  # Specifies the quantization type (nf4)
    bnb_4bit_compute_dtype=torch.bfloat16,  # Uses bfloat16 for computation
    bnb_4bit_use_double_quant=False,  # Disables double quantization to avoid additional overhead
)

# Load the smaller and larger Gemma2 models with quantization applied
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", quantization_config=bnb_config)
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", quantization_config=bnb_config)
Ecco un rapido confronto degli output per mostrare gli effetti dello speculative decoding con e senza quantizzazione:
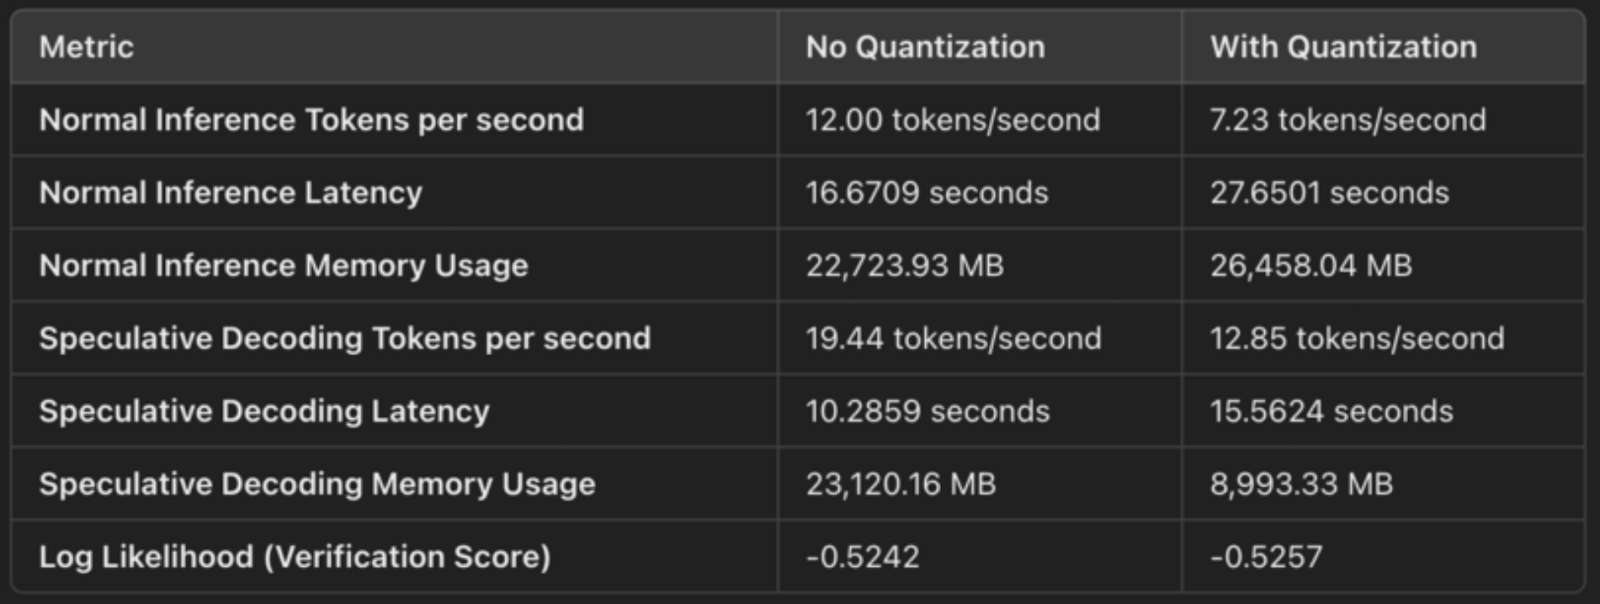
La configurazione specifica load_in_4bit=True, ciò significa che i pesi del modello vengono quantizzati dal formato floating-point a 32 o 16 bit a interi a 4 bit. Questo riduce l'impronta di memoria del modello. La quantizzazione comprime i pesi, permettendo di archiviarli e operarci in modo più efficiente. Ecco i risparmi di memoria concreti:
La configurazione bnb_4bit_compute_dtype=torch.bfloat16 specifica che i calcoli vengono eseguiti in bfloat16 (BF16), un formato floating-point più efficiente. BF16 ha un intervallo dinamico più ampio di FP16 ma occupa metà della memoria rispetto a FP32, offrendo un buon equilibrio tra precisione e prestazioni.
Usare BF16, specialmente su GPU NVIDIA (come A100), sfrutta le Tensor Core, ottimizzate per operazioni BF16. Questo si traduce in moltiplicazioni di matrici e altri calcoli più rapidi durante l'inferenza.
Per lo speculative decoding, osserviamo una migliore latenza:
L'impronta di memoria più ridotta significa accessi più veloci alla memoria e un uso più efficiente delle risorse GPU, con conseguente generazione più rapida.
L'opzione bnb_4bit_quant_type="nf4" specifica la Norm-Four Quantization (NF4), ottimizzata per le reti neurali. La quantizzazione NF4 aiuta a mantenere la precisione delle parti importanti del modello, pur rappresentando i pesi in 4 bit. Questo riduce al minimo il degrado delle prestazioni rispetto a una semplice quantizzazione a 4 bit.
NF4 consente di bilanciare la compattezza della quantizzazione a 4 bit e l'accuratezza delle previsioni del modello, garantendo prestazioni vicine all'originale pur riducendo drasticamente l'uso di memoria.
La doppia quantizzazione (bnb_4bit_use_double_quant=False) introduce un ulteriore livello di quantizzazione sopra i pesi a 4 bit, che può ridurre ulteriormente l'uso di memoria ma aggiunge anche overhead computazionale. In questo caso, la doppia quantizzazione è disabilitata per evitare di rallentare l'inferenza.
Le potenziali applicazioni dello speculative decoding sono ampie e interessanti. Ecco alcuni esempi:
Sebbene lo speculative decoding sia estremamente promettente, non è privo di sfide:
Lo speculative decoding è una tecnica potente che può rivoluzionare il modo in cui interagiamo con i large language model. Può accelerare sensibilmente l'inferenza degli LLM senza compromettere la qualità del testo generato. Pur esistendo delle sfide, i benefici dello speculative decoding sono innegabili e possiamo aspettarci una crescente adozione nei prossimi anni, abilitando una nuova generazione di applicazioni AI più veloci, reattive ed efficienti.
Impara l'AI con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



