
Leerpad
AI-toepassingen ontwikkelen
21 uur
LLM’s zijn enorm krachtig, maar vaak ook wat traag, en dat is niet ideaal wanneer we snelheid nodig hebben. Speculative decoding is een techniek die LLM’s versnelt door sneller reacties te genereren zonder in te leveren op kwaliteit.
In essentie is het een manier om vooruit te “raden” tijdens het genereren van tekst: het maakt voorspellingen over woorden die mogelijk volgen, terwijl het toch de nauwkeurigheid en diepgang behoudt die we van LLM’s verwachten.
In deze blog leg ik uit wat speculative decoding is, hoe het werkt en hoe je het implementeert met Gemma 2-modellen.
Speculative decoding versnelt LLM’s door een kleiner, sneller model in te zetten dat voorlopige voorspellingen genereert. Dit kleinere model, vaak het “draft”-model genoemd, genereert een batch tokens die het hoofdmodel, een krachtigere LLM, kan bevestigen of bijstellen. Het draft-model fungeert als een eerste passeerbeurt en produceert meerdere tokens die het generatieproces versnellen.
In plaats van dat de hoofd-LLM sequentieel tokens genereert, levert het draft-model een set waarschijnlijke kandidaten aan, die het hoofdmodel parallel beoordeelt. Deze methode verlaagt de rekenlast voor de hoofd-LLM door de eerste voorspellingen uit te besteden, zodat die zich kan richten op correcties of validaties.
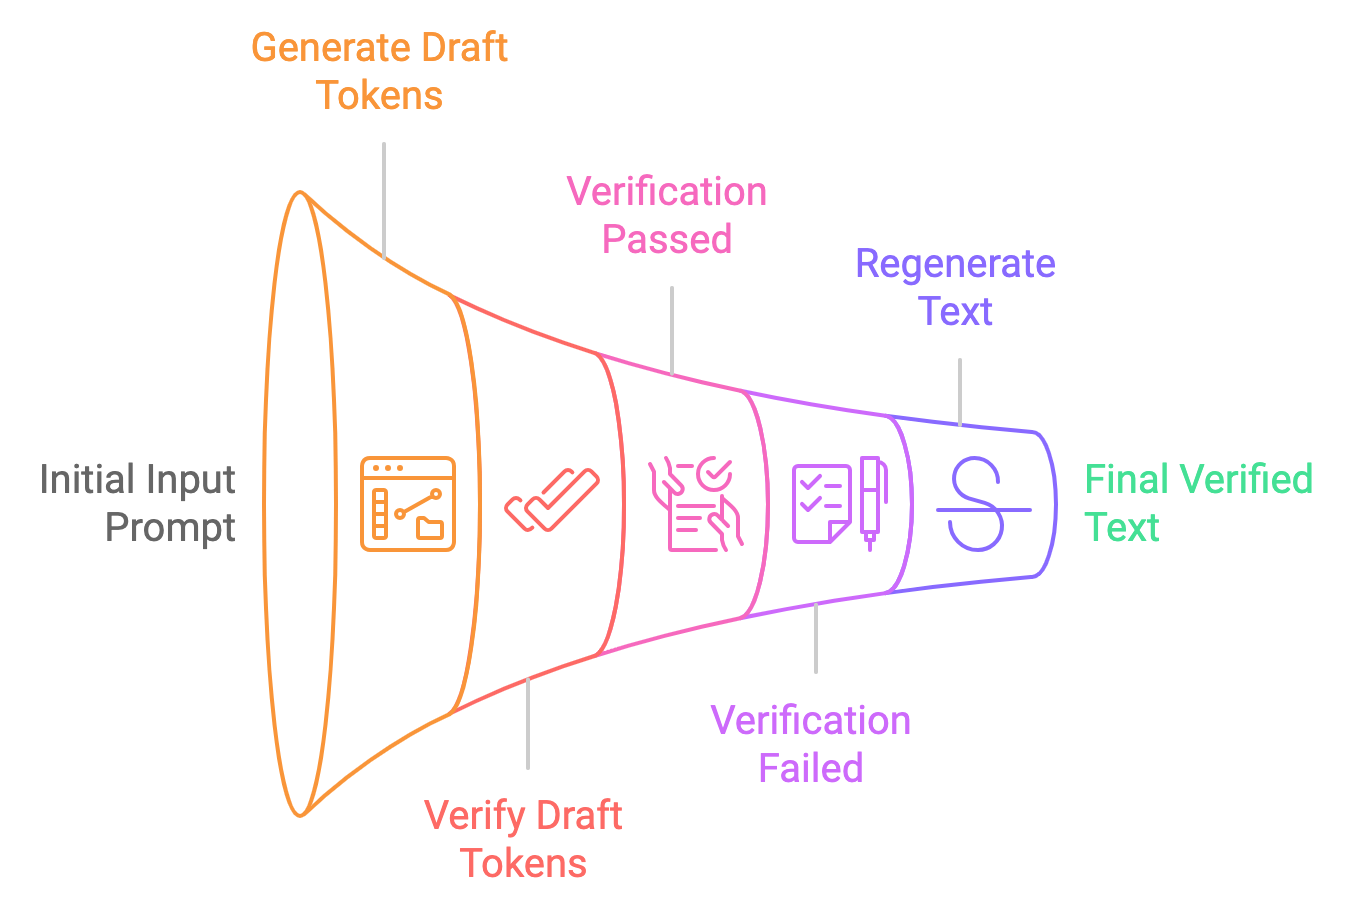
Denk eraan als een schrijver met een redacteur. De hoofd-LLM is de schrijver, in staat om tekst van hoge kwaliteit te produceren maar in een lager tempo. Een kleiner, sneller “draft”-model fungeert als de redacteur en genereert snel mogelijke vervolgen van de tekst. De hoofd-LLM beoordeelt vervolgens deze suggesties, neemt de juiste over en verwerpt de rest. Zo kan de LLM meerdere tokens tegelijk verwerken en sneller tekst genereren.
Laten we het proces van speculative decoding opsplitsen in eenvoudige stappen:
Traditioneel decoderen verwerkt tokens één voor één, wat leidt tot hoge latentie, terwijl speculative decoding een kleiner model toestaat om tokens in bulk te genereren, met verificatie door het grotere model. Dit kan de responstijd met 30–40% verkorten, waardoor de latentie van 25–30 seconden daalt tot slechts 15–18 seconden.
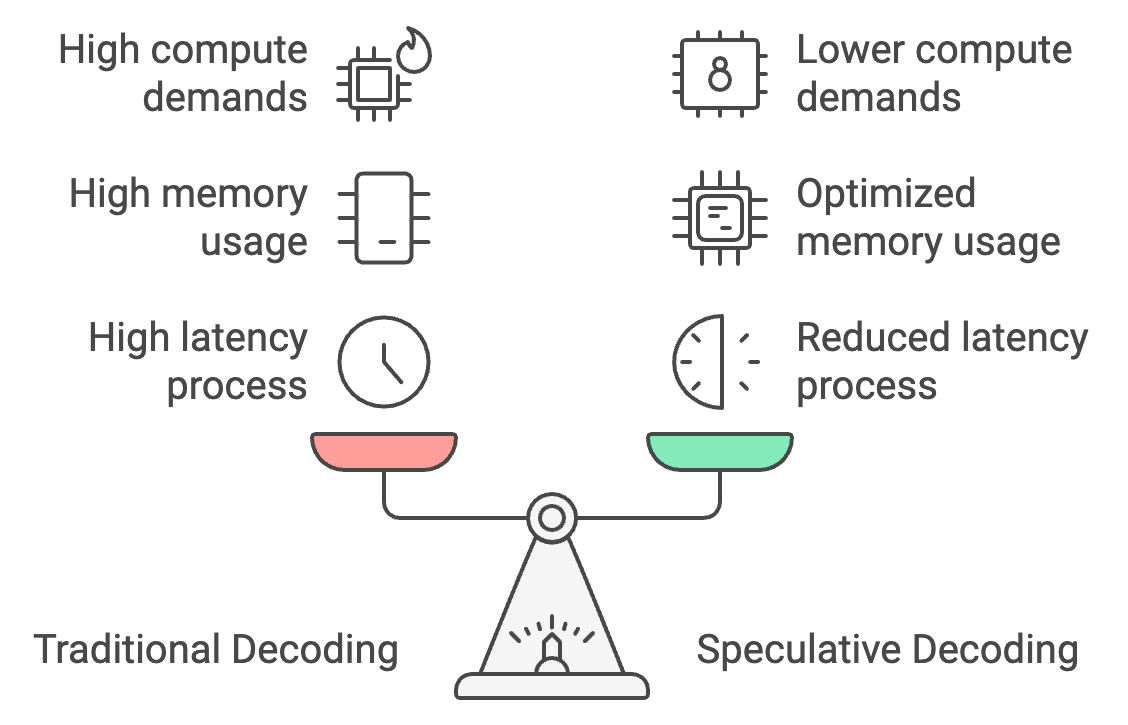
Daarnaast optimaliseert speculative decoding het geheugengebruik door het grootste deel van de tokengeneratie naar het kleinere model te verschuiven, waardoor de geheugenvraag van 26 GB naar ongeveer 14 GB daalt en on-device inferentie toegankelijker wordt.
Tot slot verlaagt het de rekenbelasting met 50%, omdat het grotere model alleen verifieert in plaats van tokens te genereren. Daardoor werkt het soepeler op mobiele apparaten met beperkte rekenkracht en voorkom je oververhitting.
We implementeren een praktijkvoorbeeld van speculative decoding met de Gemma2-modellen. We onderzoeken hoe speculative decoding zich verhoudt tot standaardinferentie qua latentie en prestaties.
Begin met het importeren van de afhankelijkheden en het zetten van de seed.
Controleer daarna of er een GPU beschikbaar is op de machine waarop je werkt. Dit is vooral nodig voor grote modellen zoals Gemma 2-9B-it of LLama2-13B.
Tot slot laden we zowel het kleine als het grote model met hun tokenizers. Hier gebruiken we het Gemma2-2b-it (instruct)-model als draft-model en het Gemma2-9b-it-model voor verificatie.
Er zijn ook een paar alternatieve modelcombinaties mogelijk. Bijvoorbeeld:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

# Set Seed
set_seed(42)

# Check if GPU is available
device = "cuda" if torch.cuda.is_available() else "cpu"

# Load the smaller Gemma2 model (draft generation)
small_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-2b-it", device_map="auto")
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", torch_dtype=torch.bfloat16)

# Load the larger Gemma2 model (verification)
big_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-9b-it", device_map="auto")
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", torch_dtype=torch.bfloat16)Eerst voeren we inferentie uit op alleen het grote model (Gemma2-9b-it) en genereren we output. Begin met het tokenizen van de inputprompt en verplaats de tokens naar het juiste device (GPU indien beschikbaar). De methode generate produceert de output van het model en genereert tot max_new_tokens. Het resultaat wordt vervolgens van token-ID’s terugvertaald naar leesbare tekst.
def normal_inference(big_model, big_tokenizer, prompt, max_new_tokens=50):
    inputs = big_tokenizer(prompt, return_tensors='pt').to(device)
    outputs = big_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
return big_tokenizer.decode(outputs[0], skip_special_tokens=True)Vervolgens proberen we de speculative decoding-methode, waarbij we de volgende stappen nemen:
def speculative_decoding(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Step 1: Use the small model to generate the draft
    inputs = small_tokenizer(prompt, return_tensors='pt').to(device)
    small_outputs = small_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
    draft = small_tokenizer.decode(small_outputs[0], skip_special_tokens=True)

    # Step 2: Verify the draft with the big model
    big_inputs = big_tokenizer(draft, return_tensors='pt').to(device)

    # Step 3: Calculate log-likelihood of the draft tokens under the large model
    with torch.no_grad():
        outputs = big_model(big_inputs['input_ids'])
        log_probs = torch.log_softmax(outputs.logits, dim=-1)

    draft_token_ids = big_inputs['input_ids']
    log_likelihood = 0
    for i in range(draft_token_ids.size(1) - 1):
        token_id = draft_token_ids[0, i + 1]
        log_likelihood += log_probs[0, i, token_id].item()

    avg_log_likelihood = log_likelihood / (draft_token_ids.size(1) - 1)

    # Return the draft and its log-likelihood score
    return draft, avg_log_likelihood
Let op: log-likelihood is de logaritme van de kans die een model toekent aan een specifieke reeks tokens. Hier geeft het aan hoe waarschijnlijk of “zelfverzekerd” het model is dat de tokenreeks (de gegenereerde tekst) klopt, gegeven de voorgaande tokens.
Na de implementatie van beide technieken kunnen we hun respectieve latenties meten. Voor speculative decoding beoordelen we de prestaties door naar de log-likelihoodwaarde te kijken. Een log-likelihoodwaarde die richting nul gaat, met name in het negatieve bereik, duidt erop dat de gegenereerde tekst accuraat is.
def measure_latency(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Measure latency for normal inference (big model only)
    start_time = time.time()
    normal_output = normal_inference(big_model, big_tokenizer, prompt, max_new_tokens)
    normal_inference_latency = time.time() - start_time
    print(f"Normal Inference Output: {normal_output}")
    print(f"Normal Inference Latency: {normal_inference_latency:.4f} seconds")
    print("\n\n")

    # Measure latency for speculative decoding
    start_time = time.time()
    speculative_output, log_likelihood = speculative_decoding(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    speculative_decoding_latency = time.time() - start_time
    print(f"Speculative Decoding Output: {speculative_output}")
    print(f"Speculative Decoding Latency: {speculative_decoding_latency:.4f} seconds")
    print(f"Log Likelihood (Verification Score): {log_likelihood:.4f}")

    return normal_inference_latency, speculative_decoding_latency
Dit levert op:
De lagere latentie is te danken aan minder tijd voor tekstopwekking door het kleinere model en minder tijd voor het grotere model omdat het alleen de gegenereerde tekst verifieert.
Laten we speculative decoding vergelijken met autoregressieve inferentie met vijf prompts:
# List of 5 prompts
prompts = [
    "The future of artificial intelligence is ",
    "Machine learning is transforming the world by ",
    "Natural language processing enables computers to understand ",
    "Generative models like GPT-3 can create ",
    "AI ethics and fairness are important considerations for "
]

# Inference settings
max_new_tokens = 200

# Initialize accumulators for latency, memory, and tokens per second
total_tokens_per_sec_normal = 0
total_tokens_per_sec_speculative = 0
total_normal_latency = 0
total_speculative_latency = 0

# Perform inference on each prompt and accumulate the results
for prompt in prompts:
    normal_latency, speculative_latency, _, _, tokens_per_sec_normal, tokens_per_sec_speculative = measure_latency_and_memory(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    total_tokens_per_sec_normal += tokens_per_sec_normal
    total_tokens_per_sec_speculative += tokens_per_sec_speculative
    total_normal_latency += normal_latency
    total_speculative_latency += speculative_latency

# Calculate averages
average_tokens_per_sec_normal = total_tokens_per_sec_normal / len(prompts)
average_tokens_per_sec_speculative = total_tokens_per_sec_speculative / len(prompts)
average_normal_latency = total_normal_latency / len(prompts)
average_speculative_latency = total_speculative_latency / len(prompts)

# Output the averages
print(f"Average Normal Inference Latency: {average_normal_latency:.4f} seconds")
print(f"Average Speculative Decoding Latency: {average_speculative_latency:.4f} seconds")
print(f"Average Normal Inference Tokens per second: {average_tokens_per_sec_normal:.2f} tokens/second")
print(f"Average Speculative Decoding Tokens per second: {average_tokens_per_sec_speculative:.2f} tokens/second")
Average Normal Inference Latency: 25.0876 seconds
Average Speculative Decoding Latency: 15.7802 seconds
Average Normal Inference Tokens per second: 7.97 tokens/second
Average Speculative Decoding Tokens per second: 12.68 tokens/secondDit laat zien dat speculative decoding efficiënter is en meer tokens per seconde genereert dan normale inferentie. Deze verbetering komt doordat het kleinere model het grootste deel van de tekstopwekking afhandelt, terwijl de rol van het grotere model beperkt is tot verificatie. Daardoor daalt de totale rekenlast qua latentie en geheugen.
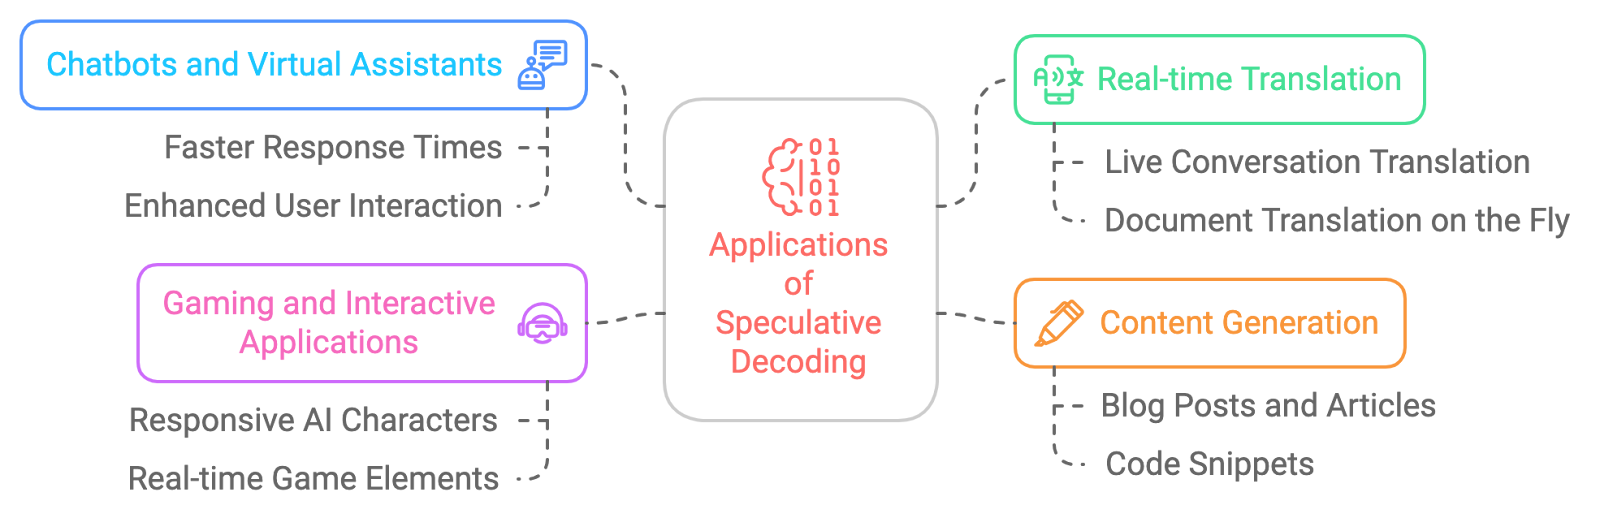
Met deze geheugenvragen kunnen we speculative decoding-technieken eenvoudig op edge-apparaten inzetten en snelheidswinst boeken in on-device toepassingen zoals chatbots, vertaaltools, games en meer.
De bovenstaande aanpak is efficiënt, maar er is een afweging tussen latentie en geheugenoptimalisatie voor on-device inferentie. Om dit aan te pakken passen we quantization toe op zowel kleine als grote modellen. Je kunt experimenteren en quantization alleen op het grote model toepassen, aangezien het kleine model al het minste ruimte inneemt.
Quantificatie wordt toegepast op kleinere en grotere modellen met de BitsAndBytesConfig-configuratie uit de Hugging Face-transformers-bibliotheek. Quantization stelt ons in staat het geheugengebruik aanzienlijk te verlagen en in veel gevallen de inferentiesnelheid te verbeteren door de gewichten van het model om te zetten naar een compacter formaat.
Voeg de volgende codefragmenten toe aan de bovenstaande code om de effecten van quantization te zien.
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # Enables 4-bit quantization
    bnb_4bit_quant_type="nf4",  # Specifies the quantization type (nf4)
    bnb_4bit_compute_dtype=torch.bfloat16,  # Uses bfloat16 for computation
    bnb_4bit_use_double_quant=False,  # Disables double quantization to avoid additional overhead
)

# Load the smaller and larger Gemma2 models with quantization applied
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", quantization_config=bnb_config)
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", quantization_config=bnb_config)
Hier is een snelle vergelijking van outputs om de effecten van speculative decoding met en zonder quantization te laten zien:
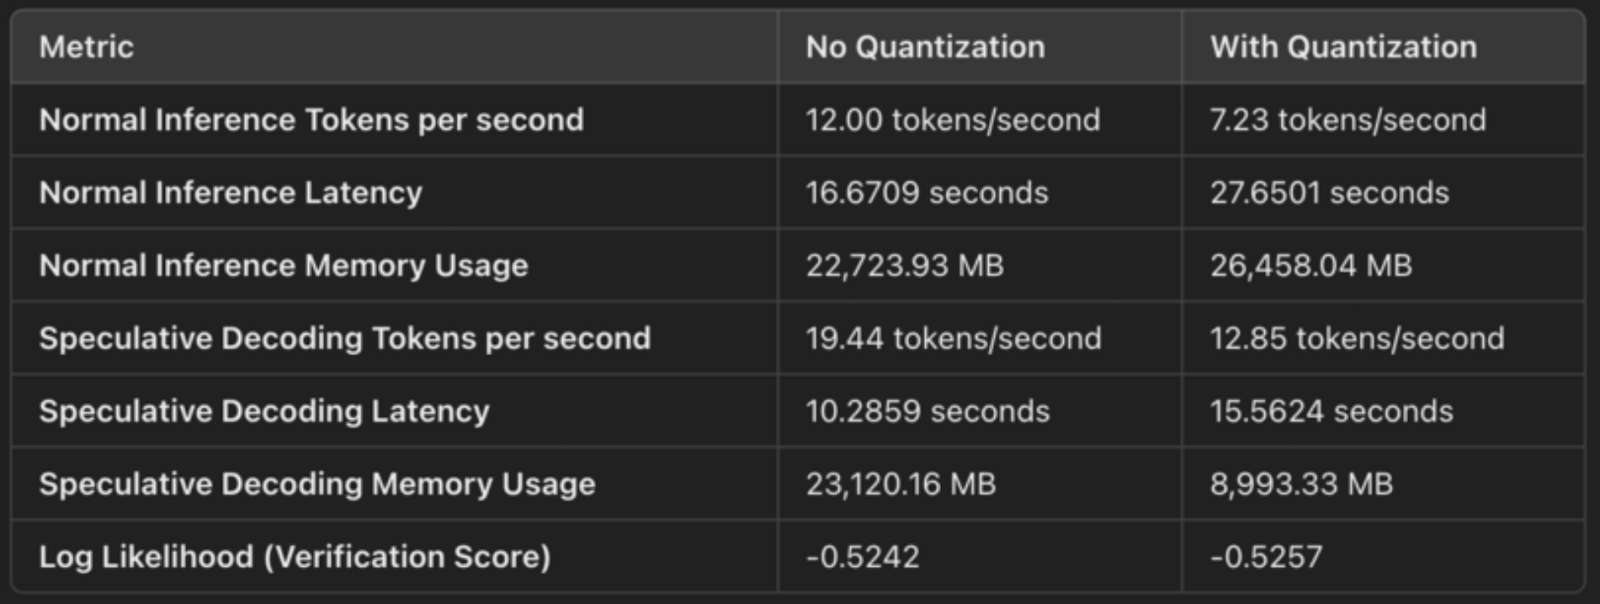
De configuratie specificeert load_in_4bit=True, wat betekent dat de gewichten van het model worden gequantized van hun oorspronkelijke 32- of 16-bits floatingpointformaat naar 4-bits integers. Dit verkleint de geheugenvraag van het model. Quantization comprimeert de gewichten, zodat we ze efficiënter kunnen opslaan en gebruiken. Dit zijn de concrete geheugenbesparingen:
De configuratie bnb_4bit_compute_dtype=torch.bfloat16 geeft aan dat berekeningen worden uitgevoerd in bfloat16 (BF16), een efficiënter floatingpointformaat. BF16 heeft een groter dynamisch bereik dan FP16 maar gebruikt de helft van het geheugen van FP32; het is dus een goede balans tussen precisie en performance.
Door BF16 te gebruiken, vooral op NVIDIA-GPU’s (zoals A100), maak je gebruik van Tensor Cores die zijn geoptimaliseerd voor BF16-bewerkingen. Dit resulteert in snellere matrixvermenigvuldigingen en andere berekeningen tijdens inferentie.
Voor speculative decoding zien we verbeterde latentie:
De kleinere geheugenfootprint betekent snellere geheugentoegang en efficiënter gebruik van GPU-resources, wat leidt tot snellere generatie.
De optie bnb_4bit_quant_type="nf4" specificeert Norm-Four Quantization (NF4), geoptimaliseerd voor neurale netwerken. NF4 helpt de precisie van belangrijke delen van het model te behouden, ook al worden de gewichten in 4 bits weergegeven. Dit minimaliseert prestatieverlies ten opzichte van eenvoudige 4-bits quantization.
NF4 biedt een balans tussen de compactheid van 4-bits quantization en de nauwkeurigheid van de voorspellingen van het model, zodat de prestaties dicht bij het origineel blijven terwijl het geheugengebruik drastisch afneemt.
Double quantization (bnb_4bit_use_double_quant=False) voegt een extra laag quantization toe bovenop de 4-bits gewichten, wat het geheugen nog verder kan verlagen maar ook rekenoverhead toevoegt. In dit geval is double quantization uitgeschakeld om vertraging bij de inferentie te voorkomen.
De mogelijke toepassingen van speculative decoding zijn legio en spannend. Enkele voorbeelden:
Hoewel speculative decoding veelbelovend is, brengt het ook uitdagingen met zich mee:
Speculative decoding is een krachtige techniek die de manier waarop we met large language models omgaan kan veranderen. Het kan LLM-inferentie aanzienlijk versnellen zonder de kwaliteit van de gegenereerde tekst aan te tasten. Hoewel er uitdagingen zijn, zijn de voordelen van speculative decoding onmiskenbaar. We kunnen verwachten dat de adoptie de komende jaren toeneemt, wat een nieuwe generatie snellere, responsievere en efficiëntere AI-toepassingen mogelijk maakt.
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

