
लर्निंग पाथ
एआई अनुप्रयोग विकसित करना
21 घंटा
LLMs बेहद शक्तिशाली हैं, लेकिन कई बार ये कुछ धीमे हो सकते हैं—जो उन परिस्थितियों में आदर्श नहीं है जहाँ हमें गति चाहिए। स्पेक्युलेटिव डिकोडिंग एक ऐसी तकनीक है जो LLMs की गुणवत्ता से समझौता किए बिना प्रतिक्रियाएँ तेज़ी से जनरेट करके उन्हें गति देती है।
मूल रूप से, यह टेक्स्ट जनरेशन की प्रक्रिया में आगे का "अंदाज़ा लगाने" का तरीका है—आने वाले शब्दों की भविष्यवाणी करते हुए, फिर भी LLMs से अपेक्षित सटीकता और गहराई बनाए रखते हुए।
इस ब्लॉग में, मैं समझाऊँगा कि स्पेक्युलेटिव डिकोडिंग क्या है, यह कैसे काम करती है, और Gemma 2 मॉडलों के साथ इसे कैसे लागू करें।
स्पेक्युलेटिव डिकोडिंग एक छोटे, तेज़ मॉडल को शामिल करके LLMs को तेज़ करती है, जो प्रारंभिक भविष्यवाणियाँ बनाता है। इस छोटे मॉडल को अक्सर “ड्राफ्ट” मॉडल कहा जाता है, जो टोकन का एक बैच जनरेट करता है जिसे मुख्य, अधिक शक्तिशाली LLM पुष्टि या परिष्कृत कर सकता है। ड्राफ्ट मॉडल प्रथम-पास की तरह काम करता है और कई टोकन उत्पन्न करता है, जिससे जनरेशन प्रक्रिया तेज़ होती है।
मुख्य LLM के क्रमिक रूप से टोकन जनरेट करने के बजाय, ड्राफ्ट मॉडल संभावित प्रत्याशियों का एक सेट देता है और मुख्य मॉडल उन्हें समानांतर में मूल्यांकित करता है। यह तरीका प्रारंभिक भविष्यवाणियाँ ऑफलोड करके मुख्य LLM पर कम्प्यूटेशनल लोड कम करता है, जिससे वह केवल सुधार या सत्यापन पर ध्यान केंद्रित कर सके।
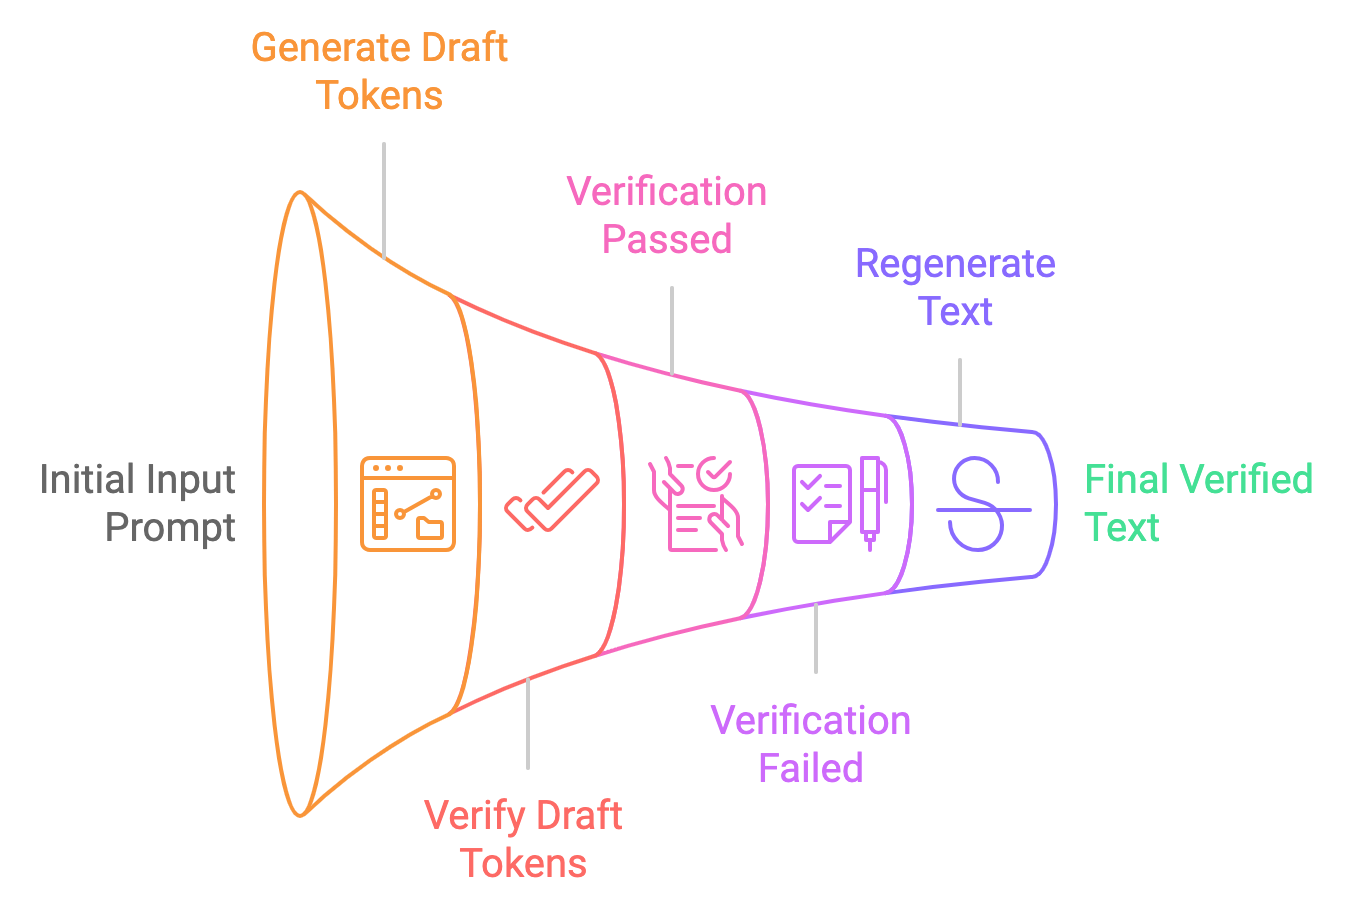
इसे एक लेखक और संपादक की टीम की तरह समझिए। मुख्य LLM लेखक है—उच्च गुणवत्ता का पाठ बना सकता है, पर थोड़ा धीमे। एक छोटा, तेज़ “ड्राफ्ट” मॉडल संपादक की तरह कार्य करता है, जो तुरंत संभावित कंटिन्यूएशन सुझाता है। मुख्य LLM फिर इन सुझावों का मूल्यांकन करता है, सही को अपनाता है और शेष को त्याग देता है। इससे LLM एक साथ कई टोकनों को प्रोसेस कर सकता है और टेक्स्ट जनरेशन तेज़ हो जाती है।
आइए स्पेक्युलेटिव डिकोडिंग की प्रक्रिया को सरल चरणों में समझें:
ट्रेडिशनल डिकोडिंग एक बार में एक टोकन प्रोसेस करती है, जिससे उच्च विलंबता होती है; जबकि स्पेक्युलेटिव डिकोडिंग में छोटा मॉडल बल्क में टोकन बनाता है और बड़ा मॉडल उन्हें सत्यापित करता है। इससे प्रतिक्रिया समय 30–40% तक घट सकता है—25–30 सेकंड की लेटेंसी घटकर लगभग 15–18 सेकंड रह जाती है।
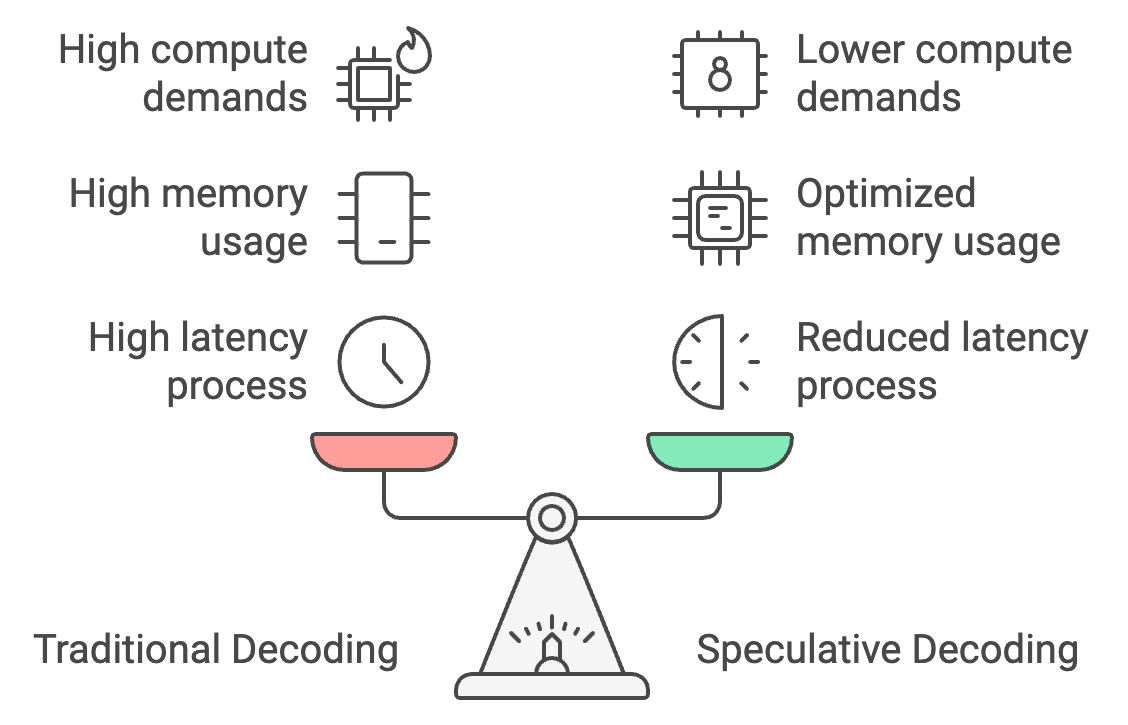
साथ ही, स्पेक्युलेटिव डिकोडिंग मेमोरी उपयोग का अनुकूलन करती है—ज्यादातर टोकन जनरेशन छोटे मॉडल पर शिफ्ट होने से मेमोरी आवश्यकता 26 GB से घटकर लगभग 14 GB रह जाती है, जिससे ऑन-डिवाइस इन्फरेंस अधिक सुलभ हो जाती है।
अंततः, यह कम्प्यूट डिमांड 50% तक कम कर देती है, क्योंकि बड़ा मॉडल टोकन जनरेट करने के बजाय केवल सत्यापन करता है—इससे सीमित पावर वाले मोबाइल डिवाइस पर प्रदर्शन स्मूथ रहता है और ओवरहीटिंग से बचाव होता है।
Gemma2 मॉडलों का उपयोग करते हुए स्पेक्युलेटिव डिकोडिंग का एक प्रायोगिक उदाहरण लागू करते हैं। हम लेटेंसी और परफॉर्मेंस—दोनों के संदर्भ में—स्पेक्युलेटिव डिकोडिंग की तुलना स्टैंडर्ड इन्फरेंस से करेंगे।
शुरू करने के लिए, डिपेंडेंसी इम्पोर्ट करें और सीड सेट करें।
इसके बाद, देखें कि आप जिस मशीन पर काम कर रहे हैं, उस पर GPU उपलब्ध है या नहीं। यह मुख्यतः बड़े मॉडलों—जैसे Gemma 2-9B-it या LLama2-13B—के लिए आवश्यक है।
अंत में, हम छोटे और बड़े दोनों मॉडल उनके टोकनाइज़र सहित लोड करते हैं। यहाँ, ड्राफ्ट के लिए Gemma2-2b-it (instruct) और सत्यापन के लिए Gemma2-9b-it मॉडल का उपयोग कर रहे हैं।
कुछ अन्य मॉडल भी वैकल्पिक रूप से इस्तेमाल किए जा सकते हैं। उदाहरण के लिए:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

# Set Seed
set_seed(42)

# Check if GPU is available
device = "cuda" if torch.cuda.is_available() else "cpu"

# Load the smaller Gemma2 model (draft generation)
small_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-2b-it", device_map="auto")
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", torch_dtype=torch.bfloat16)

# Load the larger Gemma2 model (verification)
big_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-9b-it", device_map="auto")
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", torch_dtype=torch.bfloat16)पहले, हम केवल बड़े मॉडल (Gemma2-9b-it) पर इन्फरेंस करके आउटपुट जनरेट करते हैं। शुरुआत करें इनपुट प्रॉम्प्ट को टोकनाइज़ करके और टोकनों को उपयुक्त डिवाइस (यदि उपलब्ध हो तो GPU) पर ले जाकर। generate मेथड मॉडल का आउटपुट बनाता है, अधिकतम max_new_tokens तक। परिणाम को फिर टोकन IDs से वापस मानव-पठनीय टेक्स्ट में डिकोड किया जाता है।
def normal_inference(big_model, big_tokenizer, prompt, max_new_tokens=50):
    inputs = big_tokenizer(prompt, return_tensors='pt').to(device)
    outputs = big_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
return big_tokenizer.decode(outputs[0], skip_special_tokens=True)अब, हम स्पेक्युलेटिव डिकोडिंग विधि आज़माते हैं, जिसमें हम ये कदम उठाते हैं:
def speculative_decoding(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Step 1: Use the small model to generate the draft
    inputs = small_tokenizer(prompt, return_tensors='pt').to(device)
    small_outputs = small_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
    draft = small_tokenizer.decode(small_outputs[0], skip_special_tokens=True)

    # Step 2: Verify the draft with the big model
    big_inputs = big_tokenizer(draft, return_tensors='pt').to(device)

    # Step 3: Calculate log-likelihood of the draft tokens under the large model
    with torch.no_grad():
        outputs = big_model(big_inputs['input_ids'])
        log_probs = torch.log_softmax(outputs.logits, dim=-1)

    draft_token_ids = big_inputs['input_ids']
    log_likelihood = 0
    for i in range(draft_token_ids.size(1) - 1):
        token_id = draft_token_ids[0, i + 1]
        log_likelihood += log_probs[0, i, token_id].item()

    avg_log_likelihood = log_likelihood / (draft_token_ids.size(1) - 1)

    # Return the draft and its log-likelihood score
    return draft, avg_log_likelihood
नोट: लॉग-लाइकलीहुड वह लघुगणक है जो किसी विशेष टोकन-अनुक्रम को मॉडल द्वारा दी गई प्रायिकता का होता है। यहाँ, यह दर्शाता है कि दिए गए पिछले टोकनों को देखते हुए जनरेट किए गए टोकनों (टेक्स्ट) के वैध होने के बारे में मॉडल कितना “आत्मविश्वासी” है।
दोनों तकनीकों को लागू करने के बाद, हम उनकी संबंधित लेटेंसी माप सकते हैं। स्पेक्युलेटिव डिकोडिंग में, हम लॉग-लाइकलीहुड वैल्यू देखकर परफॉर्मेंस का आकलन करते हैं। शून्य के करीब (विशेषकर निगेटिव रेंज में) लॉग-लाइकलीहुड दर्शाता है कि जनरेट किया गया टेक्स्ट सटीक है।
def measure_latency(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Measure latency for normal inference (big model only)
    start_time = time.time()
    normal_output = normal_inference(big_model, big_tokenizer, prompt, max_new_tokens)
    normal_inference_latency = time.time() - start_time
    print(f"Normal Inference Output: {normal_output}")
    print(f"Normal Inference Latency: {normal_inference_latency:.4f} seconds")
    print("\n\n")

    # Measure latency for speculative decoding
    start_time = time.time()
    speculative_output, log_likelihood = speculative_decoding(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    speculative_decoding_latency = time.time() - start_time
    print(f"Speculative Decoding Output: {speculative_output}")
    print(f"Speculative Decoding Latency: {speculative_decoding_latency:.4f} seconds")
    print(f"Log Likelihood (Verification Score): {log_likelihood:.4f}")

    return normal_inference_latency, speculative_decoding_latency
इससे निम्नलिखित प्राप्त होता है:
कम लेटेंसी का श्रेय छोटे मॉडल द्वारा टेक्स्ट जनरेशन में कम समय लगने और बड़े मॉडल द्वारा केवल सत्यापन में कम समय लगने को जाता है।
आइए पाँच प्रॉम्प्ट्स के जरिए स्पेक्युलेटिव डिकोडिंग की तुलना ऑटोरेग्रेसिव इन्फरेंस से करें:
# List of 5 prompts
prompts = [
    "The future of artificial intelligence is ",
    "Machine learning is transforming the world by ",
    "Natural language processing enables computers to understand ",
    "Generative models like GPT-3 can create ",
    "AI ethics and fairness are important considerations for "
]

# Inference settings
max_new_tokens = 200

# Initialize accumulators for latency, memory, and tokens per second
total_tokens_per_sec_normal = 0
total_tokens_per_sec_speculative = 0
total_normal_latency = 0
total_speculative_latency = 0

# Perform inference on each prompt and accumulate the results
for prompt in prompts:
    normal_latency, speculative_latency, _, _, tokens_per_sec_normal, tokens_per_sec_speculative = measure_latency_and_memory(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    total_tokens_per_sec_normal += tokens_per_sec_normal
    total_tokens_per_sec_speculative += tokens_per_sec_speculative
    total_normal_latency += normal_latency
    total_speculative_latency += speculative_latency

# Calculate averages
average_tokens_per_sec_normal = total_tokens_per_sec_normal / len(prompts)
average_tokens_per_sec_speculative = total_tokens_per_sec_speculative / len(prompts)
average_normal_latency = total_normal_latency / len(prompts)
average_speculative_latency = total_speculative_latency / len(prompts)

# Output the averages
print(f"Average Normal Inference Latency: {average_normal_latency:.4f} seconds")
print(f"Average Speculative Decoding Latency: {average_speculative_latency:.4f} seconds")
print(f"Average Normal Inference Tokens per second: {average_tokens_per_sec_normal:.2f} tokens/second")
print(f"Average Speculative Decoding Tokens per second: {average_tokens_per_sec_speculative:.2f} tokens/second")
Average Normal Inference Latency: 25.0876 seconds
Average Speculative Decoding Latency: 15.7802 seconds
Average Normal Inference Tokens per second: 7.97 tokens/second
Average Speculative Decoding Tokens per second: 12.68 tokens/secondयह दर्शाता है कि स्पेक्युलेटिव डिकोडिंग अधिक दक्ष है—यह सामान्य इन्फरेंस की तुलना में प्रति सेकंड अधिक टोकन जनरेट करती है। यह सुधार इसलिए है क्योंकि छोटा मॉडल अधिकांश टेक्स्ट जनरेशन संभालता है, जबकि बड़े मॉडल की भूमिका केवल सत्यापन तक सीमित रहती है, जिससे कुल मिलाकर लेटेंसी और मेमोरी दोनों के संदर्भ में कम्प्यूटेशनल लोड कम हो जाता है।
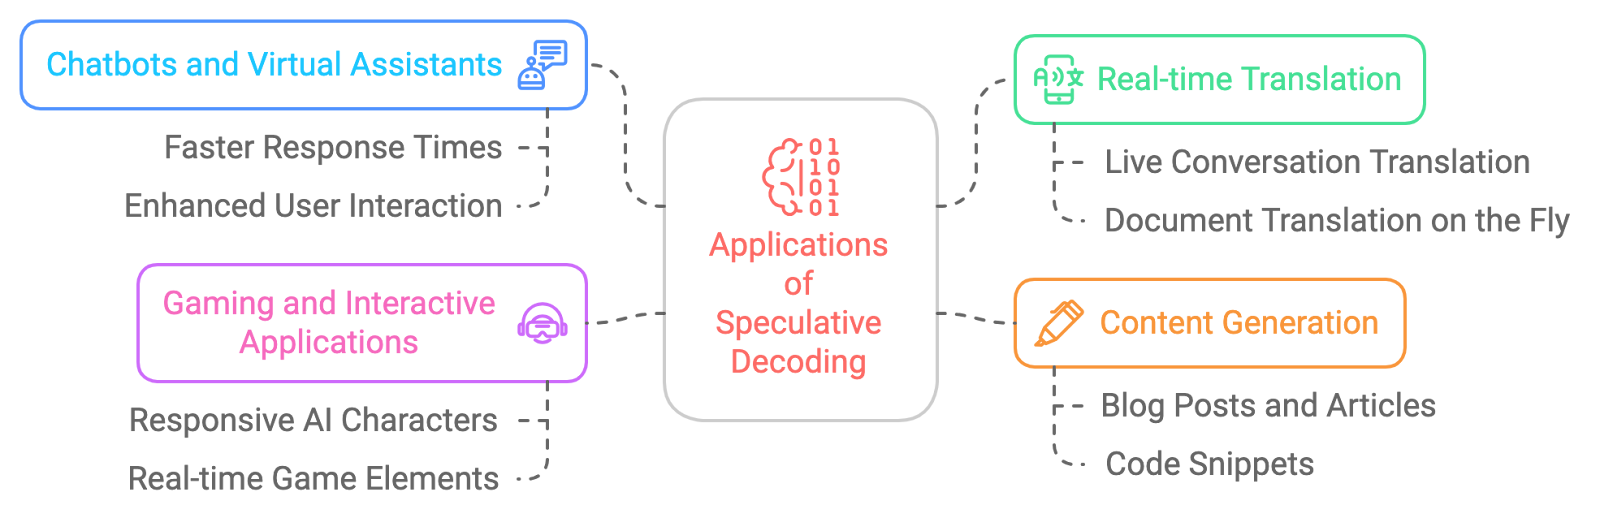
इन मेमोरी आवश्यकताओं के साथ, हम आसानी से एज डिवाइसेस पर स्पेक्युलेटिव डिकोडिंग तैनात कर सकते हैं और अपने ऑन-डिवाइस अनुप्रयोगों—जैसे चैटबॉट्स, भाषा अनुवादक, गेम्स आदि—में गति-वृद्धि पा सकते हैं।
ऊपर दिया गया दृष्टिकोण कुशल है, लेकिन ऑन-डिवाइस इन्फरेंस के लिए लेटेंसी और मेमोरी अनुकूलन के बीच समझौता रहता है। इसे संबोधित करने के लिए, आइए छोटे और बड़े—दोनों मॉडलों पर क्वांटाइज़ेशन लागू करें। आप केवल बड़े मॉडल पर क्वांटाइज़ेशन लागू करके भी प्रयोग कर सकते हैं, क्योंकि छोटा मॉडल पहले से ही कम जगह लेता है।
क्वांटाइज़ेशन Hugging Face की transformers लाइब्रेरी के BitsAndBytesConfig कॉन्फ़िगरेशन से छोटे और बड़े दोनों मॉडलों पर लागू किया जाता है। क्वांटाइज़ेशन मॉडल के वेट्स को अधिक कॉम्पैक्ट रूप में बदलकर मेमोरी उपयोग को काफी कम कर देता है और कई मामलों में इन्फरेंस स्पीड भी बढ़ा देता है।
क्वांटाइज़ेशन के प्रभाव देखने के लिए ऊपर दिए कोड में निम्न स्निपेट जोड़ें।
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # Enables 4-bit quantization
    bnb_4bit_quant_type="nf4",  # Specifies the quantization type (nf4)
    bnb_4bit_compute_dtype=torch.bfloat16,  # Uses bfloat16 for computation
    bnb_4bit_use_double_quant=False,  # Disables double quantization to avoid additional overhead
)

# Load the smaller and larger Gemma2 models with quantization applied
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", quantization_config=bnb_config)
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", quantization_config=bnb_config)
यहाँ स्पेक्युलेटिव डिकोडिंग के, क्वांटाइज़ेशन के साथ और बिना, प्रभाव दिखाने के लिए आउटपुट का एक त्वरित तुलना-चित्र है:
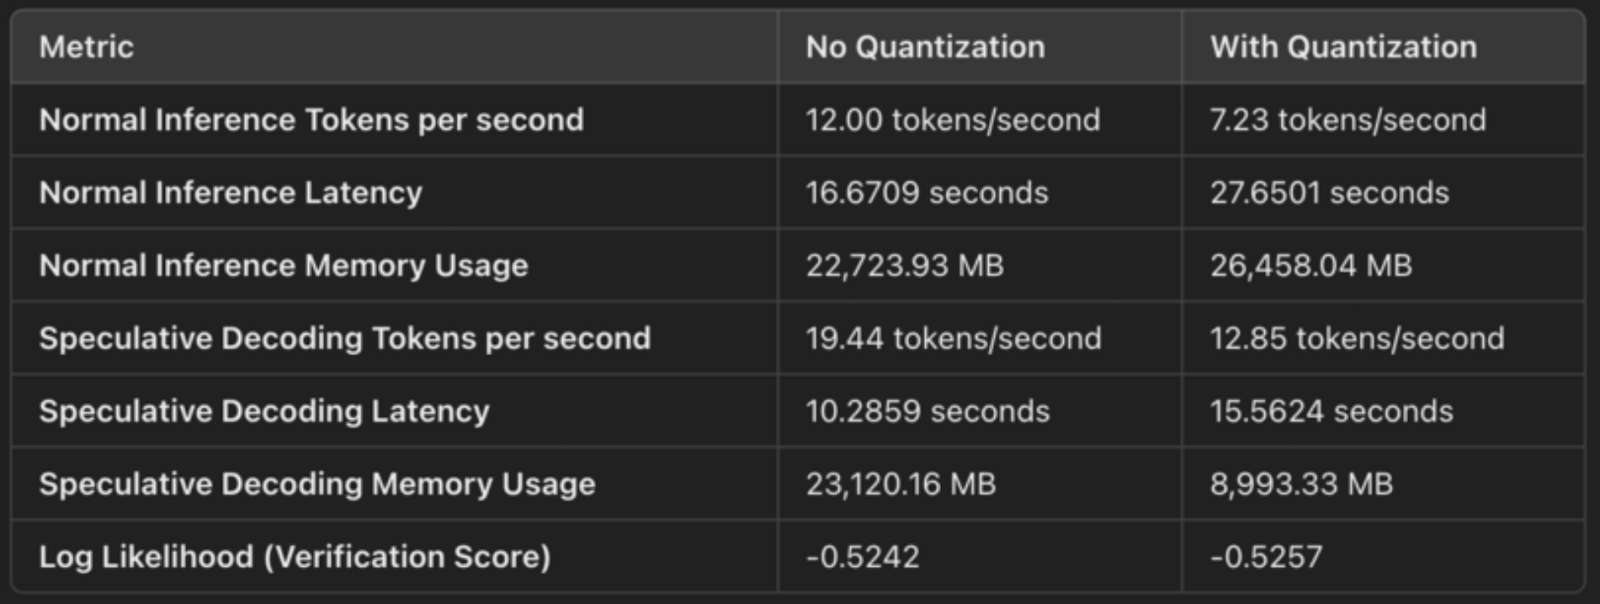
कॉन्फ़िगरेशन में load_in_4bit=True निर्दिष्ट है, यानी मॉडल के वेट्स को उनके मूल 32-बिट या 16-बिट फ्लोटिंग-पॉइंट फ़ॉर्मैट से 4-बिट इन्टीजर्स में क्वांटाइज़ किया जाता है। इससे मॉडल का मेमोरी फूटप्रिंट घटता है। क्वांटाइज़ेशन वेट्स को कंप्रेस करता है, जिससे उन्हें अधिक कुशलता से स्टोर और ऑपरेट किया जा सके। ये हैं ठोस मेमोरी लाभ:
कॉन्फ़िगरेशन bnb_4bit_compute_dtype=torch.bfloat16 बताता है कि कम्प्यूटेशन bfloat16 (BF16) में होगा—यह एक कुशल फ्लोटिंग-पॉइंट फ़ॉर्मैट है। BF16 का डायनेमिक रेंज FP16 से व्यापक है, और यह FP32 की तुलना में आधी मेमोरी लेता है—प्रिसिजन और परफॉर्मेंस के बीच अच्छा संतुलन।
BF16 का उपयोग—खासकर NVIDIA GPUs (जैसे A100) पर—टेंसर कोर्स का लाभ उठाता है, जो BF16 ऑपरेशंस के लिए ऑप्टिमाइज़्ड हैं। इससे इन्फरेंस के दौरान मैट्रिक्स मल्टिप्लिकेशन और अन्य गणनाएँ तेज़ हो जाती हैं।
स्पेक्युलेटिव डिकोडिंग में, लेटेंसी में सुधार दिखता है:
कम मेमोरी फूटप्रिंट का मतलब तेज़ मेमोरी एक्सेस और GPU संसाधनों का अधिक कुशल उपयोग—जिससे जनरेशन तेज़ होती है।
bnb_4bit_quant_type="nf4" विकल्प नॉर्म-फोर क्वांटाइज़ेशन (NF4) निर्दिष्ट करता है, जो न्यूरल नेटवर्क्स के लिए अनुकूलित है। NF4 महत्वपूर्ण हिस्सों की प्रिसिजन को बनाए रखने में मदद करता है, भले ही वेट्स 4-बिट में दर्शाए गए हों—इससे साधारण 4-बिट क्वांटाइज़ेशन की तुलना में मॉडल परफॉर्मेंस में गिरावट न्यूनतम रहती है।
NF4 4-बिट क्वांटाइज़ेशन की कॉम्पैक्टनेस और मॉडल की सटीकता—दोनों के बीच संतुलन बनाता है, जिससे परफॉर्मेंस मूल के क़रीब रहते हुए मेमोरी उपयोग में भारी कटौती मिलती है।
डबल क्वांटाइज़ेशन (bnb_4bit_use_double_quant=False) 4-बिट वेट्स के ऊपर एक अतिरिक्त क्वांटाइज़ेशन परत जोड़ता है—यह मेमोरी और कम कर सकता है, पर कम्प्यूटेशनल ओवरहेड भी बढ़ाता है। यहाँ इन्फरेंस को धीमा होने से बचाने के लिए डबल क्वांटाइज़ेशन को बंद रखा गया है।
स्पेक्युलेटिव डिकोडिंग के संभावित उपयोग व्यापक और रोमांचक हैं। कुछ उदाहरण:
जहाँ स्पेक्युलेटिव डिकोडिंग अत्यधिक संभावनाएँ रखती है, वहीं कुछ चुनौतियाँ भी हैं:
स्पेक्युलेटिव डिकोडिंग एक शक्तिशाली तकनीक है जो बड़े भाषा मॉडलों के साथ हमारी इंटरैक्शन को बदलने की क्षमता रखती है। यह जनरेट किए गए टेक्स्ट की गुणवत्ता से समझौता किए बिना LLM इन्फरेंस को उल्लेखनीय रूप से तेज़ कर सकती है। यद्यपि कुछ चुनौतियाँ हैं, स्पेक्युलेटिव डिकोडिंग के लाभ स्पष्ट हैं और आने वाले वर्षों में इसकी अपनाने की दर बढ़ने की उम्मीद है—जिससे तेज़, अधिक रेस्पॉन्सिव और अधिक कुशल AI अनुप्रयोगों की एक नई पीढ़ी सक्षम होगी।
इन पाठ्यक्रमों के साथ AI सीखें!
लर्निंग पाथ
कोर्स
कोर्स