
Lộ trình
Phát triển các ứng dụng trí tuệ nhân tạo
21 giờ
LLM rất mạnh mẽ, nhưng đôi khi có thể hơi chậm, điều này không lý tưởng trong các tình huống cần tốc độ. Speculative decoding là một kỹ thuật giúp tăng tốc LLM bằng cách tạo phản hồi nhanh hơn mà không làm giảm chất lượng.
Về bản chất, đây là cách “đoán trước” trong quá trình sinh văn bản, đưa ra dự đoán về những từ có thể xuất hiện tiếp theo, đồng thời vẫn đảm bảo độ chính xác và chiều sâu như mong đợi ở LLM.
Trong bài viết này, tôi sẽ giải thích speculative decoding là gì, cách thức hoạt động và cách triển khai với các mô hình Gemma 2.
Speculative decoding tăng tốc LLM bằng cách kết hợp một mô hình nhỏ hơn, nhanh hơn để tạo ra các dự đoán sơ bộ. Mô hình nhỏ này, thường gọi là mô hình “nháp”, sẽ sinh một loạt token mà mô hình LLM chính, mạnh hơn, có thể xác nhận hoặc tinh chỉnh. Mô hình nháp đóng vai trò lượt chạy đầu, tạo ra nhiều token để đẩy nhanh quá trình sinh văn bản.
Thay vì LLM chính sinh tuần tự từng token, mô hình nháp cung cấp một tập các ứng viên tiềm năng và mô hình chính đánh giá chúng song song. Cách này giảm tải tính toán cho LLM chính bằng cách chuyển phần dự đoán ban đầu sang mô hình nháp, cho phép mô hình chính chỉ tập trung vào việc hiệu chỉnh hoặc xác nhận.
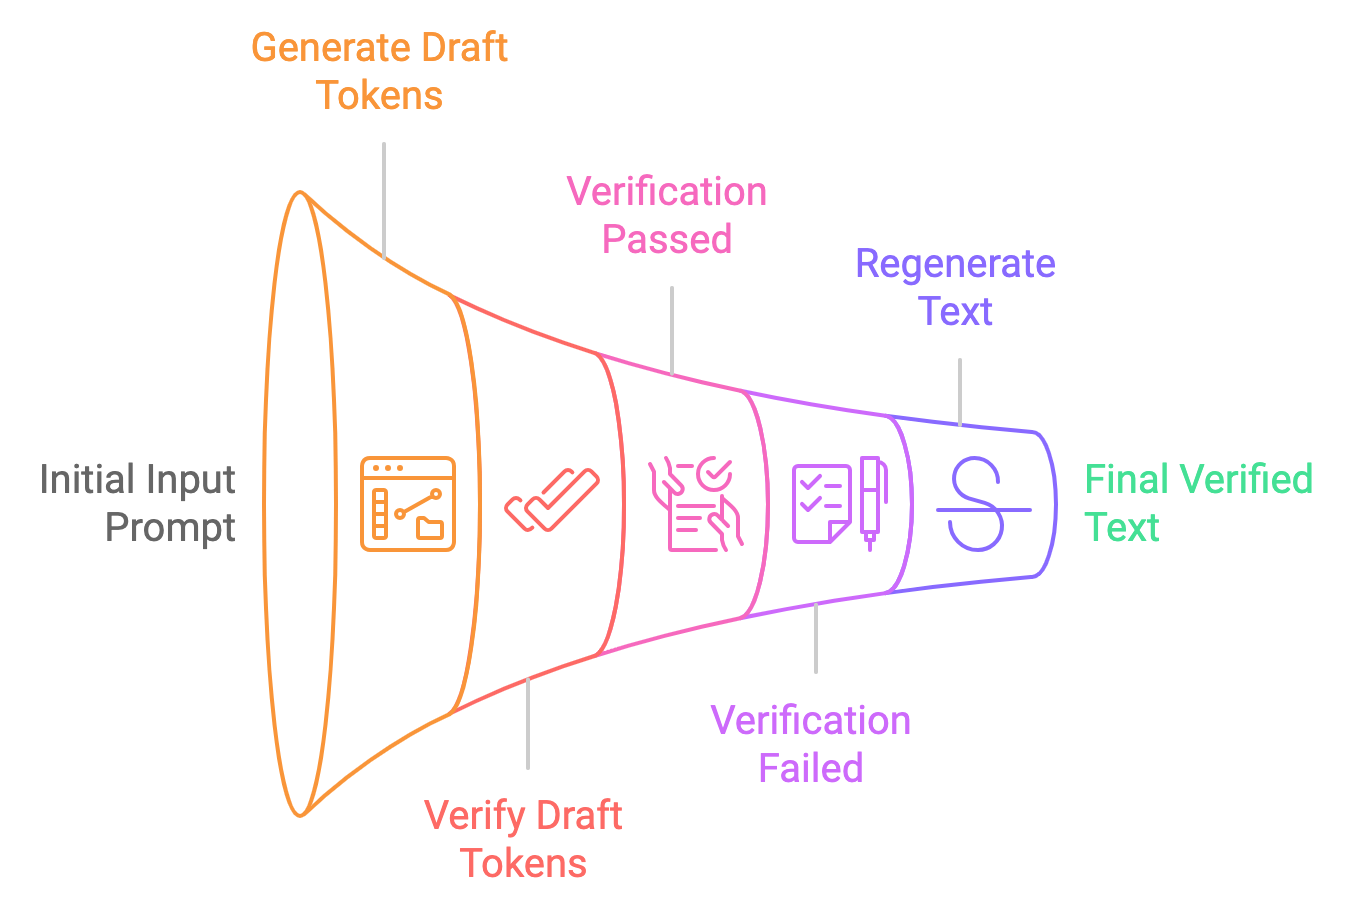
Hãy hình dung như một nhà văn với một biên tập viên. LLM chính là nhà văn, có thể tạo ra văn bản chất lượng cao nhưng chậm hơn. Mô hình “nháp” nhỏ, nhanh đóng vai biên tập viên, nhanh chóng đề xuất các hướng tiếp nối văn bản. LLM chính sau đó đánh giá các gợi ý này, giữ lại phần chính xác và loại bỏ phần còn lại. Nhờ vậy, LLM có thể xử lý nhiều token đồng thời, tăng tốc độ sinh văn bản.
Hãy phân rã quy trình speculative decoding thành các bước đơn giản:
Giải mã truyền thống xử lý từng token một, gây độ trễ cao, trong khi speculative decoding cho phép mô hình nhỏ sinh token theo lô và mô hình lớn xác minh. Điều này có thể giảm thời gian phản hồi 30–40%, cắt độ trễ từ 25–30 giây xuống chỉ còn khoảng 15–18 giây.
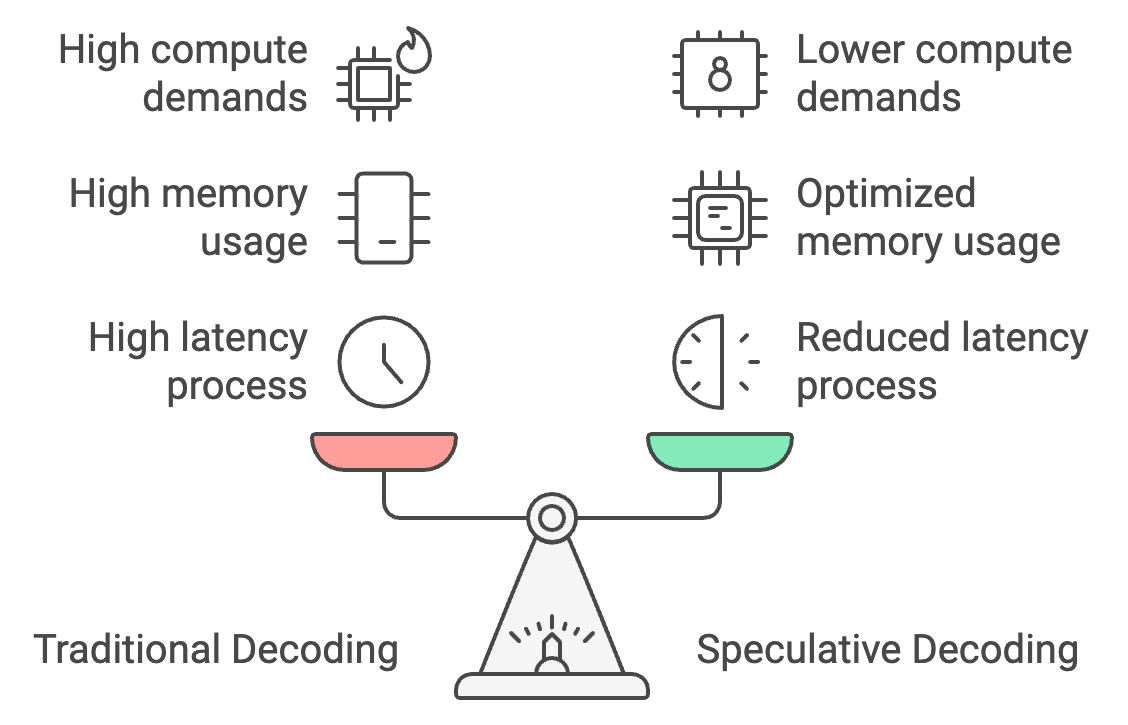
Ngoài ra, speculative decoding tối ưu hóa bộ nhớ bằng cách chuyển phần lớn việc sinh token sang mô hình nhỏ hơn, giảm yêu cầu bộ nhớ từ 26 GB xuống khoảng 14 GB và giúp suy luận trên thiết bị dễ tiếp cận hơn.
Cuối cùng, nó giảm nhu cầu tính toán 50%, vì mô hình lớn chỉ xác minh thay vì sinh token, cho phép vận hành mượt hơn trên thiết bị di động cấu hình hạn chế và tránh quá nhiệt.
Để triển khai một ví dụ thực hành speculative decoding bằng các mô hình Gemma2. Chúng ta sẽ khám phá cách speculative decoding so sánh với suy luận tiêu chuẩn về cả độ trễ và hiệu năng.
Bắt đầu bằng cách import các phụ thuộc và đặt seed.
Tiếp theo, kiểm tra xem máy bạn dùng có GPU không. Điều này chủ yếu cần cho các mô hình lớn như Gemma 2-9B-it hoặc LLama2-13B.
Cuối cùng, chúng ta tải cả mô hình nhỏ và lớn cùng tokenizer của chúng. Ở đây, chúng ta dùng mô hình Gemma2-2b-it (instruct) làm mô hình nháp và Gemma2-9b-it để xác minh.
Cũng có một vài mô hình khác có thể dùng thay thế. Ví dụ:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

# Set Seed
set_seed(42)

# Check if GPU is available
device = "cuda" if torch.cuda.is_available() else "cpu"

# Load the smaller Gemma2 model (draft generation)
small_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-2b-it", device_map="auto")
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", torch_dtype=torch.bfloat16)

# Load the larger Gemma2 model (verification)
big_tokenizer = AutoTokenizer.from_pretrained("google/gemma-2-9b-it", device_map="auto")
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", torch_dtype=torch.bfloat16)Đầu tiên, chúng ta thực hiện suy luận chỉ trên mô hình lớn (Gemma2-9b-it) và tạo đầu ra. Bắt đầu bằng cách token hóa prompt đầu vào và chuyển token sang thiết bị phù hợp (GPU nếu có). Phương thức generate tạo đầu ra của mô hình, sinh tối đa max_new_tokens. Kết quả sau đó được giải mã từ ID token về văn bản có thể đọc được.
def normal_inference(big_model, big_tokenizer, prompt, max_new_tokens=50):
    inputs = big_tokenizer(prompt, return_tensors='pt').to(device)
    outputs = big_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
return big_tokenizer.decode(outputs[0], skip_special_tokens=True)Tiếp theo, chúng ta thử phương pháp speculative decoding với các bước sau:
def speculative_decoding(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Step 1: Use the small model to generate the draft
    inputs = small_tokenizer(prompt, return_tensors='pt').to(device)
    small_outputs = small_model.generate(inputs['input_ids'], max_new_tokens=max_new_tokens)
    draft = small_tokenizer.decode(small_outputs[0], skip_special_tokens=True)

    # Step 2: Verify the draft with the big model
    big_inputs = big_tokenizer(draft, return_tensors='pt').to(device)

    # Step 3: Calculate log-likelihood of the draft tokens under the large model
    with torch.no_grad():
        outputs = big_model(big_inputs['input_ids'])
        log_probs = torch.log_softmax(outputs.logits, dim=-1)

    draft_token_ids = big_inputs['input_ids']
    log_likelihood = 0
    for i in range(draft_token_ids.size(1) - 1):
        token_id = draft_token_ids[0, i + 1]
        log_likelihood += log_probs[0, i, token_id].item()

    avg_log_likelihood = log_likelihood / (draft_token_ids.size(1) - 1)

    # Return the draft and its log-likelihood score
    return draft, avg_log_likelihood
Lưu ý: Log-likelihood là log của xác suất mà mô hình gán cho một chuỗi token cụ thể. Ở đây, nó phản ánh mức “tự tin” của mô hình rằng chuỗi token (văn bản sinh ra) là hợp lệ dựa trên các token trước đó.
Sau khi triển khai cả hai kỹ thuật, chúng ta có thể đo độ trễ tương ứng. Với speculative decoding, chúng ta đánh giá hiệu năng bằng cách xem xét giá trị log-likelihood. Giá trị log-likelihood tiến về 0, đặc biệt ở miền âm, cho thấy văn bản sinh ra là chính xác.
def measure_latency(small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens=50):
    # Measure latency for normal inference (big model only)
    start_time = time.time()
    normal_output = normal_inference(big_model, big_tokenizer, prompt, max_new_tokens)
    normal_inference_latency = time.time() - start_time
    print(f"Normal Inference Output: {normal_output}")
    print(f"Normal Inference Latency: {normal_inference_latency:.4f} seconds")
    print("\n\n")

    # Measure latency for speculative decoding
    start_time = time.time()
    speculative_output, log_likelihood = speculative_decoding(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    speculative_decoding_latency = time.time() - start_time
    print(f"Speculative Decoding Output: {speculative_output}")
    print(f"Speculative Decoding Latency: {speculative_decoding_latency:.4f} seconds")
    print(f"Log Likelihood (Verification Score): {log_likelihood:.4f}")

    return normal_inference_latency, speculative_decoding_latency
Kết quả trả về:
Độ trễ thấp hơn là nhờ mô hình nhỏ tốn ít thời gian để sinh văn bản và mô hình lớn tốn ít thời gian hơn vì chỉ xác minh văn bản đã sinh.
Hãy so sánh speculative decoding với suy luận tự hồi quy bằng năm prompt sau:
# List of 5 prompts
prompts = [
    "The future of artificial intelligence is ",
    "Machine learning is transforming the world by ",
    "Natural language processing enables computers to understand ",
    "Generative models like GPT-3 can create ",
    "AI ethics and fairness are important considerations for "
]

# Inference settings
max_new_tokens = 200

# Initialize accumulators for latency, memory, and tokens per second
total_tokens_per_sec_normal = 0
total_tokens_per_sec_speculative = 0
total_normal_latency = 0
total_speculative_latency = 0

# Perform inference on each prompt and accumulate the results
for prompt in prompts:
    normal_latency, speculative_latency, _, _, tokens_per_sec_normal, tokens_per_sec_speculative = measure_latency_and_memory(
        small_model, big_model, small_tokenizer, big_tokenizer, prompt, max_new_tokens
    )
    total_tokens_per_sec_normal += tokens_per_sec_normal
    total_tokens_per_sec_speculative += tokens_per_sec_speculative
    total_normal_latency += normal_latency
    total_speculative_latency += speculative_latency

# Calculate averages
average_tokens_per_sec_normal = total_tokens_per_sec_normal / len(prompts)
average_tokens_per_sec_speculative = total_tokens_per_sec_speculative / len(prompts)
average_normal_latency = total_normal_latency / len(prompts)
average_speculative_latency = total_speculative_latency / len(prompts)

# Output the averages
print(f"Average Normal Inference Latency: {average_normal_latency:.4f} seconds")
print(f"Average Speculative Decoding Latency: {average_speculative_latency:.4f} seconds")
print(f"Average Normal Inference Tokens per second: {average_tokens_per_sec_normal:.2f} tokens/second")
print(f"Average Speculative Decoding Tokens per second: {average_tokens_per_sec_speculative:.2f} tokens/second")
Average Normal Inference Latency: 25.0876 seconds
Average Speculative Decoding Latency: 15.7802 seconds
Average Normal Inference Tokens per second: 7.97 tokens/second
Average Speculative Decoding Tokens per second: 12.68 tokens/secondĐiều này cho thấy speculative decoding hiệu quả hơn, tạo ra nhiều token mỗi giây hơn so với suy luận bình thường. Cải thiện này là do mô hình nhỏ đảm nhận phần lớn việc sinh văn bản, trong khi vai trò của mô hình lớn chỉ là xác minh, giúp giảm tải tính toán tổng thể về độ trễ và bộ nhớ.
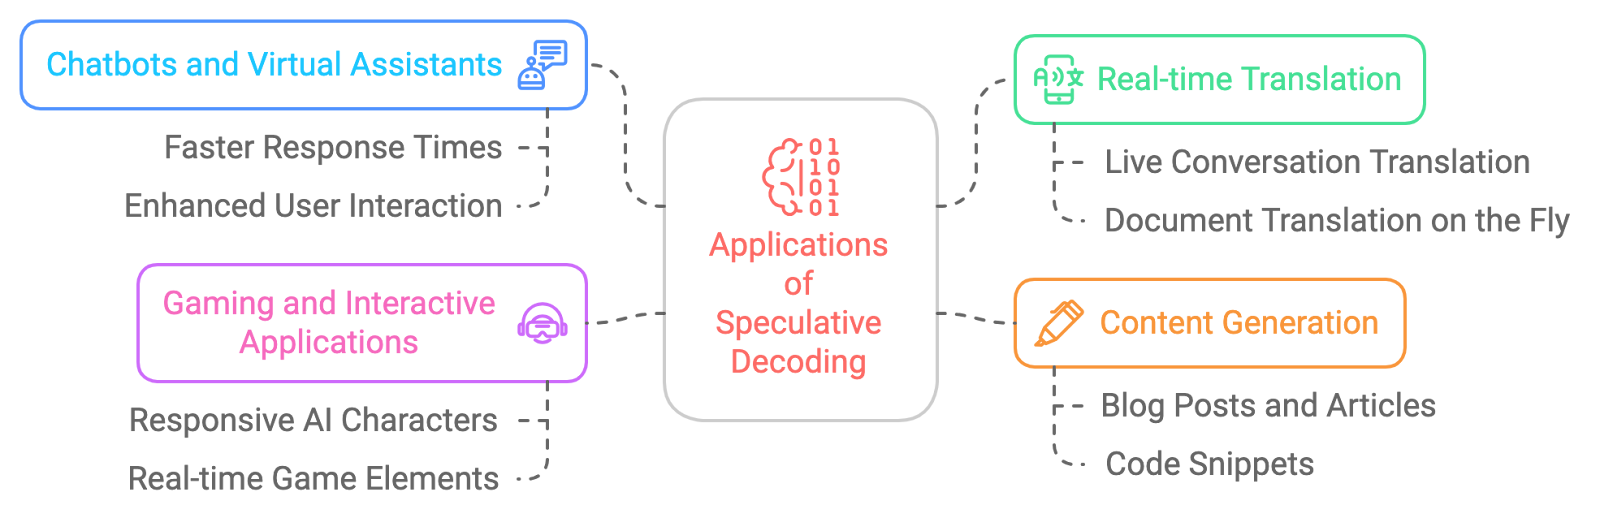
Với các yêu cầu bộ nhớ này, chúng ta có thể dễ dàng triển khai kỹ thuật speculative decoding trên thiết bị biên và tăng tốc cho các ứng dụng on-device như chatbot, bộ dịch ngôn ngữ, trò chơi, v.v.
Cách tiếp cận ở trên hiệu quả, nhưng có đánh đổi giữa độ trễ và tối ưu bộ nhớ cho suy luận trên thiết bị. Để giải quyết, hãy áp dụng quantization cho cả mô hình nhỏ và lớn. Bạn có thể thử nghiệm và chỉ áp dụng lượng tử hóa cho mô hình lớn vì mô hình nhỏ vốn đã chiếm ít dung lượng nhất.
Lượng tử hóa được áp dụng cho mô hình nhỏ và lớn bằng cấu hình BitsAndBytesConfig từ thư viện transformers của Hugging Face. Quantization cho phép giảm đáng kể mức sử dụng bộ nhớ và trong nhiều trường hợp cải thiện tốc độ suy luận bằng cách chuyển trọng số của mô hình sang dạng gọn hơn.
Thêm đoạn mã sau vào code ở trên để quan sát hiệu ứng của lượng tử hóa.
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # Enables 4-bit quantization
    bnb_4bit_quant_type="nf4",  # Specifies the quantization type (nf4)
    bnb_4bit_compute_dtype=torch.bfloat16,  # Uses bfloat16 for computation
    bnb_4bit_use_double_quant=False,  # Disables double quantization to avoid additional overhead
)

# Load the smaller and larger Gemma2 models with quantization applied
small_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-2b-it", device_map="auto", quantization_config=bnb_config)
big_model = AutoModelForCausalLM.from_pretrained("google/gemma-2-9b-it", device_map="auto", quantization_config=bnb_config)
Dưới đây là so sánh nhanh đầu ra để minh họa tác động của speculative decoding khi có và không có lượng tử hóa:
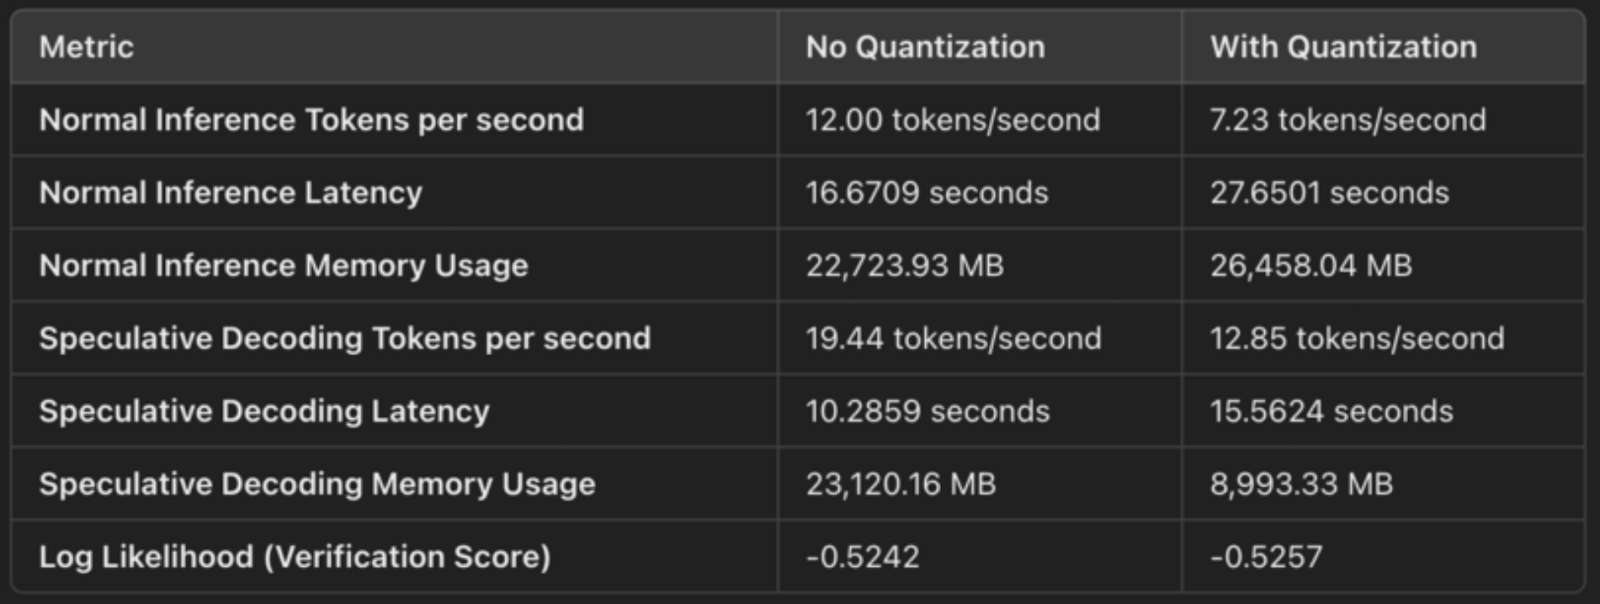
Cấu hình đặt load_in_4bit=True, nghĩa là trọng số của mô hình được lượng tử hóa từ dạng số thực 32-bit hoặc 16-bit về số nguyên 4-bit. Điều này giảm dấu chân bộ nhớ của mô hình. Lượng tử hóa nén trọng số, cho phép lưu trữ và xử lý hiệu quả hơn. Đây là các con số tiết kiệm bộ nhớ cụ thể:
Cấu hình bnb_4bit_compute_dtype=torch.bfloat16 chỉ định tính toán sử dụng bfloat16 (BF16), một định dạng số thực hiệu quả hơn. BF16 có miền động rộng hơn FP16 nhưng chỉ chiếm một nửa bộ nhớ so với FP32, cân bằng tốt giữa độ chính xác và hiệu năng.
Dùng BF16, đặc biệt trên GPU NVIDIA (như A100), sẽ tận dụng Tensor Cores tối ưu cho phép toán BF16. Kết quả là nhân ma trận và các phép tính khác trong suy luận nhanh hơn.
Với speculative decoding, chúng ta thấy độ trễ được cải thiện:
Dấu chân bộ nhớ nhỏ hơn đồng nghĩa truy cập bộ nhớ nhanh hơn và sử dụng tài nguyên GPU hiệu quả hơn, dẫn tới tốc độ sinh nhanh hơn.
Tùy chọn bnb_4bit_quant_type="nf4" chỉ định Norm-Four Quantization (NF4), được tối ưu cho mạng nơ-ron. Lượng tử hóa NF4 giúp giữ lại độ chính xác ở các phần quan trọng của mô hình, dù trọng số được biểu diễn ở 4 bit. Điều này giảm thiểu suy giảm hiệu năng so với lượng tử hóa 4-bit đơn giản.
NF4 giúp cân bằng giữa độ gọn nhẹ của 4-bit và độ chính xác trong dự đoán, đảm bảo hiệu năng gần với bản gốc trong khi giảm mạnh mức dùng bộ nhớ.
Double quantization (bnb_4bit_use_double_quant=False) thêm một lớp lượng tử hóa nữa trên trọng số 4-bit, có thể giảm thêm bộ nhớ nhưng cũng tăng chi phí tính toán. Ở đây, double quantization được tắt để tránh làm chậm suy luận.
Tiềm năng ứng dụng của speculative decoding rất rộng và thú vị. Ví dụ:
Dù speculative decoding đầy hứa hẹn, vẫn tồn tại những thách thức:
Speculative decoding là một kỹ thuật mạnh mẽ có tiềm năng thay đổi cách chúng ta tương tác với các mô hình ngôn ngữ lớn. Nó có thể tăng tốc suy luận LLM đáng kể mà không làm giảm chất lượng văn bản sinh ra. Dù còn những thách thức cần vượt qua, lợi ích của speculative decoding là không thể phủ nhận, và chúng ta có thể kỳ vọng mức độ ứng dụng sẽ tăng trong những năm tới, mở đường cho thế hệ ứng dụng AI nhanh hơn, phản hồi tốt hơn và hiệu quả hơn.
Học AI với các khóa học này!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
