{count, plural, one {Program} other {Program}}
Pengembangan Aplikasi Kecerdasan Buatan
{hours} jam
Large language models (LLMs) sering kali kurang optimal untuk tugas yang membutuhkan banyak pengetahuan dan informasi yang mutakhir serta tepat. Di sinilah retrieval-augmented generation (RAG) berperan, menggabungkan kemampuan generatif LLM dengan basis pengetahuan eksternal untuk meningkatkan akurasi dan relevansi.
Meski efektif, sistem RAG tradisional menghadapi tantangan dalam menangani dokumen yang panjang dan kompleks, sehingga meningkatkan latensi dan terkadang menghasilkan jawaban yang kurang akurat. Untuk mengatasi hal ini, konsep speculative RAG muncul sebagai solusi yang menjanjikan. Mari kita bahas lebih lanjut.
Speculative retrieval-augmented generation (RAG) adalah kerangka kerja inovatif yang dirancang untuk meningkatkan efisiensi dan akurasi sistem RAG dengan membagi proses generasi menjadi dua langkah terpisah:
Mari memahami speculative RAG dengan menelaah diagram berikut:
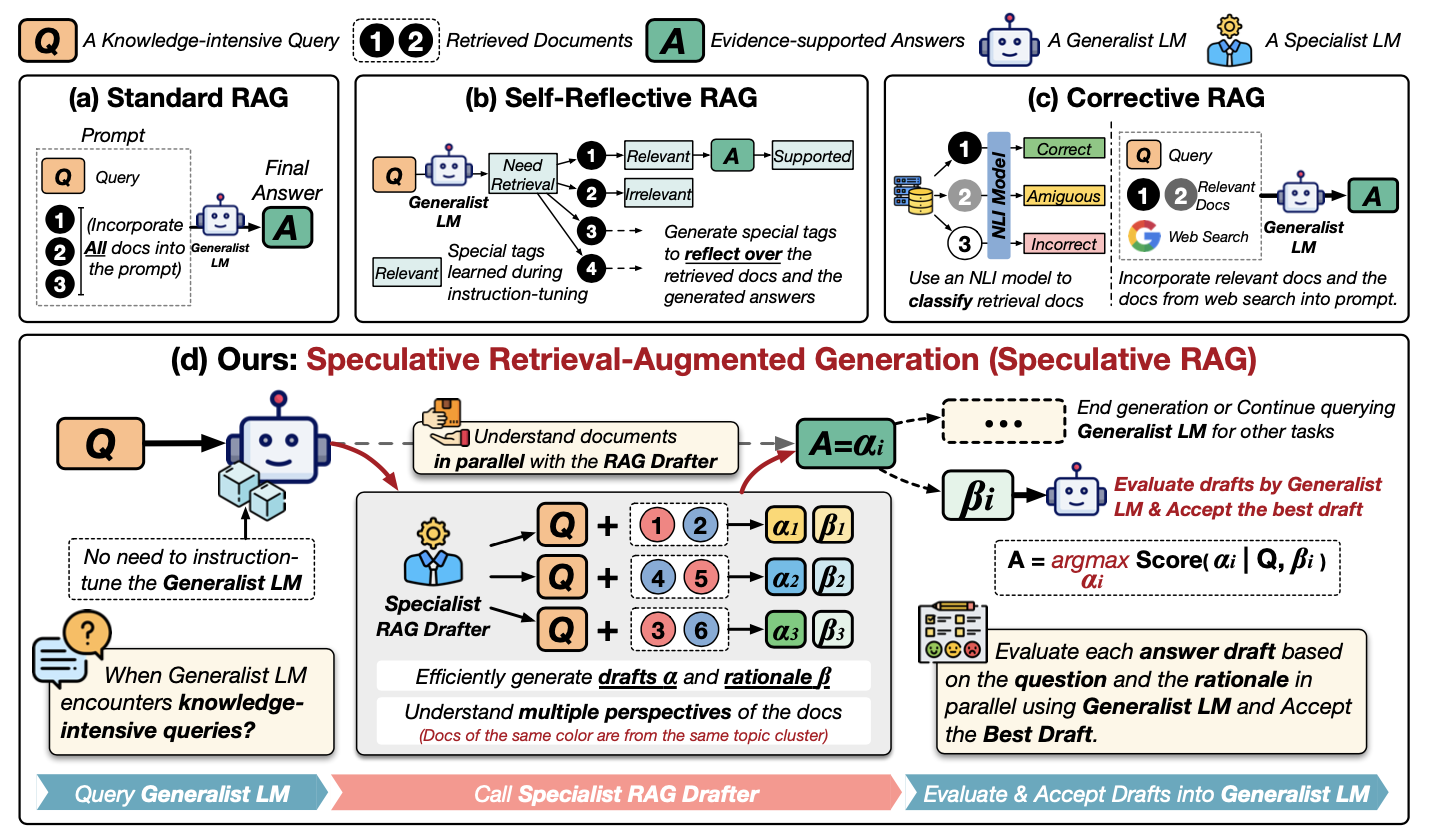
Sumber: Wang et al., 2024
Mari kita telusuri diagram ini langkah demi langkah. Diagram ini menunjukkan berbagai cara menggunakan informasi eksternal untuk membantu LLM menjawab pertanyaan, dengan fokus pada metode baru bernama Speculative RAG. Berikut metode pada baris pertama:
Sekarang, mari cermati (d) Speculative RAG:
Pada dasarnya, speculative RAG seperti memiliki tim ahli: drafter membuat opsi, dan LLM generalis mengambil keputusan akhir. Ini membuat proses lebih cepat dan berpotensi lebih akurat.
Speculative RAG menawarkan beberapa keunggulan utama dibanding sistem RAG tradisional:
Dengan menggunakan RAG Drafter yang terspesialisasi untuk menghasilkan beberapa draf dari subset dokumen yang beragam, Speculative RAG meningkatkan akurasi keluaran akhir. Pendekatan ini memungkinkan sistem mempertimbangkan berbagai perspektif, sehingga mengurangi kemungkinan menghasilkan jawaban yang salah atau bias. Dalam eksperimen, Speculative RAG menunjukkan peningkatan akurasi hingga 12,97% pada tolok ukur seperti PubHealth dibanding sistem RAG konvensional.
Salah satu tantangan terbesar pada sistem RAG tradisional adalah meningkatnya latensi akibat pemrosesan dokumen yang panjang dan kompleks. Speculative RAG mengatasi masalah ini dengan memindahkan proses penyusunan draf ke LM yang lebih kecil dan efisien, yang dapat menghasilkan draf secara paralel. Pendekatan ini mengurangi waktu pemrosesan keseluruhan, dengan perbaikan latensi hingga 51% dalam beberapa kasus.
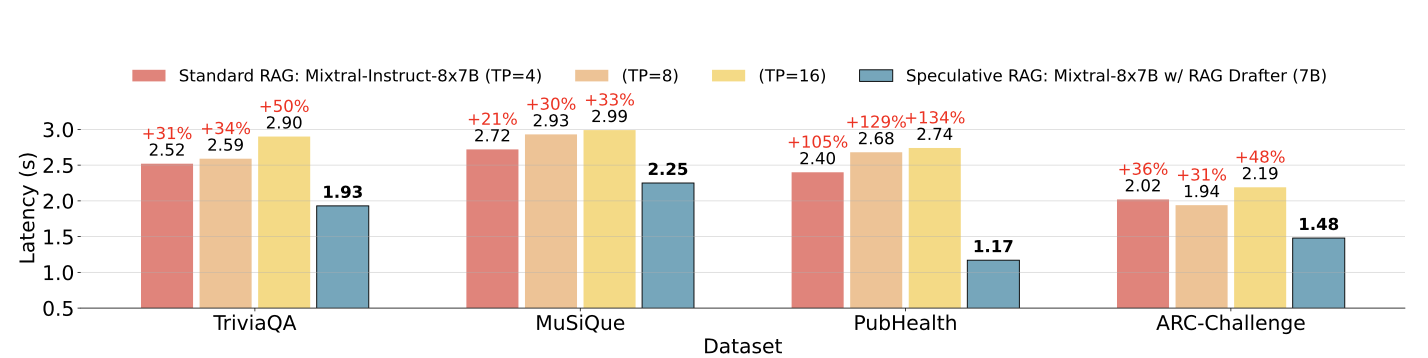
Latensi Speculative RAG vs latensi RAG Standar pada berbagai dataset. Sumber: Wang et al., 2024
Speculative RAG mengoptimalkan penggunaan sumber daya dengan mendelegasikan tugas penyusunan draf ke LM yang lebih kecil, yang secara komputasi lebih ringan dibanding LM generalis yang lebih besar pada sistem RAG tradisional. Pembagian kerja ini tidak hanya mempercepat proses generasi, tetapi juga mengurangi beban komputasi keseluruhan, sehingga lebih efisien.
Kerangka Speculative RAG sangat adaptif dan dapat diterapkan pada berbagai tugas yang membutuhkan banyak pengetahuan tanpa perlu penyesuaian ekstensif. Skalabilitas ini menjadikannya solusi ideal untuk beragam aplikasi, dari tanya jawab hingga analisis dokumen kompleks.
Untuk mengimplementasikan versi sederhana Speculative RAG untuk tugas tanya jawab dasar, kita akan menggunakan dataset kecil dan penyiapan sederhana dengan dua model—model yang lebih kecil untuk penyusunan draf dan model yang lebih besar untuk verifikasi.
Untuk kesederhanaan, kita akan menggunakan pustaka Hugging Face Transformers. Kita akan menunjukkan cara menggunakan model bahasa yang lebih kecil untuk menghasilkan beberapa draf dan model yang lebih besar untuk memverifikasi serta memilih draf terbaik.
Pertama, mari instal pustaka yang diperlukan. Anda perlu memulai ulang sesi setelah memasang pustaka transformers dari HuggingFace. Pastikan Anda telah menambahkan kredensial HuggingFace di bawah secret key di Collab atau editor lainnya.
!pip install transformers torch datasetsUntuk contoh ini, kita akan menggunakan SQuAD (Stanford Question Answering Dataset) yang tersedia dari pustaka datasets milik Hugging Face.
from datasets import load_dataset
# Load the SQuAD dataset
dataset = load_dataset("squad", split="train[:100]") # Using a small subsetKita akan menggunakan dua model pralatih dari pustaka Hugging Face. Model yang lebih kecil (distilbert-base-uncased-distilled-squad) akan bertindak sebagai RAG Drafter dan model yang lebih besar (bert-large-uncased-whole-word-masking-finetuned-squad) akan bertindak sebagai RAG Verifier.
Kemudian, kita akan membangun pipeline Drafter dan verifier dengan model yang dipilih.
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

# Initialize the smaller model (RAG Drafter)
drafter_model_name = "distilbert-base-uncased-distilled-squad"
drafter_model = AutoModelForQuestionAnswering.from_pretrained(drafter_model_name)
drafter_tokenizer = AutoTokenizer.from_pretrained(drafter_model_name)

# Initialize the larger model (RAG Verifier)
verifier_model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
verifier_model = AutoModelForQuestionAnswering.from_pretrained(verifier_model_name)
verifier_tokenizer = AutoTokenizer.from_pretrained(verifier_model_name)

# Set up pipelines
drafter_pipeline = pipeline("question-answering", model=drafter_model, tokenizer=drafter_tokenizer)
verifier_pipeline = pipeline("question-answering", model=verifier_model, tokenizer=verifier_tokenizer)Berikutnya, kita akan mendefinisikan fungsi untuk menghasilkan beberapa draf menggunakan model yang lebih kecil dengan pipeline Drafter yang sudah ditentukan.
def generate_drafts(question, context, num_drafts=3):
   drafts = []
   for _ in range(num_drafts):
       draft = Drafter_pipeline(question=question, context=context)
       drafts.append(draft)
return draftsSekarang kita akan mendefinisikan fungsi verify_drafts() yang menggunakan model yang lebih besar untuk memverifikasi dan memilih draf terbaik berdasarkan skor keyakinan.
Fungsi ini memetakan posisi karakter awal dan akhir dari tiap draf ke posisi token yang sesuai dalam konteks yang ditokenisasi menggunakan offset mapping. Model verifier kemudian memberi skor pada tiap draf berdasarkan keyakinannya bahwa posisi tersebut merupakan jawaban yang benar. Draf dengan skor keyakinan tertinggi dipilih sebagai jawaban terbaik, memastikan keluaran akhir akurat dan andal.
Penanganan yang cermat terhadap perataan token dan penskoran pada fungsi ini menjadi kunci peningkatan kinerja Speculative RAG.
def verify_drafts(question, context, drafts):
    best_draft = None
    highest_score = 0

    # Tokenize the context using the verifier's tokenizer, keeping track of offsets
    inputs = verifier_tokenizer(question, context, return_tensors="pt", return_offsets_mapping=True)
    offset_mapping = inputs['offset_mapping'][0]  # This will give us the character-to-token mapping
    input_ids = inputs['input_ids'][0]

    for draft in drafts:
        start_char = draft['start']
        end_char = draft['end']

        # Find the corresponding token positions using offset mapping
        start_index = None
        end_index = None

        for idx, (start, end) in enumerate(offset_mapping):
            if start_index is None and start_char >= start and start_char < end:
                start_index = idx
            if end_index is None and end_char > start and end_char <= end:
                end_index = idx
            if start_index is not None and end_index is not None:
                break

        # Ensure indices were found and are within bounds
        if (start_index is None or end_index is None or
                start_index >= len(input_ids) or end_index >= len(input_ids)):
            print(f"Draft skipped: Out of bounds or no matching tokens. "
                  f"Start Index: {start_index}, End Index: {end_index}")
            continue

        # Get the confidence score using the larger model
        outputs = verifier_model(input_ids=input_ids.unsqueeze(0))
        score = (outputs.start_logits[0, start_index].item() +
                 outputs.end_logits[0, end_index].item())

        if score > highest_score:
            highest_score = score
            best_draft = draft

    if best_draft is None:
        print("No valid draft found after verification.")

return best_draftSekarang, mari terapkan proses Speculative RAG pada 10 pertanyaan sampel dari dataset.
correct = 0
total = 10  # Evaluate on 10 samples for simplicity

for i in range(total):
    sample = dataset[i]
    question = sample['question']
    context = sample['context']
    drafts = generate_drafts(question, context)
    best_answer = verify_drafts(question, context, drafts)

    print(f"Q: {question}")

    if best_answer is not None:
        print(f"A: {best_answer['answer']}\n")
        # For simplicity, compare with the first answer (gold) provided in the dataset
        if best_answer['answer'].lower() in sample['answers']['text'][0].lower():
            correct += 1
    else:
        print("No valid draft found.\n")

accuracy = correct / total * 100
print(f"Accuracy: {accuracy}%")
Cuplikan kode ini mengevaluasi akurasi implementasi speculative RAG yang disederhanakan pada 10 sampel dari suatu dataset. Untuk setiap sampel, kode menghasilkan beberapa draf jawaban berdasarkan pertanyaan dan konteks yang diberikan lalu memilih draf terbaik menggunakan fungsi verifikasi. Jika jawaban yang valid ditemukan, kode membandingkannya dengan jawaban emas (benar) yang disediakan dalam dataset. Jika cocok, jumlah correct akan ditambah.
Terakhir, kode menghitung dan mencetak akurasi sebagai persentase jawaban benar dari total sampel. Kode ini menghasilkan akurasi 90% pada dataset yang disederhanakan ini.
Meskipun speculative RAG memberikan hasil yang baik, ada beberapa tantangan:
Speculative RAG dapat diterapkan di berbagai domain yang membutuhkan pengambilan informasi yang akurat dan efisien. Berikut beberapa potensi aplikasinya:
Speculative RAG meningkatkan retrieval-augmented generation dengan akurasi yang lebih baik, latensi yang berkurang, efisiensi sumber daya, dan skalabilitas. Kami mendemonstrasikan implementasinya menggunakan Hugging Face Transformers.
Meski ada tantangan, potensi speculative RAG di berbagai domain menjadikannya menjanjikan untuk penelitian lebih lanjut.
Jika Anda ingin mempelajari lebih lanjut tentang implementasi RAG, saya merekomendasikan tutorial berikut:
Pelajari AI dengan kursus-kursus ini!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




