
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
52K
Llama 3.1 adalah pilihan yang baik untuk RAG, sebuah teknik yang menggabungkan sistem retrieval dengan kemampuan menghasilkan teks dari model bahasa untuk memastikan keluaran yang lebih akurat dan relevan.
Dalam RAG, sistem retrieval terlebih dahulu menelusuri dataset besar untuk menemukan informasi yang paling relevan, yang kemudian digunakan oleh model bahasa untuk menghasilkan respons akhir. Ini sangat berguna untuk tugas seperti menjawab pertanyaan, membangun chatbot, dan menangani tugas yang sarat informasi, di mana model bahasa tradisional mungkin memberikan jawaban yang usang atau tidak relevan.
Dengan kemampuannya menangani hingga 128K token dan dukungan untuk berbagai bahasa, Llama 3.1 meningkatkan kualitas dan keandalan konten AI dalam sistem RAG.
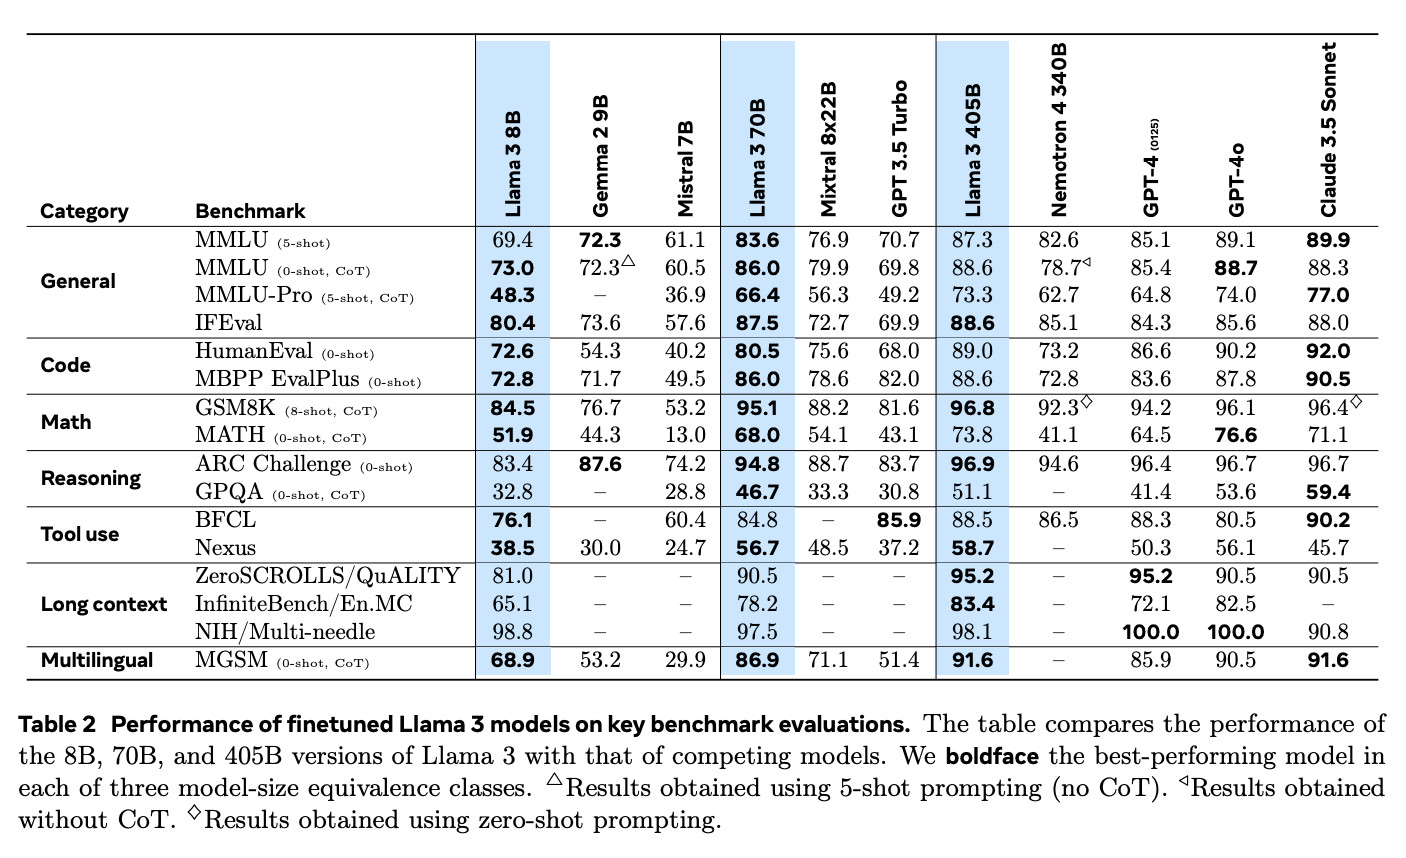
Sumber: The Llama 3 Herd of Models
Selain itu, Llama 3.1 menonjol dalam aplikasi RAG jika dibandingkan dengan model sumber tertutup seperti GPT-4o dan Claude 3.5 Sonnet. Kemampuan penalaran yang kuat dan kemampuan memproses teks lebih panjang memungkinkannya menangani pertanyaan kompleks dengan lebih baik dan memberikan jawaban yang lebih relevan.
Dalam tolok ukur Needle-in-a-Haystack (NIH), yang menguji kemampuan model menemukan potongan informasi spesifik ("jarum") dalam volume teks besar ("tumpukan jerami"), Llama 3.1 unggul dengan tingkat retrieval hampir sempurna di semua ukuran model. Ini menunjukkan kemampuannya mengelola tugas pencarian yang kompleks, sehingga ideal untuk sistem RAG yang perlu mengekstrak informasi presisi dari dataset besar.
Model ini juga berkinerja sangat baik dalam tolok ukur Multi-needle, yang menuntut pengambilan beberapa potongan informasi secara akurat. Hasilnya yang nyaris sempurna semakin membuktikan kemampuannya menangani tugas retrieval yang kompleks.
Untuk menyiapkan aplikasi RAG dengan Llama 3.1, diperlukan beberapa langkah. Ini mencakup mengunduh model Llama 3.1 ke mesin lokal, menyiapkan lingkungan, memuat pustaka yang diperlukan, dan membuat mekanisme retrieval. Terakhir, kita akan menggabungkannya dengan model bahasa untuk membangun aplikasi lengkap.
Di bawah ini adalah panduan langkah demi langkah yang jelas untuk membantu Anda mengimplementasikan aplikasi RAG menggunakan Llama 3.1.
Pertama, instal aplikasi Ollama, yang memungkinkan kita menjalankan Llama 3.1 dan model bahasa open-source lainnya di mesin lokal Anda. Anda dapat mengunduh aplikasi Ollama dari situs web resmi mereka.
Setelah Anda menginstal dan membuka Ollama, langkah berikutnya adalah mengunduh model Llama 3.1 ke mesin lokal Anda. Untuk tutorial ini, kita akan menggunakan versi 8B parameter. Untuk mengunduhnya, buka terminal dan jalankan baris perintah berikut:
ollama run llama3.1Setelah pengunduhan model selesai, kita siap menghubungkannya menggunakan Langchain, yang akan kami tunjukkan caranya di bagian selanjutnya.
Sebelum mulai, pastikan Anda telah memasang pustaka Python yang tepat. Kita akan memerlukan pustaka seperti langchain, langchain_community, langchain-ollama, langchain_openai. Jika Anda belum memasangnya, Anda bisa menggunakan pip dengan perintah berikut:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaLangkah pertama dalam membuat sistem RAG adalah memuat dokumen yang ingin kita gunakan sebagai basis pengetahuan. Pada contoh ini, kita akan menggunakan halaman web sebagai sumber.
Berikut caranya:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
    "<https://lilianweng.github.io/posts/2023-06-23-agent/>",
    "<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
    "<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
Di sini, WebBaseLoader digunakan untuk mengambil konten dari setiap URL yang disediakan. Hasil daftar bersarang dari dokumen kemudian digabungkan menjadi satu daftar datar bernama docs_list, sehingga kita mendapatkan daftar dokumen.
Agar proses retrieval lebih efisien, kita membagi dokumen menjadi potongan kecil menggunakan RecursiveCharacterTextSplitter. Ini membantu sistem menangani dan mencari teks dengan lebih efektif.
Kita dapat menyiapkan text splitter dengan menentukan ukuran potongan dan overlap. Misalnya, pada kode di bawah, kita menyiapkan pemisah teks dengan ukuran potongan 250 karakter dan tanpa overlap.
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)Selanjutnya, kita perlu mengonversi potongan teks menjadi embedding, yang kemudian disimpan dalam vector store, sehingga memungkinkan retrieval cepat dan efisien berdasarkan kemiripan.
Untuk melakukannya, kita menggunakan OpenAIEmbeddings untuk menghasilkan embedding bagi setiap potongan teks, yang kemudian disimpan dalam SKLearnVectorStore. Vector store dikonfigurasi untuk mengembalikan 4 dokumen paling relevan untuk setiap kueri dengan pengaturan as_retriever(k=4).
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
    documents=doc_splits,
    embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)Pada langkah ini, kita akan menyiapkan LLM dan membuat templat prompt untuk menghasilkan respons berdasarkan dokumen yang diambil.
Pertama, kita perlu mendefinisikan templat prompt yang menginstruksikan LLM tentang cara memformat jawabannya. Templat ini memberi tahu model untuk menggunakan dokumen yang disediakan guna menjawab pertanyaan secara ringkas, maksimal tiga kalimat. Jika model tidak dapat menemukan jawabannya, ia harus menyatakan bahwa ia tidak tahu.
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
    template="""You are an assistant for question-answering tasks.
    Use the following documents to answer the question.
    If you don't know the answer, just say that you don't know.
    Use three sentences maximum and keep the answer concise:
    Question: {question}
    Documents: {documents}
    Answer:
    """,
    input_variables=["question", "documents"],
)
Selanjutnya, kita menghubungkan ke model Llama 3.1 menggunakan ChatOllama dari Langchain, yang kita konfigurasi dengan temperature 0 untuk respons yang konsisten.
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
    model="llama3.1",
    temperature=0,
)
Terakhir, kita membuat rantai yang menggabungkan templat prompt dengan LLM dan menggunakan StrOutputParser untuk memastikan output berupa string sederhana yang bersih dan siap ditampilkan.
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()Pada langkah ini, kita akan menggabungkan retriever dan rantai RAG untuk membuat aplikasi RAG yang lengkap. Kita akan melakukannya dengan membuat kelas bernama RAGApplication yang akan menangani baik pengambilan dokumen maupun pembuatan jawaban.
Kelas RAGApplication memiliki metode run yang menerima pertanyaan pengguna, menggunakan retriever untuk menemukan dokumen relevan, lalu mengekstrak teks dari dokumen tersebut. Setelah itu, pertanyaan dan teks dokumen diteruskan ke rantai RAG untuk menghasilkan jawaban yang ringkas.
# Define the RAG application class
class RAGApplication:
    def __init__(self, retriever, rag_chain):
        self.retriever = retriever
        self.rag_chain = rag_chain
    def run(self, question):
        # Retrieve relevant documents
        documents = self.retriever.invoke(question)
        # Extract content from retrieved documents
        doc_texts = "\\n".join([doc.page_content for doc in documents])
        # Get the answer from the language model
        answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerTerakhir, kita siap menguji aplikasi RAG dengan beberapa pertanyaan contoh untuk memastikan semuanya bekerja dengan benar. Anda dapat menyesuaikan templat prompt atau pengaturan retrieval untuk meningkatkan performa atau menyesuaikan aplikasi dengan kebutuhan spesifik.
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)
Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.Fitur-fitur canggih Llama 3.1 dan dukungan untuk RAG membuatnya ideal untuk sejumlah aplikasi yang berdampak.
Untuk pengembangan chatbot, mengintegrasikan Llama 3.1 dengan RAG memungkinkan chatbot memberikan respons yang lebih akurat dan peka konteks dengan mengakses basis data atau basis pengetahuan eksternal. Ini memastikan informasi yang diberikan kepada pengguna tetap aktual dan relevan, yang sangat penting di bidang seperti layanan pelanggan, di mana jawaban yang tepat waktu dan akurat dapat sangat meningkatkan kepuasan dan efisiensi pengguna. Dukungan multi-bahasa Llama 3.1 juga membuatnya efektif untuk melayani basis pengguna yang beragam.
Dalam sistem tanya jawab, Llama 3.1 mengatasi keterbatasan model bahasa tradisional yang hanya bergantung pada dataset internalnya. Dengan menggunakan RAG untuk mengakses informasi terkini dari sumber eksternal, Llama 3.1 meningkatkan akurasi dan keandalan jawabannya. Ini sangat berguna di bidang seperti kesehatan dan pendidikan, di mana informasi yang tepat dan terkini sangat penting.
Sebagai contoh, asisten AI medis yang didukung Llama 3.1 dapat memberikan profesional kesehatan riset atau pedoman perawatan terbaru dengan melakukan kueri ke basis data medis secara real time, sehingga membantu pengambilan keputusan klinis yang lebih baik.
Llama 3.1 juga sangat efektif untuk tugas yang memerlukan pengetahuan mendalam seperti menghasilkan laporan terperinci atau melakukan riset menyeluruh. Dengan menggunakan RAG untuk menarik dari berbagai sumber, model Llama 3.1 dapat memberikan analisis yang lebih komprehensif dan bernuansa, menjadikannya alat berharga bagi profesional di bidang seperti riset, keuangan, dan perencanaan strategis.
Mengimplementasikan aplikasi RAG dengan Llama 3.1 menggunakan Ollama dan Langchain menawarkan solusi yang baik untuk menciptakan model bahasa yang canggih dan peka konteks.
Dengan mengikuti langkah-langkah yang diuraikan—menyiapkan lingkungan, memuat dan memproses dokumen, membuat embedding, dan mengintegrasikan retriever dengan LLM—Anda dapat membangun sistem RAG fungsional yang mampu mengambil informasi relevan dan menyediakan jawaban yang akurat.
Integrasi Llama 3.1 dengan RAG sangat berharga untuk aplikasi dunia nyata seperti chatbot, sistem tanya jawab, dan alat riset, di mana akses ke informasi eksternal yang mutakhir sangat penting.
Pelajari cara membangun aplikasi AI!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




