Programma
Sviluppare applicazioni AI
21 ore
I large language model (LLM) spesso non sono all'altezza quando si tratta di compiti ad alta intensità di conoscenza che richiedono informazioni aggiornate e precise. È qui che entra in gioco la retrieval-augmented generation (RAG), che combina le capacità generative degli LLM con basi di conoscenza esterne per migliorare accuratezza e rilevanza.
Nonostante la sua efficacia, il RAG tradizionale incontra difficoltà nella gestione di documenti lunghi e complessi, con conseguente aumento della latenza e, a volte, risultati meno accurati. Per affrontare questi problemi, il concetto di speculative RAG è emerso come una soluzione promettente. Scopriamolo meglio.
Lo speculative retrieval-augmented generation (RAG) è un framework innovativo pensato per migliorare efficienza e accuratezza dei sistemi RAG suddividendo il processo di generazione in due passaggi distinti:
Comprendiamo meglio lo speculative RAG esaminando questo diagramma:
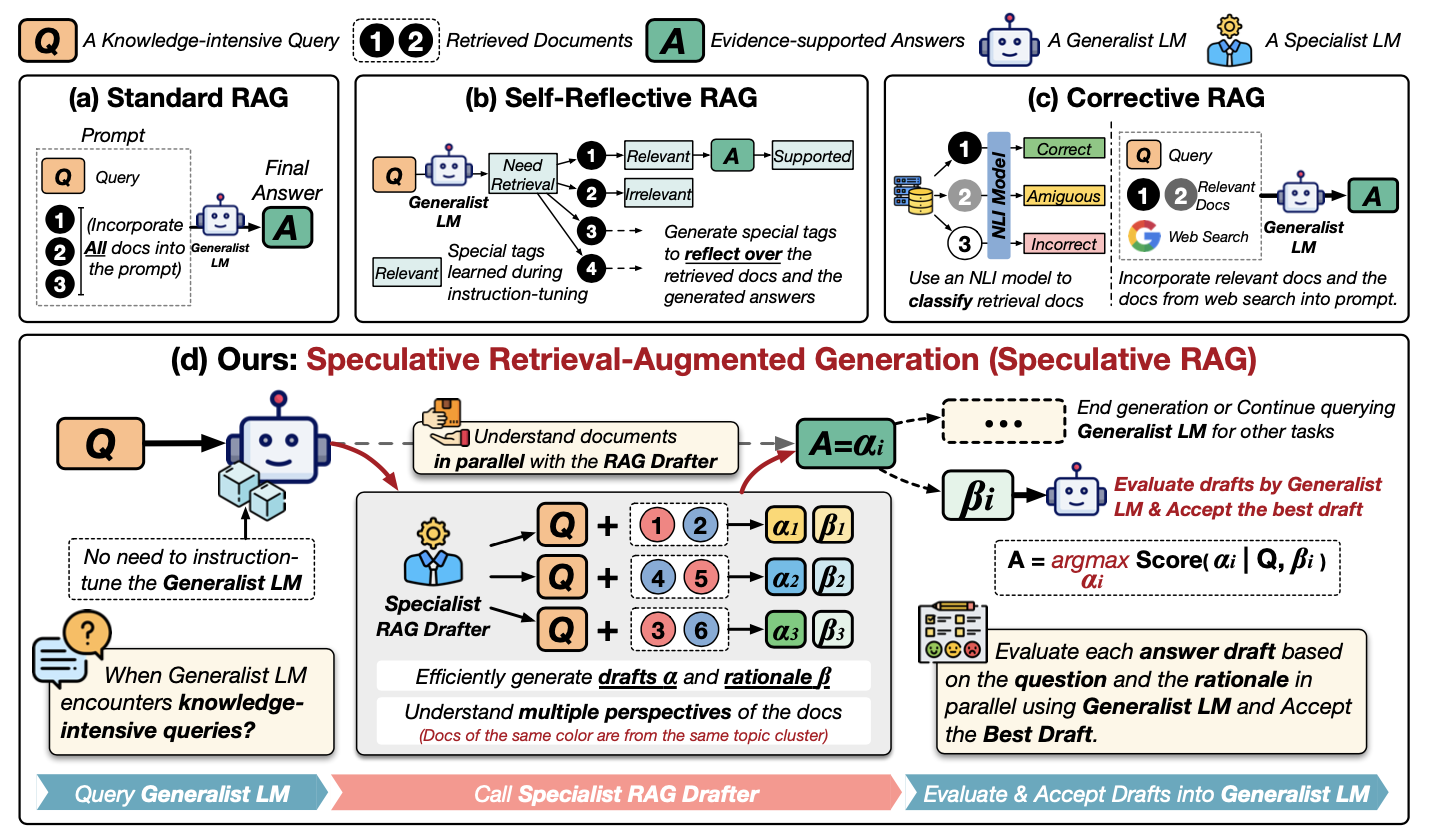
Fonte: Wang et al., 2024
Analizziamo il diagramma passo dopo passo. Mostra diversi modi di usare informazioni esterne per aiutare un LLM a rispondere alle domande, con il focus su un metodo nuovo chiamato Speculative RAG. Esaminiamo i metodi nella prima riga:
Ora, diamo uno sguardo più da vicino a (d) Speculative RAG:
In sostanza, lo speculative RAG è come avere una squadra di esperti: il drafter propone opzioni e l'LLM generalista prende la decisione finale. Questo rende il processo più rapido e potenzialmente più accurato.
Speculative RAG offre diversi vantaggi chiave rispetto ai sistemi RAG tradizionali:
Usando un RAG Drafter specializzato per generare più bozze da sottoinsiemi di documenti eterogenei, lo Speculative RAG migliora l'accuratezza dell'output finale. Questo approccio consente al sistema di considerare prospettive multiple, riducendo la probabilità di risposte errate o di parte. Negli esperimenti, lo Speculative RAG ha mostrato un miglioramento dell'accuratezza fino al 12,97% su benchmark come PubHealth rispetto ai sistemi RAG convenzionali.
Una delle sfide più significative dei sistemi RAG tradizionali è l'aumento della latenza dovuto all'elaborazione di documenti lunghi e complessi. Lo Speculative RAG affronta il problema delegando la stesura a un LM più piccolo ed efficiente, in grado di generare bozze in parallelo. Questo riduce i tempi complessivi, con miglioramenti di latenza fino al 51% in alcuni casi.
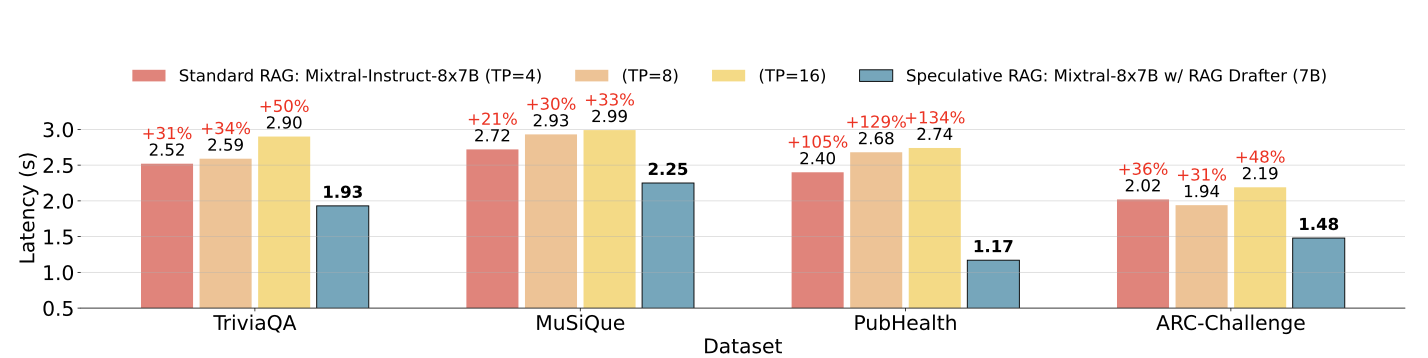
Latenza di Speculative RAG vs RAG standard su diversi dataset. Fonte: Wang et al., 2024
Speculative RAG ottimizza l'uso delle risorse delegando il compito di stesura a un LM più piccolo, meno intensivo dal punto di vista computazionale rispetto all'LM generalista più grande usato nei sistemi RAG tradizionali. Questa divisione del lavoro non solo accelera la generazione, ma riduce anche il carico computazionale complessivo, rendendolo una soluzione più efficiente.
Il framework Speculative RAG è altamente adattabile e può essere applicato a vari compiti knowledge-intensive senza necessità di un tuning esteso. Questa scalabilità lo rende ideale per un'ampia gamma di applicazioni, dal question answering all'analisi di documenti complessi.
Per implementare una versione semplificata di Speculative RAG per un'attività base di question answering, useremo un piccolo dataset e una configurazione semplice con due modelli: uno più piccolo per la stesura e uno più grande per la verifica.
Per semplicità, useremo la libreria Hugging Face Transformers. Mostreremo come usare un modello linguistico più piccolo per generare più bozze e un modello più grande per verificarle e selezionare la bozza migliore.
Per prima cosa, installiamo le librerie necessarie. Dovrai riavviare la sessione dopo aver installato la libreria transformers da HuggingFace. Assicurati di aver aggiunto le credenziali di HuggingFace sotto una chiave segreta in Collab o in un altro editor.
!pip install transformers torch datasetsPer questo esempio useremo SQuAD (Stanford Question Answering Dataset), disponibile dalla libreria datasets di Hugging Face.
from datasets import load_dataset
# Load the SQuAD dataset
dataset = load_dataset("squad", split="train[:100]") # Using a small subsetUseremo due modelli pre-addestrati dalla libreria Hugging Face. Un modello più piccolo (distilbert-base-uncased-distilled-squad) farà da RAG Drafter e un modello più grande (bert-large-uncased-whole-word-masking-finetuned-squad) farà da RAG Verifier.
Poi costruiremo una pipeline di stesura (Drafter) e una pipeline di verifica con i modelli selezionati.
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

# Initialize the smaller model (RAG Drafter)
drafter_model_name = "distilbert-base-uncased-distilled-squad"
drafter_model = AutoModelForQuestionAnswering.from_pretrained(drafter_model_name)
drafter_tokenizer = AutoTokenizer.from_pretrained(drafter_model_name)

# Initialize the larger model (RAG Verifier)
verifier_model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
verifier_model = AutoModelForQuestionAnswering.from_pretrained(verifier_model_name)
verifier_tokenizer = AutoTokenizer.from_pretrained(verifier_model_name)

# Set up pipelines
drafter_pipeline = pipeline("question-answering", model=drafter_model, tokenizer=drafter_tokenizer)
verifier_pipeline = pipeline("question-answering", model=verifier_model, tokenizer=verifier_tokenizer)Definiremo quindi una funzione per generare più bozze usando il modello più piccolo con la pipeline di Drafter predefinita.
def generate_drafts(question, context, num_drafts=3):
   drafts = []
   for _ in range(num_drafts):
       draft = Drafter_pipeline(question=question, context=context)
       drafts.append(draft)
return draftsOra definiremo una funzione verify_drafts() che usa il modello più grande per verificare e selezionare la bozza migliore in base ai punteggi di confidenza.
Funziona mappando le posizioni dei caratteri di inizio e fine di ogni bozza alle corrispondenti posizioni dei token nel contesto tokenizzato tramite una offset mapping. Il modello di verifica quindi attribuisce un punteggio a ciascuna bozza in base alla propria confidenza che tali posizioni corrispondano alla risposta corretta. La bozza con il punteggio di confidenza più alto viene selezionata come risposta migliore, garantendo che l'output finale sia accurato e affidabile.
La gestione accurata dell'allineamento dei token e del punteggio è fondamentale per le prestazioni migliorate dello Speculative RAG.
def verify_drafts(question, context, drafts):
    best_draft = None
    highest_score = 0

    # Tokenize the context using the verifier's tokenizer, keeping track of offsets
    inputs = verifier_tokenizer(question, context, return_tensors="pt", return_offsets_mapping=True)
    offset_mapping = inputs['offset_mapping'][0]  # This will give us the character-to-token mapping
    input_ids = inputs['input_ids'][0]

    for draft in drafts:
        start_char = draft['start']
        end_char = draft['end']

        # Find the corresponding token positions using offset mapping
        start_index = None
        end_index = None

        for idx, (start, end) in enumerate(offset_mapping):
            if start_index is None and start_char >= start and start_char < end:
                start_index = idx
            if end_index is None and end_char > start and end_char <= end:
                end_index = idx
            if start_index is not None and end_index is not None:
                break

        # Ensure indices were found and are within bounds
        if (start_index is None or end_index is None or
                start_index >= len(input_ids) or end_index >= len(input_ids)):
            print(f"Draft skipped: Out of bounds or no matching tokens. "
                  f"Start Index: {start_index}, End Index: {end_index}")
            continue

        # Get the confidence score using the larger model
        outputs = verifier_model(input_ids=input_ids.unsqueeze(0))
        score = (outputs.start_logits[0, start_index].item() +
                 outputs.end_logits[0, end_index].item())

        if score > highest_score:
            highest_score = score
            best_draft = draft

    if best_draft is None:
        print("No valid draft found after verification.")

return best_draftOra applichiamo il nostro processo di Speculative RAG a 10 domande di esempio del dataset.
correct = 0
total = 10  # Evaluate on 10 samples for simplicity

for i in range(total):
    sample = dataset[i]
    question = sample['question']
    context = sample['context']
    drafts = generate_drafts(question, context)
    best_answer = verify_drafts(question, context, drafts)

    print(f"Q: {question}")

    if best_answer is not None:
        print(f"A: {best_answer['answer']}\n")
        # For simplicity, compare with the first answer (gold) provided in the dataset
        if best_answer['answer'].lower() in sample['answers']['text'][0].lower():
            correct += 1
    else:
        print("No valid draft found.\n")

accuracy = correct / total * 100
print(f"Accuracy: {accuracy}%")
Questo snippet valuta l'accuratezza di un'implementazione semplificata di speculative RAG su 10 campioni di un dataset. Per ogni campione, genera più bozze di risposta in base a una domanda e a un contesto e poi seleziona la bozza migliore tramite una funzione di verifica. Se viene trovata una risposta valida, la confronta con la risposta corretta (gold) fornita nel dataset. Se la risposta coincide, il contatore correct viene incrementato.
Infine, il codice calcola e stampa l'accuratezza come percentuale di risposte corrette sul totale dei campioni. Questo codice restituisce un'accuratezza del 90% su questo dataset semplificato.
Sebbene lo speculative RAG dia buoni risultati, presenta alcune sfide:
Lo Speculative RAG può essere applicato in un'ampia gamma di domini in cui il recupero di informazioni accurate ed efficiente è fondamentale. Ecco alcune potenziali applicazioni:
Lo Speculative RAG potenzia la retrieval-augmented generation con maggiore accuratezza, latenza ridotta, efficienza delle risorse e scalabilità. Ne abbiamo mostrato l'implementazione usando Hugging Face Transformers.
Pur esistendo delle sfide, il potenziale dello speculative RAG in vari domini lo rende promettente per ulteriori ricerche.
Se vuoi approfondire l'implementazione di RAG, ti consiglio i seguenti tutorial:
Impara l'AI con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



