Program
Yapay Zeka Uygulamaları Geliştirme
21 sa
Büyük dil modelleri (LLM'ler) güncel ve kesin bilgi gerektiren bilgi-yoğun görevlerde sıklıkla yetersiz kalır. İşte burada, doğruluğu ve alaka düzeyini artırmak için LLM'lerin üretici yeteneklerini harici bilgi tabanlarıyla birleştiren geri getirme destekli üretim (RAG) devreye girer.
Etkili olmasına rağmen, geleneksel RAG sistemleri uzun ve karmaşık belgeleri yönetmede zorlanır; bu da gecikmenin artmasına ve bazen daha az doğru sonuçlara yol açar. Bu sorunları gidermek için spekülatif RAG kavramı umut verici bir çözüm olarak ortaya çıkmıştır. Hakkında daha fazlasını öğrenelim.
Spekülatif geri getirme destekli üretim (RAG), üretim sürecini iki ayrı adıma bölerek RAG sistemlerinin verimliliğini ve doğruluğunu artırmak için tasarlanmış yenilikçi bir çerçevedir:
Spekülatif RAG'i bu şemayı inceleyerek daha iyi anlayalım:
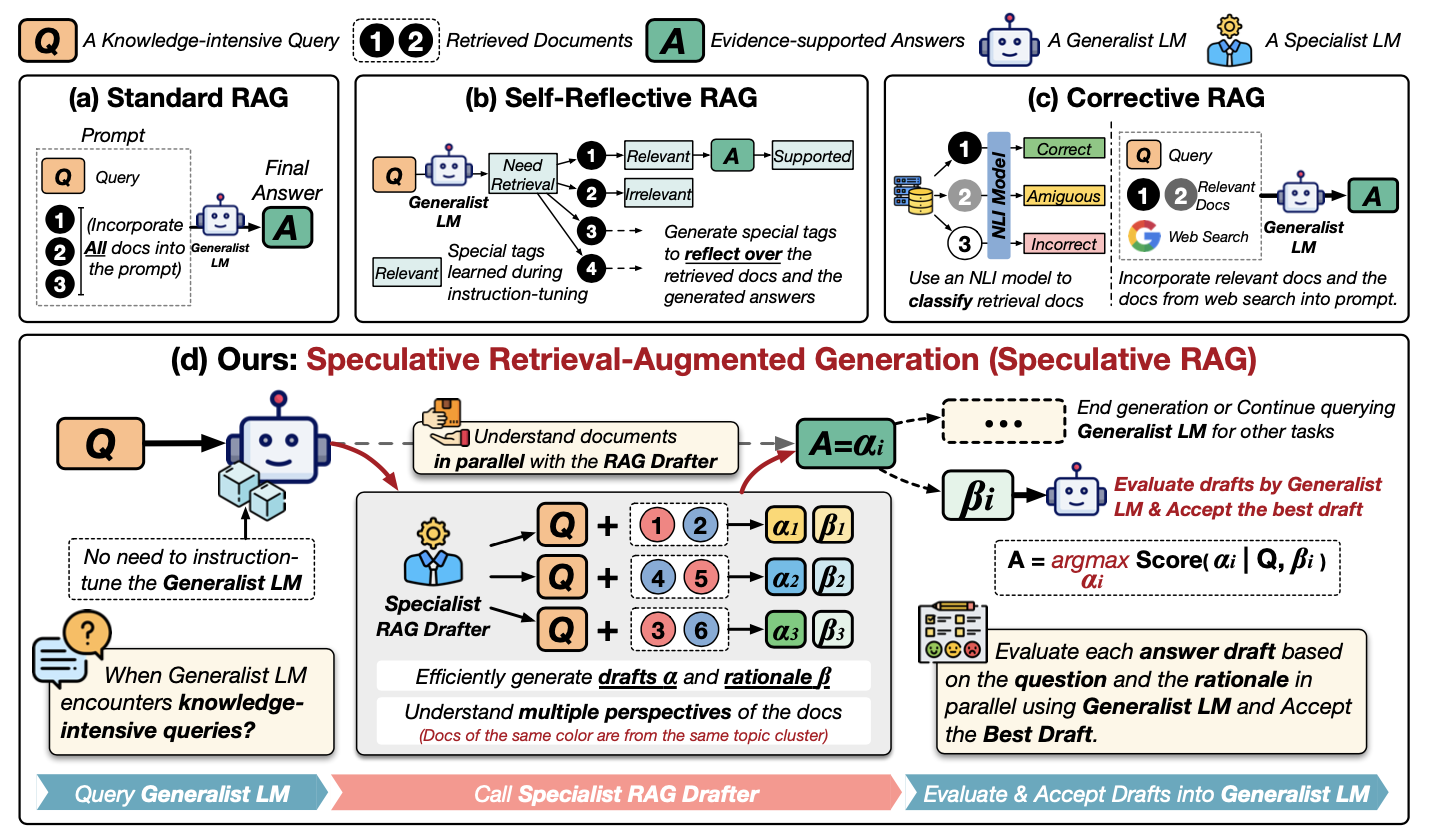
Kaynak: Wang ve ark., 2024
Bu diyagramı adım adım inceleyelim. Şema, LLM'in soruları yanıtlarken harici bilgiyi kullanmasının farklı yollarını gösterir ve Spekülatif RAG adı verilen yeni bir yönteme odaklanır. İlk satırdaki yöntemlere bakalım:
Şimdi de (d) Spekülatif RAG'e yakından bakalım:
Özetle, spekülatif RAG uzmanlardan oluşan bir ekibe benzer: taslakçı seçenekler üretir, genelci LLM ise son kararı verir. Bu da süreci daha hızlı ve potansiyel olarak daha doğru hale getirir.
Spekülatif RAG, geleneksel RAG sistemlerine göre birkaç önemli avantaj sunar:
Farklı belge alt kümelerinden birden fazla taslak üretmek için uzman bir RAG Taslakçısı kullanarak Spekülatif RAG, nihai çıktının doğruluğunu artırır. Bu yaklaşım, sistemin birden çok bakış açısını dikkate almasına olanak tanır; yanlış veya taraflı yanıtlar üretme olasılığını azaltır. Deneylerde, Spekülatif RAG, PubHealth gibi kıyaslamalarda geleneksel RAG sistemlerine kıyasla doğrulukta %12,97'ye varan bir iyileşme göstermiştir.
Geleneksel RAG sistemlerindeki en önemli zorluklardan biri, uzun ve karmaşık belgelerin işlenmesinin neden olduğu artan gecikmedir. Spekülatif RAG, taslak hazırlama sürecini daha küçük ve verimli bir dil modeline devrederek bu sorunu ele alır; bu model taslakları paralel olarak üretebilir. Bu yaklaşım, bazı durumlarda gecikmede %51'e varan iyileşmelerle toplam işlem süresini azaltır.
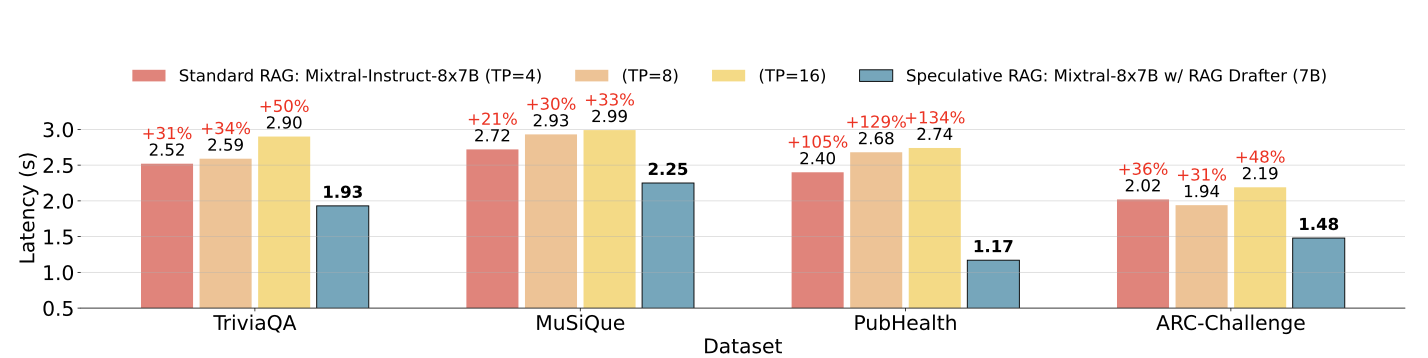
Farklı veri kümelerinde Spekülatif RAG gecikmesi ve Standart RAG gecikmesi. Kaynak: Wang ve ark., 2024
Spekülatif RAG, taslak hazırlama görevini geleneksel RAG sistemlerinde kullanılan daha büyük genelci modele kıyasla daha az hesaplama maliyetine sahip daha küçük bir dil modeline devrederek kaynak kullanımını optimize eder. Bu iş bölümü, üretim sürecini hızlandırmakla kalmaz, aynı zamanda toplam hesaplama yükünü azaltarak daha kaynak-verimli bir çözüm sunar.
Spekülatif RAG çerçevesi son derece uyarlanabilirdir ve kapsamlı ayarlamalara gerek kalmadan çeşitli bilgi-yoğun görevlere uygulanabilir. Bu ölçeklenebilirlik, soru yanıtlama görevlerinden karmaşık belge analizine kadar geniş bir uygulama yelpazesi için ideal bir çözüm olmasını sağlar.
Temel bir soru-cevap görevi için Spekülatif RAG'in basitleştirilmiş bir sürümünü uygulamak üzere küçük bir veri kümesi ve iki modelden oluşan basit bir kurulum kullanacağız—taslak hazırlama için daha küçük, doğrulama için daha büyük bir model.
Basit olması için Hugging Face Transformers kütüphanesini kullanacağız. Daha küçük bir dil modelini kullanarak birden fazla taslak üretmeyi ve daha büyük bir modelle en iyi taslağı doğrulayıp seçmeyi göstereceğiz.
Önce gerekli kütüphaneleri kuralım. Transformers kütüphanesini HuggingFace'ten kurduktan sonra oturumu yeniden başlatmanız gerekir. HuggingFace kimlik bilgilerinizi Colab veya başka bir editörde gizli anahtar altında eklediğinizden emin olun.
!pip install transformers torch datasetsBu örnek için, Hugging Face datasets kütüphanesinden erişilebilen SQuAD (Stanford Question Answering Dataset) veri kümesini kullanacağız.
from datasets import load_dataset
# Load the SQuAD dataset
dataset = load_dataset("squad", split="train[:100]") # Using a small subsetHugging Face kütüphanesinden iki önceden eğitilmiş model kullanacağız. Daha küçük bir model (distilbert-base-uncased-distilled-squad) RAG Taslakçısı olarak görev yapacak ve daha büyük bir model (bert-large-uncased-whole-word-masking-finetuned-squad) RAG Doğrulayıcısı olarak görev yapacak.
Ardından, seçilen modellerle bir Taslakçı ve bir doğrulayıcı hattı (pipeline) kuracağız.
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

# Initialize the smaller model (RAG Drafter)
drafter_model_name = "distilbert-base-uncased-distilled-squad"
drafter_model = AutoModelForQuestionAnswering.from_pretrained(drafter_model_name)
drafter_tokenizer = AutoTokenizer.from_pretrained(drafter_model_name)

# Initialize the larger model (RAG Verifier)
verifier_model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
verifier_model = AutoModelForQuestionAnswering.from_pretrained(verifier_model_name)
verifier_tokenizer = AutoTokenizer.from_pretrained(verifier_model_name)

# Set up pipelines
drafter_pipeline = pipeline("question-answering", model=drafter_model, tokenizer=drafter_tokenizer)
verifier_pipeline = pipeline("question-answering", model=verifier_model, tokenizer=verifier_tokenizer)Sonraki adımda, önceden tanımlı Taslakçı hattıyla daha küçük modeli kullanarak birden çok taslak üreten bir fonksiyon tanımlayacağız.
def generate_drafts(question, context, num_drafts=3):
   drafts = []
   for _ in range(num_drafts):
       draft = Drafter_pipeline(question=question, context=context)
       drafts.append(draft)
return draftsŞimdi, daha büyük modeli kullanarak güven puanlarına göre en iyi taslağı doğrulayıp seçen bir verify_drafts() fonksiyonu tanımlayacağız.
Bu fonksiyon, her taslağın başlangıç ve bitiş karakter konumlarını, bir öteleme eşlemesi kullanarak belirteçli (tokenize) bağlamdaki karşılık gelen belirteç konumlarına eşleyerek çalışır. Doğrulayıcı model, bu konumların doğru yanıt olduğuna dair güvenine göre her taslağı puanlar. En yüksek güven puanına sahip taslak en iyi yanıt olarak seçilir ve böylece nihai çıktının hem doğru hem de güvenilir olması sağlanır.
Bu fonksiyonun, belirteç hizalamasını ve puanlamayı dikkatli biçimde ele alması, Spekülatif RAG'in gelişmiş performansının anahtarıdır.
def verify_drafts(question, context, drafts):
    best_draft = None
    highest_score = 0

    # Tokenize the context using the verifier's tokenizer, keeping track of offsets
    inputs = verifier_tokenizer(question, context, return_tensors="pt", return_offsets_mapping=True)
    offset_mapping = inputs['offset_mapping'][0]  # This will give us the character-to-token mapping
    input_ids = inputs['input_ids'][0]

    for draft in drafts:
        start_char = draft['start']
        end_char = draft['end']

        # Find the corresponding token positions using offset mapping
        start_index = None
        end_index = None

        for idx, (start, end) in enumerate(offset_mapping):
            if start_index is None and start_char >= start and start_char < end:
                start_index = idx
            if end_index is None and end_char > start and end_char <= end:
                end_index = idx
            if start_index is not None and end_index is not None:
                break

        # Ensure indices were found and are within bounds
        if (start_index is None or end_index is None or
                start_index >= len(input_ids) or end_index >= len(input_ids)):
            print(f"Draft skipped: Out of bounds or no matching tokens. "
                  f"Start Index: {start_index}, End Index: {end_index}")
            continue

        # Get the confidence score using the larger model
        outputs = verifier_model(input_ids=input_ids.unsqueeze(0))
        score = (outputs.start_logits[0, start_index].item() +
                 outputs.end_logits[0, end_index].item())

        if score > highest_score:
            highest_score = score
            best_draft = draft

    if best_draft is None:
        print("No valid draft found after verification.")

return best_draftŞimdi, veri kümesinden 10 örnek soru üzerinde Spekülatif RAG sürecimizi uygulayalım.
correct = 0
total = 10  # Evaluate on 10 samples for simplicity

for i in range(total):
    sample = dataset[i]
    question = sample['question']
    context = sample['context']
    drafts = generate_drafts(question, context)
    best_answer = verify_drafts(question, context, drafts)

    print(f"Q: {question}")

    if best_answer is not None:
        print(f"A: {best_answer['answer']}\n")
        # For simplicity, compare with the first answer (gold) provided in the dataset
        if best_answer['answer'].lower() in sample['answers']['text'][0].lower():
            correct += 1
    else:
        print("No valid draft found.\n")

accuracy = correct / total * 100
print(f"Accuracy: {accuracy}%")
Bu kod parçacığı, bir veri kümesinden 10 örnek üzerinde basitleştirilmiş bir spekülatif RAG uygulamasının doğruluğunu değerlendirir. Her örnek için, verilen soru ve bağlama dayalı olarak birden fazla yanıt taslağı üretir ve ardından bir doğrulama fonksiyonu kullanarak en iyi taslağı seçer. Geçerli bir yanıt bulunursa, bu yanıt veri kümesinde sağlanan doğru (altın) yanıtla karşılaştırılır. Yanıt eşleşirse correct sayacı artırılır.
Son olarak, kod toplam örnekler içindeki doğru yanıtların yüzdesi olarak doğruluğu hesaplar ve yazdırır. Bu kod, bu basitleştirilmiş veri kümesinde %90 doğruluk verir.
Spekülatif RAG iyi sonuçlar üretse de bazı zorluklar barındırır:
Spekülatif RAG, doğru ve verimli bilgi geri getirme süreçlerinin kritik olduğu çok çeşitli alanlarda uygulanabilir. İşte bazı olası uygulamalar:
Spekülatif RAG, doğruluk, gecikme, kaynak verimliliği ve ölçeklenebilirlik açısından geliştirmelerle geri getirme destekli üretimi güçlendirir. Uygulamasını Hugging Face Transformers kullanarak gösterdik.
Bazı zorluklar bulunsa da, spekülatif RAG'in çeşitli alanlardaki potansiyeli, onu ileri araştırmalar için umut verici kılar.
RAG uygulaması hakkında daha fazla öğrenmek isterseniz, aşağıdaki eğitimleri öneririm:
Bu kurslarla yapay zekâyı öğrenin!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



