Leerpad
AI-toepassingen ontwikkelen
21 uur
Large language models (LLM’s) schieten vaak tekort bij kennisintensieve taken die actuele en precieze informatie vereisen. Daar komt retrieval-augmented generation (RAG) om de hoek kijken: het combineert de generatieve capaciteiten van LLM’s met externe kennisbanken om nauwkeurigheid en relevantie te vergroten.
Ondanks de effectiviteit ondervinden traditionele RAG-systemen uitdagingen bij het verwerken van lange en complexe documenten, wat leidt tot hogere latentie en soms minder nauwkeurige resultaten. Om dit aan te pakken is het concept speculative RAG ontstaan als veelbelovende oplossing. Laten we er meer over te weten komen.
Speculative retrieval-augmented generation (RAG) is een innovatief raamwerk dat de efficiëntie en nauwkeurigheid van RAG-systemen verbetert door het generatieproces op te splitsen in twee afzonderlijke stappen:
Laten we speculative RAG beter begrijpen aan de hand van dit diagram:
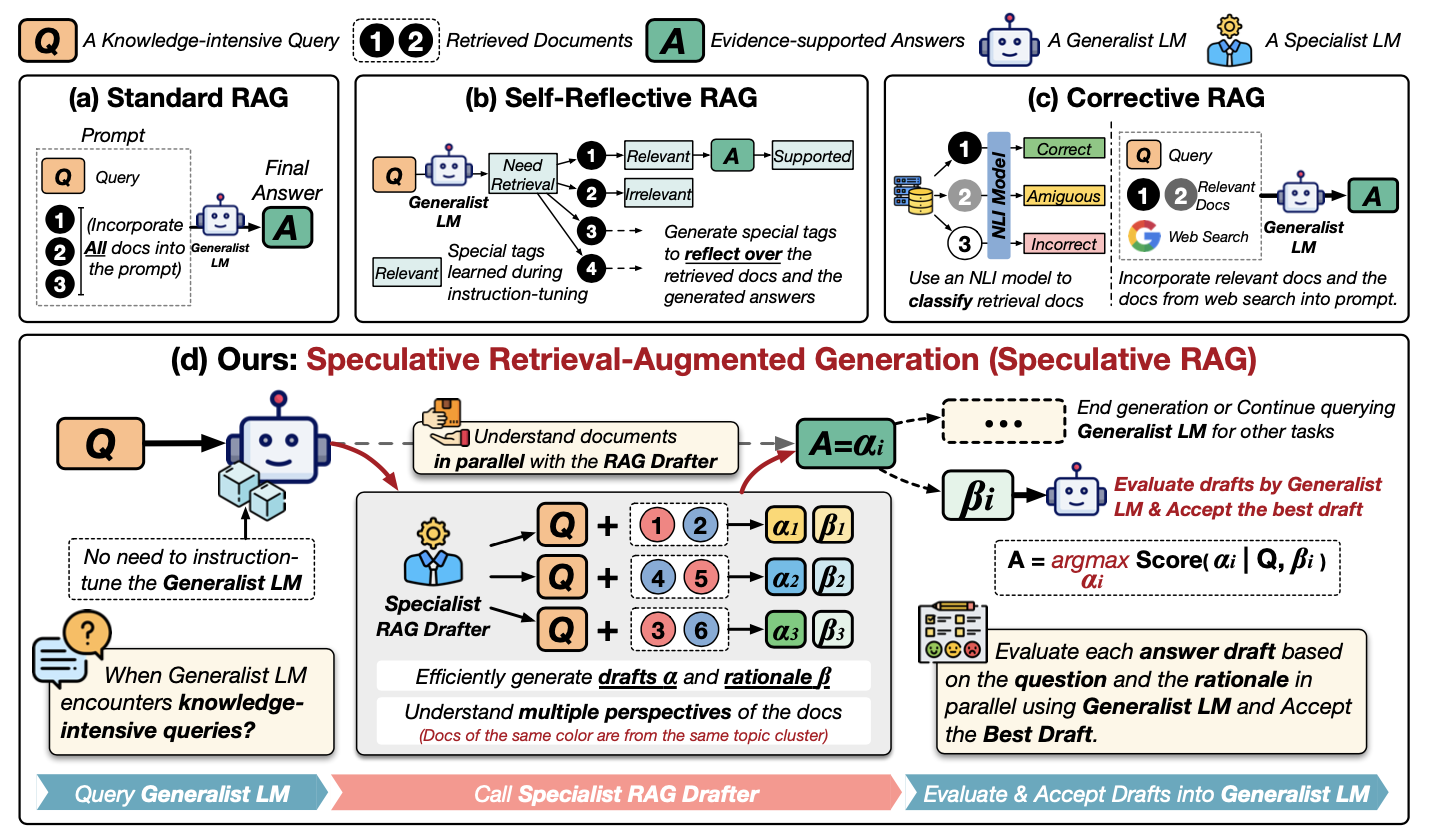
Bron: Wang et al., 2024
Laten we dit diagram stap voor stap doornemen. Het toont verschillende manieren om externe informatie te gebruiken om een LLM te helpen vragen te beantwoorden, met de focus op een nieuwe methode genaamd Speculative RAG. Laten we de methoden in de eerste rij bekijken:
Kijk nu van dichtbij naar (d) Speculative RAG:
Kortom, speculative RAG is alsof je een team van experts hebt: de drafter maakt opties, en de generalistische LLM neemt de eindbeslissing. Dat maakt het proces sneller en mogelijk nauwkeuriger.
Speculative RAG biedt verschillende belangrijke voordelen ten opzichte van traditionele RAG-systemen:
Door een gespecialiseerde RAG Drafter te gebruiken om meerdere concepten te genereren uit diverse documentsubsets, verhoogt Speculative RAG de nauwkeurigheid van de uiteindelijke output. Zo kan het systeem meerdere perspectieven meewegen, wat de kans op onjuiste of bevooroordeelde antwoorden verkleint. In experimenten liet Speculative RAG tot 12,97% verbetering in nauwkeurigheid zien op benchmarks zoals PubHealth, vergeleken met conventionele RAG-systemen.
Een van de grootste uitdagingen bij traditionele RAG-systemen is de verhoogde latentie door het verwerken van lange en complexe documenten. Speculative RAG pakt dit aan door het opstelproces uit te besteden aan een kleiner, efficiënter LM, dat concepten parallel kan genereren. Dit verkort de totale verwerkingstijd, met latentieverbeteringen tot wel 51% in sommige gevallen.
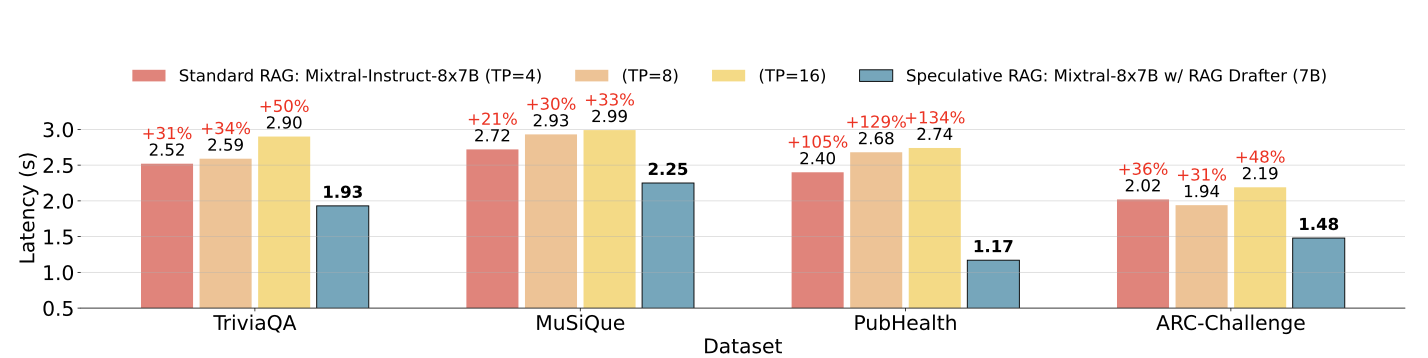
Speculative RAG-latentie vs standaard RAG-latentie op verschillende datasets. Bron: Wang et al., 2024
Speculative RAG optimaliseert het middelengebruik door de opstaaktaak toe te wijzen aan een kleiner LM, dat minder rekenintensief is dan de grotere generalistische LM in traditionele RAG-systemen. Deze taakverdeling versnelt niet alleen de generatie, maar vermindert ook de totale rekenlast, waardoor het een efficiëntere oplossing is.
Het Speculative RAG-raamwerk is zeer aanpasbaar en kan worden toegepast op uiteenlopende kennisintensieve taken zonder uitgebreide tuning. Deze schaalbaarheid maakt het een ideale oplossing voor een breed scala aan toepassingen, van vraagbeantwoording tot complexe documentanalyse.
Om een vereenvoudigde versie van Speculative RAG te implementeren voor een basistaak in vraagbeantwoording, gebruiken we een kleine dataset en een eenvoudige setup met twee modellen—een kleiner model voor het opstellen en een groter voor de verificatie.
Voor de eenvoud gebruiken we de Hugging Face Transformers-bibliotheek. We laten zien hoe je een kleiner taalmodel gebruikt om meerdere concepten te genereren en een groter model om te verifiëren en het beste concept te selecteren.
Laten we eerst de benodigde bibliotheken installeren. Je moet de sessie herstarten na het installeren van de transformers-bibliotheek van HuggingFace. Zorg ervoor dat je HuggingFace-credentials hebt toegevoegd onder een geheime sleutel in Collab of een andere editor.
!pip install transformers torch datasetsVoor dit voorbeeld gebruiken we SQuAD (Stanford Question Answering Dataset) uit de Hugging Face datasets-bibliotheek.
from datasets import load_dataset
# Load the SQuAD dataset
dataset = load_dataset("squad", split="train[:100]") # Using a small subsetWe gebruiken twee voorgetrainde modellen uit de Hugging Face-bibliotheek. Een kleiner model (distilbert-base-uncased-distilled-squad) fungeert als onze RAG Drafter en een groter model (bert-large-uncased-whole-word-masking-finetuned-squad) fungeert als de RAG Verifier.
Daarna bouwen we een Drafter- en een verifier-pijplijn met de geselecteerde modellen.
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

# Initialize the smaller model (RAG Drafter)
drafter_model_name = "distilbert-base-uncased-distilled-squad"
drafter_model = AutoModelForQuestionAnswering.from_pretrained(drafter_model_name)
drafter_tokenizer = AutoTokenizer.from_pretrained(drafter_model_name)

# Initialize the larger model (RAG Verifier)
verifier_model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
verifier_model = AutoModelForQuestionAnswering.from_pretrained(verifier_model_name)
verifier_tokenizer = AutoTokenizer.from_pretrained(verifier_model_name)

# Set up pipelines
drafter_pipeline = pipeline("question-answering", model=drafter_model, tokenizer=drafter_tokenizer)
verifier_pipeline = pipeline("question-answering", model=verifier_model, tokenizer=verifier_tokenizer)Vervolgens definiëren we een functie die meerdere concepten genereert met het kleinere model via de vooraf gedefinieerde Drafter-pijplijn.
def generate_drafts(question, context, num_drafts=3):
   drafts = []
   for _ in range(num_drafts):
       draft = Drafter_pipeline(question=question, context=context)
       drafts.append(draft)
return draftsWe definiëren nu een verify_drafts() functie die het grotere model gebruikt om de concepten te verifiëren en het beste concept te selecteren op basis van zekerheidscores.
Dit werkt door de start- en eindtekenposities van elk concept te mappen naar de bijbehorende tokenposities in de getokeniseerde context met een offsetmapping. Het verifier-model scoort vervolgens elk concept op basis van de zekerheid dat deze posities het juiste antwoord zijn. Het concept met de hoogste zekerheidscore wordt gekozen als beste antwoord, zodat de uiteindelijke output zowel nauwkeurig als betrouwbaar is.
De zorgvuldige omgang met tokenuitlijning en scoring in deze functie is cruciaal voor de verbeterde prestaties van Speculative RAG.
def verify_drafts(question, context, drafts):
    best_draft = None
    highest_score = 0

    # Tokenize the context using the verifier's tokenizer, keeping track of offsets
    inputs = verifier_tokenizer(question, context, return_tensors="pt", return_offsets_mapping=True)
    offset_mapping = inputs['offset_mapping'][0]  # This will give us the character-to-token mapping
    input_ids = inputs['input_ids'][0]

    for draft in drafts:
        start_char = draft['start']
        end_char = draft['end']

        # Find the corresponding token positions using offset mapping
        start_index = None
        end_index = None

        for idx, (start, end) in enumerate(offset_mapping):
            if start_index is None and start_char >= start and start_char < end:
                start_index = idx
            if end_index is None and end_char > start and end_char <= end:
                end_index = idx
            if start_index is not None and end_index is not None:
                break

        # Ensure indices were found and are within bounds
        if (start_index is None or end_index is None or
                start_index >= len(input_ids) or end_index >= len(input_ids)):
            print(f"Draft skipped: Out of bounds or no matching tokens. "
                  f"Start Index: {start_index}, End Index: {end_index}")
            continue

        # Get the confidence score using the larger model
        outputs = verifier_model(input_ids=input_ids.unsqueeze(0))
        score = (outputs.start_logits[0, start_index].item() +
                 outputs.end_logits[0, end_index].item())

        if score > highest_score:
            highest_score = score
            best_draft = draft

    if best_draft is None:
        print("No valid draft found after verification.")

return best_draftLaten we ons Speculative RAG-proces nu toepassen op 10 voorbeeldvragen uit de dataset.
correct = 0
total = 10  # Evaluate on 10 samples for simplicity

for i in range(total):
    sample = dataset[i]
    question = sample['question']
    context = sample['context']
    drafts = generate_drafts(question, context)
    best_answer = verify_drafts(question, context, drafts)

    print(f"Q: {question}")

    if best_answer is not None:
        print(f"A: {best_answer['answer']}\n")
        # For simplicity, compare with the first answer (gold) provided in the dataset
        if best_answer['answer'].lower() in sample['answers']['text'][0].lower():
            correct += 1
    else:
        print("No valid draft found.\n")

accuracy = correct / total * 100
print(f"Accuracy: {accuracy}%")
Deze code evalueert de nauwkeurigheid van een vereenvoudigde Speculative RAG-implementatie op 10 voorbeelden uit een dataset. Voor elk voorbeeld worden meerdere antwoordconcepten gegenereerd op basis van een gegeven vraag en context, waarna met een verificatiefunctie het beste concept wordt gekozen. Als er een geldig antwoord wordt gevonden, vergelijkt de code dit met het gouden (juiste) antwoord uit de dataset. Komt het overeen, dan wordt de correct-teller verhoogd.
Tot slot berekent en print de code de nauwkeurigheid als percentage correcte antwoorden van het totaal aantal voorbeelden. Op deze vereenvoudigde dataset levert de code een nauwkeurigheid van 90% op.
Hoewel speculative RAG goede resultaten oplevert, zijn er ook uitdagingen:
Speculative RAG is toepasbaar in een breed scala aan domeinen waar accurate en efficiënte informatieophaling cruciaal is. Enkele mogelijke toepassingen:
Speculative RAG versterkt retrieval-augmented generation met verbeterde nauwkeurigheid, lagere latentie, efficiënter middelengebruik en schaalbaarheid. We hebben de implementatie gedemonstreerd met Hugging Face Transformers.
Hoewel er uitdagingen zijn, maken de mogelijkheden van speculative RAG in diverse domeinen het een veelbelovende richting voor verder onderzoek.
Wil je meer leren over RAG-implementatie? Dan raad ik de volgende tutorials aan:
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

