Last chance! 50% off DataCamp Premium
Sale ends in
Large language models (LLMs) अक्सर उन ज्ञान-गहन कार्यों में कमतर पड़ जाते हैं जिनमें नवीनतम और सटीक जानकारी की जरूरत होती है। यहीं retrieval-augmented generation (RAG) काम आता है—LLMs की जनरेटिव क्षमता को बाहरी नॉलेज बेस के साथ मिलाकर सटीकता और प्रासंगिकता बढ़ाने के लिए।
प्रभावी होने के बावजूद, पारंपरिक RAG सिस्टम लंबे और जटिल दस्तावेज़ों को संभालने में चुनौतियों का सामना करते हैं, जिससे लेटेंसी बढ़ती है और कभी-कभी कम सटीक परिणाम मिलते हैं। इन समस्याओं को दूर करने के लिए स्पेक्युलेटिव RAG की अवधारणा एक आशाजनक समाधान के रूप में उभरी है। आइए इसके बारे में और जानें।
स्पेक्युलेटिव retrieval-augmented generation (RAG) एक नवीन फ्रेमवर्क है, जिसे जनरेशन प्रक्रिया को दो अलग-अलग चरणों में बाँटकर RAG सिस्टम की दक्षता और सटीकता सुधारने के लिए डिज़ाइन किया गया है:
आइए इस डायग्राम को देखकर स्पेक्युलेटिव RAG को बेहतर समझें:
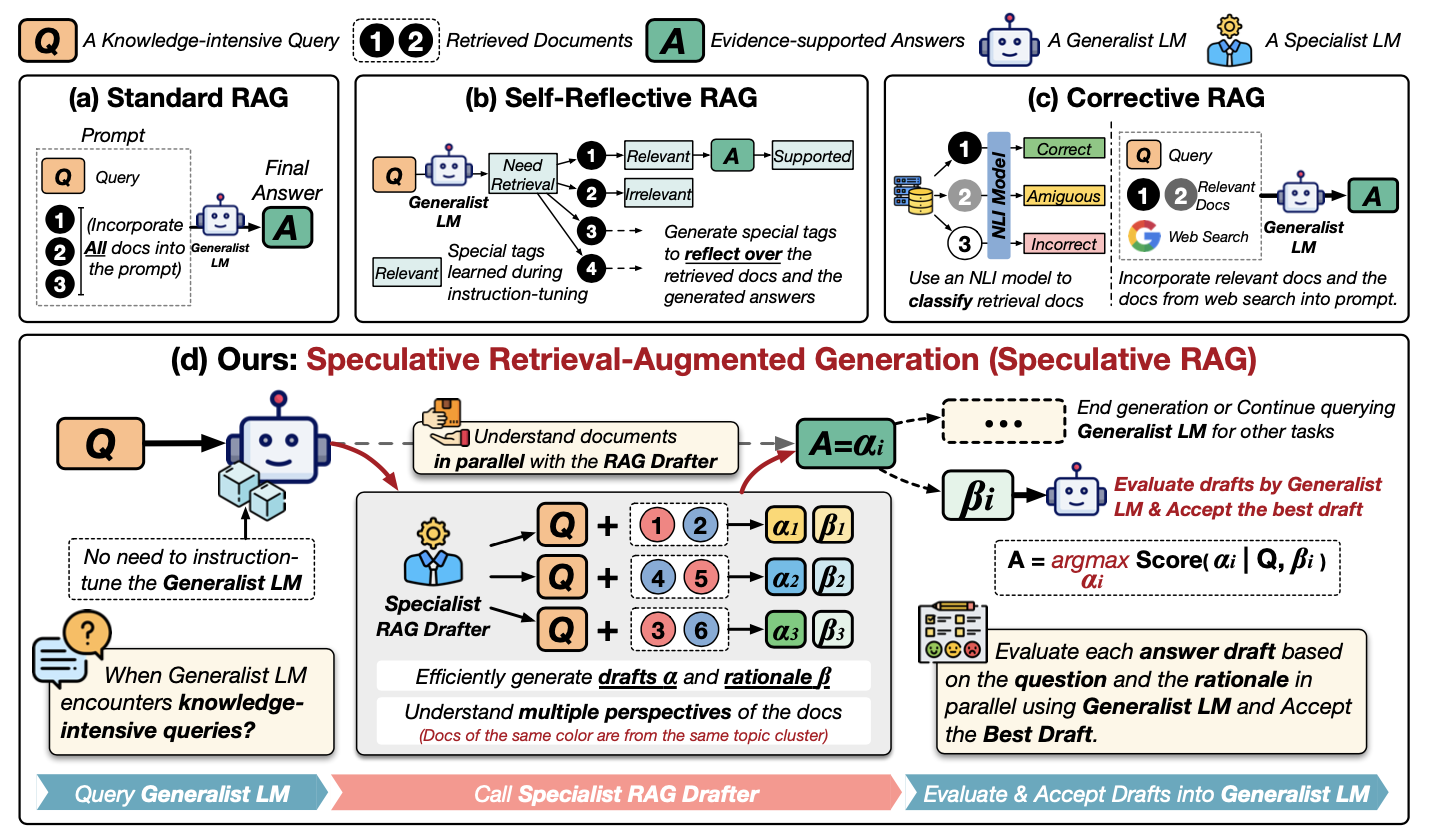
स्रोत: Wang et al., 2024
आइए इस डायग्राम को चरण-दर-चरण समझें। यह यह दिखाता है कि बाहरी जानकारी का उपयोग करके LLM को प्रश्नों के उत्तर देने में कैसे मदद की जा सकती है, खासकर Speculative RAG नामक एक नए तरीके पर ध्यान केंद्रित करते हुए। पहले पंक्ति के तरीकों पर नज़र डालते हैं:
अब (d) स्पेक्युलेटिव RAG पर करीब से नज़र डालते हैं:
मूल रूप से, स्पेक्युलेटिव RAG विशेषज्ञों की एक टीम जैसा है: ड्राफ्टर विकल्प तैयार करता है, और जनरलिस्ट LLM अंतिम निर्णय लेता है। इससे प्रक्रिया तेज़ और संभावित रूप से अधिक सटीक हो जाती है।
स्पेक्युलेटिव RAG पारंपरिक RAG सिस्टम की तुलना में कई प्रमुख लाभ देता है:
विविध दस्तावेज़ सबसेट से कई ड्राफ्ट बनाने के लिए विशेष RAG Drafter का उपयोग कर, स्पेक्युलेटिव RAG अंतिम आउटपुट की सटीकता बढ़ाता है। यह अप्रोच सिस्टम को कई दृष्टिकोणों पर विचार करने देता है, जिससे गलत या पक्षपाती उत्तरों की संभावना घटती है। प्रयोगों में, PubHealth जैसे बेंचमार्क्स पर स्पेक्युलेटिव RAG ने परंपरागत RAG की तुलना में सटीकता में 12.97% तक सुधार दिखाया।
पारंपरिक RAG सिस्टम की सबसे बड़ी चुनौतियों में से एक लंबे और जटिल दस्तावेज़ों को प्रोसेस करने से होने वाली लेटेंसी है। स्पेक्युलेटिव RAG इस समस्या को ड्राफ्टिंग प्रक्रिया को छोटे, अधिक कुशल LM पर ऑफलोड कर सुलझाता है, जो समानांतर में ड्राफ्ट बना सकता है। इस अप्रोच से कुल प्रोसेसिंग समय घटता है—कुछ मामलों में लेटेंसी 51% तक कम हुई।
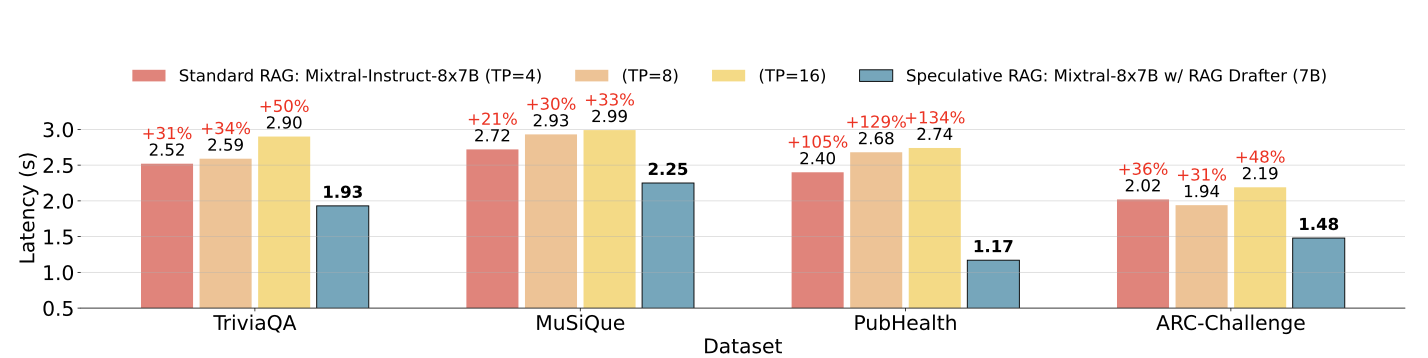
विभिन्न डेटासेट्स पर स्पेक्युलेटिव RAG लेटेंसी बनाम स्टैंडर्ड RAG लेटेंसी। स्रोत: Wang et al., 2024
स्पेक्युलेटिव RAG ड्राफ्टिंग कार्य को छोटे LM को सौंपकर संसाधनों का उपयोग ऑप्टिमाइज़ करता है, जो पारंपरिक RAG में प्रयुक्त बड़े जनरलिस्ट LM की तुलना में कम कंप्यूटेशनल-इंटेंसिव होता है। यह कार्य-विभाजन न केवल जनरेशन को तेज़ करता है बल्कि कुल कंप्यूटेशनल लोड भी घटाता है, जिससे यह अधिक संसाधन-दक्ष समाधान बनता है।
स्पेक्युलेटिव RAG फ्रेमवर्क अत्यधिक अनुकूलनीय है और व्यापक ट्यूनिंग के बिना विभिन्न ज्ञान-गहन कार्यों पर लागू किया जा सकता है। यह स्केलेबिलिटी इसे प्रश्नोत्तर से लेकर जटिल दस्तावेज़ विश्लेषण तक, कई प्रकार के अनुप्रयोगों के लिए उपयुक्त बनाती है।
स्पेक्युलेटिव RAG का एक सरल संस्करण बेसिक प्रश्नोत्तर कार्य के लिए इम्प्लीमेंट करने हेतु, हम एक छोटा डेटासेट और दो मॉडलों के साथ सरल सेटअप का उपयोग करेंगे—ड्राफ्टिंग के लिए छोटा मॉडल और वेरिफिकेशन के लिए बड़ा मॉडल।
सरलता के लिए, हम Hugging Face Transformers लाइब्रेरी का उपयोग करेंगे। हम दिखाएँगे कि छोटे भाषा मॉडल से कई ड्राफ्ट कैसे बनाए जाएँ और बड़े मॉडल से सर्वश्रेष्ठ ड्राफ्ट का वेरिफाइ और चयन कैसे किया जाए।
पहले आवश्यक लाइब्रेरी इंस्टॉल करते हैं। HuggingFace से transformers लाइब्रेरी इंस्टॉल करने के बाद आपको सेशन रीस्टार्ट करना होगा। सुनिश्चित करें कि आपने Collab या किसी अन्य एडिटर में सीक्रेट की के तहत HuggingFace क्रेडेंशियल्स जोड़े हैं।
!pip install transformers torch datasetsइस उदाहरण के लिए, हम Hugging Face डेटासेट्स लाइब्रेरी से उपलब्ध SQuAD (Stanford Question Answering Dataset) का उपयोग करेंगे।
from datasets import load_dataset
# Load the SQuAD dataset
dataset = load_dataset("squad", split="train[:100]") # Using a small subsetहम Hugging Face लाइब्रेरी से दो प्री-ट्रेन्ड मॉडल का उपयोग करेंगे। एक छोटा मॉडल (distilbert-base-uncased-distilled-squad) हमारा RAG Drafter होगा, और बड़ा मॉडल (bert-large-uncased-whole-word-masking-finetuned-squad) RAG Verifier होगा।
इसके बाद, हम चुने गए मॉडलों के साथ Drafter और verifier पाइपलाइन बनाएँगे।
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

# Initialize the smaller model (RAG Drafter)
drafter_model_name = "distilbert-base-uncased-distilled-squad"
drafter_model = AutoModelForQuestionAnswering.from_pretrained(drafter_model_name)
drafter_tokenizer = AutoTokenizer.from_pretrained(drafter_model_name)

# Initialize the larger model (RAG Verifier)
verifier_model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
verifier_model = AutoModelForQuestionAnswering.from_pretrained(verifier_model_name)
verifier_tokenizer = AutoTokenizer.from_pretrained(verifier_model_name)

# Set up pipelines
drafter_pipeline = pipeline("question-answering", model=drafter_model, tokenizer=drafter_tokenizer)
verifier_pipeline = pipeline("question-answering", model=verifier_model, tokenizer=verifier_tokenizer)अब, हम प्री-डिफाइंड Drafter पाइपलाइन के साथ छोटे मॉडल का उपयोग करके कई ड्राफ्ट जनरेट करने के लिए एक फ़ंक्शन परिभाषित करेंगे।
def generate_drafts(question, context, num_drafts=3):
   drafts = []
   for _ in range(num_drafts):
       draft = Drafter_pipeline(question=question, context=context)
       drafts.append(draft)
return draftsअब हम verify_drafts() फ़ंक्शन परिभाषित करेंगे जो बड़े मॉडल का उपयोग कर कॉन्फिडेंस स्कोर्स के आधार पर सर्वश्रेष्ठ ड्राफ्ट को वेरिफाइ और सिलेक्ट करता है।
यह फ़ंक्शन ऑफ़सेट मैपिंग का उपयोग कर प्रत्येक ड्राफ्ट की शुरुआत और अंत के कैरेक्टर पोज़िशन को टोकनाइज़्ड कॉन्टेक्स्ट में संबंधित टोकन पोज़िशन से मैप करता है। फिर वेरिफायर मॉडल इन पोज़िशनों के सही उत्तर होने में अपने भरोसे के आधार पर हर ड्राफ्ट को स्कोर करता है। सबसे अधिक कॉन्फिडेंस स्कोर वाला ड्राफ्ट सर्वश्रेष्ठ उत्तर चुना जाता है, जिससे अंतिम आउटपुट सटीक और भरोसेमंद रहता है।
टोकन एलाइनमेंट और स्कोरिंग का यह सावधानीपूर्वक हैंडलिंग, स्पेक्युलेटिव RAG के बेहतर प्रदर्शन की कुंजी है।
def verify_drafts(question, context, drafts):
    best_draft = None
    highest_score = 0

    # Tokenize the context using the verifier's tokenizer, keeping track of offsets
    inputs = verifier_tokenizer(question, context, return_tensors="pt", return_offsets_mapping=True)
    offset_mapping = inputs['offset_mapping'][0]  # This will give us the character-to-token mapping
    input_ids = inputs['input_ids'][0]

    for draft in drafts:
        start_char = draft['start']
        end_char = draft['end']

        # Find the corresponding token positions using offset mapping
        start_index = None
        end_index = None

        for idx, (start, end) in enumerate(offset_mapping):
            if start_index is None and start_char >= start and start_char < end:
                start_index = idx
            if end_index is None and end_char > start and end_char <= end:
                end_index = idx
            if start_index is not None and end_index is not None:
                break

        # Ensure indices were found and are within bounds
        if (start_index is None or end_index is None or
                start_index >= len(input_ids) or end_index >= len(input_ids)):
            print(f"Draft skipped: Out of bounds or no matching tokens. "
                  f"Start Index: {start_index}, End Index: {end_index}")
            continue

        # Get the confidence score using the larger model
        outputs = verifier_model(input_ids=input_ids.unsqueeze(0))
        score = (outputs.start_logits[0, start_index].item() +
                 outputs.end_logits[0, end_index].item())

        if score > highest_score:
            highest_score = score
            best_draft = draft

    if best_draft is None:
        print("No valid draft found after verification.")

return best_draftअब, डेटासेट के 10 नमूनों पर अपनी स्पेक्युलेटिव RAG प्रक्रिया लागू करते हैं।
correct = 0
total = 10  # Evaluate on 10 samples for simplicity

for i in range(total):
    sample = dataset[i]
    question = sample['question']
    context = sample['context']
    drafts = generate_drafts(question, context)
    best_answer = verify_drafts(question, context, drafts)

    print(f"Q: {question}")

    if best_answer is not None:
        print(f"A: {best_answer['answer']}\n")
        # For simplicity, compare with the first answer (gold) provided in the dataset
        if best_answer['answer'].lower() in sample['answers']['text'][0].lower():
            correct += 1
    else:
        print("No valid draft found.\n")

accuracy = correct / total * 100
print(f"Accuracy: {accuracy}%")
यह कोड स्निपेट किसी डेटासेट के 10 नमूनों पर स्पेक्युलेटिव RAG के सरल इम्प्लीमेंटेशन की सटीकता का मूल्यांकन करता है। हर नमूने के लिए यह दिए गए प्रश्न और संदर्भ के आधार पर कई उत्तर ड्राफ्ट बनाता है और फिर वेरिफिकेशन फ़ंक्शन से सर्वश्रेष्ठ ड्राफ्ट चुनता है। यदि वैध उत्तर मिलता है, तो उसे डेटासेट में दिए गए गोल्ड (सही) उत्तर से तुलना करता है। मेल खाने पर correct काउंट बढ़ा दिया जाता है।
अंत में, कोड कुल नमूनों में से सही उत्तरों का प्रतिशत निकालकर सटीकता प्रिंट करता है। इस सरल डेटासेट पर यह कोड 90% सटीकता देता है।
हालाँकि स्पेक्युलेटिव RAG अच्छे परिणाम देता है, कुछ चुनौतियाँ भी हैं:
स्पेक्युलेटिव RAG उन अनेक क्षेत्रों में लागू किया जा सकता है जहाँ सटीक और कुशल सूचना-प्राप्ति महत्वपूर्ण है। कुछ संभावित उपयोग हैं:
स्पेक्युलेटिव RAG, सटीकता, कम लेटेंसी, संसाधन-दक्षता और स्केलेबिलिटी के साथ retrieval-augmented generation को बेहतर बनाता है। हमने इसका इम्प्लीमेंटेशन Hugging Face Transformers के साथ प्रदर्शित किया।
हालाँकि चुनौतियाँ मौजूद हैं, विभिन्न डोमेन्स में स्पेक्युलेटिव RAG की संभावनाएँ आगे के शोध के लिए इसे आशाजनक बनाती हैं।
यदि आप RAG इम्प्लीमेंटेशन के बारे में अधिक सीखना चाहते हैं, तो मैं निम्नलिखित ट्यूटोरियल की सिफारिश करता/करती हूँ:
इन कोर्सेज़ के साथ AI सीखें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}