Kursus
Pengantar R
4 jam
3.1M

Teknik data mining atau machine learning sering kali dapat dimanfaatkan pada tahap awal riset biomedis untuk menganalisis dataset berukuran besar, misalnya untuk membantu identifikasi gen kandidat atau biomarker penyakit prediktif pada dataset sekuensing high-throughput. Namun, data dari uji klinis biasanya mencakup “data survival” yang memerlukan pendekatan analisis yang cukup berbeda.
Pada jenis analisis ini, waktu hingga suatu kejadian tertentu, seperti kematian atau kekambuhan penyakit, menjadi fokus, dan dua (atau lebih) kelompok pasien dibandingkan terkait waktu tersebut. Tiga konsep inti dapat digunakan untuk memperoleh hasil yang bermakna dari dataset semacam ini dan tujuan tutorial ini adalah memperkenalkan konsep statistik, interpretasinya, serta penerapan metode-metode ini pada dunia nyata beserta implementasinya di R:
Dalam tutorial ini, Anda juga akan menggunakan paket survival dan survminer di R serta dataset ovarian (Edmunson J.H. et al., 1979) yang disertakan dalam paket survival. Anda akan membaca lebih lanjut tentang dataset ini nanti dalam tutorial!
Tip: lihat lembar contekan survminer ini
Setelah tutorial ini, Anda akan dapat memanfaatkan data tersebut untuk menjawab pertanyaan seperti: apakah pasien mendapat manfaat dari rejimen terapi A dibandingkan rejimen B? Apakah usia dan kebugaran pasien secara signifikan memengaruhi hasil? Apakah penyakit residual merupakan biomarker prognosis dalam hal survival?
Sebelum masuk ke detail statistik, Anda mungkin ingin mempelajari beberapa istilah yang berguna:
Istilah "censoring" mengacu pada data yang tidak lengkap. Meskipun ada berbagai jenis, pada titik ini Anda mungkin ingin membatasi diri pada data right-censored karena ini adalah jenis censoring yang paling umum dalam dataset survival.
Untuk beberapa pasien, Anda mungkin tahu bahwa ia diikuti selama waktu tertentu tanpa terjadi “kejadian”, tetapi Anda mungkin tidak tahu apakah pada akhirnya pasien tersebut selamat atau tidak. Ini bisa terjadi jika pasien hilang dari tindak lanjut atau menarik diri dari studi. Data pada pasien ini akan “dicensor” setelah titik waktu terakhir ketika Anda tahu dengan pasti bahwa pasien Anda belum mengalami “kejadian” yang Anda cari. Kejadian adalah titik akhir yang telah ditentukan sebelumnya dalam studi Anda, misalnya kematian atau kekambuhan penyakit. Selain itu, semua pasien yang tidak mengalami “kejadian” hingga studi berakhir akan dicensor pada titik waktu terakhir tersebut.
Pada dasarnya, ada tiga alasan mengapa data bisa dicensor.
Dengan demikian, jumlah observasi yang dicensor selalu n >= 0. Semua contoh ini merupakan kasus “right-censoring” dan dapat diklasifikasikan lebih lanjut menjadi censoring tipe I tetap atau acak dan censoring tipe II, tetapi pengelompokan ini terutama relevan dari sudut pandang desain studi dan tidak akan dibahas dalam tutorial pengantar ini.
Hal yang perlu Anda ingat adalah bahwa semua jenis censoring merupakan kasus ketiadaan informasi dan censoring tidak pernah disebabkan oleh “kejadian” yang mendefinisikan titik akhir studi Anda. Ini juga menyiratkan bahwa tidak ada pasien yang dicensor dalam dataset ovarian karena pasien yang bersangkutan meninggal.
Lalu, seperti apa bentuk fungsi survival yang menggambarkan kelangsungan hidup pasien dari waktu ke waktu?
Estimator Kaplan-Meier, yang secara independen dideskripsikan oleh Edward Kaplan dan Paul Meier dan diterbitkan bersama pada tahun 1958 di Journal of the American Statistical Association, adalah statistik nonparametrik yang memungkinkan kita mengestimasi fungsi survival.
Ingat bahwa statistik nonparametrik tidak didasarkan pada asumsi distribusi probabilitas yang mendasari, yang masuk akal karena data survival memiliki distribusi yang condong.
Statistik ini memberikan probabilitas bahwa seorang pasien akan bertahan melewati waktu tertentu t. Pada t = 0, estimator Kaplan-Meier bernilai 1 dan ketika t menuju tak terhingga, estimasi menuju 0. Secara teoretis, dengan dataset yang sangat besar dan t diukur hingga detik, fungsi t versus probabilitas survival akan mulus. Nanti, Anda akan melihat bagaimana bentuknya dalam praktik.
Lebih lanjut, ini didasarkan pada asumsi bahwa probabilitas bertahan melewati titik waktu tertentu t sama dengan hasil kali laju survival yang teramati hingga titik waktu t. Lebih tepatnya, S(t) #probabilitas survival pada waktu t diberikan oleh S(t) = p.1 * p.2 * … * p.t dengan p.1 adalah proporsi semua pasien yang bertahan melewati titik waktu pertama, p.2 adalah proporsi pasien yang bertahan melewati titik waktu kedua, dan seterusnya hingga mencapai titik waktu t.
Penting untuk diperhatikan bahwa, mulai dari p.2 hingga p.t, Anda hanya menghitung pasien yang bertahan melewati titik waktu sebelumnya saat menghitung proporsi untuk setiap titik waktu berikutnya; dengan demikian, p.2, p.3, …, p.t adalah proporsi yang bersyarat pada proporsi sebelumnya.
Dalam praktik, Anda ingin mengurutkan waktu survival terlebih dahulu berdasarkan durasi yang meningkat. Ini mencakup nilai yang dicensor. Kemudian Anda menghitung proporsi seperti dijelaskan di atas dan mengalikannya untuk memperoleh S(t). Pasien yang dicensor diabaikan setelah titik waktu censoring, sehingga mereka tidak memengaruhi proporsi pasien yang bertahan. Untuk informasi detail tentang metodenya, lihat (Swinscow dan Campbell, 2002).
Catatan terakhir, Anda dapat menggunakan uji log-rank untuk membandingkan kurva survival dua kelompok. Uji log-rank adalah uji hipotesis statistik yang menguji hipotesis nol bahwa kurva survival dari dua populasi tidak berbeda. Suatu distribusi probabilitas, yaitu distribusi chi-kuadrat, dapat digunakan untuk memperoleh p-value. Secara singkat, p-value digunakan dalam pengujian hipotesis statistik untuk mengukur signifikansi statistik. Hasil dengan p < 0.05 biasanya dianggap signifikan. Dalam kasus kita, p < 0.05 akan menunjukkan bahwa dua kelompok perlakuan berbeda secara signifikan dalam hal survival.
Fungsi lain yang berguna dalam konteks analisis survival adalah fungsi hazard h(t). Ini menggambarkan probabilitas suatu kejadian atau hazard-nya h (sekali lagi, kematian dalam hal ini) jika subjek bertahan hingga titik waktu tertentu t. Ini sedikit lebih sulit diilustrasikan dibanding estimator Kaplan-Meier karena mengukur risiko kematian sesaat. Meski begitu, Anda memerlukan fungsi hazard untuk mempertimbangkan kovariat saat membandingkan survival kelompok pasien. Kovariat, juga disebut variabel penjelas atau independen dalam analisis regresi, adalah variabel yang berpotensi memprediksi suatu luaran atau yang ingin Anda sesuaikan untuk memperhitungkan interaksi antarkomponen variabel.
Jika uji log-rank membandingkan dua kurva survival Kaplan-Meier, yang mungkin diperoleh dari pemisahan populasi pasien menjadi subkelompok perlakuan, maka model Cox proportional hazards diturunkan dari fungsi hazard dasar (baseline) populasi pasien yang bersangkutan dan sejumlah kovariat dikotomis yang arbitrer. Sekali lagi, model ini tidak mengasumsikan distribusi probabilitas yang mendasari tetapi mengasumsikan bahwa hazard dari kelompok pasien yang Anda bandingkan konstan dari waktu ke waktu. Itulah sebabnya disebut “proportional hazards model”. Nanti, Anda akan melihat contoh yang mengilustrasikan pertimbangan teoretis ini.
Sekarang, mari kita coba menganalisis dataset ovarian!
Dengan konsep-konsep ini, Anda sekarang dapat mulai menganalisis dataset nyata dan mencoba menjawab beberapa pertanyaan di atas. Mari mulai dengan memuat dua paket yang diperlukan untuk analisis dan paket dplyr yang menyertakan beberapa fungsi berguna untuk mengelola data frame.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Tip: jangan lupa gunakan install.packages() untuk memasang paket apa pun yang mungkin belum ada di workspace Anda!
Langkah berikutnya adalah memuat dataset dan memeriksa strukturnya. Seperti yang Anda baca di awal tutorial ini, Anda akan bekerja dengan data set ovarian. Dataset ini memuat kohort pasien kanker ovarium dan informasi klinis terkait, termasuk lama waktu pasien dilacak hingga mereka meninggal atau hilang dari tindak lanjut (futime), apakah pasien dicensor atau tidak (fustat), usia pasien, penugasan kelompok perawatan, keberadaan penyakit residual, dan status performa.
Seperti yang sudah terlihat, beberapa nama variabel agak samar; Anda juga mungkin ingin melihat halaman bantuan.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
Kolom futime berisi waktu survival. Ini adalah variabel respons. Sementara itu, fustat memberi tahu Anda apakah waktu survival pasien tertentu dicensor. Tampaknya, 26 pasien dalam studi ini menerima salah satu dari dua rejimen terapi (rx) dan dokter yang merawat menilai regresi tumor (resid.ds) dan performa pasien (menurut kriteria standar ECOG; ecog.ps) pada suatu waktu.
Selain itu, Anda memperoleh informasi tentang usia pasien dan jika Anda ingin memasukkannya sebagai variabel prediktif nantinya, Anda harus mendikotomikan nilai kontinu menjadi biner. Namun, cutoff apa yang sebaiknya dipilih? Mari lihat distribusi keseluruhan nilai usia:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 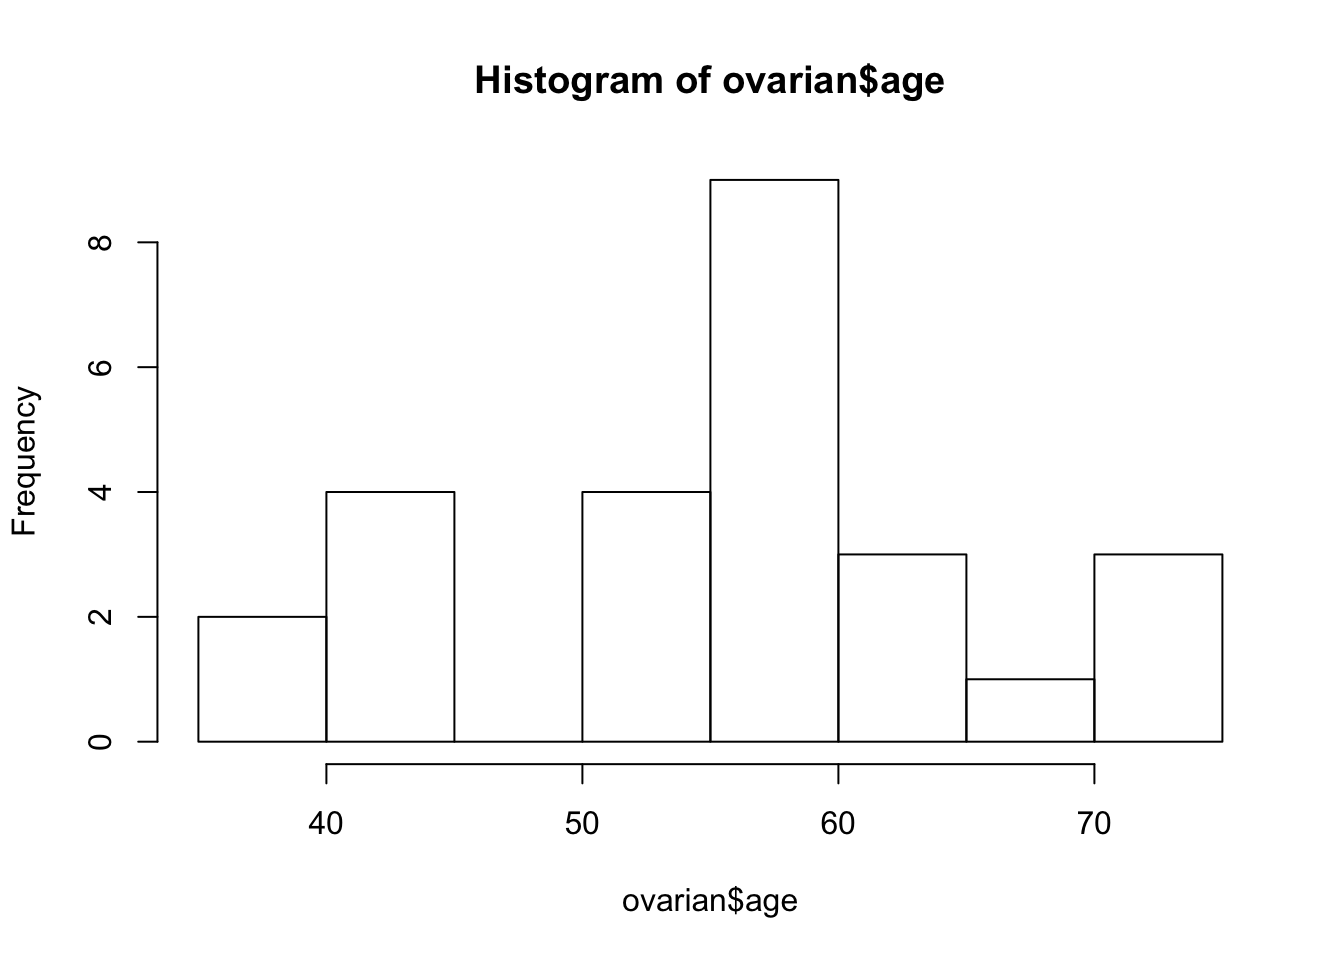
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
Distribusi yang jelas bi-modal menyarankan cutoff 50 tahun. Anda dapat menggunakan fungsi mutate untuk menambahkan kolom age_group tambahan ke data frame yang akan berguna nanti. Selain itu, Anda sebaiknya mengonversi kovariat yang akan digunakan menjadi faktor.
Sekarang, Anda siap membuat objek survival. Ini pada dasarnya adalah versi kompilasi dari kolom futime dan fustat yang dapat diinterpretasikan oleh fungsi survfit. Tanda + di belakang waktu survival menunjukkan titik data yang dicensor.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Langkah selanjutnya adalah mem-fit kurva Kaplan-Meier. Anda dapat melakukannya dengan mudah dengan meneruskan surv_object ke fungsi survfit. Anda juga dapat melakukan stratifikasi kurva berdasarkan rejimen pengobatan rx yang ditugaskan kepada pasien. summary() dari objek fit1 yang dihasilkan menampilkan, antara lain, waktu survival, proporsi pasien yang bertahan pada setiap titik waktu, yaitu p.1, p.2, ... dari atas, dan kelompok perlakuan.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Anda dapat memeriksa kurva survival yang sesuai dengan meneruskan objek survival ke fungsi ggsurvplot. Argumen pval = TRUE sangat berguna, karena juga memplot p-value dari uji log-rank!
ggsurvplot(fit1, data = ovarian, pval = TRUE)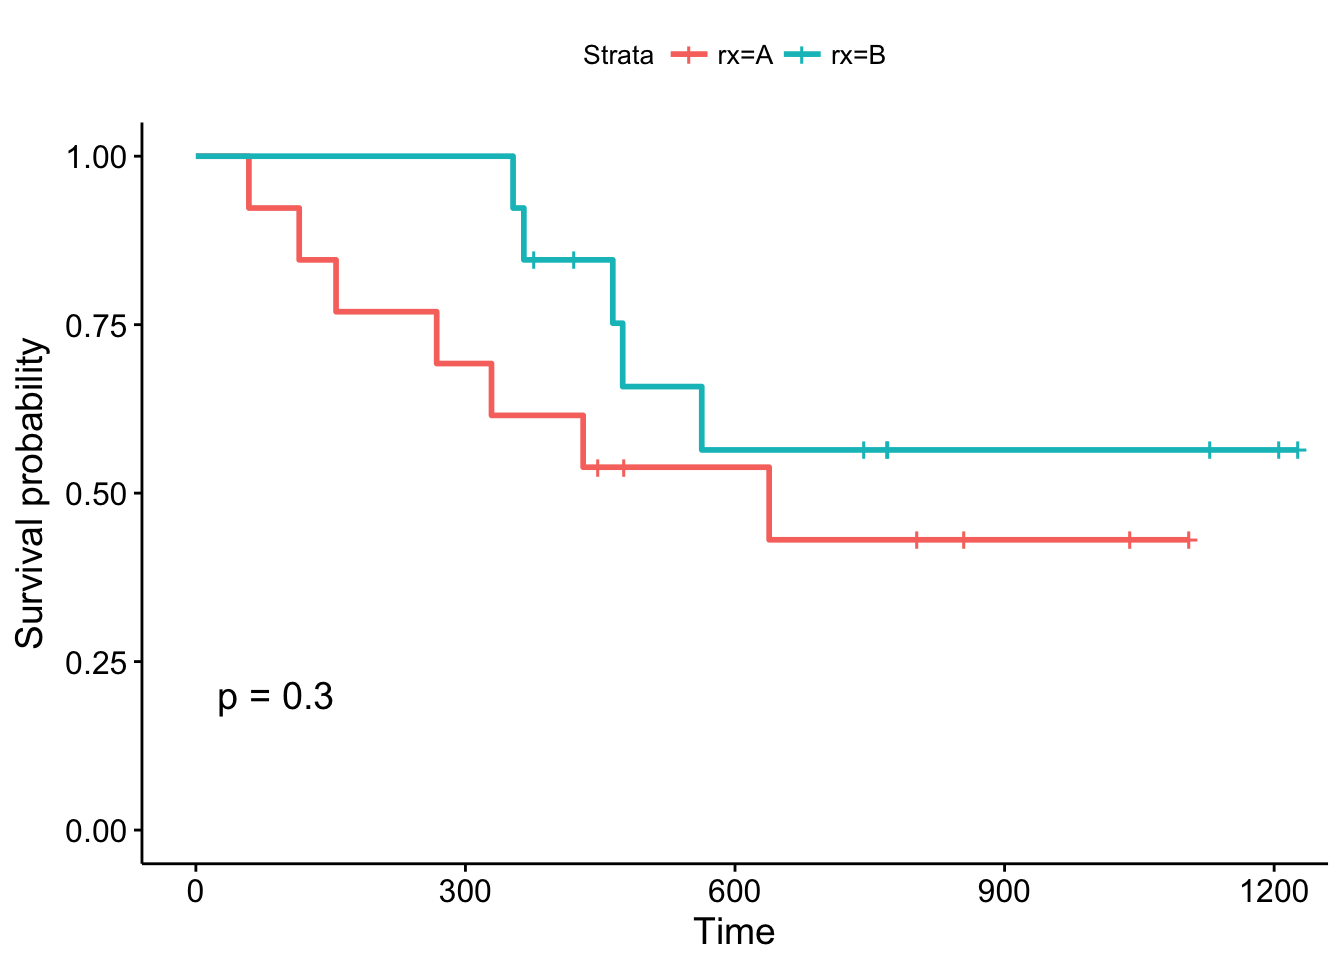
Secara konvensi, garis vertikal menunjukkan data yang dicensor, dengan nilai x yang sesuai menunjukkan waktu terjadinya censoring.
P-value log-rank sebesar 0.3 menunjukkan hasil yang tidak signifikan jika Anda menganggap p < 0.05 sebagai batas signifikansi statistik. Dalam studi ini, tidak ada perlakuan yang diteliti yang secara signifikan lebih unggul, meskipun pasien yang menerima perlakuan B terlihat lebih baik pada bulan pertama tindak lanjut. Bagaimana dengan variabel lainnya?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)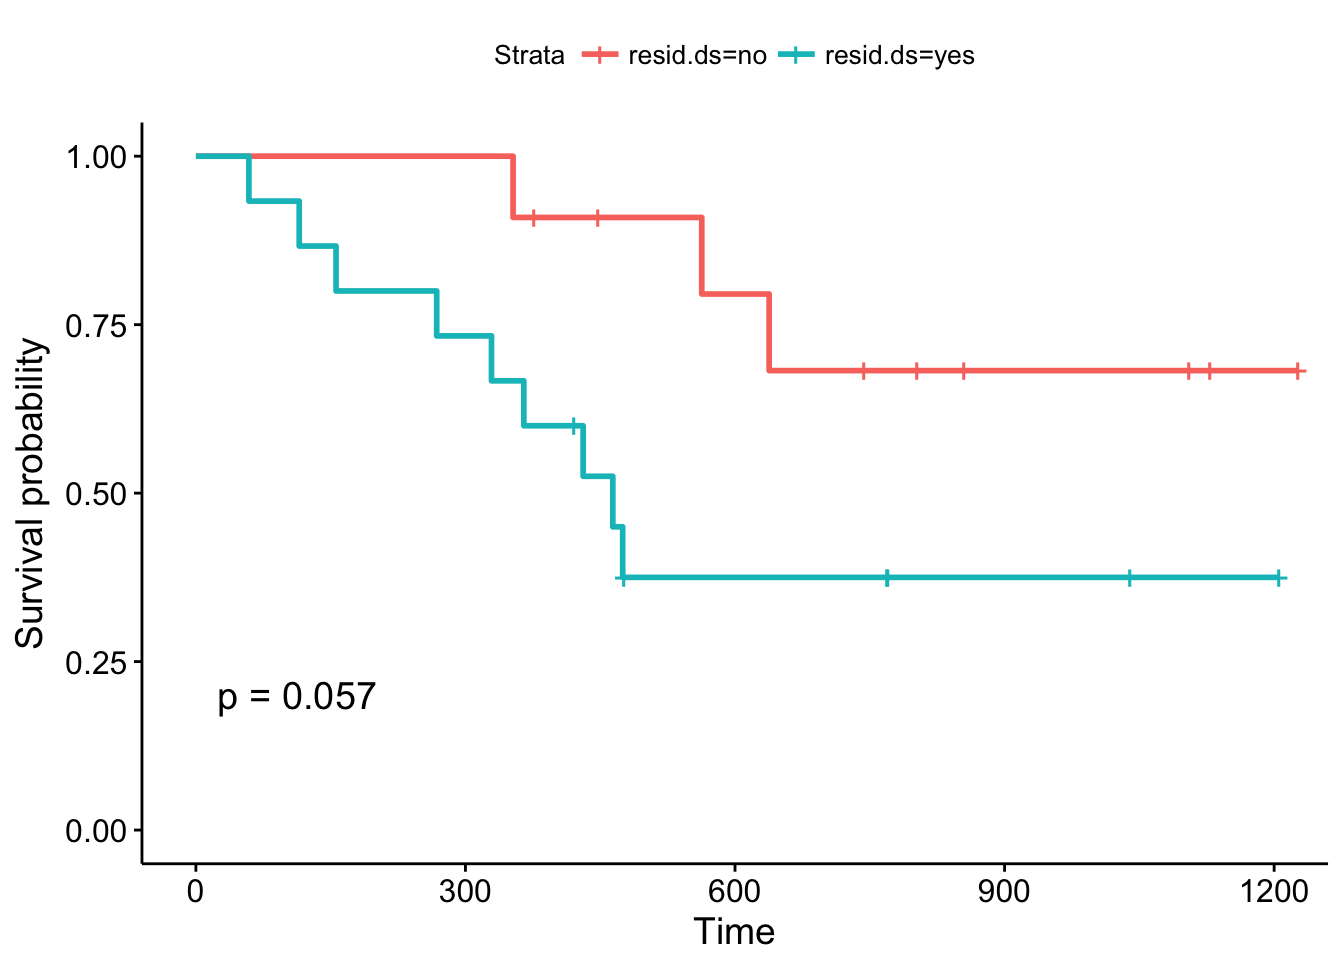
Plot Kaplan-Meier yang distratifikasi menurut status penyakit residual tampak sedikit berbeda: Kurva menyimpang lebih awal dan uji log-rank hampir signifikan. Anda mungkin berpendapat bahwa studi lanjutan dengan ukuran sampel yang lebih besar dapat memvalidasi hasil ini, yaitu bahwa pasien dengan status penyakit residual positif memiliki prognosis yang secara signifikan lebih buruk dibandingkan pasien tanpa penyakit residual.
Namun, adakah cara yang lebih sistematis untuk melihat berbagai kovariat? Seperti yang mungkin Anda ingat dari salah satu bagian sebelumnya, model Cox proportional hazards memungkinkan Anda memasukkan kovariat. Anda dapat membangun model Cox proportional hazards menggunakan fungsi coxph dan memvisualisasikannya menggunakan ggforest. Jenis plot ini disebut forest plot. Plot ini menampilkan apa yang disebut hazard ratio (HR) yang diturunkan dari model untuk semua kovariat yang kita masukkan ke dalam formula di coxph. Singkatnya, HR > 1 menunjukkan peningkatan risiko kematian (menurut definisi h(t)) jika suatu kondisi tertentu terpenuhi pada pasien. Sebaliknya, HR < 1 menunjukkan penurunan risiko. Mari lihat keluaran modelnya:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)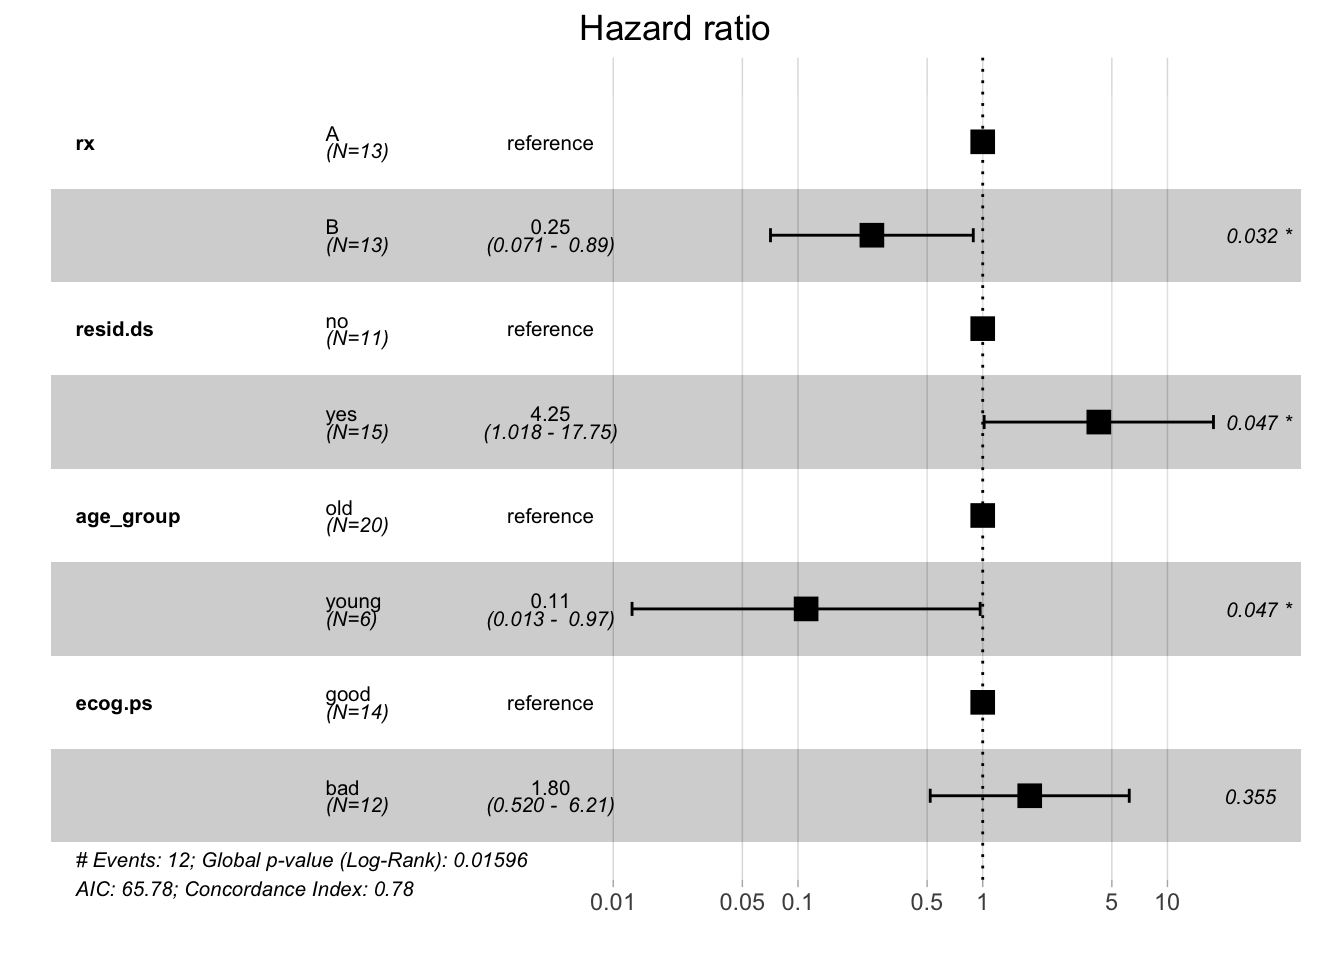
Setiap HR merepresentasikan risiko relatif kematian yang membandingkan satu instance dari fitur biner dengan instance lainnya. Misalnya, hazard ratio sebesar 0,25 untuk kelompok perlakuan memberi tahu Anda bahwa pasien yang menerima perlakuan B memiliki risiko kematian yang lebih rendah dibandingkan pasien yang menerima perlakuan A (yang berfungsi sebagai referensi untuk menghitung hazard ratio). Seperti ditunjukkan oleh forest plot, interval kepercayaan 95% yang bersesuaian adalah 0,071 - 0,89 dan hasil ini signifikan.
Menggunakan model ini, Anda dapat melihat bahwa variabel kelompok perlakuan, status penyakit residual, dan kelompok usia secara signifikan memengaruhi risiko kematian pasien dalam studi ini. Ini cukup berbeda dari apa yang Anda lihat dengan estimator Kaplan-Meier dan uji log-rank. Jika yang pertama mengestimasi probabilitas survival, yang terakhir menghitung risiko kematian dan hazard ratio terkait. Analisis Anda menunjukkan bahwa hasil yang dihasilkan oleh metode ini dapat berbeda dalam hal signifikansi.
Contoh di atas menunjukkan betapa mudahnya mengimplementasikan konsep statistik analisis survival di R. Dalam pengantar ini, Anda telah mempelajari cara membangun model terkait, cara memvisualisasikannya, dan juga beberapa latar belakang statistik yang membantu memahami hasil analisis Anda. Semoga sekarang Anda dapat mulai menggunakan teknik ini untuk menganalisis dataset Anda sendiri. Terima kasih telah membaca tutorial ini!
Lihat Tutorial Regresi Linear di R kami.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



