Cours
Introduction à R
4 h
3.1M

Les techniques de fouille de données ou d’apprentissage automatique peuvent souvent être mobilisées dès les premières étapes de la recherche biomédicale pour analyser de grands jeux de données, par exemple pour identifier des gènes candidats ou des biomarqueurs prédictifs de maladie dans des jeux de données de séquençage à haut débit. Cependant, les données issues des essais cliniques incluent généralement des « données de survie » qui nécessitent une approche d’analyse assez différente.
Dans ce type d’analyse, on s’intéresse au temps jusqu’à un événement spécifique, comme le décès ou la récidive, et l’on compare deux (ou plusieurs) groupes de patients par rapport à ce temps. Trois concepts clés permettent de tirer des résultats pertinents de ce type de jeu de données. L’objectif de ce tutoriel est de présenter ces concepts statistiques, leur interprétation, ainsi qu’une application concrète de ces méthodes et leur implémentation en R :
Dans ce tutoriel, vous utiliserez également les packages R survival et survminer, ainsi que le jeu de données ovarian (Edmunson J.H. et al., 1979) fourni avec le package survival. Vous en saurez plus sur ce jeu de données un peu plus loin !
Astuce : consultez cette antisèche survminer
Après ce tutoriel, vous serez en mesure d’exploiter ces données pour répondre à des questions comme : les patients bénéficient‑ils davantage du schéma thérapeutique A que du schéma B ? L’âge et l’état général des patients influencent‑ils significativement l’issue ? La maladie résiduelle est‑elle un biomarqueur pronostique en termes de survie ?
Avant d’entrer dans le détail statistique, voici quelques termes utiles :
Le terme « censure » désigne des données incomplètes. Il en existe différents types, mais concentrez‑vous ici sur la censure à droite, la plus courante dans les jeux de données de survie.
Pour certains patients, vous savez qu’ils ont été suivis pendant un certain temps sans qu’un « événement » ne survienne, mais vous ignorez s’ils ont finalement survécu ou non. C’est le cas, par exemple, lorsqu’un patient est perdu de vue ou se retire de l’étude. Les données de ce patient sont alors « censurées » après le dernier point temporel auquel vous êtes certain que l’événement recherché ne s’était pas produit. Un événement est le critère d’évaluation prédéfini de votre étude, par exemple le décès ou la récidive. De même, tous les patients qui n’auront pas connu l’événement à la fin de l’étude seront censurés à ce dernier temps d’observation.
En substance, ce sont les trois raisons principales pour lesquelles des données peuvent être censurées.
Ainsi, le nombre d’observations censurées est toujours n >= 0. Tous ces exemples relèvent de la « censure à droite ». On peut affiner en censure de type I (fixe ou aléatoire) et de type II, mais ces distinctions concernent surtout le plan d’étude et ne seront pas abordées dans ce tutoriel introductif.
Gardez à l’esprit que toute censure correspond à une absence d’information et qu’elle n’est jamais due à l’« événement » qui définit le critère principal de votre étude. Cela implique notamment qu’aucun des patients censurés dans le jeu de données ovarian ne l’a été parce que le patient est décédé.
À quoi ressemble une fonction de survie qui décrit la probabilité de survie des patients au fil du temps ?
L’estimateur de Kaplan‑Meier, décrit indépendamment par Edward Kaplan et Paul Meier puis publié conjointement en 1958 dans le Journal of the American Statistical Association, est une statistique non paramétrique qui permet d’estimer la fonction de survie.
Rappel : une statistique non paramétrique ne repose pas sur l’hypothèse d’une loi de probabilité sous‑jacente, ce qui est pertinent ici, les données de survie présentant une distribution asymétrique.
Cette statistique donne la probabilité qu’un patient donné survive au‑delà d’un instant t. À t = 0, l’estimateur de Kaplan‑Meier vaut 1 et, lorsque t tend vers l’infini, il tend vers 0. En théorie, avec un jeu de données infiniment grand et un temps mesuré à la seconde, la fonction t vs probabilité de survie serait lisse. Vous verrez ensuite son aspect en pratique.
On suppose en outre que la probabilité de survivre au‑delà d’un instant t est égale au produit des taux de survie observés jusqu’à t. Plus précisément, S(t) # probabilité de survie à l’instant t est donnée par S(t) = p.1 * p.2 * … * p.t, où p.1 est la proportion de patients survivant au‑delà du premier instant, p.2 la proportion survivant au‑delà du deuxième, et ainsi de suite jusqu’à t.
Il est important de noter qu’à partir de p.2 et jusqu’à p.t, vous ne tenez compte, pour chaque instant suivant, que des patients ayant survécu à l’instant précédent ; ainsi, p.2, p.3, …, p.t sont des proportions conditionnelles.
En pratique, commencez par trier les temps de survie par ordre croissant, y compris les valeurs censurées. Calculez ensuite les proportions comme décrit ci‑dessus et multipliez‑les pour obtenir S(t). Les patients censurés sont exclus après l’instant de censure et n’influencent donc pas la proportion de survivants par la suite. Pour plus de détails, voir (Swinscow et Campbell, 2002).
Enfin, vous pouvez utiliser le test du log‑rank pour comparer les courbes de survie de deux groupes. C’est un test d’hypothèse statistique qui évalue l’hypothèse nulle selon laquelle les courbes de survie de deux populations ne diffèrent pas. Une loi du chi‑deux permet d’en déduire une valeur p. En bref, les valeurs p quantifient la significativité statistique. Un résultat avec p < 0.05 est généralement jugé significatif. Dans notre cas, p < 0.05 indiquerait que les deux traitements diffèrent significativement en termes de survie.
Une autre fonction utile en analyse de survie est la fonction de risque instantané h(t). Elle décrit la probabilité d’un événement, ou son risque h (ici, le décès), conditionnellement à la survie du sujet jusqu’à l’instant t. Elle est plus difficile à illustrer que l’estimateur de Kaplan‑Meier car elle mesure le risque instantané de décès. Néanmoins, la fonction de risque est indispensable pour prendre en compte des covariables lorsque vous comparez la survie de groupes de patients. Les covariables, dites aussi variables explicatives ou indépendantes en régression, sont des variables potentiellement prédictives de l’issue ou à ajuster pour tenir compte d’interactions.
Alors que le test du log‑rank compare deux courbes de survie de Kaplan‑Meier, obtenues par exemple en scindant une population de patients en sous‑groupes de traitement, les modèles de Cox à hasards proportionnels s’appuient sur la fonction de risque de base des populations considérées et sur un nombre arbitraire de covariables dichotomisées. Là encore, ils ne supposent pas de loi de probabilité sous‑jacente, mais ils supposent que les risques des groupes comparés sont proportionnels dans le temps, d’où l’appellation « modèle à hasards proportionnels ». Vous verrez plus loin un exemple illustrant ces points théoriques.
Passons maintenant à l’analyse du jeu de données ovarian !
Avec ces concepts en tête, vous pouvez analyser un jeu de données réel et tenter de répondre à certaines des questions ci‑dessus. Commençons par charger les deux packages nécessaires à l’analyse ainsi que le package dplyr, qui propose des fonctions utiles pour manipuler les data frames.
# Load required packages
library(survival)
library(survminer)
library(dplyr)
Astuce : n’oubliez pas d’utiliser install.packages() pour installer les packages manquants dans votre espace de travail !
L’étape suivante consiste à charger le jeu de données et à en examiner la structure. Comme indiqué au début de ce tutoriel, vous allez travailler avec le jeu de données ovarian. Il s’agit d’une cohorte de patientes atteintes d’un cancer de l’ovaire et d’informations cliniques associées, notamment le temps de suivi jusqu’au décès ou à la perte de suivi (futime), l’indication de censure (fustat), l’âge, l’affectation de traitement, la présence de maladie résiduelle et le statut de performance.
Comme vous le voyez, certains noms de variables sont un peu cryptiques ; n’hésitez pas à consulter la page d’aide.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
La colonne futime contient les temps de survie : c’est la variable à expliquer. fustat indique si le temps de survie d’une patiente est censuré. Les 26 patientes de l’étude ont reçu l’un des deux schémas thérapeutiques (rx) et le médecin a évalué la régression tumorale (resid.ds) et l’état général des patientes (selon les critères ECOG standardisés ; ecog.ps).
Vous disposez aussi de l’âge des patientes. Si vous souhaitez l’inclure comme variable prédictive, il faudra dichotomiser cette variable continue en binaire. Mais quel seuil choisir ? Observons la distribution globale des âges :
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 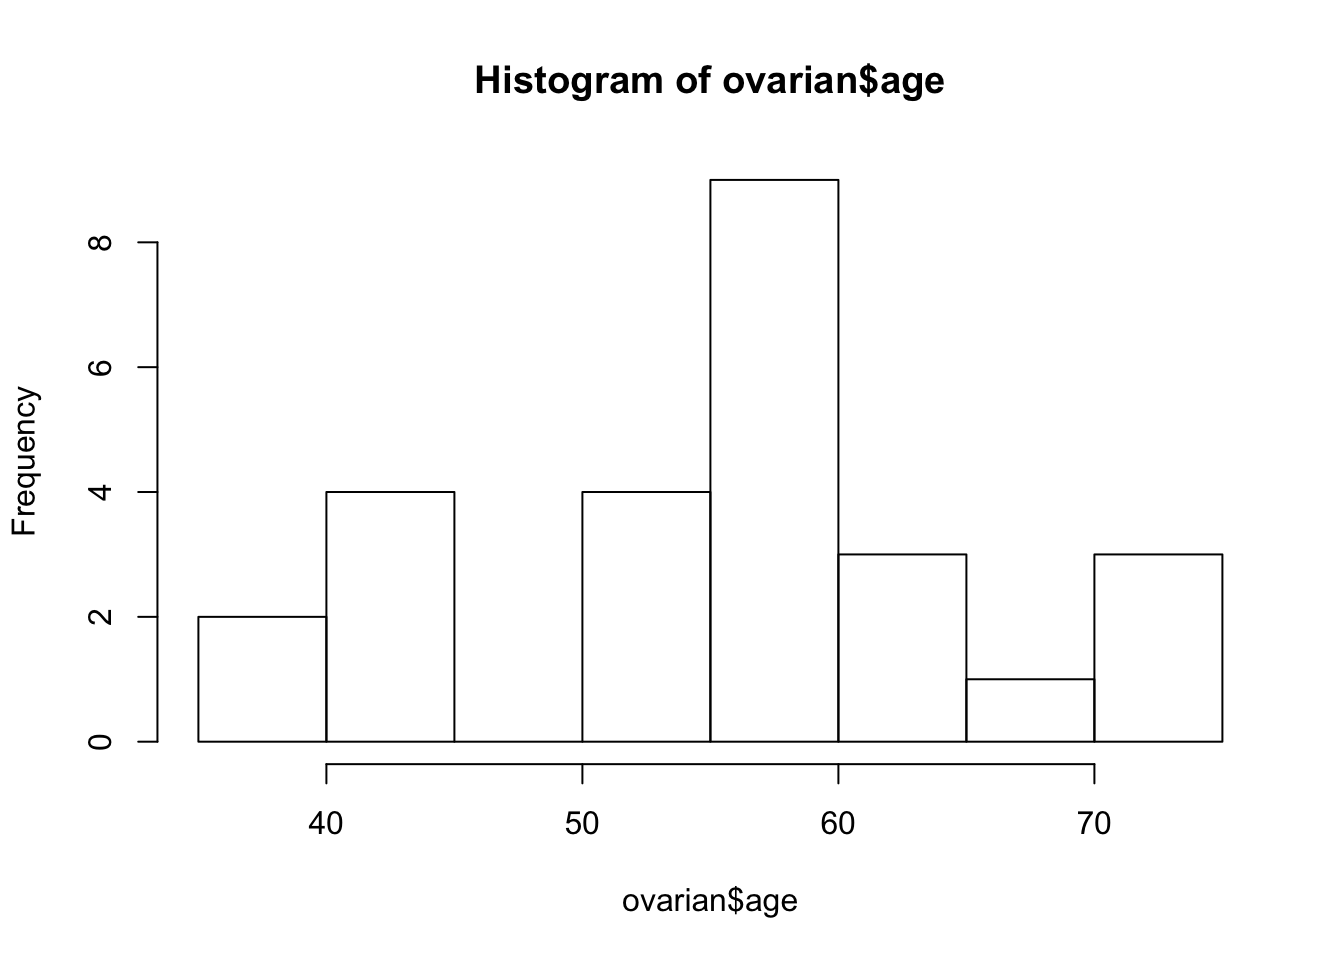
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
La distribution manifestement bimodale suggère un seuil à 50 ans. La fonction mutate vous permet d’ajouter une colonne age_group au data frame, qui sera utile par la suite. Pensez également à convertir les futures covariables en facteurs.
Vous pouvez maintenant créer un objet de survie : il s’agit essentiellement d’une combinaison des colonnes futime et fustat interprétable par la fonction survfit. Un + derrière un temps de survie indique une donnée censurée.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Étape suivante : ajuster les courbes de Kaplan‑Meier. Il suffit de passer surv_object à la fonction survfit. Vous pouvez aussi stratifier la courbe selon le schéma thérapeutique rx attribué. Un summary() de l’objet fit1 renvoie, entre autres, les temps de survie, la proportion de survivants à chaque instant — vos p.1, p.2, ... — et les groupes de traitement.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Vous pouvez visualiser la courbe de survie correspondante avec ggsurvplot. L’argument pval = TRUE est très pratique : il affiche aussi la valeur p du test du log‑rank !
ggsurvplot(fit1, data = ovarian, pval = TRUE)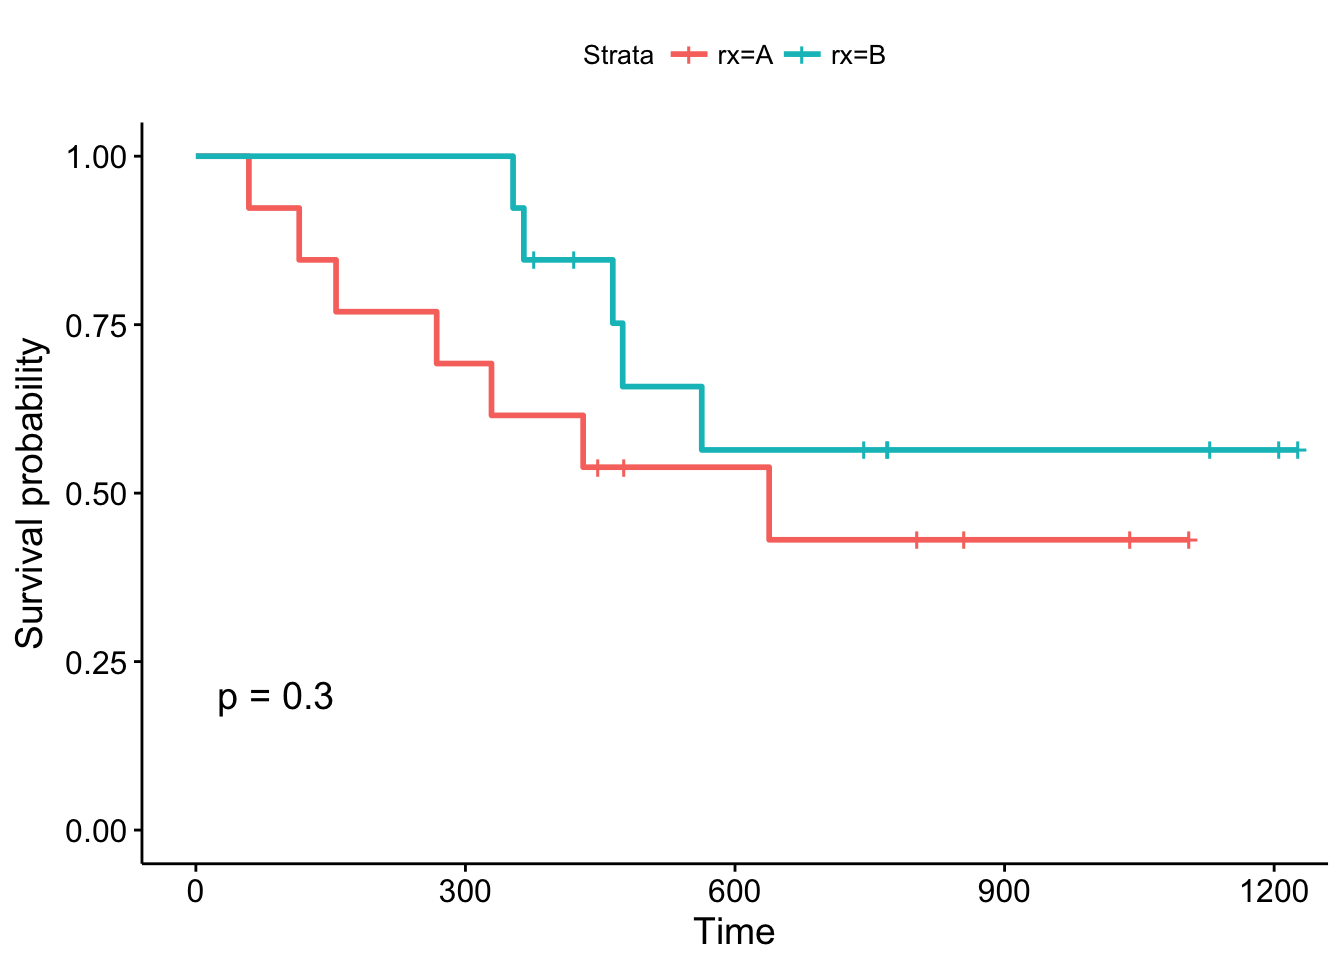
Par convention, les traits verticaux indiquent des données censurées ; leur abscisse correspond au moment de la censure.
La valeur p du log‑rank (0,3) indique un résultat non significatif si l’on retient p < 0.05 comme seuil de significativité. Dans cette étude, aucun des traitements n’est significativement supérieur, même si les patientes sous traitement B semblent mieux se porter durant le premier mois de suivi. Qu’en est‑il des autres variables ?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)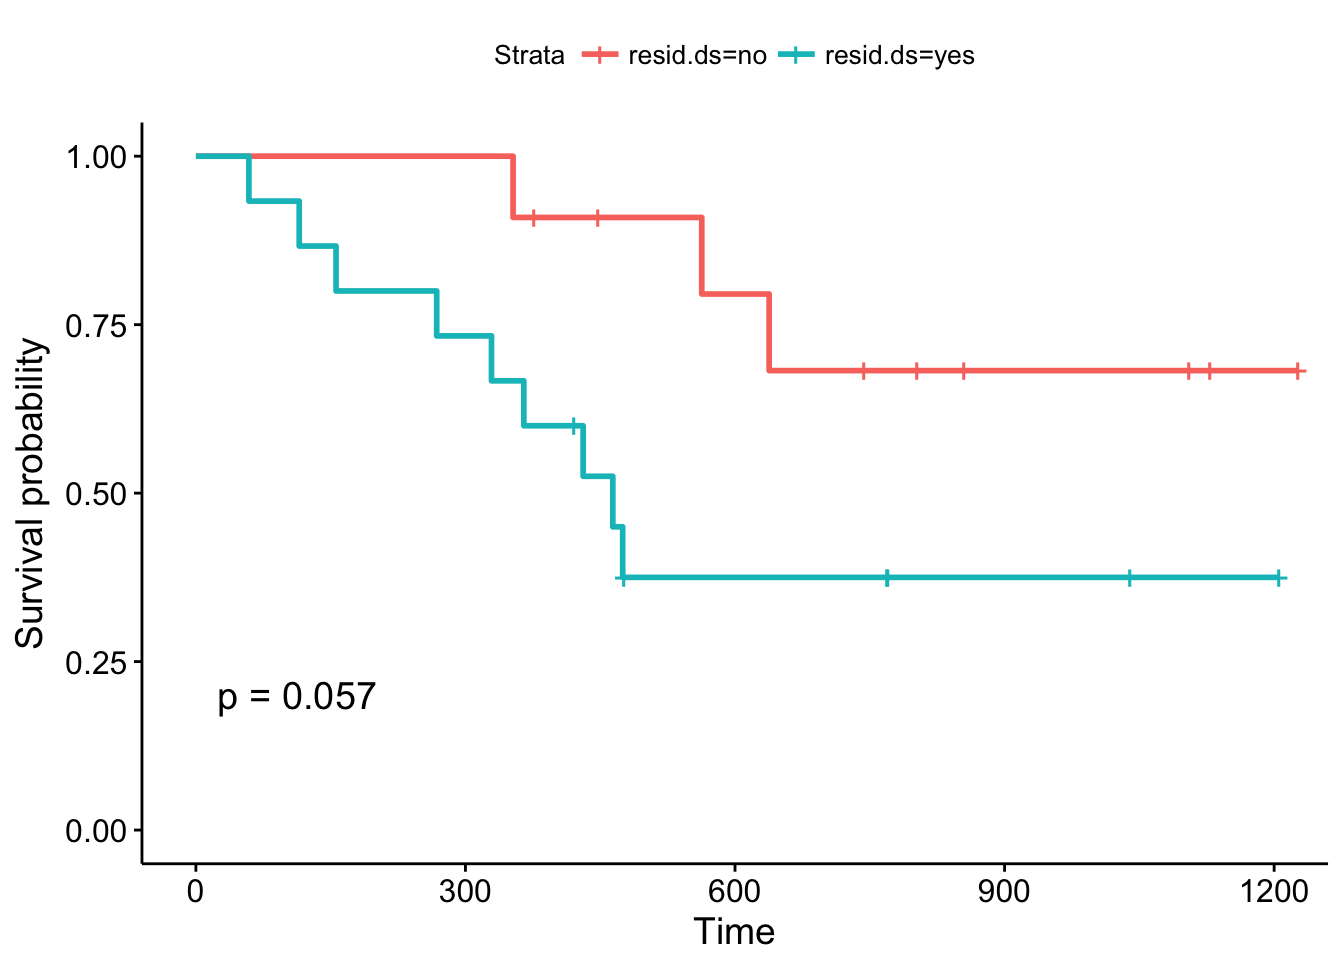
Les courbes de Kaplan‑Meier, stratifiées selon la présence de maladie résiduelle, diffèrent davantage : elles divergent tôt et le test du log‑rank est presque significatif. On pourrait avancer qu’une étude de suivi avec un effectif plus élevé permettrait de valider ces résultats, à savoir qu’une maladie résiduelle positive est associée à un pronostic significativement moins favorable qu’en son absence.
Existe‑t‑il une approche plus systématique pour examiner les différentes covariables ? Comme rappelé plus haut, les modèles de Cox à hasards proportionnels permettent d’inclure des covariables. Vous pouvez les estimer avec coxph et les visualiser avec ggforest. Ce type de graphique s’appelle un forest plot. Il affiche les hazard ratios (HR) issus du modèle pour chaque covariable incluse dans la formule de coxph. En bref, un HR > 1 indique une augmentation du risque de décès (au sens de h(t)) lorsque la condition est remplie ; un HR < 1 indique une diminution du risque. Examinons la sortie du modèle :
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)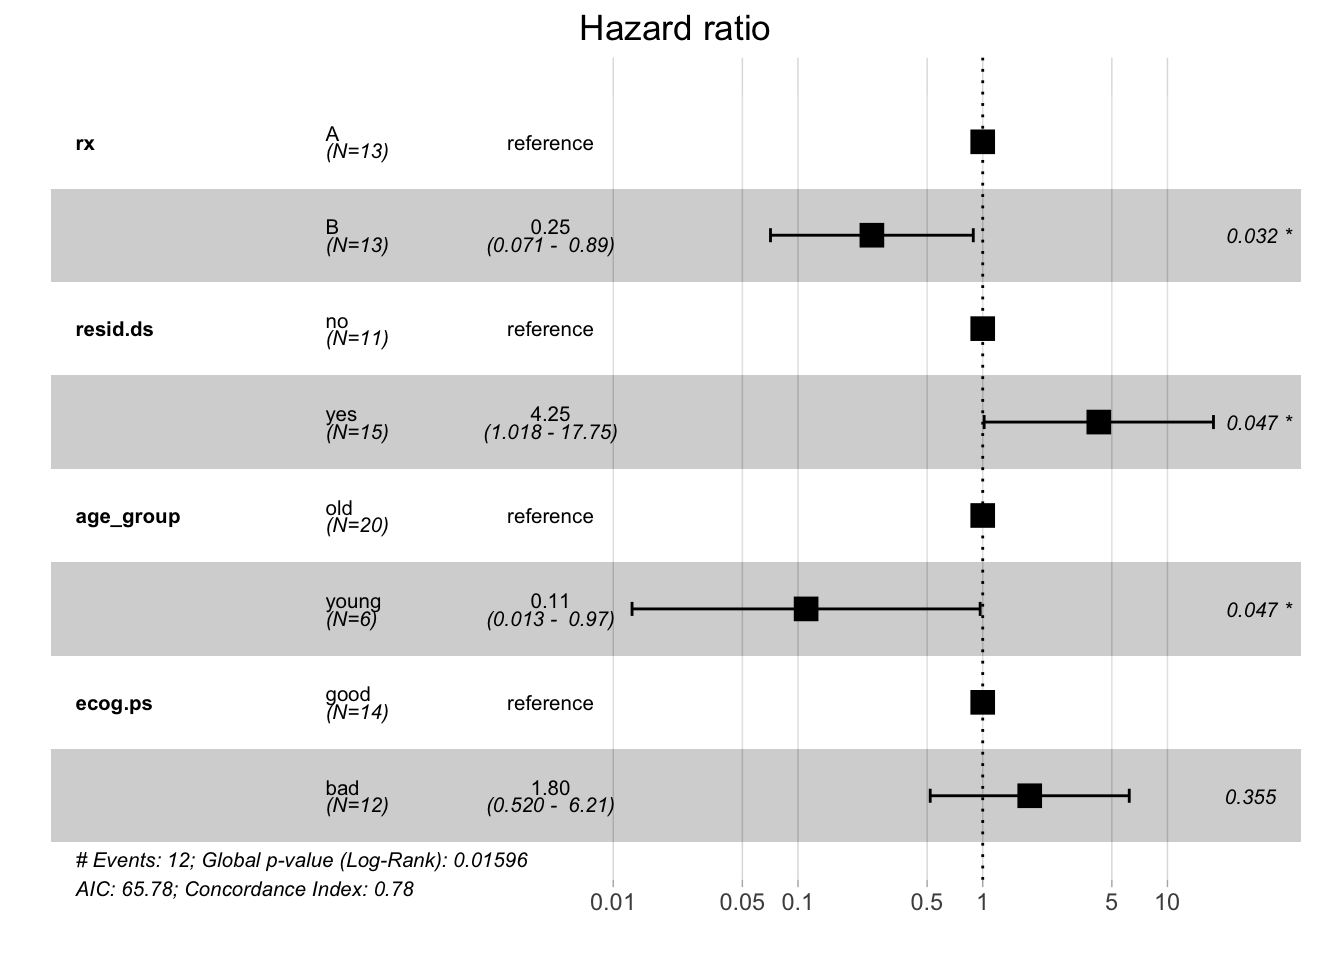
Chaque HR représente un risque relatif de décès comparant une modalité d’une variable binaire à l’autre. Par exemple, un hazard ratio de 0,25 pour les groupes de traitement indique que les patientes ayant reçu le traitement B présentent un risque de décès réduit par rapport à celles sous traitement A (utilisé comme référence pour calculer le HR). D’après le forest plot, l’intervalle de confiance à 95 % correspondant est de 0,071 à 0,89 et ce résultat est significatif.
Avec ce modèle, on observe que les variables groupe de traitement, maladie résiduelle et groupe d’âge influencent significativement le risque de décès des patientes. C’est assez différent de ce que montraient l’estimateur de Kaplan‑Meier et le test du log‑rank. Le premier estime une probabilité de survie, tandis que le second évalue un risque de décès et des hazard ratios. Votre analyse montre que ces méthodes peuvent aboutir à des niveaux de significativité différents.
Ces exemples montrent la simplicité avec laquelle on peut implémenter les concepts statistiques de l’analyse de survie en R. Dans cette introduction, vous avez appris à construire les modèles, à les visualiser et acquis des notions statistiques utiles pour interpréter vos résultats. Nous espérons que vous pourrez désormais utiliser ces techniques pour analyser vos propres jeux de données. Merci d’avoir lu ce tutoriel !
Découvrez notre tutoriel sur la régression linéaire en R.
Cours R
Cours
Cours
Cours