Kurs
R’ye Giriş
4 sa
3.1M

Veri madenciliği veya makine öğrenmesi teknikleri, biyomedikal araştırmaların erken aşamalarında büyük veri kümelerini analiz etmek için sıklıkla kullanılabilir; örneğin, yüksek verimli dizileme veri setlerinde aday genlerin veya öngörücü hastalık biyobelirteçlerinin belirlenmesine yardımcı olmak için. Ancak, klinik deneylerden elde edilen veriler genellikle oldukça farklı bir analiz yaklaşımı gerektiren “sağkalım verilerini” içerir.
Bu tür bir analizde, ölüm veya hastalığın nüksetmesi gibi belirli bir olaya kadar geçen süre ilgi konusudur ve iki (veya daha fazla) hasta grubu bu süre açısından karşılaştırılır. Bu tür bir veri setinden anlamlı sonuçlar elde etmek için üç temel kavram kullanılabilir ve bu eğitimin amacı, istatistiksel kavramları, bunların yorumunu ve ayrıca bu yöntemlerin gerçek dünya uygulamasını ve R’deki uygulanışını tanıtmaktır:
Bu eğitimde ayrıca R’de survival ve survminer paketlerini ve survival paketiyle birlikte gelen ovarian veri setini (Edmunson J.H. ve diğ., 1979) kullanacaksınız. Bu veri seti hakkında daha fazlasını eğitimin ilerleyen kısımlarında okuyacaksınız!
İpucu: şu survminer kopya kağıdına göz atın
Bu eğitimden sonra, şu tür soruları yanıtlamak için bu verilerden yararlanabileceksiniz: Hastalar, B rejimine kıyasla A tedavi rejiminden fayda görüyor mu? Hastaların yaşı ve kondisyonu sonucu anlamlı biçimde etkiliyor mu? Artık hastalık (rezidüel hastalık) sağkalım açısından prognostik bir biyobelirteç midir?
İstatistiklerin ayrıntılarına girmeden önce, bazı yararlı terimleri öğrenmek isteyebilirsiniz:
“Sansürleme” terimi eksik veriye karşılık gelir. Farklı türleri olmakla birlikte, bu noktada kendinizi sağkalım veri setlerinde en yaygın sansürleme türü olduğundan sağdan sansürlenmiş verilerle sınırlamak isteyebilirsiniz.
Bazı hastalar için belirli bir süre boyunca “olay” gerçekleşmeden takip edildiğini biliyor olabilirsiniz, ancak nihayetinde hayatta kalıp kalmadığını bilemeyebilirsiniz. Bu, hasta takibe gelmezse veya çalışmadan çekilirse söz konusu olabilir. Bu hastaya ait veriler, hastanın aradığınız “olayı” yaşamadığından emin olduğunuz son zaman noktasından sonra “sansürlenmiş” olacaktır. Olay, çalışmanızın önceden belirlenmiş sonlanımıdır; örneğin ölüm veya hastalığın nüksetmesi. Ayrıca, çalışma bitene kadar “olayı” yaşamayan tüm hastalar da o son zaman noktasında sansürlenecektir.
Özetle, verilerin sansürlenmesine yol açabilecek üç neden vardır.
Dolayısıyla, sansürlü gözlem sayısı her zaman n >= 0’dır. Bu örneklerin hepsi “sağdan sansürleme”ye örnektir ve ayrıca sabit veya rastgele tip I sansürleme ile tip II sansürleme olarak sınıflandırılabilir; ancak bu sınıflandırmalar çoğunlukla çalışma tasarımı açısından önemlidir ve bu giriş niteliğindeki eğitimde sizi meşgul etmeyecektir.
Aklınızda tutmanız gereken bir diğer nokta, tüm sansürleme türlerinin bilgi yokluğu durumları olduğudur ve sansürleme, çalışmanızın sonlanımını tanımlayan “olay” yüzünden asla meydana gelmez. Bu da ovarian veri setindeki sansürlü hastaların hiçbirinin ilgili hasta öldüğü için sansürlenmediği anlamına gelir.
Peki, zaman içinde hasta sağkalımını tanımlayan bir sağkalım fonksiyonu nasıl görünür?
Edward Kaplan ve Paul Meier tarafından bağımsız olarak tanımlanan ve 1958’de Journal of the American Statistical Association’da birlikte yayımlanan Kaplan-Meier tahmin edicisi, sağkalım fonksiyonunu tahmin etmemizi sağlayan parametrik olmayan bir istatistiktir.
Unutmayın, parametrik olmayan bir istatistik, altta yatan bir olasılık dağılımı varsayımına dayanmaz; bu da mantıklıdır çünkü sağkalım verileri çarpık bir dağılıma sahiptir.
Bu istatistik, bireysel bir hastanın belirli bir t zamanını aşarak hayatta kalma olasılığını verir. t = 0’da Kaplan-Meier tahmin edicisi 1’dir ve t sonsuza giderken tahmin edici 0’a yaklaşır. Kuramsal olarak, sonsuz büyüklükte bir veri kümesi ve saniye duyarlılığında ölçülen t ile, t ile sağkalım olasılığı arasındaki fonksiyon düzgündür. İleride, bunun pratikte nasıl göründüğünü göreceksiniz.
Ayrıca, belirli bir t zaman noktasını aşarak hayatta kalma olasılığının, t zaman noktasına kadar gözlenen sağkalım oranlarının çarpımına eşit olduğu varsayımına dayanır. Daha kesin olarak, S(t) #time t’deki sağkalım olasılığı S(t) = p.1 * p.2 * … * p.t ile verilir; burada p.1 ilk zaman noktasını aşan tüm hastaların oranı, p.2 ikinci zaman noktasını aşan hastaların oranı vb. olup t zaman noktasına kadar devam eder.
Şuna dikkat etmek önemlidir: p.2’den başlayarak p.t’ye kadar, her bir sonraki zaman noktası için oranları hesaplarken yalnızca bir önceki zaman noktasını aşarak hayatta kalan hastaları hesaba katarsınız; dolayısıyla p.2, p.3, …, p.t önceki oranlara koşullu oranlardır.
Uygulamada, öncelikle sağkalım sürelerini artan süreye göre sıralamak istersiniz. Buna sansürlü değerler de dahildir. Daha sonra yukarıda açıklandığı gibi oranları hesaplar ve S(t)’yi türetmek için çarparsınız. Sansürlü hastalar, sansürleme zaman noktasından sonra dışlanır; bu nedenle sağ kalan hasta oranını etkilemezler. Yöntem hakkında ayrıntılı bilgi için (Swinscow ve Campbell, 2002)’ye bakın.
Son olarak, iki grubun sağkalım eğrilerini karşılaştırmak için log-rank testini kullanabilirsiniz. Log-rank testi, iki popülasyonun sağkalım eğrilerinin farklı olmadığı yönündeki sıfır hipotezini test eden bir istatistiksel hipotez testidir. p-değeri türetmek için belirli bir olasılık dağılımı, yani ki-kare dağılımı kullanılır. Kısaca, p-değerleri istatistiksel anlamlılığı nicelleştirmek için kullanılır. p < 0.05 olan bir sonuç genellikle anlamlı kabul edilir. Bizim durumumuzda, p < 0.05, iki tedavi grubunun sağkalım açısından anlamlı biçimde farklı olduğunu gösterecektir.
Sağkalım analizleri bağlamında bir diğer yararlı fonksiyon tehlike fonksiyonudur, h(t). Bu fonksiyon, bir olayın gerçekleşme olasılığını ya da tehlikesini h (bu durumda yine ölüm riski) konu kişinin belirli t zaman noktasına kadar hayatta kaldığı varsayımı altında tanımlar. Anlık ölüm riskini ölçtüğü için Kaplan-Meier tahmin edicisine kıyasla görselleştirmesi biraz daha zordur. Bununla birlikte, hasta gruplarının sağkalımını karşılaştırırken kovaryatları dikkate alabilmek için tehlike fonksiyonuna ihtiyaç duyarsınız. Regresyon analizinde açıklayıcı veya bağımsız değişkenler olarak da adlandırılan kovaryatlar, bir sonucun öngörücüsü olabilecek veya değişkenler arası etkileşimleri hesaba katmak için ayarlamak isteyebileceğiniz değişkenlerdir.
Log-rank testi, bir hasta popülasyonunu tedavi alt gruplarına ayırarak elde edilen iki Kaplan-Meier sağkalım eğrisini karşılaştırırken, Cox orantılı tehlike modelleri söz konusu hasta popülasyonlarının altta yatan temel tehlike fonksiyonlarından ve keyfi sayıda ikileştirilmiş kovaryattan türetilir. Yine, altta yatan bir olasılık dağılımı varsaymaz, ancak karşılaştırdığınız hasta gruplarının tehlikelerinin zaman içinde sabit olduğunu varsayar. Bu nedenle “orantılı tehlikeler modeli” olarak adlandırılır. Birazdan, bu kuramsal hususları örnekleyen bir örnek göreceksiniz.
Şimdi, ovarian veri setini analiz etmeyi deneyelim!
Bu kavramlarla artık gerçek bir veri setini analiz etmeye ve yukarıdaki sorulardan bazılarını yanıtlamaya başlayabilirsiniz. Analizler için gerekli iki paketi ve veri çerçevelerini yönetmek için kullanışlı işlevler sunan dplyr paketini yükleyerek başlayalım.
# Load required packages
library(survival)
library(survminer)
library(dplyr)İpucu: Çalışma alanınızda eksik olabilecek paketleri kurmak için install.packages() kullanmayı unutmayın!
Bir sonraki adım veri setini yüklemek ve yapısını incelemektir. Eğitimin başında okuduğunuz gibi, ovarian veri setiyle çalışacaksınız. Bu veri seti, over kanseri hastalarından oluşan bir kohortu ve ilgili klinik bilgileri içerir; buna hastaların ya öldükleri ya da takibi bırakana kadar izlendiği süre (futime), hastaların sansürlenip sansürlenmediği (fustat), hasta yaşı, tedavi grubu ataması, artık (rezidüel) hastalık varlığı ve performans durumu dahildir.
Gördüğünüz üzere, bazı değişken adları biraz anlaşılmaz; yardım sayfasına da bakmak isteyebilirsiniz.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
futime sütunu sağkalım sürelerini tutar. Bu, yanıt değişkenidir. Öte yandan fustat, bireysel bir hastanın sağkalım süresinin sansürlü olup olmadığını belirtir. Görünen o ki bu çalışmadaki 26 hastaya iki tedavi rejiminden (rx) biri uygulanmış ve ilgili hekimler bir noktada tümör gerilemesini (resid.ds) ve hastaların performansını (standartlaştırılmış ECOG kriterlerine göre; ecog.ps) değerlendirmiştir.
Ayrıca, hastaların yaşı hakkında bilgi edinirsiniz ve bunu sonunda bir öngörücü değişken olarak dahil etmek isterseniz, sürekli değerleri ikili değerlere dönüştürmeniz gerekir. Peki bunun için hangi eşik değeri seçmelisiniz? Öncelikle yaş değerlerinin genel dağılımına bakalım:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 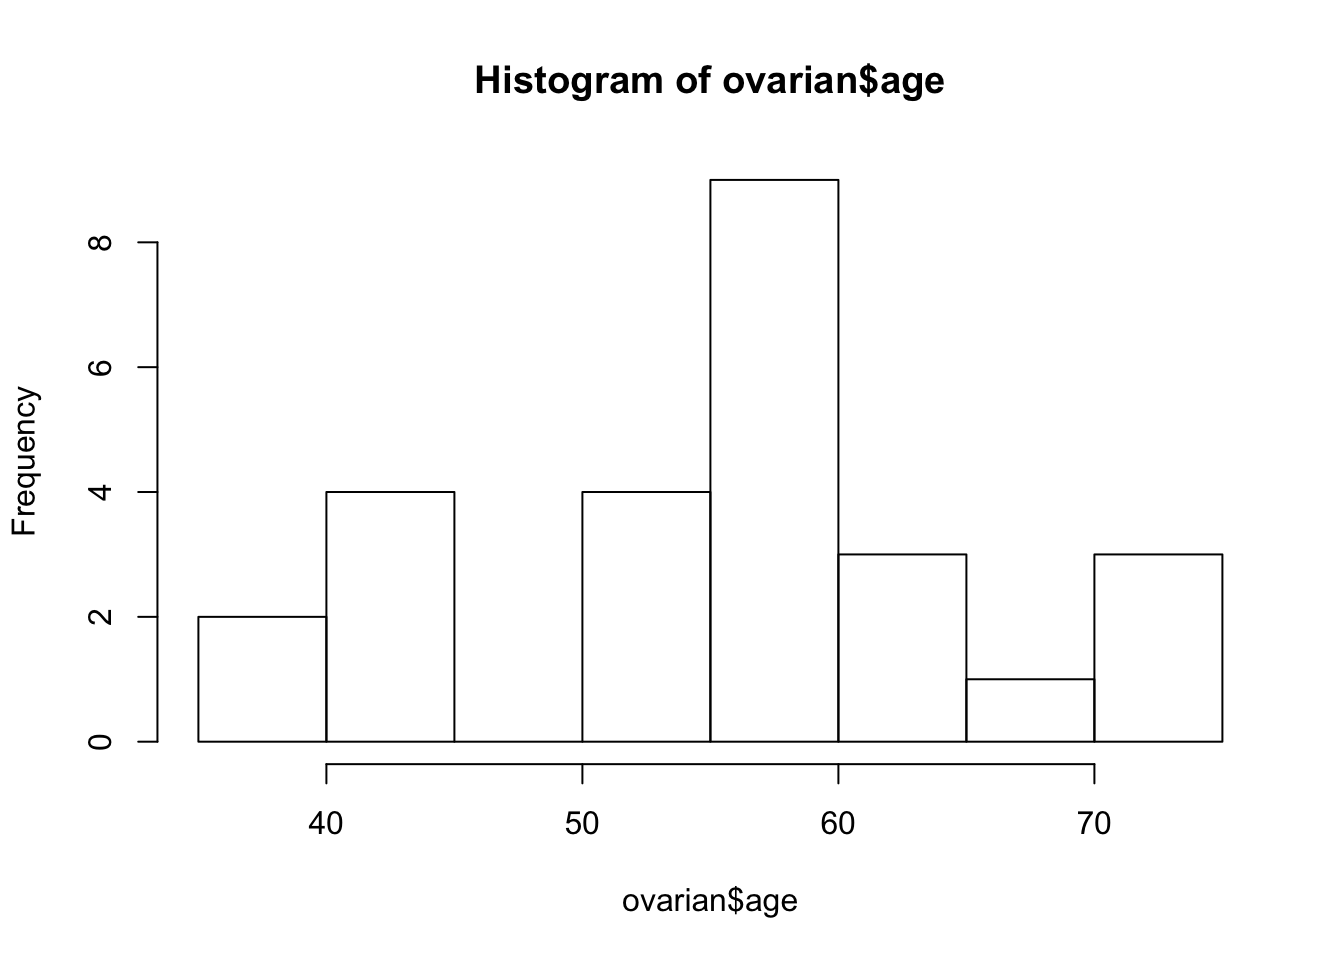
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
Açıkça iki modlu görünen dağılım, 50 yaş eşik değerini öneriyor. mutate işlevini kullanarak veri çerçevesine daha sonra işinize yarayacak ek bir age_group sütunu ekleyebilirsiniz. Ayrıca, gelecekteki kovaryatları faktörlere dönüştürmelisiniz.
Artık bir sağkalım nesnesi oluşturmaya hazırsınız. Bu, survfit işlevinin yorumlayabildiği, futime ve fustat sütunlarının derlenmiş bir sürümüdür. Sağkalım sürelerinin arkasındaki bir + işareti sansürlü veri noktalarını gösterir.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Bir sonraki adım Kaplan-Meier eğrilerini uydurmaktır. Bunu, surv_object’i survfit işlevine vererek kolayca yapabilirsiniz. Ayrıca, hastaların atandığı tedavi rejimine (rx) göre eğriyi tabakalandırabilirsiniz. Ortaya çıkan fit1 nesnesinin bir summary() çıktısı, diğerlerinin yanı sıra, sağkalım sürelerini, her zaman noktasındaki sağ kalan hasta oranını (yukarıdaki p.1, p.2, ...’niz) ve tedavi gruplarını gösterir.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
İlgili sağkalım eğrisini, sağkalım nesnesini ggsurvplot işlevine vererek inceleyebilirsiniz. pval = TRUE bağımsız değişkeni çok kullanışlıdır; çünkü log-rank testinin p-değerini de çizer!
ggsurvplot(fit1, data = ovarian, pval = TRUE)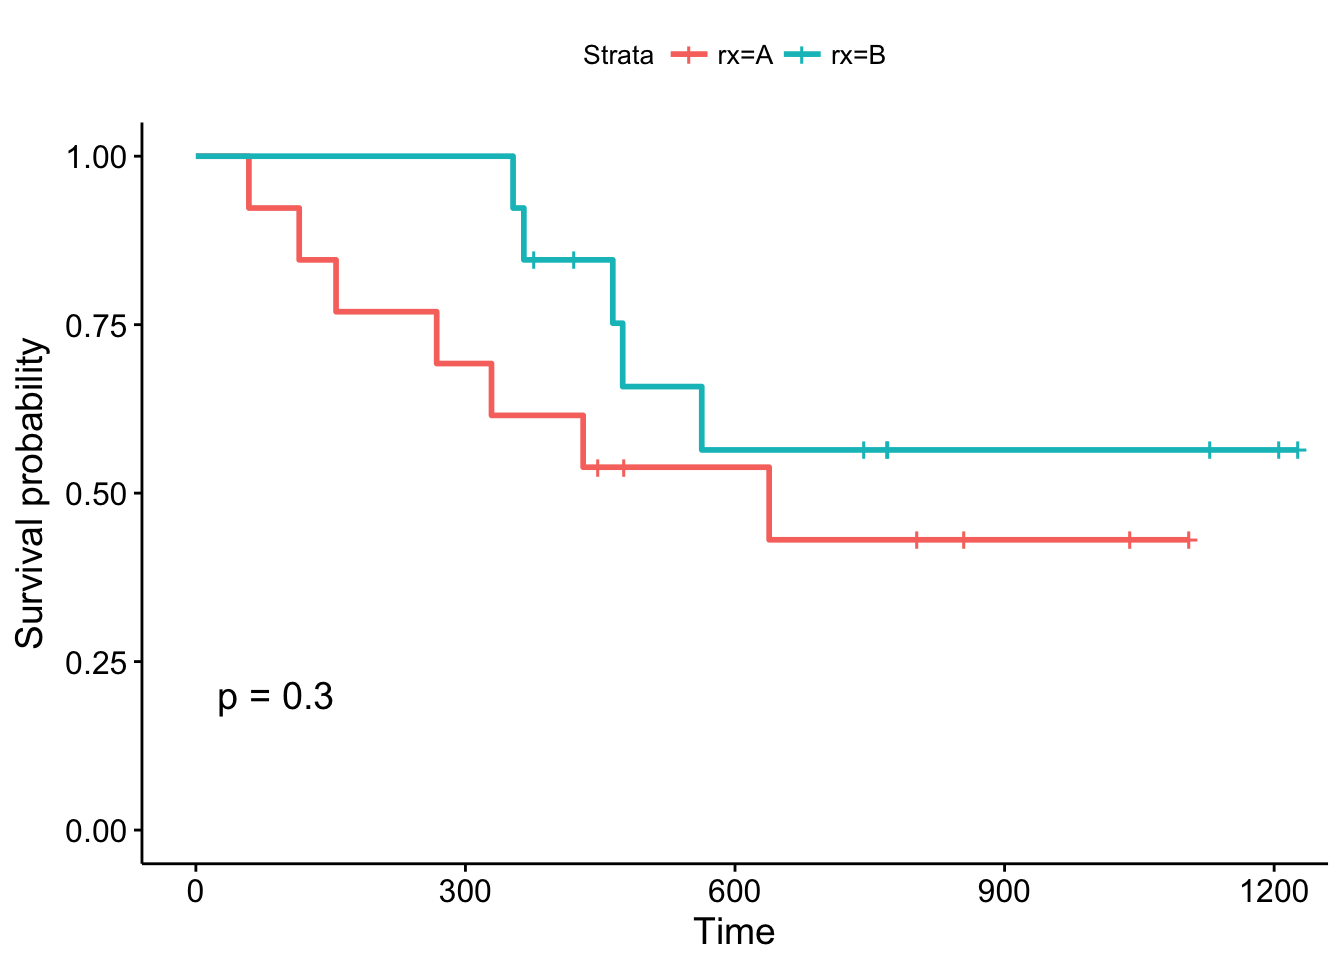
Gelenek gereği, düşey çizgiler sansürlü verileri, bunların x değerleri ise sansürlemenin gerçekleştiği zamanı gösterir.
0,3’lük log-rank p-değeri, istatistiksel anlamlılık için p < 0.05 eşiğini dikkate alırsanız, anlamlı olmayan bir sonuca işaret eder. Bu çalışmada incelenen tedavilerin hiçbiri anlamlı şekilde üstün değildir; ancak tedavi B alan hastalar takiplerin ilk ayında daha iyi görünmektedir. Diğer değişkenler ne durumda?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)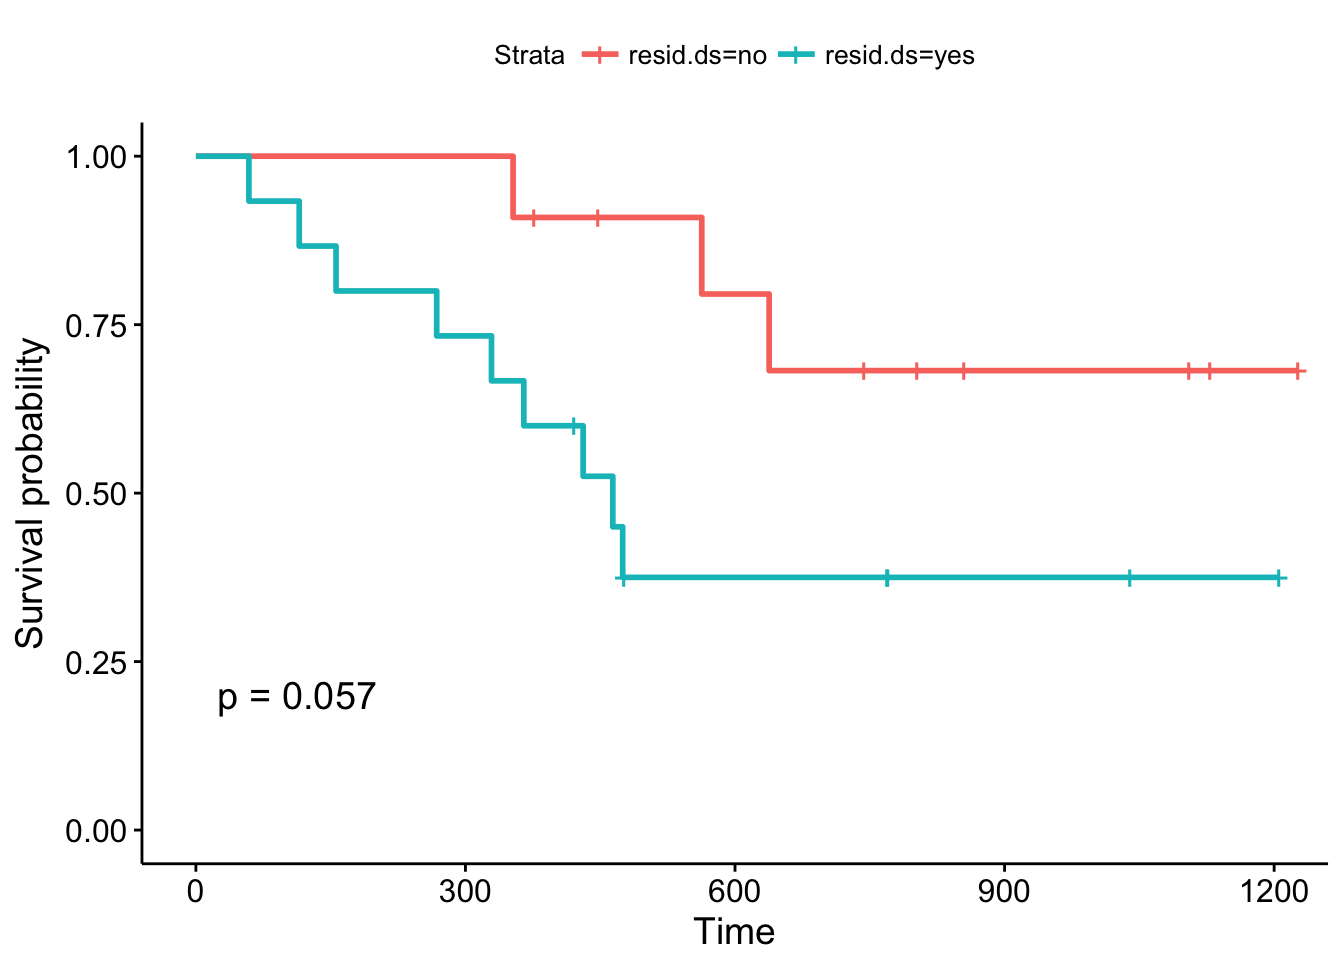
Rezidüel hastalık durumuna göre tabakalandırılmış Kaplan-Meier çizimleri biraz farklı görünüyor: Eğriler erken dönemde ayrışıyor ve log-rank testi neredeyse anlamlı. Daha büyük örneklem büyüklüğüne sahip bir takip çalışmasının bu sonuçları doğrulayabileceğini; yani, pozitif rezidüel hastalık durumundaki hastaların, rezidüel hastalığı olmayanlara kıyasla anlamlı biçimde daha kötü bir prognoza sahip olduğunu savunabilirsiniz.
Peki farklı kovaryatlara daha sistematik biçimde bakmanın bir yolu var mı? Önceki bölümlerden hatırlayacağınız üzere, Cox orantılı tehlike modelleri kovaryatları dahil etmenize olanak tanır. coxph işlevini kullanarak Cox orantılı tehlike modelleri kurabilir ve ggforest ile görselleştirebilirsiniz. Bu tür grafiklere orman grafiği (forest plot) denir. coxph formülüne dahil ettiğimiz tüm kovaryatlar için modelden türetilen tehlike oranlarını (HR) gösterir. Kısaca, HR > 1, belirli bir koşul sağlandığında ölüm riskinin (h(t) tanımına göre) arttığını; HR < 1 ise azaldığını gösterir. Model çıktısına bakalım:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)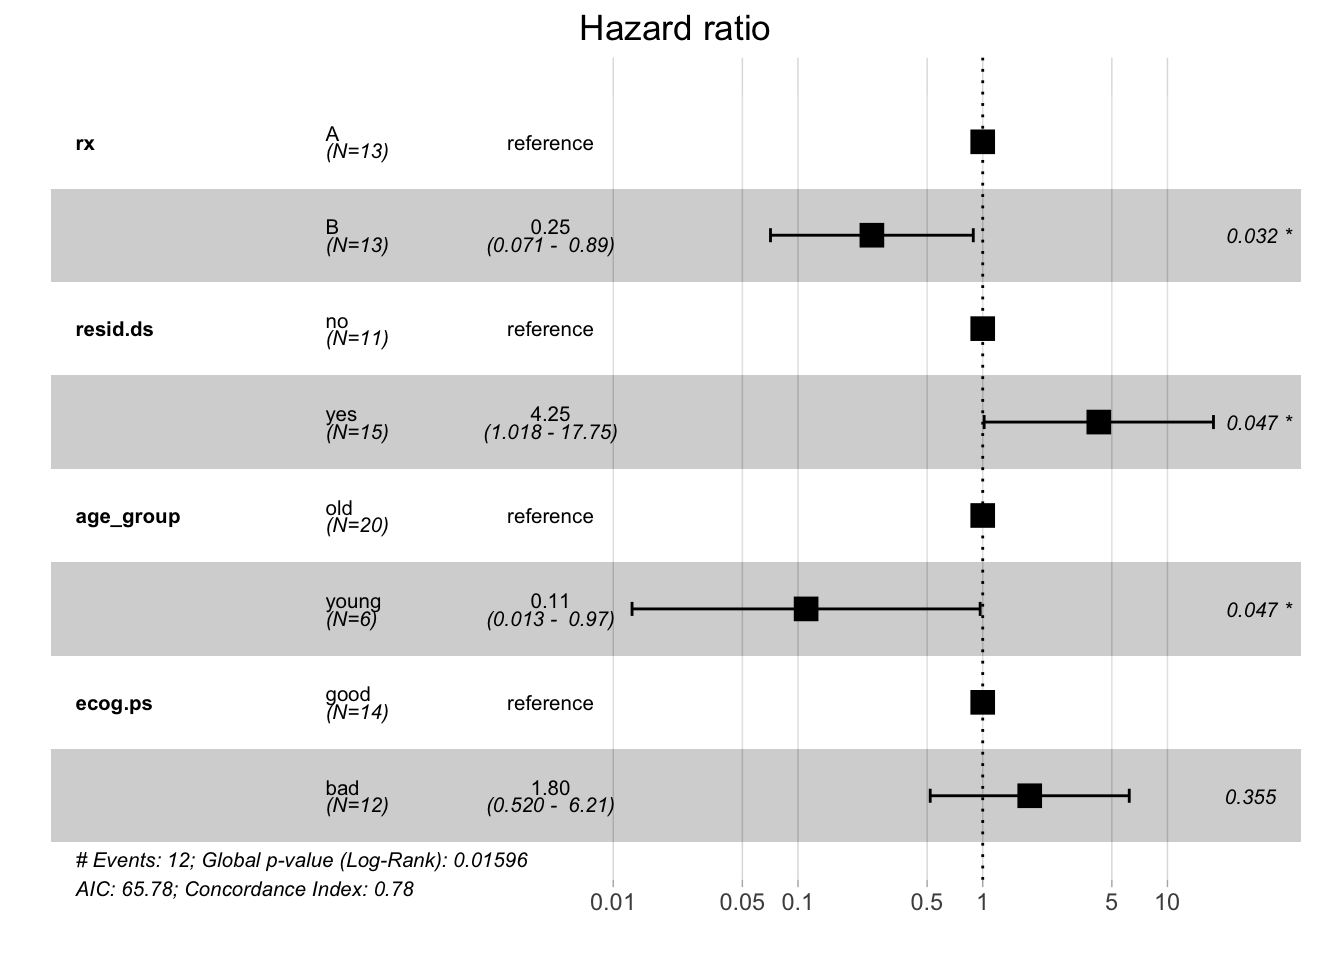
Her HR, ikili bir özelliğin bir örneğini diğerine kıyasla göreli ölüm riskini temsil eder. Örneğin, tedavi grupları için 0,25’lik bir tehlike oranı, tedavi B alan hastaların, tehlike oranının hesaplanmasında referans olarak kullanılan tedavi A’yı alan hastalara kıyasla daha düşük ölüm riskine sahip olduğunu gösterir. Orman grafiğinin de gösterdiği üzere, ilgili %95 güven aralığı 0,071 - 0,89’dur ve bu sonuç anlamlıdır.
Bu modeli kullanarak, bu çalışmada tedavi grubu, rezidüel hastalık durumu ve yaş grubu değişkenlerinin hastaların ölüm riskini anlamlı biçimde etkilediğini görebilirsiniz. Bu, Kaplan-Meier tahmin edicisi ve log-rank testiyle gördüklerinizden oldukça farklıdır. İlki sağkalım olasılığını tahmin ederken, ikincisi ölüm riskini ve ilgili tehlike oranlarını hesaplar. Analiziniz, bu yöntemlerle elde edilen sonuçların anlamlılık açısından farklılaşabileceğini göstermektedir.
Yukarıdaki örnekler, sağkalım analizinin istatistiksel kavramlarının R’de ne kadar kolay uygulanabildiğini gösteriyor. Bu girişte, ilgili modelleri nasıl kuracağınızı, nasıl görselleştireceğinizi ve analiz sonuçlarını anlamanıza yardımcı olacak bazı istatistiksel arka plan bilgilerini öğrendiniz. Umarız artık bu teknikleri kendi veri setlerinizi analiz etmek için kullanmaya başlayabilirsiniz. Bu eğitimi okuduğunuz için teşekkürler!
R'de Doğrusal Regresyon Eğitimimize göz atın.
R kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




