Kurs
Einführung in R
4 Std.
3.1M

Data Mining bzw. Machine-Learning-Verfahren lassen sich in frühen Phasen der biomedizinischen Forschung oft einsetzen, um große Datensätze zu analysieren — zum Beispiel, um Kandidatengene oder prädiktive Krankheitsbiomarker in High-Throughput-Sequenzierungen zu identifizieren. Daten aus klinischen Studien enthalten jedoch häufig sogenannte „Survival-Daten“, die eine ganz andere Analyse erfordern.
Hier interessiert die Zeit bis zu einem bestimmten Ereignis, etwa Tod oder Krankheitsrückfall, und es werden zwei (oder mehr) Patientengruppen hinsichtlich dieser Zeit verglichen. Drei zentrale Konzepte helfen, aus solchen Datensätzen aussagekräftige Ergebnisse zu gewinnen. Dieses Tutorial stellt die statistischen Konzepte, ihre Interpretation sowie eine praktische Anwendung mitsamt Umsetzung in R vor:
In diesem Tutorial verwendest du außerdem die R-Pakete survival und survminer sowie den Datensatz ovarian (Edmunson J.H. et al., 1979), der mit dem Paket survival ausgeliefert wird. Mehr zu diesem Datensatz liest du weiter unten!
Tipp: Schau dir dieses survminer Cheatsheet an.
Nach diesem Tutorial kannst du Fragen wie diese fundiert beantworten: Profitieren Patientinnen vom Therapieregime A im Vergleich zu Regime B? Beeinflussen Alter und Fitness der Patientinnen das Ergebnis signifikant? Ist eine Resttumorlast ein prognostischer Biomarker in Bezug auf das Überleben?
Bevor wir in die Statistik einsteigen, lohnt sich ein Blick auf einige wichtige Begriffe:
„Zensierung“ bezeichnet unvollständige Daten. Es gibt verschiedene Typen, für den Einstieg konzentrierst du dich am besten auf rechtszensierte Daten, denn sie sind in Survival-Datensätzen am häufigsten.
Bei manchen Patientinnen weißt du, dass sie bis zu einem bestimmten Zeitpunkt beobachtet wurden, ohne dass das „Ereignis“ eingetreten ist — aber nicht, ob sie letztlich überlebt haben oder nicht. Das passiert zum Beispiel, wenn jemand aus der Nachbeobachtung verloren geht oder die Studie verlässt. Die Daten dieser Person werden nach dem letzten Zeitpunkt, zu dem sicher kein Ereignis eingetreten ist, „zensiert“. Ein Ereignis ist das vordefinierte Studien-Ende, z. B. Tod oder Rezidiv. Auch alle Patientinnen, die bis Studienende kein Ereignis haben, werden zu diesem letzten Zeitpunkt zensiert.
Im Wesentlichen gibt es drei Gründe, warum Daten zensiert sein können.
Die Zahl der zensierten Beobachtungen ist also immer n >= 0. Alle Beispiele sind Fälle von „Rechtszensierung“. Man kann weiter in feste bzw. zufällige Zensierung vom Typ I und Typ II unterscheiden; diese Einteilung ist vor allem für das Studiendesign relevant und spielt in diesem Einstieg keine Rolle.
Wichtig ist: Jede Form der Zensierung bedeutet fehlende Information und wird nie durch das „Ereignis“ verursacht, das den Studienendpunkt definiert. Das heißt auch, keine der zensierten Patientinnen im ovarian-Datensatz wurde zensiert, weil sie verstorben ist.
Wie sieht eine Überlebensfunktion aus, die das Überleben von Patientinnen über die Zeit beschreibt?
Der Kaplan-Meier-Schätzer, unabhängig von Edward Kaplan und Paul Meier beschrieben und 1958 gemeinsam im Journal of the American Statistical Association veröffentlicht, ist eine nichtparametrische Statistik zur Schätzung der Überlebensfunktion.
Zur Erinnerung: Nichtparametrische Verfahren setzen keine bestimmte Wahrscheinlichkeitsverteilung voraus — sinnvoll, da Survival-Daten meist schief verteilt sind.
Die Statistik liefert die Wahrscheinlichkeit, dass eine einzelne Patientin einen bestimmten Zeitpunkt t überlebt. Bei t = 0 ist der Kaplan-Meier-Schätzer 1, für t gegen unendlich nähert er sich 0. In der Theorie, mit unendlich großem Datensatz und Sekundengenauigkeit, wäre die Funktion über t glatt. Gleich siehst du, wie das in der Praxis aussieht.
Die Methode basiert darauf, dass die Wahrscheinlichkeit, einen Zeitpunkt t zu überleben, dem Produkt der beobachteten Überlebensraten bis t entspricht. Präziser: S(t) #die Überlebenswahrscheinlichkeit zum Zeitpunkt t ist S(t) = p.1 * p.2 * … * p.t, wobei p.1 der Anteil aller Patientinnen ist, die über den ersten Zeitpunkt hinaus überleben, p.2 der Anteil, der den zweiten Zeitpunkt überlebt, usw., bis t.
Wichtig dabei: Ab p.2 bis p.t berücksichtigst du jeweils nur die Patientinnen, die den vorherigen Zeitpunkt überlebt haben; p.2, p.3, …, p.t sind also bedingte Anteile.
In der Praxis sortierst du die Überlebenszeiten zunächst aufsteigend — inklusive der zensierten Werte. Dann berechnest du die Anteile wie oben beschrieben und multiplizierst sie zu S(t). Zensierte Personen werden nach dem Zensurzeitpunkt nicht mehr berücksichtigt und beeinflussen die Anteile nicht. Ausführliche Infos zur Methode findest du in (Swinscow und Campbell, 2002).
Zum Vergleich von Überlebenskurven zweier Gruppen nutzt du den Log-Rank-Test. Er prüft die Nullhypothese, dass sich die Überlebenskurven zweier Populationen nicht unterscheiden. Über die Chi-Quadrat-Verteilung erhältst du einen p-Wert. P-Werte quantifizieren die statistische Signifikanz; üblich ist p < 0.05 als signifikant. In unserem Fall würde p < 0.05 bedeuten, dass sich die beiden Behandlungsgruppen hinsichtlich des Überlebens signifikant unterscheiden.
Eine weitere wichtige Größe in Survival-Analysen ist die Hazardfunktion h(t). Sie beschreibt die Wahrscheinlichkeit eines Ereignisses bzw. die Hazard h (hier: Sterberisiko) unter der Bedingung, dass die Person den Zeitpunkt t bis dahin überlebt hat. Sie ist schwerer zu veranschaulichen als der Kaplan-Meier-Schätzer, da sie das momentane Risiko misst. Um Kovariablen beim Vergleich von Gruppen zu berücksichtigen, brauchst du die Hazardfunktion. Kovariablen (in der Regression auch erklärende bzw. unabhängige Variablen) sind potenziell prädiktiv für ein Outcome oder dienen der Adjustierung für Interaktionen.
Während der Log-Rank-Test zwei Kaplan-Meier-Kurven vergleicht (z. B. durch Aufteilen in Behandlungsgruppen), basieren Cox-Proportional-Hazards-Modelle auf den zugrunde liegenden Baseline-Hazards der betrachteten Populationen und beliebig vielen dichotomisierten Kovariablen. Auch hier wird keine Verteilung angenommen, jedoch die Proportionalität der Hazards über die Zeit. Daher der Name „Proportional-Hazards-Modell“. Gleich sehen wir ein Beispiel, das die Theorie greifbar macht.
Jetzt analysieren wir den ovarian-Datensatz!
Mit diesen Konzepten kannst du nun einen realen Datensatz analysieren und die oben skizzierten Fragen angehen. Lade zunächst die beiden benötigten Pakete sowie dplyr mit praktischen Funktionen zur Datenrahmen-Verarbeitung.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Tipp: Vergiss nicht, fehlende Pakete mit install.packages() zu installieren!
Als Nächstes lädst du den Datensatz und wirfst einen Blick auf seine Struktur. Wie eingangs erwähnt, arbeitest du mit dem ovarian-Datensatz. Er umfasst eine Kohorte von Patientinnen mit Ovarialkarzinom samt klinischer Informationen, darunter die Nachbeobachtungszeit bis Tod oder Verlust der Nachbeobachtung (futime), ob eine Beobachtung zensiert ist (fustat), Alter, Zuordnung zur Behandlungsgruppe, Resttumorstatus und Performance Status.
Einige Variablennamen sind etwas kryptisch — ein Blick in die Hilfeseite lohnt sich.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
Die Spalte futime enthält die Überlebenszeiten — das ist die Zielvariable. fustat zeigt, ob die jeweilige Überlebenszeit zensiert ist. Offenbar erhielten die 26 Patientinnen eines von zwei Therapieregimen (rx); zudem beurteilte die Ärztin/der Arzt die Tumorregression (resid.ds) und die Performance der Patientinnen (nach ECOG-Kriterien; ecog.ps).
Außerdem liegt das Alter der Patientinnen vor. Willst du es als prädiktive Variable nutzen, musst du die kontinuierlichen Werte dichotomisieren. Aber welcher Cutoff bietet sich an? Schauen wir uns die Altersverteilung an:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 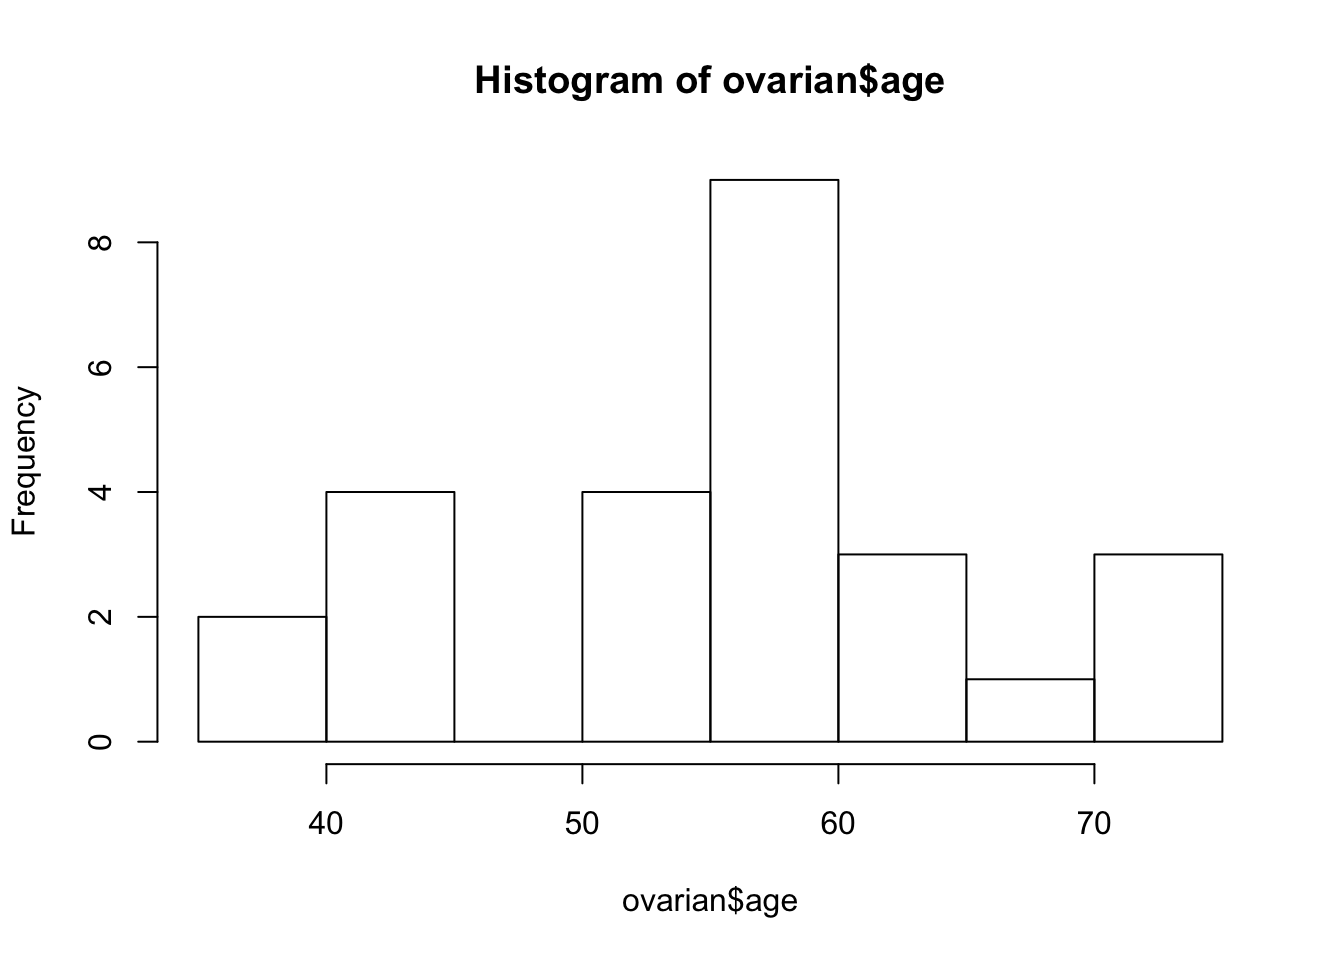
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
Die klar bimodale Verteilung spricht für einen Cutoff bei 50 Jahren. Mit mutate fügst du eine zusätzliche Spalte age_group hinzu, die gleich nützlich wird. Außerdem solltest du die künftigen Kovariablen in Faktoren umwandeln.
Jetzt erstellst du ein Survival-Objekt. Es bündelt im Wesentlichen die Spalten futime und fustat in einem Format, das die Funktion survfit versteht. Ein + hinter Zeiten kennzeichnet zensierte Beobachtungen.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Im nächsten Schritt passt du die Kaplan-Meier-Kurven an. Übergib dazu das surv_object an survfit. Du kannst die Kurven auch nach dem Therapieregime rx stratifizieren. Ein summary() des resultierenden Objekts fit1 zeigt unter anderem die Überlebenszeiten, die Überlebensanteile an jedem Zeitpunkt — also deine p.1, p.2, ... von oben — und die Behandlungsgruppen.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Die zugehörige Überlebenskurve kannst du mit ggsurvplot visualisieren. Das Argument pval = TRUE ist praktisch, da es den p-Wert des Log-Rank-Tests direkt einblendet!
ggsurvplot(fit1, data = ovarian, pval = TRUE)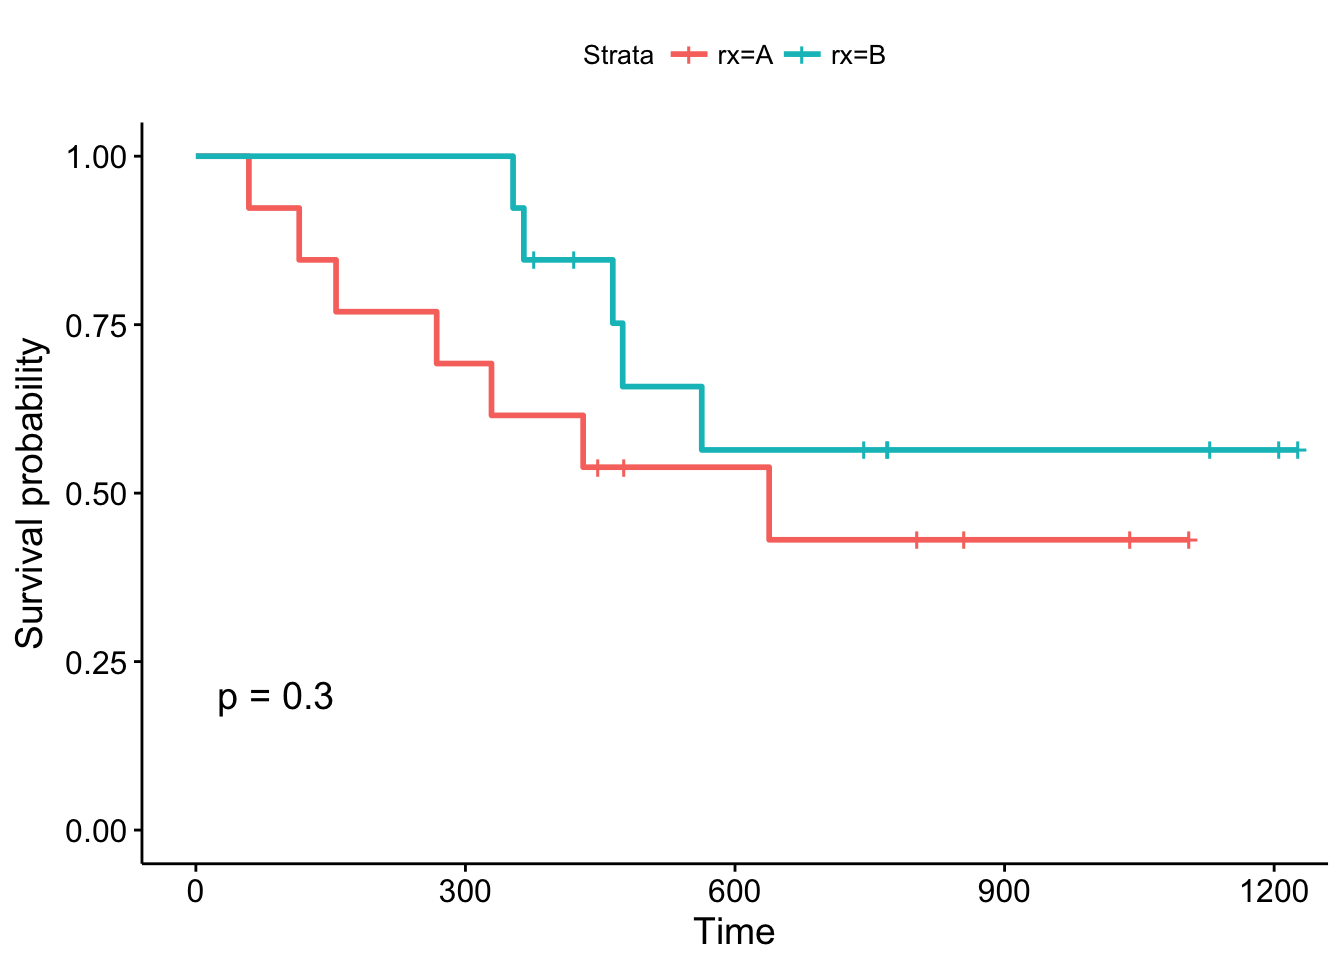
Konventionell markieren vertikale Striche zensierte Daten; ihre x-Werte geben den Zeitpunkt der Zensierung an.
Der Log-Rank-p-Wert von 0,3 ist nicht signifikant, wenn du p < 0.05 als Schwelle nimmst. In dieser Studie war keine der Behandlungen signifikant überlegen, auch wenn Patientinnen unter Therapie B im ersten Monat etwas besser abschneiden. Wie sieht es mit den anderen Variablen aus?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)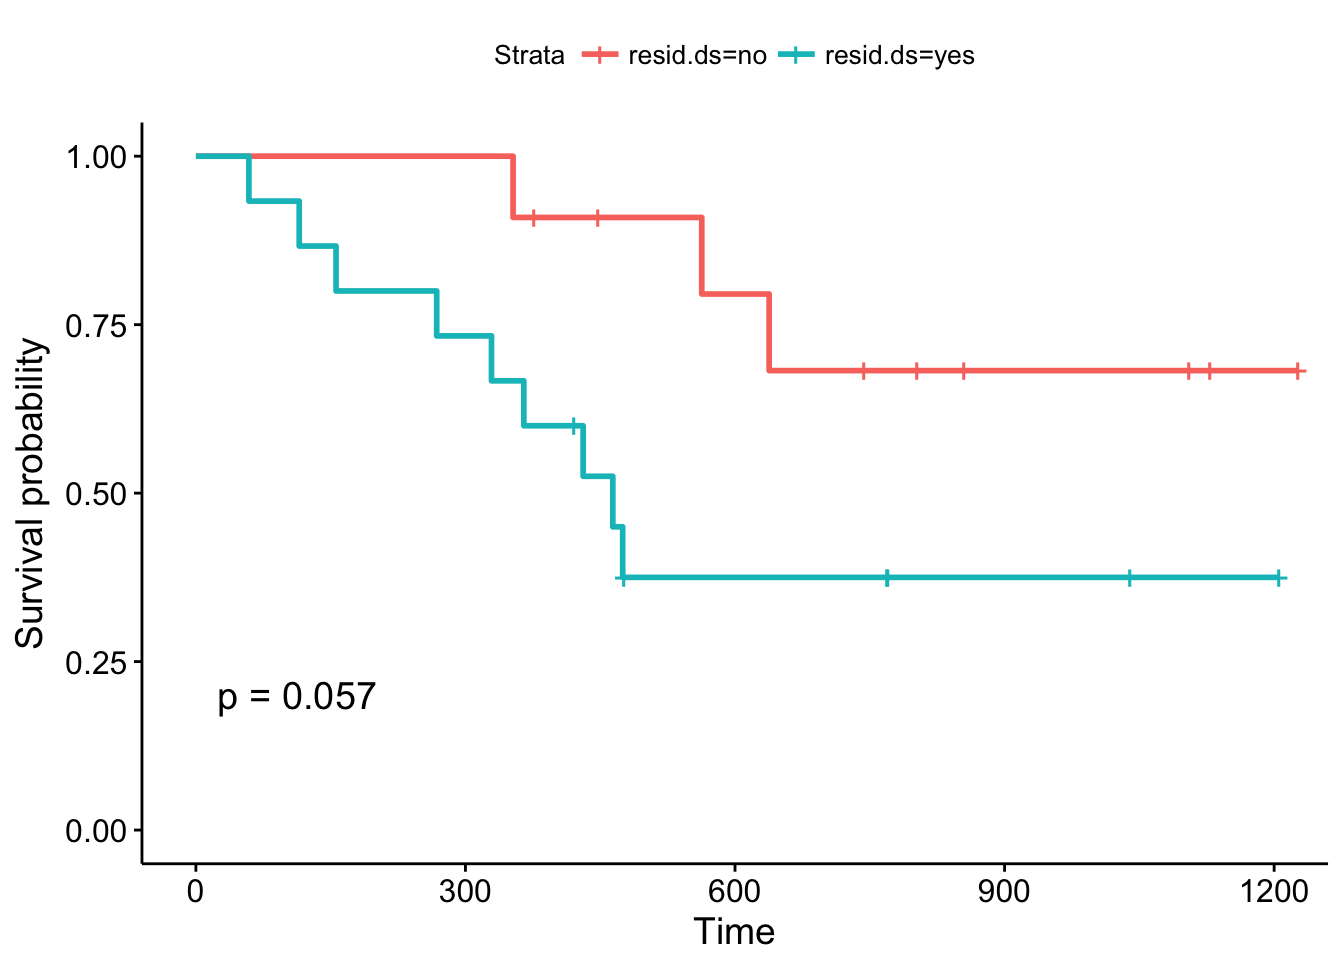
Die nach Resttumorstatus stratifizierten Kaplan-Meier-Kurven sehen anders aus: Die Kurven trennen sich früh, und der Log-Rank-Test ist beinahe signifikant. Hier ließe sich argumentieren, dass eine Folgestudie mit größerer Stichprobe diese Ergebnisse bestätigen könnte — nämlich, dass Patientinnen mit positivem Resttumorstatus eine deutlich schlechtere Prognose haben.
Gibt es einen systematischeren Ansatz für die Kovariablen? Wie oben erwähnt, erlauben Cox-Proportional-Hazards-Modelle die Einbeziehung von Kovariablen. Du erstellst sie mit coxph und visualisierst sie mit ggforest. Diese Darstellung heißt Forest Plot. Sie zeigt die sogenannten Hazard Ratios (HR), die das Modell für alle in der coxph-Formel enthaltenen Kovariablen liefert. Kurz: Eine HR > 1 bedeutet erhöhtes Sterberisiko (gemäß h(t)) unter einer bestimmten Bedingung, eine HR < 1 ein verringertes Risiko. Schauen wir uns die Ausgabe an:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)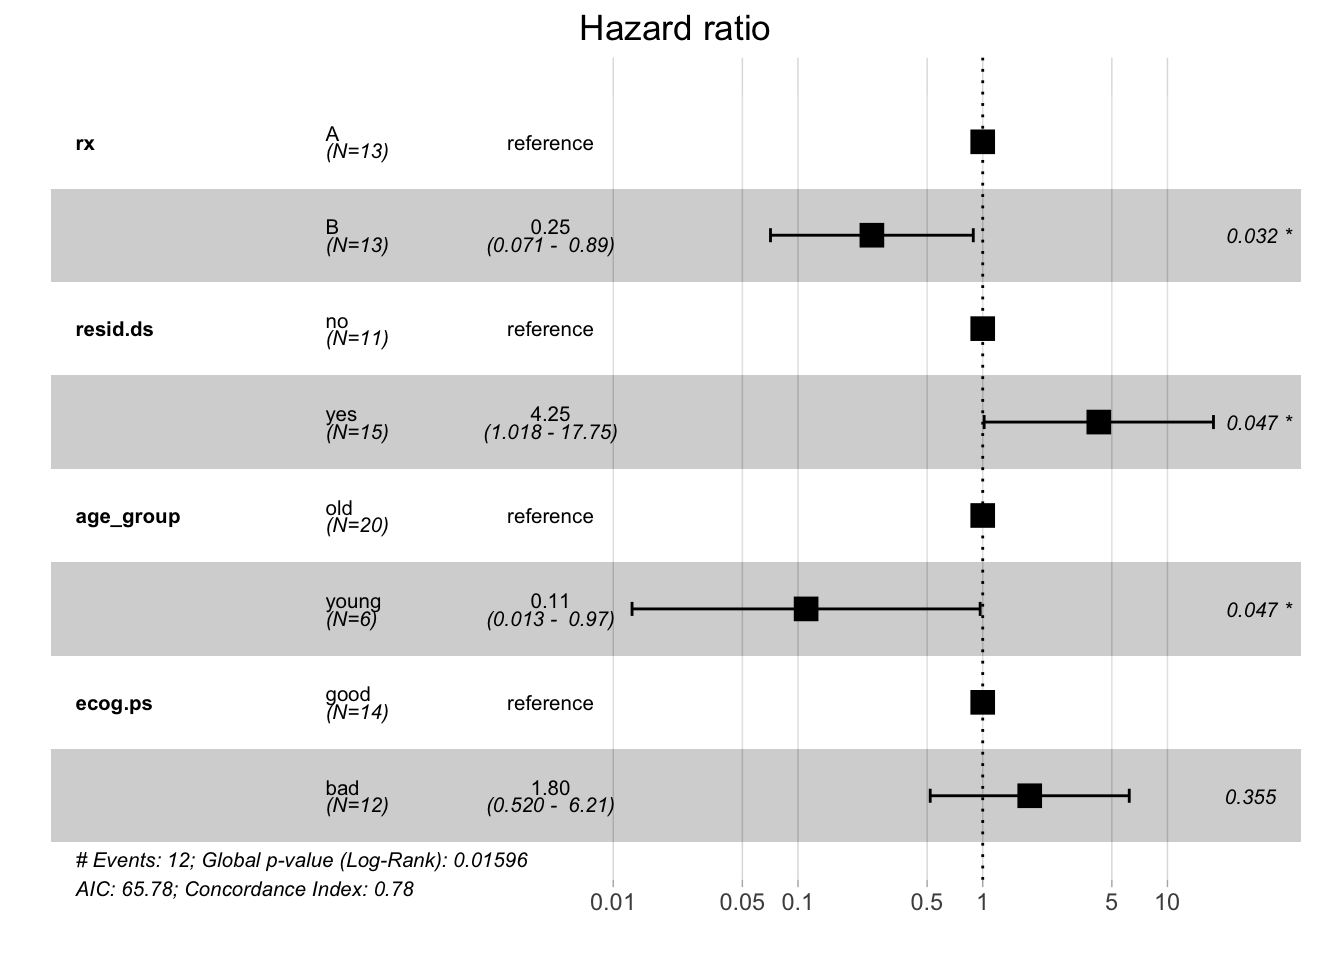
Jede HR steht für ein relatives Sterberisiko, das eine Ausprägung eines binären Merkmals mit der anderen vergleicht. Beispiel: Eine Hazard Ratio von 0,25 für die Behandlungsgruppen bedeutet, dass Patientinnen unter Behandlung B ein verringertes Sterberisiko haben als Patientinnen unter Behandlung A (Referenz für die HR). Der Forest Plot zeigt ein 95%-Konfidenzintervall von 0,071 bis 0,89 — das ist signifikant.
In diesem Modell beeinflussen Behandlungsgruppe, Resttumorstatus und Altersgruppe das Sterberisiko der Patientinnen signifikant. Das unterscheidet sich von den Ergebnissen mit Kaplan-Meier und Log-Rank. Während der Kaplan-Meier-Schätzer die Überlebenswahrscheinlichkeit schätzt, bewertet das Cox-Modell das Sterberisiko und liefert Hazard Ratios. Deine Analyse zeigt: Die Methoden können sich in der Signifikanz ihrer Ergebnisse unterscheiden.
Die Beispiele zeigen, wie einfach sich die statistischen Konzepte der Survival-Analyse in R umsetzen lassen. In dieser Einführung hast du gelernt, entsprechende Modelle zu bauen, sie zu visualisieren und die wichtigsten statistischen Hintergründe zu verstehen, um deine Ergebnisse einzuordnen. Hoffentlich kannst du diese Techniken nun auf deine eigenen Datensätze anwenden. Danke fürs Lesen!
Sieh dir auch unser Tutorial zur Linearen Regression in R an.
R-Kurse
Kurs
Kurs
Kurs