Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M

Khai phá dữ liệu hoặc các kỹ thuật học máy thường có thể được sử dụng ở giai đoạn đầu của nghiên cứu y sinh để phân tích các tập dữ liệu lớn, ví dụ, hỗ trợ xác định gen ứng viên hoặc các biomarker dự đoán bệnh trong các tập dữ liệu giải trình tự quy mô lớn. Tuy nhiên, dữ liệu từ thử nghiệm lâm sàng thường bao gồm “dữ liệu sống sót” đòi hỏi một cách tiếp cận phân tích hoàn toàn khác.
Trong kiểu phân tích này, thời gian tới một sự kiện cụ thể, như tử vong hoặc tái phát bệnh, là trọng tâm và hai (hoặc nhiều) nhóm bệnh nhân được so sánh liên quan đến khoảng thời gian này. Ba khái niệm cốt lõi có thể được sử dụng để rút ra kết quả có ý nghĩa từ loại dữ liệu như vậy và mục tiêu của hướng dẫn này là giới thiệu các khái niệm thống kê, cách diễn giải của chúng, cũng như một ứng dụng thực tế của các phương pháp này cùng với cách triển khai trong R:
Trong hướng dẫn này, bạn cũng sẽ sử dụng các gói survival và survminer trong R và bộ dữ liệu ovarian (Edmunson J.H. et al., 1979) đi kèm với gói survival. Bạn sẽ đọc thêm về bộ dữ liệu này ở phần sau của hướng dẫn!
Mẹo: xem tờ ghi nhớ survminer này
Sau hướng dẫn này, bạn sẽ có thể tận dụng các dữ liệu này để trả lời những câu hỏi như: bệnh nhân có lợi hơn khi dùng phác đồ điều trị A so với B không? Tuổi và thể trạng của bệnh nhân có ảnh hưởng đáng kể đến kết quả không? Bệnh tồn dư có phải là biomarker tiên lượng về mặt sống sót không?
Trước khi đi sâu vào thống kê, bạn có thể muốn tìm hiểu một số thuật ngữ hữu ích:
Thuật ngữ "kiểm duyệt" (censoring) đề cập đến dữ liệu không đầy đủ. Mặc dù có các loại khác nhau, ở thời điểm này bạn có thể muốn giới hạn ở dữ liệu kiểm duyệt phải (right-censored), vì đây là loại phổ biến nhất trong các tập dữ liệu sống sót.
Với một số bệnh nhân, bạn có thể biết rằng họ đã được theo dõi trong một khoảng thời gian nhất định mà không có “sự kiện” xảy ra, nhưng có thể bạn không biết liệu cuối cùng bệnh nhân có sống sót hay không. Điều này xảy ra nếu bệnh nhân bị mất theo dõi hoặc rút khỏi nghiên cứu. Dữ liệu của bệnh nhân này sẽ được “kiểm duyệt” sau thời điểm cuối cùng mà bạn chắc chắn rằng bệnh nhân chưa gặp “sự kiện” bạn quan tâm. Sự kiện là điểm cuối được xác định trước của nghiên cứu, ví dụ tử vong hoặc tái phát bệnh. Ngoài ra, tất cả bệnh nhân không gặp “sự kiện” cho đến khi nghiên cứu kết thúc sẽ được kiểm duyệt tại thời điểm cuối cùng đó.
Cơ bản thì có ba lý do khiến dữ liệu bị kiểm duyệt.
Do đó, số lượng quan sát bị kiểm duyệt luôn n >= 0. Tất cả các ví dụ này là trường hợp “kiểm duyệt phải” và có thể phân loại thêm thành kiểm duyệt loại I cố định hoặc ngẫu nhiên và kiểm duyệt loại II, nhưng các phân loại này chủ yếu liên quan đến thiết kế nghiên cứu và sẽ không bàn sâu trong hướng dẫn nhập môn này.
Một điều bạn nên ghi nhớ là tất cả các dạng kiểm duyệt đều là thiếu thông tin và việc kiểm duyệt không bao giờ do “sự kiện” xác định điểm cuối của nghiên cứu gây ra. Điều đó cũng ngụ ý rằng không có bệnh nhân nào bị kiểm duyệt trong bộ dữ liệu ovarian là do bệnh nhân đó đã tử vong.
Vậy một hàm sống sót mô tả sự sống còn của bệnh nhân theo thời gian trông như thế nào?
Bộ ước lượng Kaplan-Meier, được Edward Kaplan và Paul Meier mô tả độc lập và cùng công bố năm 1958 trên Tạp chí Hiệp hội Thống kê Hoa Kỳ, là một thống kê phi tham số cho phép ước tính hàm sống sót.
Hãy nhớ rằng thống kê phi tham số không dựa trên giả định về một phân phối xác suất nền tảng, điều này hợp lý vì dữ liệu sống sót có phân phối lệch.
Thống kê này cho biết xác suất một bệnh nhân sống sót qua một thời điểm cụ thể t. Tại t = 0, bộ ước lượng Kaplan-Meier bằng 1 và khi t tiến tới vô cùng, ước lượng tiến về 0. Về lý thuyết, với một tập dữ liệu vô hạn và t đo đến từng giây, hàm tương ứng của t so với xác suất sống sót sẽ mượt. Sau này, bạn sẽ thấy nó trông như thế nào trong thực tế.
Nó còn dựa trên giả định rằng xác suất sống sót qua một thời điểm t bằng tích của các tỷ lệ sống sót quan sát được cho đến thời điểm t. Cụ thể hơn, S(t) #xác suất sống sót tại thời điểm t được cho bởi S(t) = p.1 * p.2 * … * p.t với p.1 là tỷ lệ tất cả bệnh nhân sống sót qua thời điểm thứ nhất, p.2 là tỷ lệ bệnh nhân sống sót qua thời điểm thứ hai, v.v. cho đến thời điểm t.
Điều quan trọng cần lưu ý là, bắt đầu từ p.2 đến p.t, bạn chỉ tính những bệnh nhân đã sống sót qua thời điểm trước đó khi tính tỷ lệ cho mỗi thời điểm tiếp theo; do đó, p.2, p.3, …, p.t là các tỷ lệ có điều kiện trên các tỷ lệ trước đó.
Trong thực hành, trước tiên bạn nên sắp xếp thời gian sống sót theo thứ tự tăng dần. Việc này bao gồm cả các giá trị bị kiểm duyệt. Sau đó, bạn tính các tỷ lệ như mô tả ở trên và nhân chúng để suy ra S(t). Các bệnh nhân bị kiểm duyệt được loại khỏi phép tính sau thời điểm kiểm duyệt, do đó họ không ảnh hưởng đến tỷ lệ bệnh nhân còn sống. Để biết thông tin chi tiết về phương pháp, tham khảo (Swinscow và Campbell, 2002).
Cuối cùng, bạn có thể sử dụng kiểm định log-rank để so sánh các đường cong sống sót của hai nhóm. Kiểm định log-rank là kiểm định giả thuyết thống kê nhằm kiểm tra giả thuyết không rằng các đường cong sống sót của hai quần thể không khác nhau. Một phân phối xác suất nhất định, cụ thể là phân phối chi-bình phương, có thể được dùng để suy ra giá trị p. Nói ngắn gọn, giá trị p được dùng trong kiểm định giả thuyết để định lượng ý nghĩa thống kê. Kết quả với p < 0.05 thường được coi là có ý nghĩa. Trong trường hợp của chúng ta, p < 0.05 sẽ cho thấy hai nhóm điều trị khác biệt có ý nghĩa về mặt sống sót.
Một hàm hữu ích khác trong bối cảnh phân tích sống sót là hàm nguy cơ h(t). Nó mô tả xác suất xảy ra sự kiện hay nguy cơ h (trong trường hợp này là tử vong) nếu đối tượng đã sống sót đến thời điểm t đó. Nó khó minh họa hơn ước lượng Kaplan-Meier vì đo lường rủi ro tử vong tức thời. Tuy nhiên, bạn cần hàm nguy cơ để xét đến các biến đồng biến khi so sánh sự sống sót của các nhóm bệnh nhân. Đồng biến, còn gọi là biến giải thích hoặc biến độc lập trong phân tích hồi quy, là các biến có thể dự đoán một kết quả hoặc bạn muốn điều chỉnh để tính đến tương tác giữa các biến.
Nếu kiểm định log-rank so sánh hai đường cong sống sót Kaplan-Meier, vốn có thể được tạo ra bằng cách chia quần thể bệnh nhân thành các nhóm điều trị, thì các mô hình tỷ lệ nguy cơ Cox được suy ra từ các hàm nguy cơ cơ sở của các quần thể bệnh nhân liên quan và một số lượng tùy ý các đồng biến đã nhị phân hóa. Một lần nữa, nó không giả định một phân phối xác suất nền tảng nhưng giả định rằng các nguy cơ của các nhóm bệnh nhân bạn so sánh là không đổi theo thời gian. Đó là lý do gọi là “mô hình tỷ lệ nguy cơ”. Sau này, bạn sẽ thấy một ví dụ minh họa các cân nhắc lý thuyết này.
Giờ hãy thử phân tích bộ dữ liệu ovarian!
Với các khái niệm trên, bạn có thể bắt đầu phân tích một bộ dữ liệu thực và thử trả lời một số câu hỏi ở trên. Hãy bắt đầu bằng cách tải hai gói cần thiết cho phân tích và gói dplyr cung cấp một số hàm hữu ích để quản lý data frame.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Mẹo: đừng quên dùng install.packages() để cài đặt mọi gói còn thiếu trong không gian làm việc của bạn!
Bước tiếp theo là tải bộ dữ liệu và xem cấu trúc của nó. Như bạn đã đọc ở đầu hướng dẫn, bạn sẽ làm việc với bộ dữ liệu ovarian. Bộ dữ liệu này bao gồm một nhóm bệnh nhân ung thư buồng trứng và thông tin lâm sàng tương ứng, bao gồm thời gian được theo dõi cho đến khi họ tử vong hoặc mất theo dõi (futime), liệu bệnh nhân có bị kiểm duyệt hay không (fustat), tuổi bệnh nhân, phân nhóm điều trị, sự hiện diện của bệnh tồn dư và tình trạng thể lực.
Như bạn có thể thấy, tên của một số biến hơi khó hiểu, bạn có thể muốn tham khảo trang trợ giúp.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
Cột futime chứa thời gian sống sót. Đây là biến phản hồi. Ngược lại, fustat cho biết thời gian sống sót của từng bệnh nhân có bị kiểm duyệt hay không. Rõ ràng, 26 bệnh nhân trong nghiên cứu này nhận một trong hai phác đồ điều trị (rx) và bác sĩ điều trị đã đánh giá thoái lui khối u (resid.ds) và tình trạng thể lực của bệnh nhân (theo tiêu chí ECOG chuẩn hóa; ecog.ps) tại một thời điểm nào đó.
Thêm vào đó, bạn có thông tin về tuổi của bệnh nhân và nếu muốn đưa biến này vào như một biến dự đoán, bạn cần nhị phân hóa giá trị liên tục thành nhị phân. Nhưng nên chọn ngưỡng nào? Hãy xem phân bố tổng thể của các giá trị tuổi:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 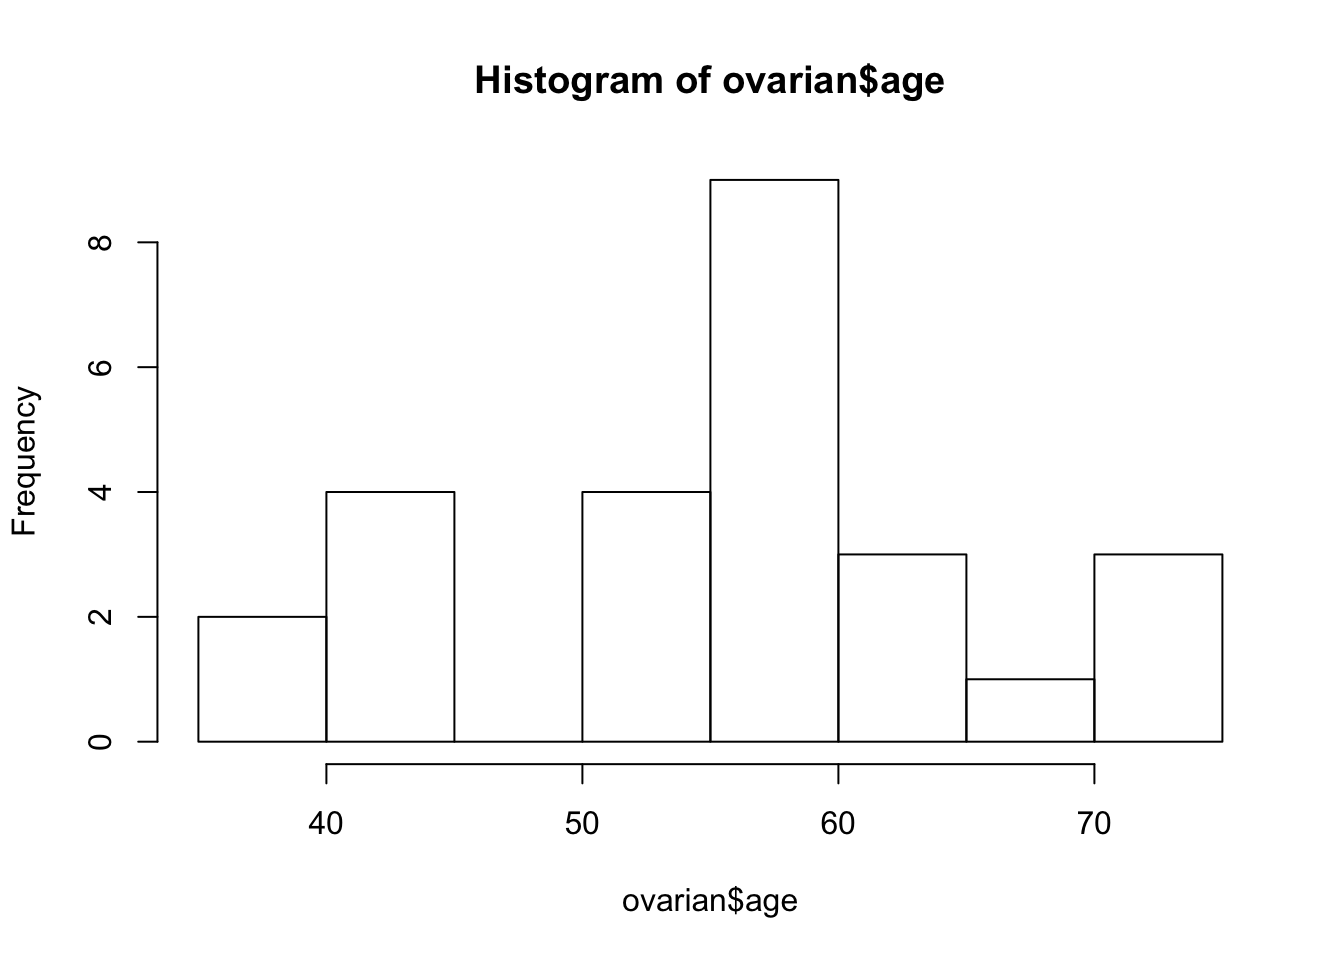
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
Phân bố hiển nhiên là hai đỉnh gợi ý ngưỡng 50 tuổi. Bạn có thể dùng hàm mutate để thêm cột age_group vào data frame, điều này sẽ hữu ích về sau. Đồng thời, bạn nên chuyển các đồng biến sau này thành kiểu factor.
Bây giờ, bạn đã sẵn sàng tạo một đối tượng sống sót. Về cơ bản, đó là phiên bản tổng hợp của các cột futime và fustat có thể được survfit diễn giải. Dấu + sau thời gian sống sót biểu thị các điểm dữ liệu bị kiểm duyệt.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Bước tiếp theo là khớp các đường cong Kaplan-Meier. Bạn có thể dễ dàng làm điều đó bằng cách truyền surv_object vào hàm survfit. Bạn cũng có thể phân tầng đường cong theo phác đồ điều trị rx mà bệnh nhân được chỉ định. Hàm summary() của đối tượng fit1 kết quả hiển thị, trong số những thứ khác, các thời điểm sống sót, tỷ lệ bệnh nhân còn sống tại mỗi thời điểm, tức p.1, p.2, ... ở trên, và các nhóm điều trị.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Bạn có thể xem đường cong sống sót tương ứng bằng cách truyền đối tượng sống sót vào hàm ggsurvplot. Tham số pval = TRUE rất hữu ích vì nó cũng vẽ giá trị p của kiểm định log-rank!
ggsurvplot(fit1, data = ovarian, pval = TRUE)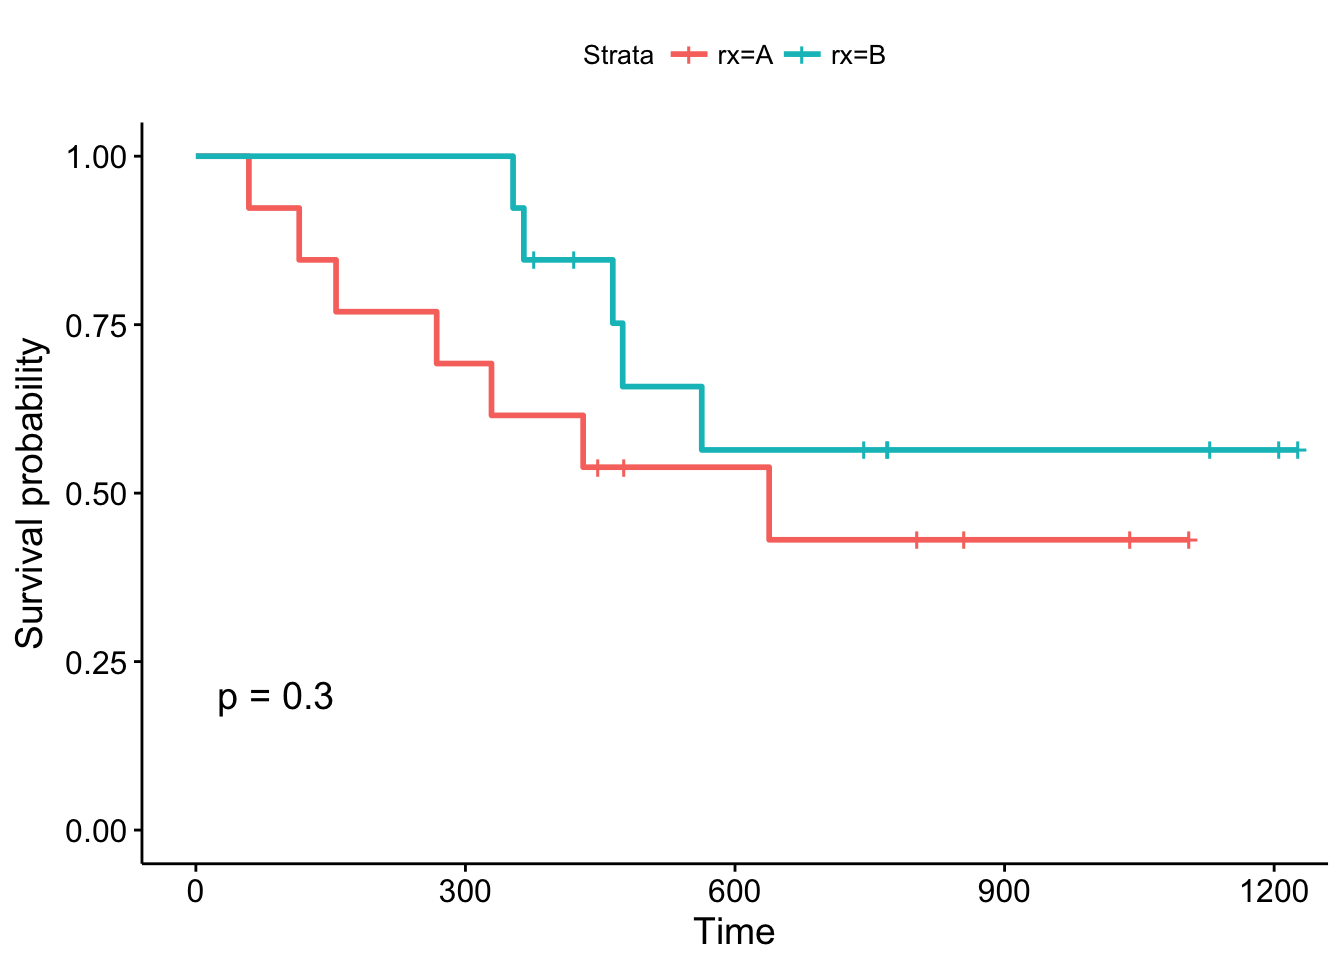
Theo quy ước, các đường thẳng đứng biểu thị dữ liệu bị kiểm duyệt, giá trị x tương ứng là thời điểm kiểm duyệt xảy ra.
Giá trị p của log-rank bằng 0.3 cho thấy kết quả không có ý nghĩa nếu bạn coi p < 0.05 là ngưỡng ý nghĩa thống kê. Trong nghiên cứu này, không có phương án điều trị nào vượt trội có ý nghĩa, mặc dù bệnh nhân dùng điều trị B có kết quả tốt hơn trong tháng theo dõi đầu tiên. Còn các biến khác thì sao?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)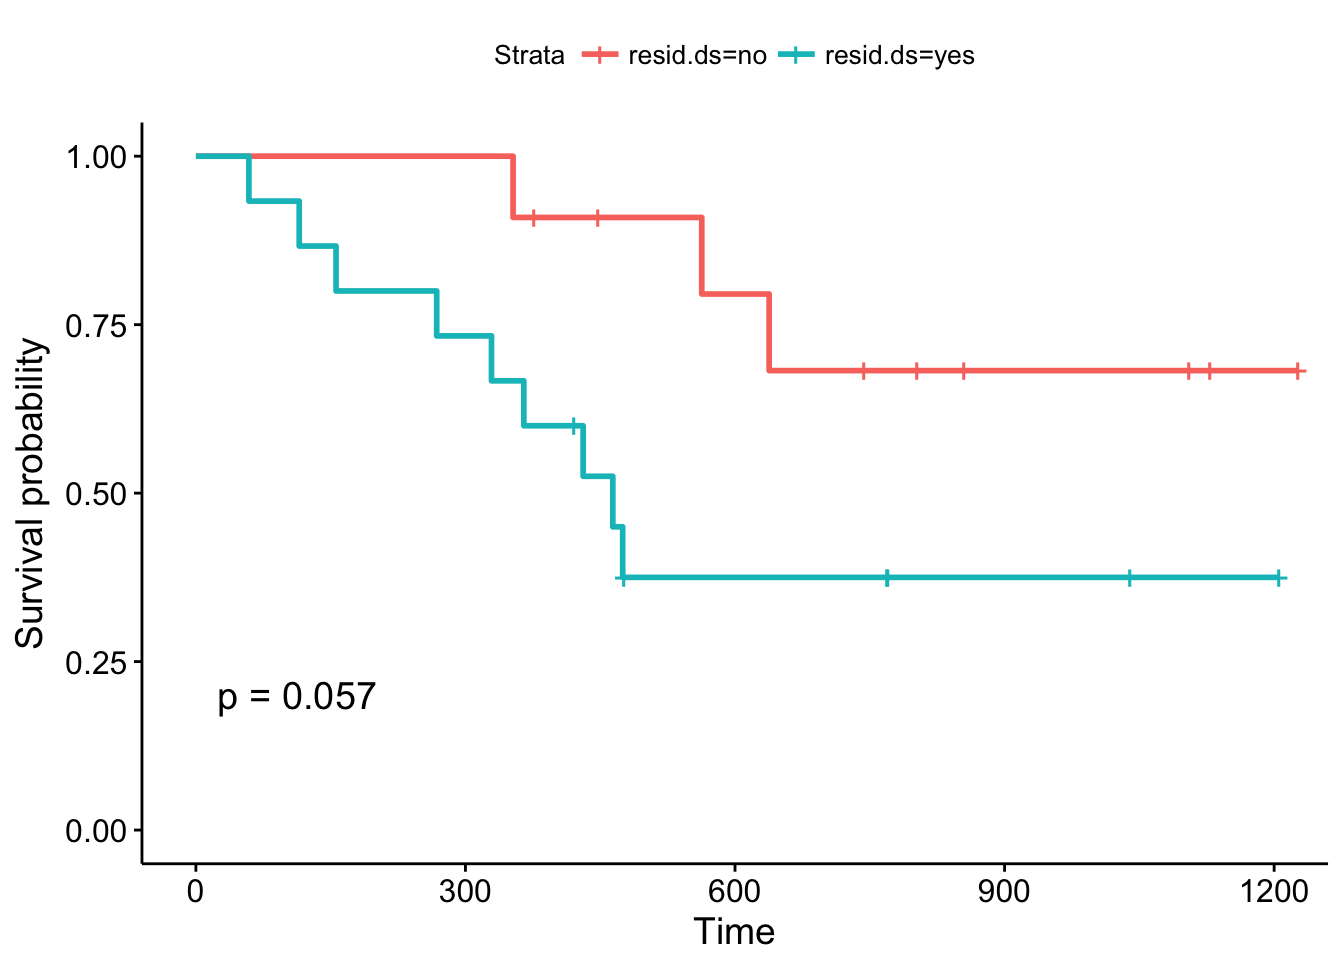
Các biểu đồ Kaplan-Meier được phân tầng theo tình trạng bệnh tồn dư trông có chút khác: Các đường cong tách nhau sớm và kiểm định log-rank gần đạt ý nghĩa. Bạn có thể lập luận rằng một nghiên cứu tiếp theo với cỡ mẫu lớn hơn có thể xác nhận các kết quả này, tức bệnh nhân có bệnh tồn dư dương tính có tiên lượng kém hơn đáng kể so với bệnh nhân không có bệnh tồn dư.
Nhưng có cách hệ thống hơn để xem xét các đồng biến khác nhau không? Như bạn có thể nhớ, các mô hình tỷ lệ nguy cơ Cox cho phép bạn đưa các đồng biến vào. Bạn có thể xây dựng mô hình Cox bằng hàm coxph và trực quan hóa chúng bằng ggforest. Kiểu biểu đồ này gọi là forest plot. Nó hiển thị các tỷ số nguy cơ (HR) được suy ra từ mô hình cho tất cả đồng biến mà chúng ta đưa vào công thức trong coxph. Ngắn gọn, HR > 1 chỉ ra tăng nguy cơ tử vong (theo định nghĩa của h(t)) nếu bệnh nhân thỏa điều kiện cụ thể. Ngược lại, HR < 1 chỉ ra giảm nguy cơ. Hãy xem đầu ra của mô hình:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
 ggforest(fit.coxph, data = ovarian)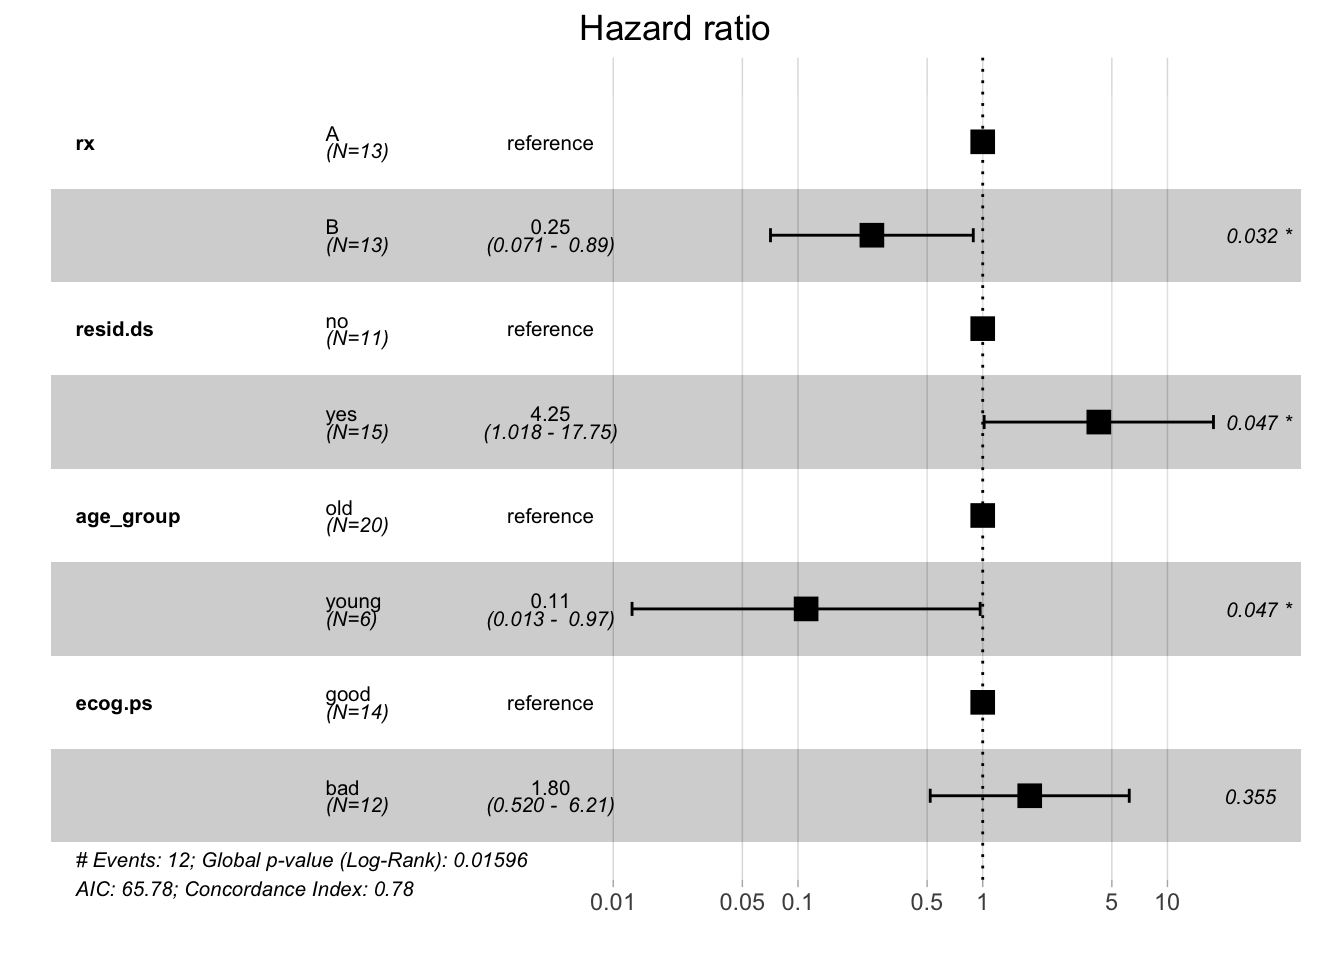
Mỗi HR biểu thị rủi ro tử vong tương đối so sánh một trường hợp của đặc trưng nhị phân với trường hợp còn lại. Ví dụ, một tỷ số nguy cơ 0.25 cho nhóm điều trị cho biết những bệnh nhân nhận điều trị B có nguy cơ tử vong giảm so với những bệnh nhân nhận điều trị A (được dùng làm tham chiếu để tính HR). Như forest plot cho thấy, khoảng tin cậy 95% tương ứng là 0.071 - 0.89 và kết quả này có ý nghĩa.
Với mô hình này, bạn có thể thấy các biến nhóm điều trị, tình trạng bệnh tồn dư và nhóm tuổi ảnh hưởng đáng kể đến nguy cơ tử vong của bệnh nhân trong nghiên cứu. Điều này khá khác với những gì bạn thấy với ước lượng Kaplan-Meier và kiểm định log-rank. Trong khi phương pháp trước ước tính xác suất sống sót, phương pháp sau tính nguy cơ tử vong và các tỷ số nguy cơ tương ứng. Phân tích của bạn cho thấy kết quả từ các phương pháp này có thể khác nhau về mức ý nghĩa.
Các ví dụ trên cho thấy việc triển khai các khái niệm thống kê của phân tích sống sót trong R dễ dàng như thế nào. Trong phần giới thiệu này, bạn đã học cách xây dựng các mô hình tương ứng, cách trực quan hóa chúng, và một số kiến thức nền tảng thống kê giúp hiểu kết quả phân tích. Hy vọng giờ đây bạn có thể bắt đầu áp dụng các kỹ thuật này để phân tích các bộ dữ liệu của riêng mình. Cảm ơn bạn đã đọc hướng dẫn!
Xem thêm Hướng dẫn Hồi quy tuyến tính trong R.
Khóa học về R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
