Curso
Introducción a R
4 h
3.1M

Las técnicas de minería de datos o de aprendizaje automático pueden utilizarse a menudo en las primeras fases de la investigación biomédica para analizar grandes conjuntos de datos; por ejemplo, para identificar genes candidatos o biomarcadores predictivos de enfermedad en datos de secuenciación de alto rendimiento. Sin embargo, los datos de ensayos clínicos suelen incluir "datos de supervivencia" que requieren un enfoque bastante distinto de análisis.
En este tipo de análisis, nos interesa el tiempo hasta un evento concreto, como la muerte o la recaída, y se comparan dos (o más) grupos de pacientes con respecto a ese tiempo. Tres conceptos clave permiten extraer resultados significativos de este tipo de datos, y el objetivo de este tutorial es introducir estos conceptos estadísticos, su interpretación y una aplicación real de estos métodos junto con su implementación en R:
En este tutorial también vas a utilizar los paquetes de R survival y survminer y el conjunto de datos ovarian (Edmunson J.H. et al., 1979) que se incluye en el paquete survival. ¡Más adelante leerás más sobre este dataset!
Consejo: echa un vistazo a esta chuleta de survminer
Después de este tutorial, podrás aprovechar estos datos para responder preguntas como: ¿los pacientes se benefician más del tratamiento A que del B? ¿La edad y la condición física influyen significativamente en el resultado? ¿La enfermedad residual es un biomarcador pronóstico en términos de supervivencia?
Antes de entrar en detalle con la parte estadística, conviene aclarar algo de terminología útil:
El término "censura" hace referencia a datos incompletos. Aunque existen distintos tipos, por ahora conviene limitarse a la censura por la derecha, ya que es la más habitual en los conjuntos de datos de supervivencia.
Para algunos pacientes puedes saber que se les hizo seguimiento durante un tiempo sin que ocurriera el "evento", pero puede que no sepas si finalmente sobrevivieron o no. Esto sucede si el paciente se pierde en el seguimiento o decide abandonar el estudio. Los datos de ese paciente quedarán "censurados" después del último momento en el que sabes con certeza que no experimentó el "evento" que estás estudiando. Un evento es el desenlace predefinido del estudio, por ejemplo, la muerte o la recaída. Además, todos los pacientes que no experimenten el "evento" antes de que termine el estudio se censuran en ese último momento.
Básicamente, estas son las tres razones por las que los datos pueden estar censurados.
Por tanto, el número de observaciones censuradas siempre cumple n >= 0. Todos estos ejemplos son casos de "censura por la derecha" y, a su vez, se pueden clasificar en censura de tipo I (fija o aleatoria) y de tipo II, aunque estas clasificaciones importan sobre todo desde la perspectiva del diseño del estudio y no nos ocuparán en este tutorial introductorio.
Ten en cuenta que todos los tipos de censura implican falta de información, y la censura nunca está causada por el "evento" que define el desenlace del estudio. Esto también implica que ninguno de los pacientes censurados en el conjunto ovarian fue censurado porque hubiera fallecido.
Ahora bien, ¿cómo es una función de supervivencia que describe la supervivencia de pacientes a lo largo del tiempo?
El estimador de Kaplan-Meier, descrito de forma independiente por Edward Kaplan y Paul Meier y publicado conjuntamente en 1958 en el Journal of the American Statistical Association, es una estadística no paramétrica que permite estimar la función de supervivencia.
Recuerda que una estadística no paramétrica no se basa en suponer una distribución de probabilidad subyacente, lo cual tiene sentido porque los datos de supervivencia suelen presentar distribuciones asimétricas.
Esta estadística da la probabilidad de que un paciente sobreviva más allá de un instante t concreto. En t = 0, el estimador es 1 y, cuando t tiende a infinito, el estimador tiende a 0. En teoría, con un conjunto de datos infinitamente grande y t medido al segundo, la función correspondiente de t frente a la probabilidad de supervivencia sería suave. Más adelante verás cómo se ve en la práctica.
Además, se basa en la hipótesis de que la probabilidad de sobrevivir más allá de un instante t es igual al producto de las tasas de supervivencia observadas hasta ese instante. En concreto, S(t) #probabilidad de supervivencia en el tiempo t viene dada por S(t) = p.1 * p.2 * … * p.t, donde p.1 es la proporción de pacientes que sobreviven más allá del primer instante, p.2 la proporción que sobrevive más allá del segundo, y así sucesivamente hasta llegar a t.
Es importante notar que, a partir de p.2 y hasta p.t, al calcular cada proporción solo se tienen en cuenta los pacientes que han sobrevivido al instante anterior; por tanto, p.2, p.3, …, p.t son proporciones condicionadas a las anteriores.
En la práctica, primero conviene ordenar los tiempos de supervivencia de menor a mayor, incluyendo los valores censurados. Luego calculas las proporciones como se ha descrito y las multiplicas para obtener S(t). Los pacientes censurados se omiten a partir del momento de censura, así que no influyen en la proporción de pacientes que siguen vivos. Para más detalles sobre el método, consulta (Swinscow y Campbell, 2002).
Por último, puedes usar la prueba de log-rank para comparar curvas de supervivencia de dos grupos. Es una prueba de hipótesis que contrasta la hipótesis nula de que las curvas de supervivencia de dos poblaciones no difieren. A partir de una distribución de chi-cuadrado se obtiene un valor p. En pocas palabras, los valores p se usan para cuantificar la significación estadística; habitualmente se considera significativo un resultado con p < 0.05. En nuestro caso, p < 0.05 indicaría que los dos grupos de tratamiento difieren significativamente en términos de supervivencia.
Otra función útil en el contexto del análisis de supervivencia es la función de riesgo h(t). Describe la probabilidad de que ocurra un evento o su riesgo h (de nuevo, la muerte en este caso) condicionado a haber sobrevivido hasta el instante t. Es algo más difícil de ilustrar que el estimador de Kaplan-Meier porque mide el riesgo instantáneo de fallecer. Aun así, necesitas la función de riesgo para considerar covariables cuando comparas la supervivencia de grupos de pacientes. Las covariables, también llamadas variables explicativas o independientes en regresión, son variables que pueden predecir un resultado o que quieres ajustar para tener en cuenta interacciones.
Mientras que la prueba de log-rank compara dos curvas de Kaplan-Meier (por ejemplo, al dividir a los pacientes en subgrupos de tratamiento), los modelos de riesgos proporcionales de Cox se construyen a partir de las funciones de riesgo basal de las poblaciones en estudio y de un número arbitrario de covariables dicotomizadas. De nuevo, no asumen una distribución de probabilidad subyacente, pero sí suponen que los riesgos de los grupos que comparas son proporcionales (constantes en el tiempo). Por eso se llaman "modelos de riesgos proporcionales". Más adelante verás un ejemplo que ilustra estas ideas.
Ahora, ¡vamos a analizar el conjunto de datos ovarian!
Con estos conceptos claros, ya puedes empezar a analizar un conjunto de datos real e intentar responder algunas de las preguntas anteriores. Empecemos cargando los dos paquetes necesarios para los análisis y el paquete dplyr, que incluye funciones útiles para gestionar data frames.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Consejo: no olvides usar install.packages() para instalar cualquier paquete que te falte en tu entorno.
El siguiente paso es cargar el conjunto de datos y examinar su estructura. Como leíste al principio del tutorial, trabajarás con el conjunto ovarian. Incluye una cohorte de pacientes con cáncer de ovario y su información clínica correspondiente, entre ella el tiempo de seguimiento hasta la muerte o la pérdida de seguimiento (futime), si el tiempo de supervivencia está censurado o no (fustat), la edad, el grupo de tratamiento asignado, la presencia de enfermedad residual y el estado funcional.
Como ves, algunos nombres de variables son algo crípticos; quizá te convenga consultar la página de ayuda.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
La columna futime contiene los tiempos de supervivencia: es la variable respuesta. fustat, por su parte, indica si el tiempo de supervivencia de un paciente está censurado. Al parecer, los 26 pacientes del estudio recibieron uno de dos regímenes terapéuticos (rx) y el médico valoró la regresión tumoral (resid.ds) y el estado funcional de los pacientes (según los criterios estandarizados ECOG; ecog.ps).
Además, dispones de la edad de los pacientes y, si quisieras incluirla como variable predictora, tendrías que dicotomizarla a valores binarios. ¿Qué punto de corte elegir? Veamos la distribución global de la edad:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 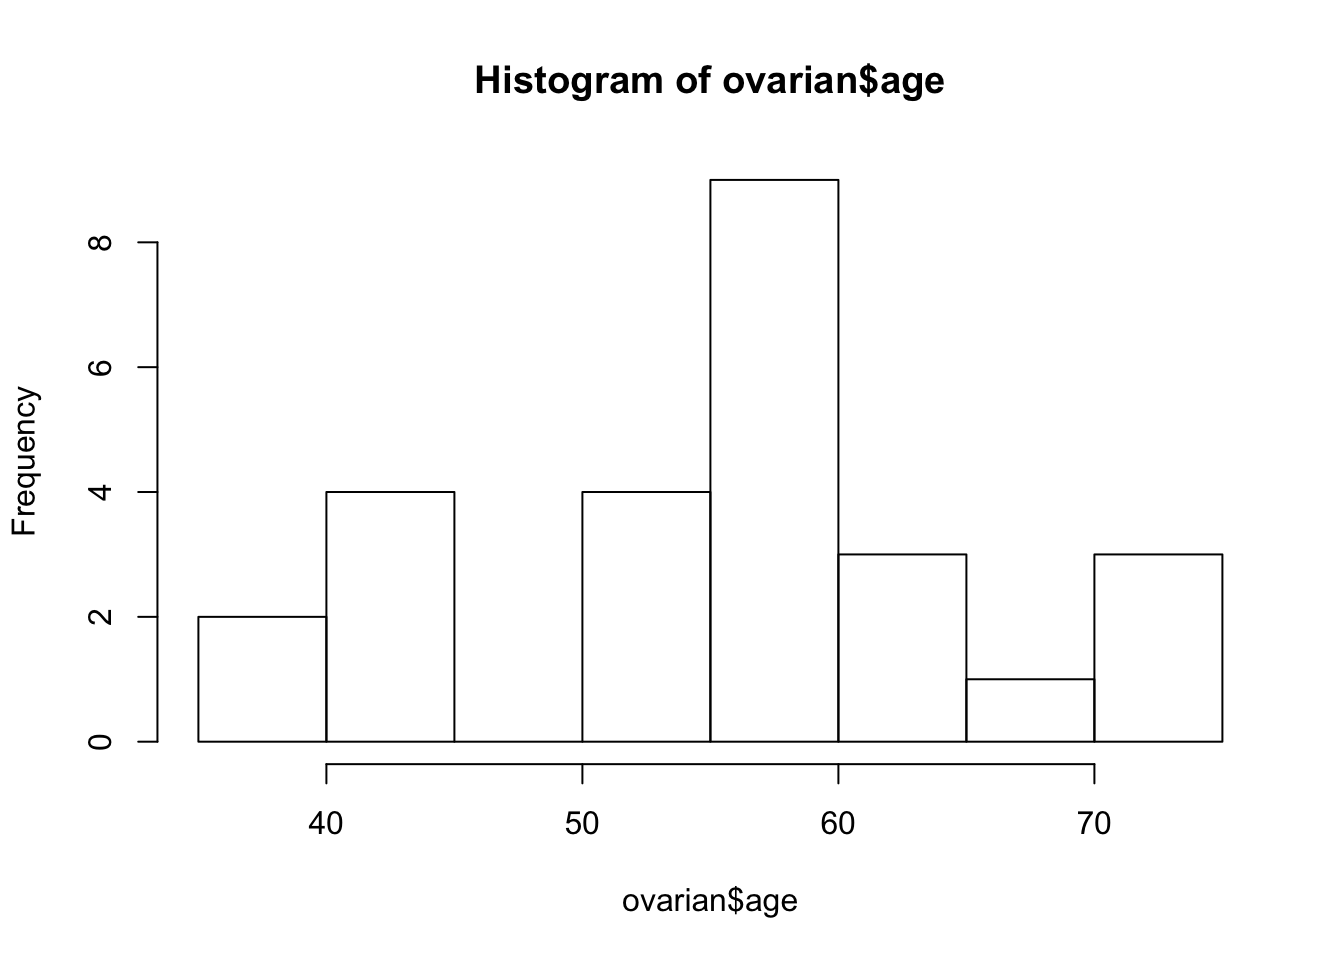
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
La distribución claramente bimodal sugiere un punto de corte de 50 años. Puedes usar la función mutate para añadir una columna adicional age_group al data frame que te será útil más adelante. Además, conviene convertir las futuras covariables en factores.
Ahora estás listo para crear un objeto de supervivencia. Básicamente es una versión compilada de las columnas futime y fustat que puede interpretar la función survfit. Un + tras los tiempos de supervivencia indica datos censurados.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
El siguiente paso es ajustar las curvas de Kaplan-Meier. Puedes hacerlo pasando el surv_object a la función survfit. También puedes estratificar la curva según el régimen de tratamiento rx asignado a los pacientes. Un summary() del objeto resultante fit1 muestra, entre otras cosas, los tiempos de supervivencia, la proporción de pacientes vivos en cada instante (tus p.1, p.2, ... de arriba) y los grupos de tratamiento.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Puedes examinar la curva de supervivencia correspondiente pasando el objeto de supervivencia a la función ggsurvplot. El argumento pval = TRUE es muy útil porque también muestra el valor p de la prueba de log-rank.
ggsurvplot(fit1, data = ovarian, pval = TRUE)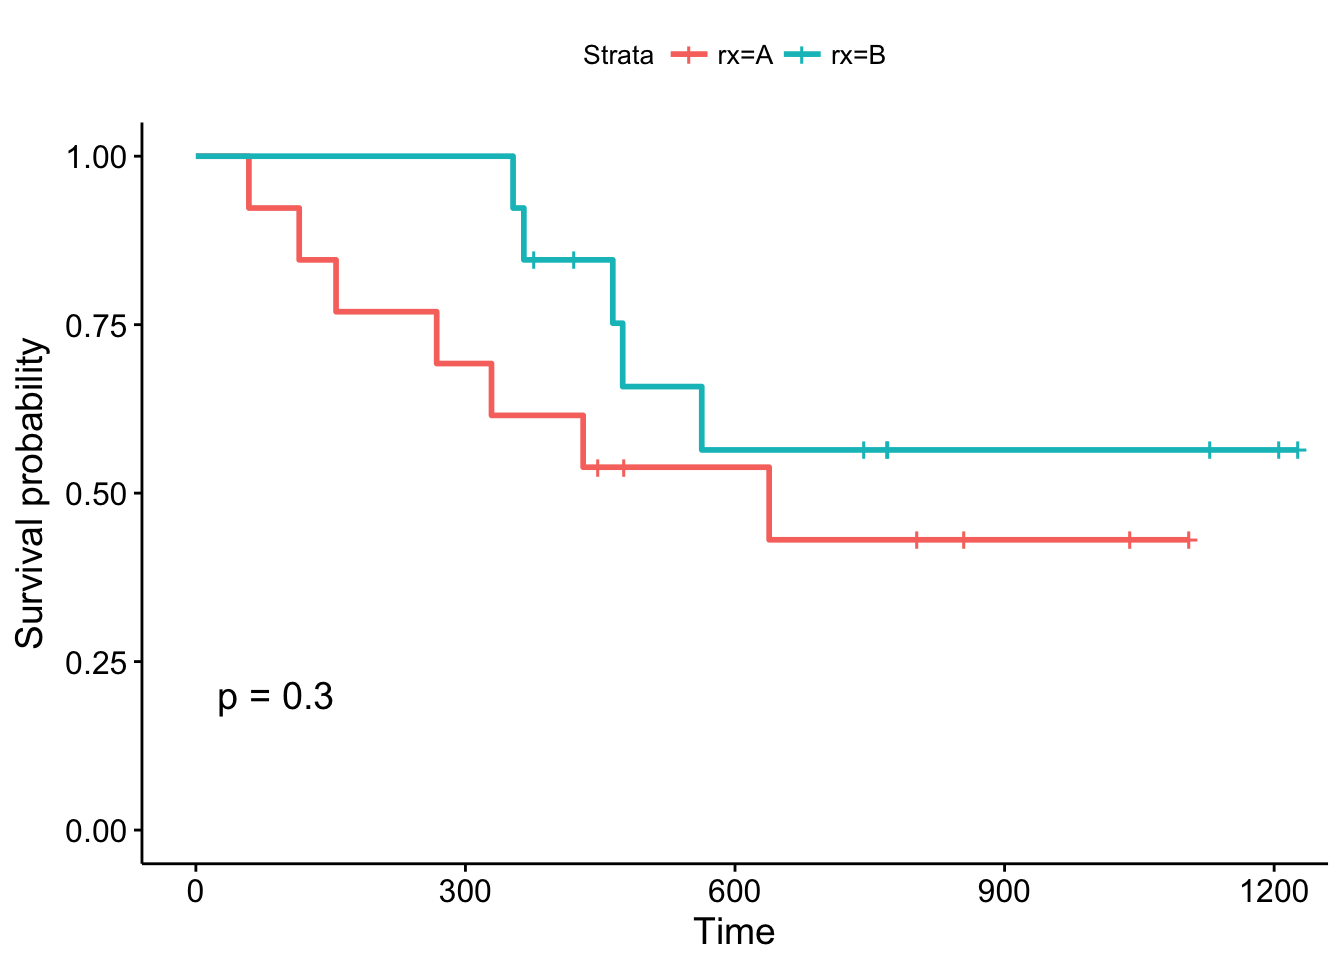
Por convención, las líneas verticales indican datos censurados; sus valores en x señalan el momento en el que ocurrió la censura.
El valor p de log-rank de 0.3 indica un resultado no significativo si consideras p < 0.05 como umbral de significación. En este estudio, ninguno de los tratamientos fue significativamente superior, aunque los pacientes con el tratamiento B parecen evolucionar mejor en el primer mes de seguimiento. ¿Qué ocurre con el resto de variables?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)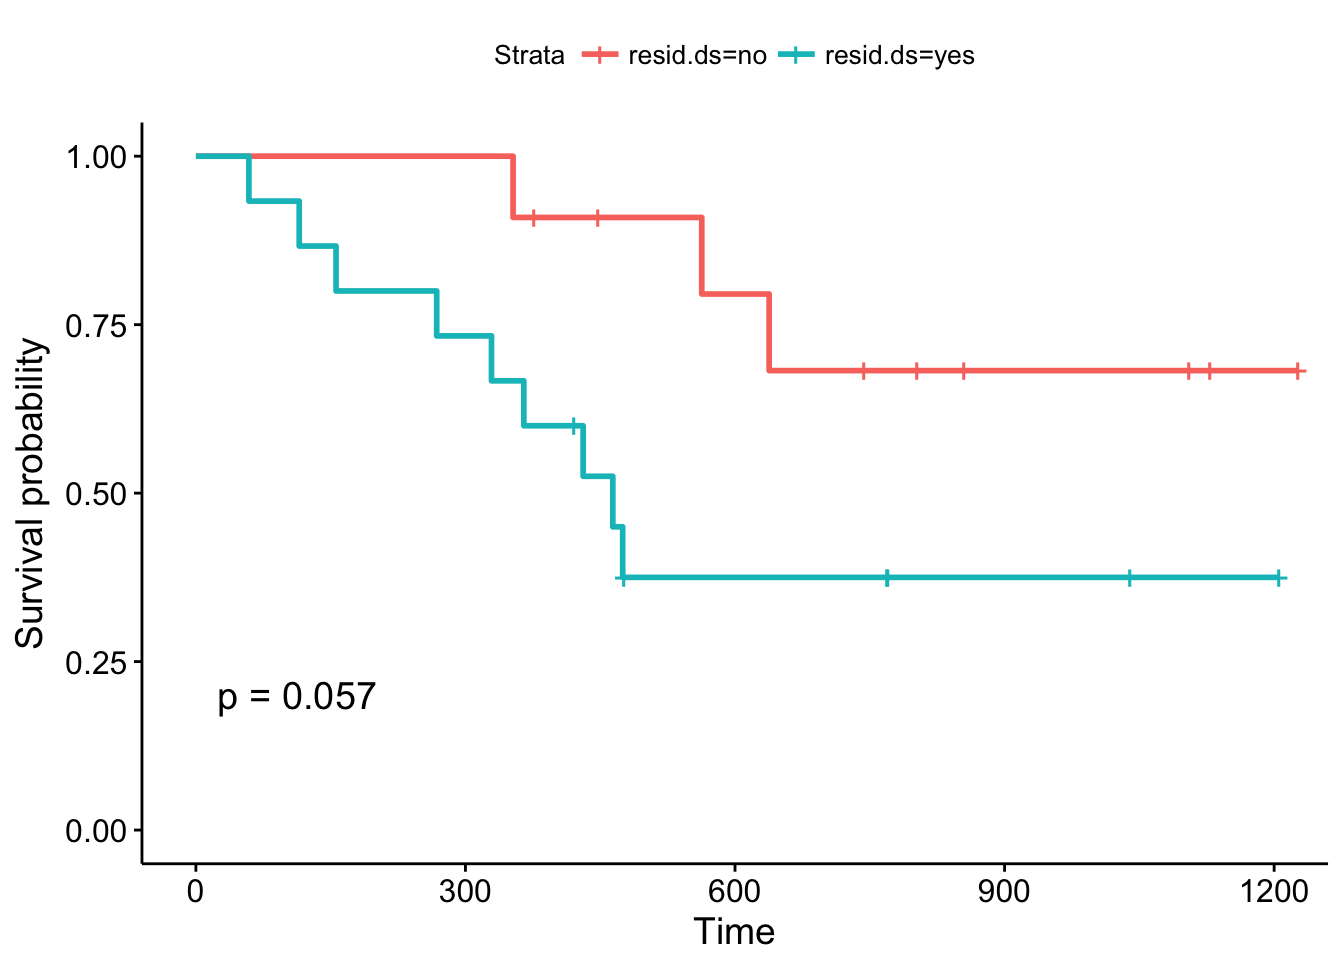
Las curvas de Kaplan-Meier estratificadas por estado de enfermedad residual son algo distintas: divergen pronto y la prueba de log-rank es casi significativa. Podrías argumentar que un estudio de seguimiento con mayor tamaño muestral podría validar estos resultados; es decir, que los pacientes con enfermedad residual positiva presentan un pronóstico significativamente peor que los pacientes sin enfermedad residual.
¿Hay una forma más sistemática de analizar las distintas covariables? Como recordarás, los modelos de riesgos proporcionales de Cox permiten incluir covariables. Puedes construirlos con la función coxph y visualizarlos con ggforest. Este tipo de gráfico se llama forest plot. Muestra los llamados hazard ratios (HR) obtenidos del modelo para todas las covariables incluidas en la fórmula de coxph. En resumen, un HR > 1 indica un mayor riesgo de muerte (según la definición de h(t)) si se cumple una condición específica en el paciente, y un HR < 1 indica un riesgo menor. Veamos la salida del modelo:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)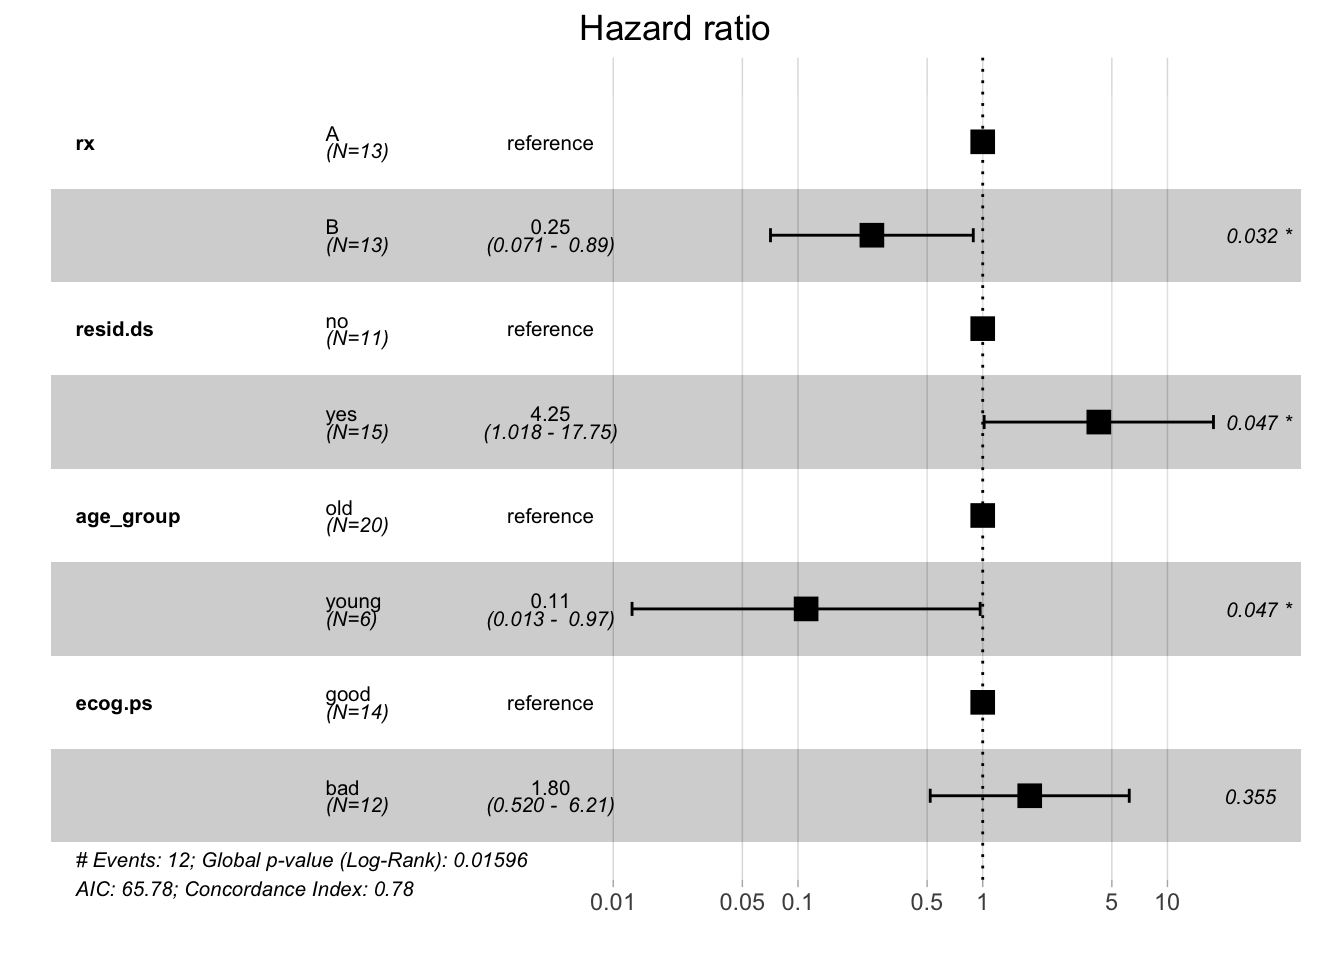
Cada HR representa un riesgo relativo de muerte que compara una modalidad de una característica binaria con la otra. Por ejemplo, un hazard ratio de 0.25 para los grupos de tratamiento indica que los pacientes que recibieron el tratamiento B tienen un riesgo de muerte menor que los que recibieron el A (que actúa como referencia). Como muestra el forest plot, el intervalo de confianza del 95% correspondiente es 0.071 - 0.89 y el resultado es significativo.
Con este modelo, ves que las variables grupo de tratamiento, estado de enfermedad residual y grupo de edad influyen significativamente en el riesgo de muerte de los pacientes de este estudio. Esto difiere de lo observado con el estimador de Kaplan-Meier y la prueba de log-rank. Mientras que el primero estima la probabilidad de supervivencia, el segundo calcula el riesgo de muerte y los hazard ratios. Tu análisis demuestra que los resultados de estos métodos pueden diferir en términos de significación.
Los ejemplos anteriores muestran lo sencillo que es implementar en R los conceptos estadísticos del análisis de supervivencia. En esta introducción has aprendido a construir los modelos, a visualizarlos y también el trasfondo estadístico que ayuda a interpretar los resultados. Esperamos que ahora puedas empezar a aplicar estas técnicas a tus propios datos. ¡Gracias por leer este tutorial!
Echa un vistazo a nuestro tutorial de regresión lineal en R.
Cursos de R
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Łukasz Deryło
10 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
12 min
Tutorial
DataCamp Team
15 min
Tutorial
Francisco Javier Carrera Arias
6 min


