Cursus
Introductie tot R
4 uur
3.1M

Data mining- of machinelearningtechnieken kunnen vaak al in een vroeg stadium van biomedisch onderzoek worden ingezet om grote datasets te analyseren, bijvoorbeeld om kandidaatgenen of voorspellende ziekte-biomarkers in high-throughput-sequencingdata te identificeren. Gegevens uit klinische trials bevatten echter meestal “survival data” die een heel andere analysetaanpak vereisen.
Bij dit type analyse staat de tijd tot een specifieke gebeurtenis, zoals overlijden of terugkeer van de ziekte, centraal en worden twee (of meer) patiëntengroepen met elkaar vergeleken op basis van deze tijd. Drie kernconcepten kunnen worden gebruikt om zinvolle resultaten uit zo'n dataset te halen. Het doel van deze tutorial is om de statistische concepten en hun interpretatie te introduceren, én een realistische toepassing van deze methoden met implementatie in R:
In deze tutorial gebruik je ook de R-pakketten survival en survminer en de ovarian-dataset (Edmunson J.H. et al., 1979) die wordt meegeleverd met het survival-pakket. Later in deze tutorial lees je meer over deze dataset!
Tip: bekijk deze survminer cheatsheet
Na deze tutorial kun je met dit soort data vragen beantwoorden zoals: hebben patiënten baat bij behandelregime A in plaats van B? Beïnvloeden leeftijd en fitheid van patiënten de uitkomst significant? Is restziekte een prognostische biomarker voor overleving?
Voordat je de statistiek induikt, is het handig om wat terminologie te leren:
De term "censoring" verwijst naar onvolledige gegevens. Hoewel er verschillende typen bestaan, kun je je hier beperken tot rechtsgecensureerde gegevens, omdat dit het meest voorkomende type censoring is in survival-datasets.
Voor sommige patiënten weet je dat hij of zij gedurende een bepaalde tijd is gevolgd zonder dat er een “event” plaatsvond, maar je weet misschien niet of de patiënt uiteindelijk heeft overleefd of niet. Dit kan het geval zijn als de patiënt uit follow-up is geraakt of zich uit de studie heeft teruggetrokken. De gegevens van deze specifieke patiënt worden “gecensureerd” na het laatste tijdstip waarop je zeker weet dat de patiënt het gezochte “event” niet heeft meegemaakt. Een event is het vooraf gespecificeerde eindpunt van je studie, bijvoorbeeld overlijden of recidief. Ook alle patiënten die het “event” niet meemaken tot het einde van de studie worden op dat laatste tijdstip gecensureerd.
In feite zijn dit de drie redenen waarom gegevens gecensureerd kunnen zijn.
Het aantal gecensureerde observaties is dus altijd n >= 0. Al deze voorbeelden zijn gevallen van “rechtscensoring”. Je kunt verder classificeren in vaste of willekeurige type I-censoring en type II-censoring, maar deze indelingen zijn vooral relevant vanuit studiedesign en spelen in deze introductietutorial geen rol.
Onthoud ook dat alle vormen van censoring vormen van non-informatie zijn en nooit worden veroorzaakt door het “event” dat het eindpunt van je studie definieert. Dat impliceert ook dat geen van de gecensureerde patiënten in de ovarian-dataset werd gecensureerd omdat de betreffende patiënt overleed.
Hoe ziet een survivalfunctie die de overleving van patiënten in de tijd beschrijft er nu uit?
De Kaplan-Meier-schatting, onafhankelijk beschreven door Edward Kaplan en Paul Meier en gezamenlijk gepubliceerd in 1958 in de Journal of the American Statistical Association, is een niet-parametrische statistiek waarmee we de survivalfunctie kunnen schatten.
Onthoud dat een niet-parametrische statistiek niet uitgaat van een onderliggende kansverdeling, wat logisch is omdat survivaldata scheef verdeeld zijn.
Deze statistiek geeft de kans dat een individuele patiënt een bepaald tijdstip t overleeft. Bij t = 0 is de Kaplan-Meier-schatting 1 en als t naar oneindig gaat, nadert de schatting 0. In theorie is, met een oneindig grote dataset en t gemeten op de seconde, de bijbehorende functie van t versus overlevingskans vloeiend. Straks zie je hoe dat er in de praktijk uitziet.
Verder gaat ze uit van de aanname dat de kans om voorbij een bepaald tijdstip t te overleven gelijk is aan het product van de geobserveerde overlevingskansen tot tijdstip t. Preciezer: S(t) #de overlevingskans op tijd t wordt gegeven door S(t) = p.1 * p.2 * … * p.t, waarbij p.1 het aandeel van alle patiënten is dat het eerste tijdstip overleeft, p.2 het aandeel dat het tweede tijdstip overleeft, enzovoort tot tijdstip t is bereikt.
Belangrijk is dat je, vanaf p.2 tot en met p.t, bij het berekenen van de aandelen voor elk volgend tijdstip alleen die patiënten meeneemt die het vorige tijdstip hebben overleefd; p.2, p.3, …, p.t zijn dus proporties die voorwaardelijk zijn op de voorgaande proporties.
In de praktijk orden je eerst de overlevingstijden in oplopende volgorde. Dit omvat ook de gecensureerde waarden. Vervolgens bereken je de proporties zoals hierboven beschreven en vermenigvuldig je ze om S(t) te krijgen. Gecensureerde patiënten worden na het tijdstip van censoring weggelaten, zodat ze de proportie overlevende patiënten niet beïnvloeden. Voor gedetailleerde informatie over de methode, zie (Swinscow en Campbell, 2002).
Tot slot kun je de log-ranktest gebruiken om survivalcurves van twee groepen te vergelijken. De log-ranktest is een statistische hypothesetoets die de nulhypothese test dat de survivalcurves van twee populaties niet verschillen. Een bepaalde kansverdeling, namelijk de chi-kwadraatverdeling, kan worden gebruikt om een p-waarde te berekenen. Kort gezegd worden p-waarden gebruikt om statistische significantie te kwantificeren. Een resultaat met p < 0.05 wordt meestal als significant beschouwd. In ons geval zou p < 0.05 erop wijzen dat de twee behandelgroepen significant van elkaar verschillen qua overleving.
Een andere nuttige functie bij survivalanalyses is de hazardfunctie h(t). Die beschrijft de kans op een event of de hazard h (hier opnieuw overlijden) als het subject tot dat specifieke tijdstip t heeft overleefd. Ze is wat lastiger te illustreren dan de Kaplan-Meier-schatting, omdat ze het onmiddellijke overlijdensrisico meet. Toch heb je de hazardfunctie nodig om covariaten mee te nemen wanneer je de overleving van patiëntgroepen vergelijkt. Covariaten, in regressieanalyse ook wel verklarende of onafhankelijke variabelen genoemd, zijn variabelen die mogelijk voorspellend zijn voor een uitkomst of waarvoor je wilt corrigeren om interacties tussen variabelen te ondervangen.
Waar de log-ranktest twee Kaplan-Meier-survivalcurves vergelijkt, die bijvoorbeeld kunnen ontstaan door een patiëntpopulatie in behandel-subgroepen op te splitsen, worden Cox-proportionele-hazardsmodellen afgeleid uit de onderliggende baseline-hazardfuncties van de betreffende patiëntpopulaties en een willekeurig aantal gedichotomiseerde covariaten. Opnieuw gaat het niet uit van een onderliggende kansverdeling, maar wél van de aanname dat de hazards van de vergeleken patiëntgroepen in de tijd constant zijn. Daarom heet het een “proportioneel-hazardsmodel”. Straks zie je een voorbeeld dat deze theorie illustreert.
Laten we nu de ovarian-dataset analyseren!
Met deze concepten op zak kun je nu een echte dataset analyseren en proberen enkele van de bovenstaande vragen te beantwoorden. Laten we beginnen met het laden van de twee pakketten die nodig zijn voor de analyses en het dplyr-pakket met handige functies voor het werken met data frames.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Tip: vergeet niet om install.packages() te gebruiken om pakketten te installeren die nog ontbreken in je workspace!
De volgende stap is het laden van de dataset en het bekijken van de structuur. Zoals je aan het begin van deze tutorial las, werk je met de ovarian-dataset. Deze dataset omvat een cohort eierstokkankerpatiënten en bijbehorende klinische informatie, waaronder de tijd waarin patiënten werden gevolgd tot ze overleden of uit follow-up raakten (futime), of patiënten al dan niet zijn gecensureerd (fustat), leeftijd van de patiënt, toewijzing aan behandelgroep, aanwezigheid van restziekte en performance status.
Zoals je al ziet, zijn sommige variabelenamen wat cryptisch; raadpleeg eventueel de helppagina.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
De kolom futime bevat de overlevingstijden. Dit is de responsvariabele. fustat geeft aan of de overlevingstijd van een individuele patiënt is gecensureerd. Blijkbaar kregen de 26 patiënten in deze studie één van twee behandelregimes (rx) en beoordeelde de behandelend arts op enig moment de tumorreductie (resid.ds) en de performance van de patiënt (volgens de gestandaardiseerde ECOG-criteria; ecog.ps).
Daarnaast krijg je informatie over de leeftijd van de patiënten en als je die uiteindelijk als voorspellende variabele wilt opnemen, moet je continue waarden dichotomiseren naar binaire waarden. Maar welke afkapwaarde kies je dan? Laten we naar de totale verdeling van de leeftijden kijken:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 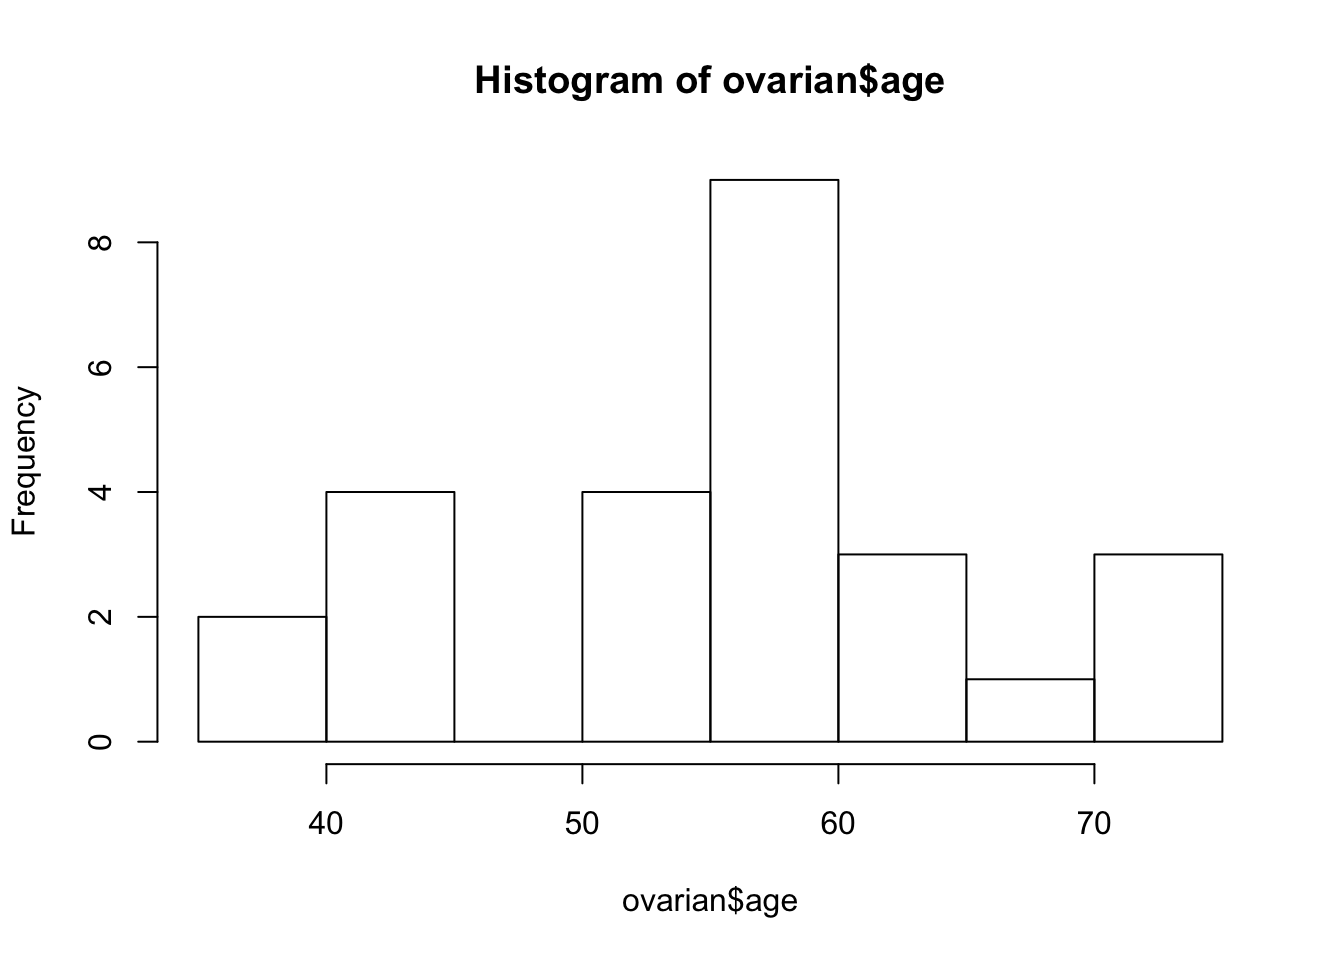
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
De duidelijk bimodale verdeling suggereert een afkapwaarde van 50 jaar. Met de functie mutate voeg je een extra kolom age_group toe aan het data frame, die later van pas komt. Ook is het goed om de toekomstige covariaten om te zetten naar factoren.
Nu kun je een survivalobject aanmaken. Dat is in feite een gebundelde versie van de kolommen futime en fustat die door de functie survfit kan worden geïnterpreteerd. Een + achter overlevingstijden duidt op gecensureerde datapunten.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
De volgende stap is het fitten van de Kaplan-Meier-curves. Dat kan eenvoudig door het surv_object door te geven aan de functie survfit. Je kunt de curve ook stratificeren op basis van het behandelregime rx waaraan patiënten zijn toegewezen. Een summary() van het resulterende fit1-object toont onder meer overlevingstijden, het aandeel overlevende patiënten op elk tijdstip, oftewel je p.1, p.2, ... van hierboven, en de behandelgroepen.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Je kunt de bijbehorende survivalcurve bekijken door het survivalobject door te geven aan de functie ggsurvplot. Het argument pval = TRUE is erg handig, omdat het ook de p-waarde van een log-ranktest weergeeft!
ggsurvplot(fit1, data = ovarian, pval = TRUE)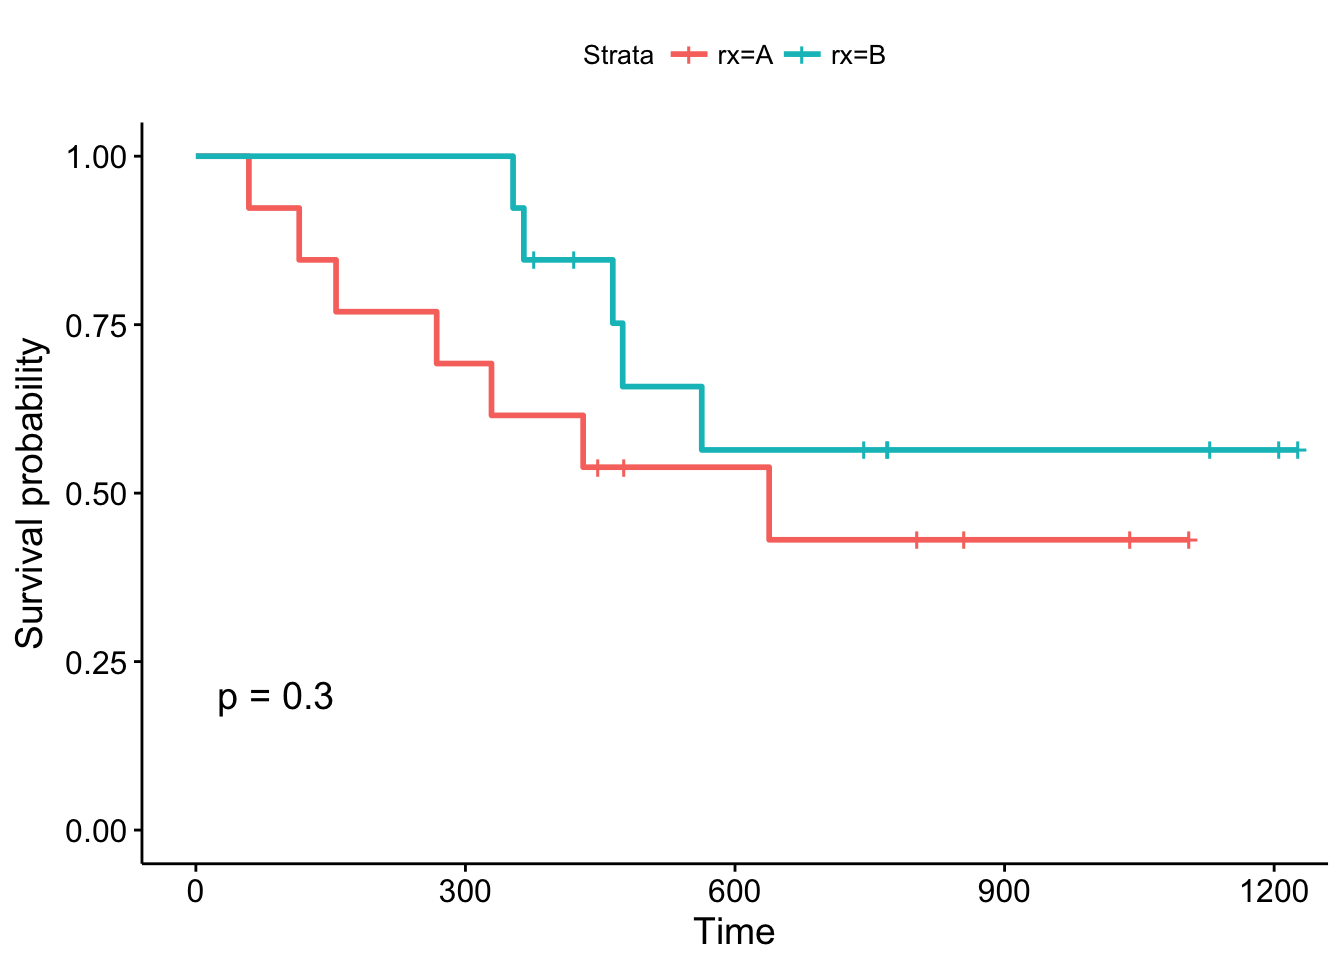
Conform de conventie geven verticale lijntjes gecensureerde data aan; hun bijbehorende x-waarde is het tijdstip waarop censoring plaatsvond.
De log-rank p-waarde van 0,3 wijst op een niet-significant resultaat als je p < 0.05 als significant beschouwt. In deze studie was geen van de onderzochte behandelingen significant superieur, hoewel patiënten die behandeling B kregen het in de eerste maand van follow-up beter doen. Hoe zit het met de andere variabelen?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)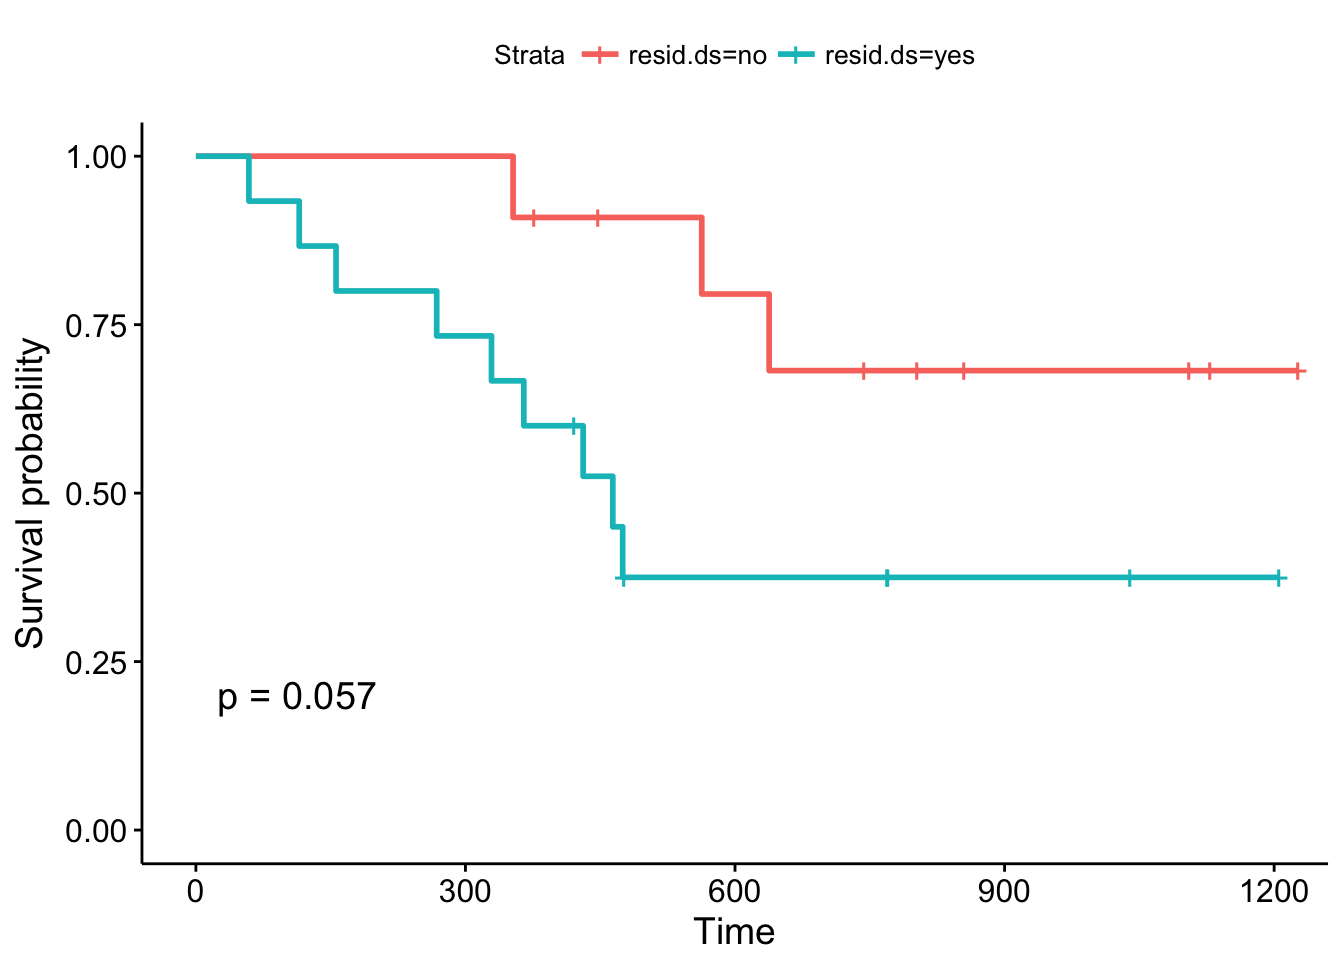
De Kaplan-Meier-plots, gestratificeerd naar restziektestatus, zien er wat anders uit: de curves lopen vroeg uiteen en de log-ranktest is bijna significant. Je zou kunnen beargumenteren dat een vervolgstudie met een grotere steekproef deze resultaten kan bevestigen, namelijk dat patiënten met een positieve restziektestatus een significant slechtere prognose hebben dan patiënten zonder restziekte.
Maar is er een systematischer manier om naar de verschillende covariaten te kijken? Zoals je je herinnert uit een eerdere passage, laten Cox-proportionele-hazardsmodellen je covariaten opnemen. Je bouwt zulke modellen met de functie coxph en visualiseert ze met ggforest. Dit type plot heet een forestplot. Hij toont zogenoemde hazard ratio's (HR) die uit het model worden afgeleid voor alle covariaten die we in de formule in coxph hebben opgenomen. Kort gezegd duidt een HR > 1 op een verhoogd overlijdensrisico (volgens de definitie van h(t)) als een patiënt aan een specifieke voorwaarde voldoet. Een HR < 1 duidt daarentegen op een verlaagd risico. Laten we naar de modeloutput kijken:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)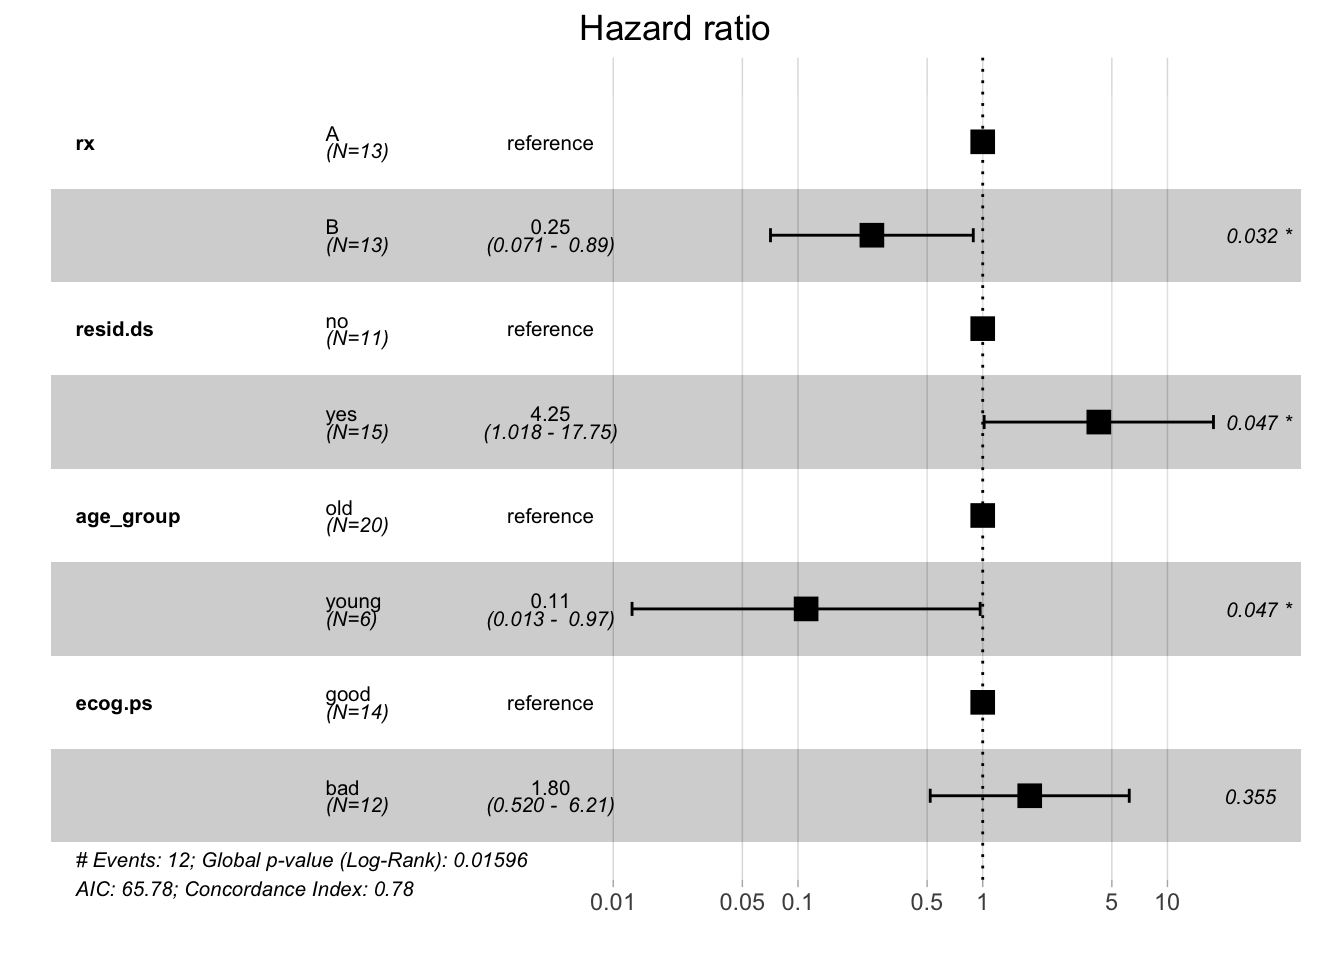
Elke HR vertegenwoordigt een relatief overlijdensrisico dat één waarde van een binaire eigenschap vergelijkt met de andere waarde. Een hazard ratio van 0,25 voor behandelgroepen vertelt bijvoorbeeld dat patiënten die behandeling B kregen een lager risico hebben om te overlijden dan patiënten die behandeling A kregen (die als referentie diende om de hazard ratio te berekenen). Zoals de forestplot laat zien, is het bijbehorende 95%-betrouwbaarheidsinterval 0,071 - 0,89 en dit resultaat is significant.
Met dit model zie je dat de behandelgroep, restziektestatus en leeftijdsgroep het overlijdensrisico van patiënten in deze studie significant beïnvloeden. Dat wijkt best af van wat je zag met de Kaplan-Meier-schatting en de log-ranktest. Waar de eerste de overlevingskans schat, berekent de tweede het overlijdensrisico en bijbehorende hazard ratio's. Je analyse laat zien dat de significantie van de resultaten van deze methoden kan verschillen.
De bovenstaande voorbeelden laten zien hoe eenvoudig het is om de statistische concepten van survival analysis in R te implementeren. In deze introductie heb je geleerd hoe je de bijbehorende modellen bouwt, hoe je ze visualiseert, en ook wat statistische achtergrond die helpt de resultaten van je analyses te begrijpen. Hopelijk kun je deze technieken nu toepassen op je eigen datasets. Bedankt voor het lezen!
Bekijk ook onze Linear Regression in R Tutorial.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

