Corso
Introduzione a R
4 ore
3.1M

Le tecniche di data mining o di machine learning possono spesso essere sfruttate nelle fasi iniziali della ricerca biomedica per analizzare grandi dataset, ad esempio per aiutare a identificare geni candidati o biomarcatori predittivi di malattia in dataset di sequenziamento ad alta processività. Tuttavia, i dati degli studi clinici includono di solito “dati di sopravvivenza” che richiedono un approccio di analisi piuttosto diverso.
In questo tipo di analisi, interessa il tempo fino a un evento specifico, come la morte o la recidiva della malattia, e si confrontano due (o più) gruppi di pazienti rispetto a questo tempo. Tre concetti fondamentali possono essere usati per ricavare risultati significativi da un dataset del genere e l’obiettivo di questo tutorial è introdurre i concetti statistici, la loro interpretazione e un’applicazione reale di questi metodi insieme alla loro implementazione in R:
In questo tutorial userai anche i pacchetti R survival e survminer e il dataset ovarian (Edmunson J.H. et al., 1979) incluso nel pacchetto survival. Più avanti in questo tutorial leggerai di più su questo dataset!
Consiglio: dai un’occhiata a questa cheat sheet di survminer
Dopo questo tutorial, sarai in grado di sfruttare questi dati per rispondere a domande come: i pazienti traggono beneficio dal regime terapeutico A rispetto al regime B? Età e condizioni fisiche dei pazienti influenzano significativamente l’esito? La malattia residua è un biomarcatore prognostico in termini di sopravvivenza?
Prima di entrare nel dettaglio della statistica, può essere utile imparare alcune definizioni:
Il termine "censoring" (censura) si riferisce a dati incompleti. Sebbene esistano diversi tipi, a questo punto potresti voler limitarti ai dati con censura a destra, poiché è il tipo più comune nei dataset di sopravvivenza.
Per alcuni pazienti potresti sapere che sono stati seguiti per un certo periodo senza che si verificasse un “evento”, ma potresti non sapere se alla fine il paziente sia sopravvissuto o meno. Ciò può accadere se il paziente è perso al follow-up oppure si è ritirato dallo studio. I dati relativi a quel particolare paziente verranno “censurati” dopo l’ultimo momento in cui sai con certezza che il paziente non ha sperimentato l’“evento” che stai osservando. Un evento è l’endpoint predefinito dello studio, per esempio la morte o la recidiva della malattia. Inoltre, tutti i pazienti che non sperimentano l’“evento” fino alla fine dello studio saranno censurati a quell’ultimo momento.
In sostanza, questi sono i tre motivi per cui i dati potrebbero essere censurati.
Di conseguenza, il numero di osservazioni censurate è sempre n >= 0. Tutti questi esempi sono casi di “censura a destra” e si possono ulteriormente classificare in censura di tipo I fissa o casuale e censura di tipo II, ma queste classificazioni sono rilevanti soprattutto in ottica di disegno dello studio e non ti riguarderanno in questo tutorial introduttivo.
Una cosa da tenere a mente è che tutti i tipi di censura rappresentano mancanza di informazione e la censura non è mai causata dall’“evento” che definisce l’endpoint dello studio. Questo implica anche che nessuno dei pazienti censurati nel dataset ovarian è stato censurato perché il rispettivo paziente è deceduto.
Come si presenta una funzione di sopravvivenza che descrive la sopravvivenza dei pazienti nel tempo?
L’estimatore di Kaplan-Meier, descritto indipendentemente da Edward Kaplan e Paul Meier e pubblicato congiuntamente nel 1958 sul Journal of the American Statistical Association, è una statistica non parametrica che consente di stimare la funzione di sopravvivenza.
Ricorda che una statistica non parametrica non si basa sull’assunzione di una distribuzione di probabilità sottostante, il che ha senso poiché i dati di sopravvivenza hanno una distribuzione asimmetrica.
Questa statistica fornisce la probabilità che un singolo paziente sopravviva oltre un certo tempo t. A t = 0, l’estimatore di Kaplan-Meier vale 1 e, per t che tende all’infinito, l’estimatore tende a 0. In teoria, con un dataset infinitamente grande e t misurato al secondo, la funzione corrispondente di t rispetto alla probabilità di sopravvivenza è liscia. Più avanti vedrai come appare in pratica.
Si basa inoltre sull’assunzione che la probabilità di sopravvivere oltre un certo tempo t sia pari al prodotto dei tassi di sopravvivenza osservati fino al tempo t. Più precisamente, S(t) #la probabilità di sopravvivenza al tempo t è data da S(t) = p.1 * p.2 * … * p.t, con p.1 proporzione di tutti i pazienti che sopravvivono oltre il primo tempo, p.2 proporzione di pazienti che sopravvivono oltre il secondo tempo, e così via fino al tempo t.
È importante notare che, a partire da p.2 e fino a p.t, quando calcoli le proporzioni per ogni tempo successivo consideri solo i pazienti che sono sopravvissuti oltre il tempo precedente; dunque p.2, p.3, …, p.t sono proporzioni condizionate sulle proporzioni precedenti.
In pratica, per prima cosa conviene ordinare i tempi di sopravvivenza in ordine crescente, inclusi i valori censurati. Poi calcoli le proporzioni come descritto sopra e le moltiplichi per ricavare S(t). I pazienti censurati vengono omessi dopo il momento della censura, quindi non influenzano la proporzione di pazienti sopravviventi. Per informazioni dettagliate sul metodo, vedi (Swinscow e Campbell, 2002).
Infine, puoi utilizzare il test log-rank per confrontare le curve di sopravvivenza di due gruppi. Il test log-rank è un test di ipotesi statistico che verifica l’ipotesi nulla secondo cui le curve di sopravvivenza di due popolazioni non differiscono. Una certa distribuzione di probabilità, ossia la distribuzione chi-quadro, può essere usata per ricavare un p-value. In breve, i p-value sono usati nei test di ipotesi per quantificare la significatività statistica. Un risultato con p < 0.05 è di solito considerato significativo. Nel nostro caso, p < 0.05 indicherebbe che i due gruppi di trattamento sono significativamente diversi in termini di sopravvivenza.
Un’altra funzione utile nel contesto delle analisi di sopravvivenza è la funzione di rischio h(t). Descrive la probabilità di un evento, o il suo rischio h (anche qui, la morte), dato che il soggetto è sopravvissuto fino a quel particolare istante t. È un po’ più difficile da illustrare rispetto all’estimatore di Kaplan-Meier perché misura il rischio istantaneo di morte. Ciononostante, hai bisogno della funzione di rischio per considerare le covariate quando confronti la sopravvivenza di gruppi di pazienti. Le covariate, dette anche variabili esplicative o indipendenti nell’analisi di regressione, sono variabili potenzialmente predittive di un esito o che potresti voler controllare per tenere conto delle interazioni tra variabili.
Mentre il test log-rank confronta due curve di sopravvivenza di Kaplan-Meier, che possono essere derivate suddividendo una popolazione di pazienti in sottogruppi di trattamento, i modelli di Cox a rischi proporzionali sono derivati dalle funzioni di rischio di base sottostanti delle popolazioni di pazienti in esame e da un numero arbitrario di covariate dicotomizzate. Anche qui non si assume una distribuzione di probabilità sottostante, ma si assume che i rischi dei gruppi di pazienti che confronti siano costanti nel tempo. Per questo si chiama “modello a rischi proporzionali”. Più avanti vedrai un esempio che illustra queste considerazioni teoriche.
Ora proviamo ad analizzare il dataset ovarian!
Con questi concetti alla mano, puoi iniziare ad analizzare un dataset reale e provare a rispondere ad alcune delle domande di cui sopra. Cominciamo caricando i due pacchetti necessari per le analisi e il pacchetto dplyr, che include funzioni utili per la gestione dei data frame.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Consiglio: non dimenticare di usare install.packages() per installare eventuali pacchetti che mancano nel tuo workspace!
Il passo successivo è caricare il dataset ed esaminarne la struttura. Come hai letto all’inizio del tutorial, lavorerai con il set di dati ovarian. Questo dataset comprende una coorte di pazienti con carcinoma ovarico e le rispettive informazioni cliniche, incluso il tempo di osservazione fino a morte o perdita al follow-up (futime), se i pazienti sono stati censurati o meno (fustat), età del paziente, assegnazione al gruppo di trattamento, presenza di malattia residua e performance status.
Come puoi già vedere, i nomi di alcune variabili sono un po’ criptici: potresti voler consultare anche la pagina di help.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
La colonna futime contiene i tempi di sopravvivenza. Questa è la variabile risposta. fustat, invece, indica se il tempo di sopravvivenza del singolo paziente è censurato. A quanto pare, i 26 pazienti in questo studio hanno ricevuto uno di due regimi terapeutici (rx) e il medico curante ha valutato la regressione dei tumori (resid.ds) e le condizioni dei pazienti (secondo i criteri ECOG standardizzati; ecog.ps) in un certo momento.
Inoltre, ottieni informazioni sull’età dei pazienti e, se vuoi includerla come variabile predittiva, dovrai dicotomizzare i valori continui in valori binari. Ma quale cutoff dovresti scegliere? Guardiamo la distribuzione complessiva dei valori di età:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 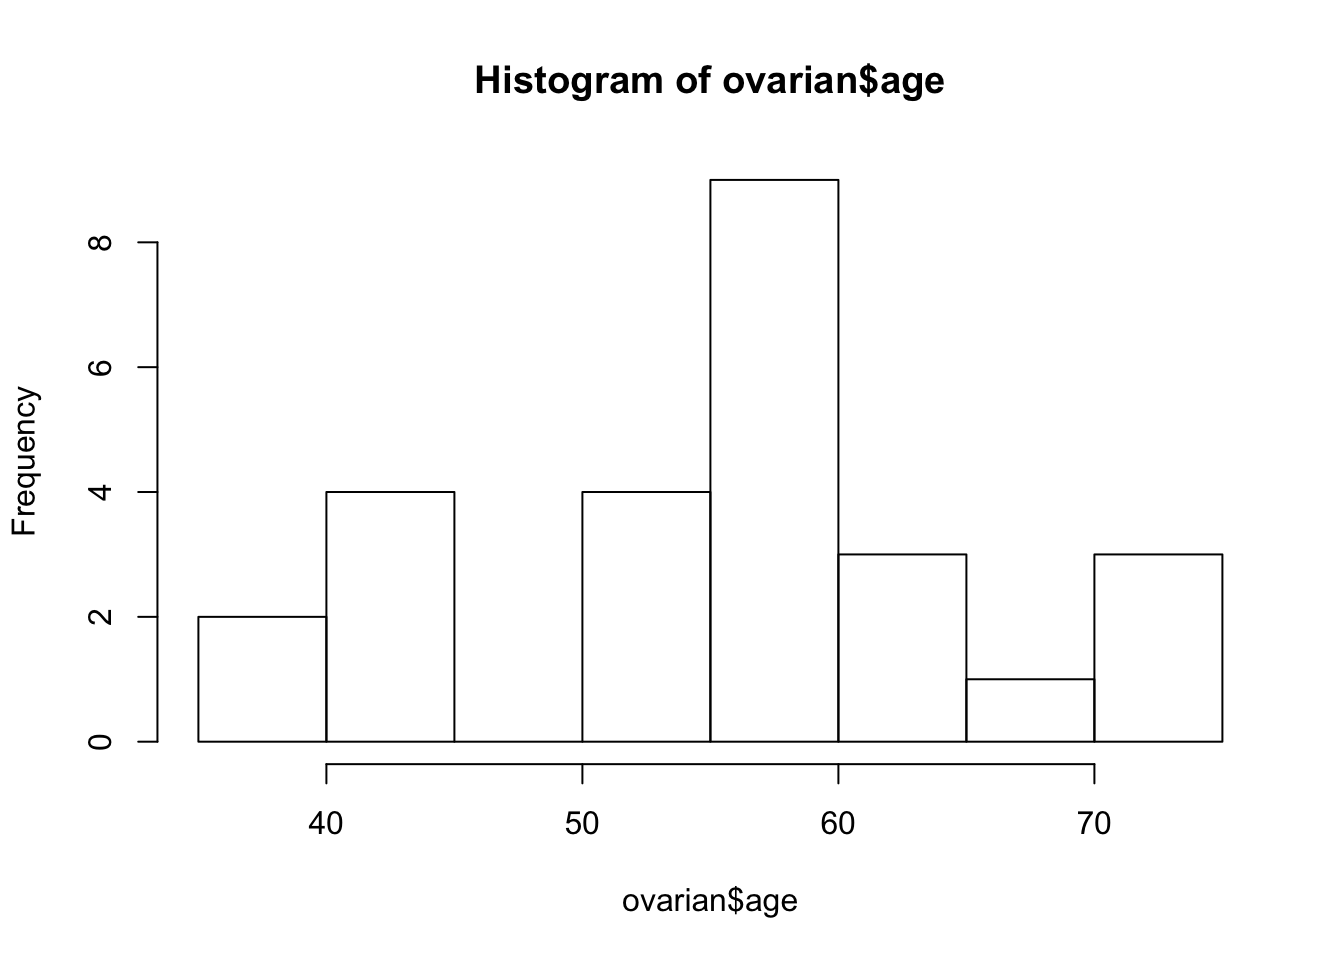
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
L’evidente distribuzione bimodale suggerisce un cutoff di 50 anni. Puoi usare la funzione mutate per aggiungere al data frame una colonna aggiuntiva age_group che tornerà utile più avanti. Inoltre, dovresti convertire in fattori le covariate che userai.
Ora sei pronto per creare un oggetto di sopravvivenza. In pratica è una versione composta delle colonne futime e fustat interpretabile dalla funzione survfit. Un + dietro ai tempi di sopravvivenza indica i punti dati censurati.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
Il passo successivo è adattare le curve di Kaplan-Meier. Puoi farlo facilmente passando surv_object alla funzione survfit. Puoi anche stratificare la curva in base al regime di trattamento rx assegnato ai pazienti. Un summary() dell’oggetto fit1 risultante mostra, tra le altre cose, i tempi di sopravvivenza, la proporzione di pazienti sopravviventi a ogni istante, cioè i tuoi p.1, p.2, ... di cui sopra, e i gruppi di trattamento.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Puoi esaminare la curva di sopravvivenza corrispondente passando l’oggetto di sopravvivenza alla funzione ggsurvplot. L’argomento pval = TRUE è molto utile, perché traccia anche il p-value del test log-rank!
ggsurvplot(fit1, data = ovarian, pval = TRUE)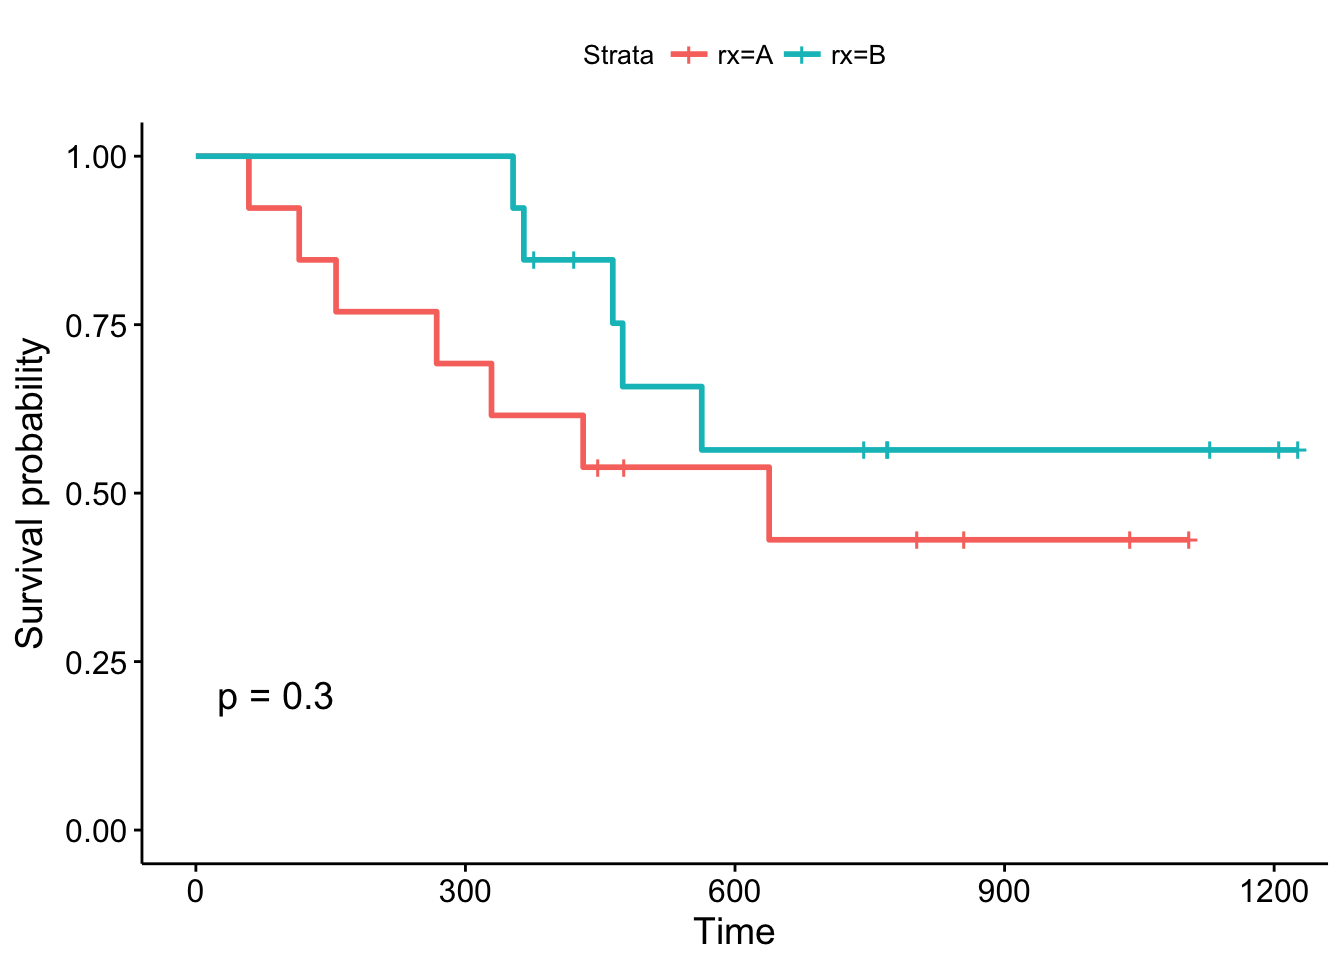
Per convenzione, le linee verticali indicano i dati censurati, e i corrispondenti valori di x il momento in cui è avvenuta la censura.
Il p-value log-rank di 0,3 indica un risultato non significativo se consideri p < 0.05 come soglia di significatività statistica. In questo studio, nessuno dei trattamenti esaminati è risultato significativamente superiore, sebbene i pazienti che ricevono il trattamento B stiano meglio nel primo mese di follow-up. E le altre variabili?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)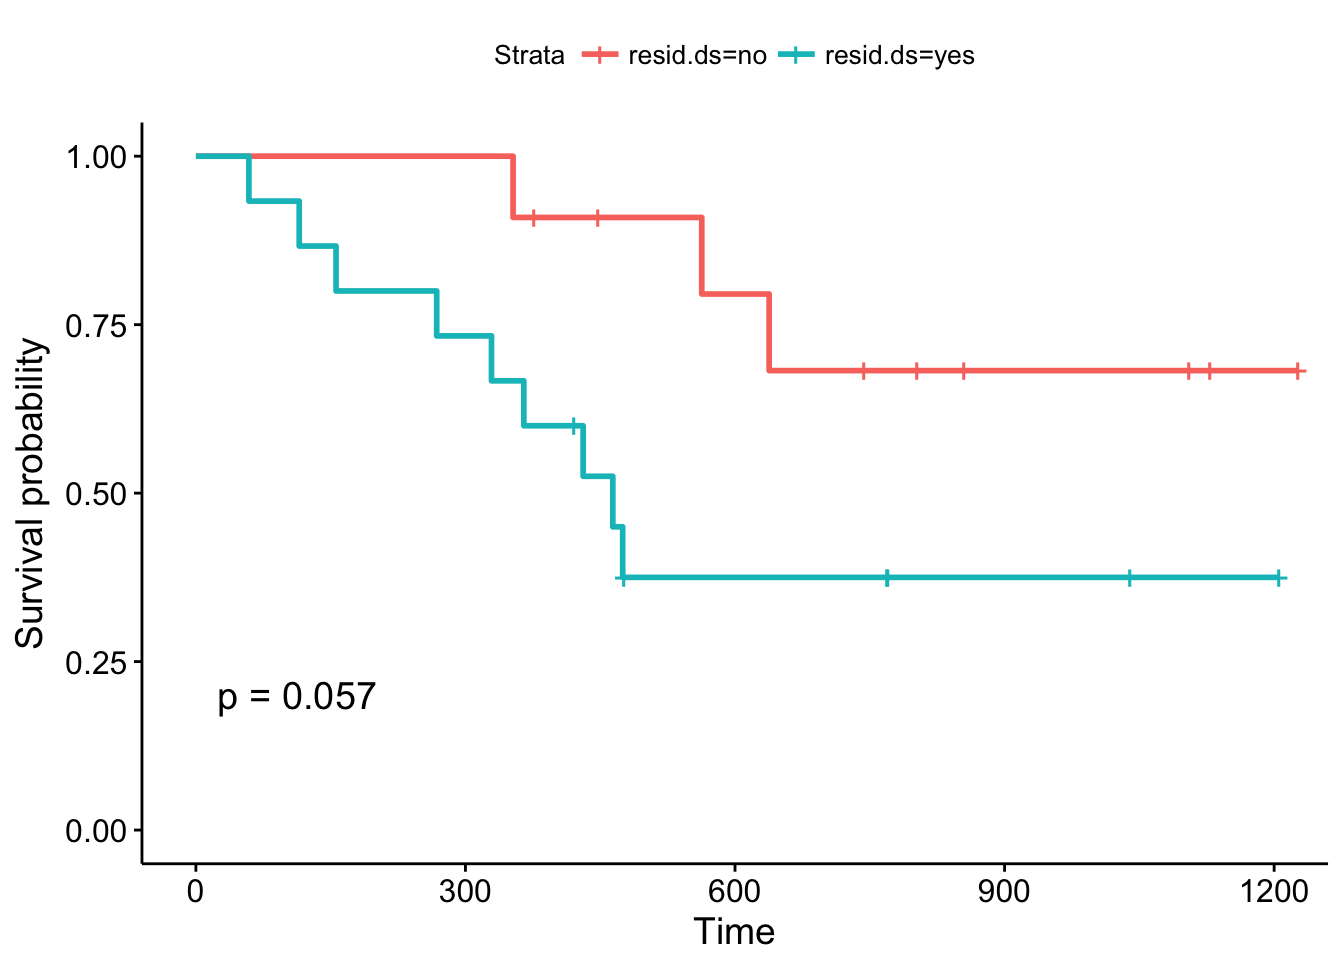
I grafici di Kaplan-Meier stratificati in base allo stato di malattia residua appaiono un po’ diversi: le curve divergono precocemente e il test log-rank è quasi significativo. Potresti sostenere che uno studio di follow-up con dimensione campionaria maggiore potrebbe convalidare questi risultati, ossia che i pazienti con malattia residua positiva hanno una prognosi significativamente peggiore rispetto ai pazienti senza malattia residua.
Ma esiste un modo più sistematico per esaminare le diverse covariate? Come forse ricordi da uno dei passaggi precedenti, i modelli a rischi proporzionali di Cox consentono di includere covariate. Puoi costruire modelli di Cox usando la funzione coxph e visualizzarli con ggforest. Questo tipo di grafico si chiama forest plot. Mostra i cosiddetti hazard ratio (HR) ricavati dal modello per tutte le covariate che abbiamo incluso nella formula in coxph. In breve, un HR > 1 indica un aumento del rischio di morte (secondo la definizione di h(t)) se un paziente soddisfa una specifica condizione. Un HR < 1, invece, indica una diminuzione del rischio. Vediamo l’output del modello:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)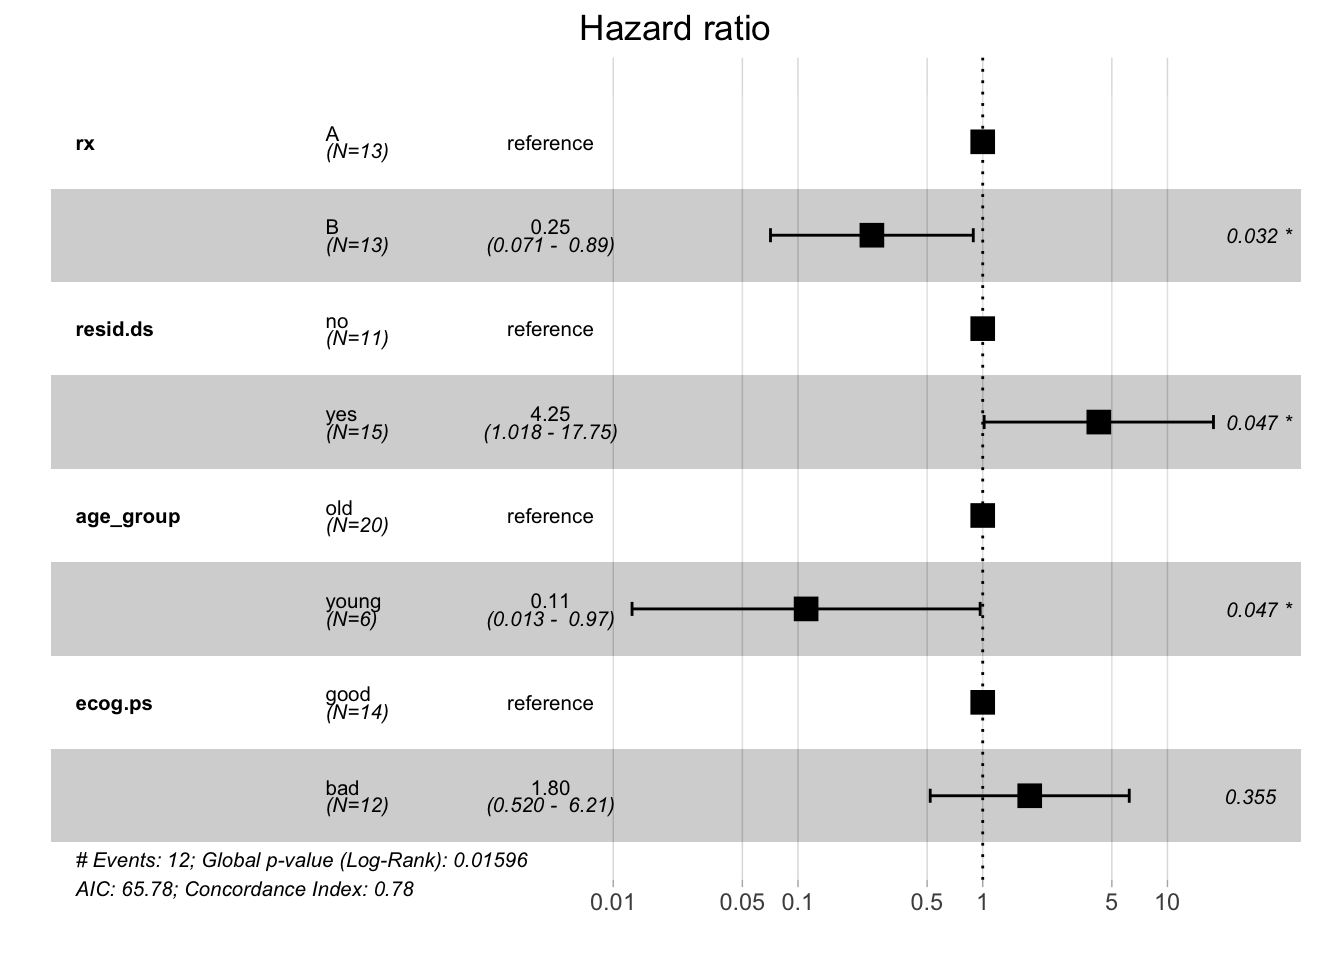
Ogni HR rappresenta un rischio relativo di morte che confronta un’istanza di una caratteristica binaria con l’altra istanza. Per esempio, un hazard ratio di 0,25 per i gruppi di trattamento indica che i pazienti che hanno ricevuto il trattamento B hanno un rischio ridotto di morte rispetto ai pazienti che hanno ricevuto il trattamento A (usato come riferimento per calcolare l’hazard ratio). Come mostrato nel forest plot, il corrispondente intervallo di confidenza al 95% è 0,071 - 0,89 e questo risultato è significativo.
Usando questo modello, puoi vedere che il gruppo di trattamento, lo stato di malattia residua e il gruppo di età influenzano significativamente il rischio di morte dei pazienti in questo studio. Questo è piuttosto diverso da quanto visto con l’estimatore di Kaplan-Meier e il test log-rank. Mentre il primo stima la probabilità di sopravvivenza, il secondo calcola il rischio di morte e i relativi hazard ratio. La tua analisi mostra che i risultati forniti da questi metodi possono differire in termini di significatività.
Gli esempi sopra mostrano quanto sia semplice implementare in R i concetti statistici dell’analisi di sopravvivenza. In questa introduzione hai imparato a costruire i relativi modelli, a visualizzarli e anche alcune nozioni statistiche di base che aiutano a comprendere i risultati delle analisi. Speriamo che ora tu possa iniziare a utilizzare queste tecniche per analizzare i tuoi dataset. Grazie per aver letto questo tutorial!
Dai un’occhiata al nostro tutorial sulla Regressione Lineare in R.
Corsi su R
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



