Saat bekerja dengan data dunia nyata, sering kali ukuran sampel kecil atau varians populasi tidak diketahui. Ini adalah kondisi di mana teknik statistik tradisional yang berbasis pada distribusi normal mungkin tidak berlaku. Di sinilah distribusi t, juga dikenal sebagai Student’s t-distribution, menjadi berguna. Ini adalah alat yang ampuh untuk membuat inferensi statistik yang andal saat data terbatas atau ketidakpastian tinggi.
Dalam artikel ini, kita akan mempelajari apa itu distribusi t, bagaimana perbandingannya dengan distribusi serupa, properti matematis utamanya, dan bagaimana penggunaannya dalam praktik, khususnya dalam pengujian hipotesis dan interval kepercayaan. Saya juga menyertakan tabel distribusi t di akhir sebagai rujukan cepat.
Apa Itu Distribusi T?
Sama seperti distribusi normal, distribusi t juga simetris dan berbentuk lonceng. Namun, distribusi ini memiliki ekor yang lebih tebal yang mencerminkan ketidakpastian lebih besar yang sering muncul pada ukuran sampel yang lebih kecil.
Selain itu, ada faktor kunci lain yang membedakan distribusi t: distribusi ini didefinisikan oleh derajat kebebasan (degrees of freedom, df). Nilai df ini dihitung sebagai ukuran sampel dikurangi satu (n − 1) dan memengaruhi bentuk distribusi.
Seiring bertambahnya derajat kebebasan, distribusi t menjadi semakin mirip dengan distribusi normal. Ketika ukuran sampel besar (misalnya, n > 30), perbedaannya menjadi sangat kecil sehingga distribusi t mulai menyerupai kurva normal baku.
Distribusi T vs. Distribusi Serupa Lainnya
Akan membantu jika kita membandingkan distribusi t dengan distribusi lain yang serupa.
Distribusi t vs. distribusi normal
Walau kita telah menyebutkan bahwa keduanya berbentuk lonceng, dengan distribusi t memiliki ekor yang lebih tebal dan lebih cocok untuk sampel kecil serta varians populasi yang tidak diketahui, sangat penting untuk menyoroti toleransinya terhadap pencilan.
|
Fitur |
Distribusi t |
Distribusi normal |
|
Bentuk |
Berlonceng, ekor lebih tebal |
Berlonceng, ekor lebih tipis |
|
Kasus Penggunaan |
Sampel kecil, σ tidak diketahui |
Sampel besar, σ diketahui |
|
Derajat Kebebasan |
Diperlukan |
Tidak berlaku |
|
Sensitivitas terhadap Pencilan |
Lebih toleran |
Kurang toleran |
Untuk sampel yang lebih besar, teorema limit pusat membenarkan penggunaan distribusi normal, karena rerata sampel cenderung mengikuti distribusi normal tanpa memedulikan bentuk populasi.
Distribusi t vs. distribusi Z
Distribusi Z merujuk pada distribusi normal baku, yang memiliki rerata 0 dan simpangan baku 1.
|
Fitur |
Distribusi t |
Distribusi Z |
|
Varians Diketahui? |
Tidak |
Ya |
|
Ketebalan Ekor |
Lebih tebal |
Lebih tipis |
|
Uji Umum |
Uji t |
Uji Z |
|
Dipakai untuk Sampel Kecil |
Ya |
Tidak |
Mari pahami ini dengan contoh kode Python:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t, norm

# X-axis range
x = np.linspace(-5, 5, 1000)

# Standard Normal (Z) Distribution
z_dist = norm.pdf(x)

# Plotting
plt.figure(figsize=(10, 6))
plt.plot(x, z_dist, label='Z-Distribution (Standard Normal)', color='black', linewidth=2)

# T-Distributions with different degrees of freedom
dfs = [1, 3, 5, 10, 30]
colors = ['red', 'orange', 'green', 'blue', 'purple']

for df, color in zip(dfs, colors):
    t_dist = t.pdf(x, df)
    plt.plot(x, t_dist, label=f'T-Distribution (df={df})', color=color, linestyle='--')

plt.title('T-Distribution vs Z-Distribution: Heavier Tails for Smaller Sample Sizes')
plt.xlabel('x')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()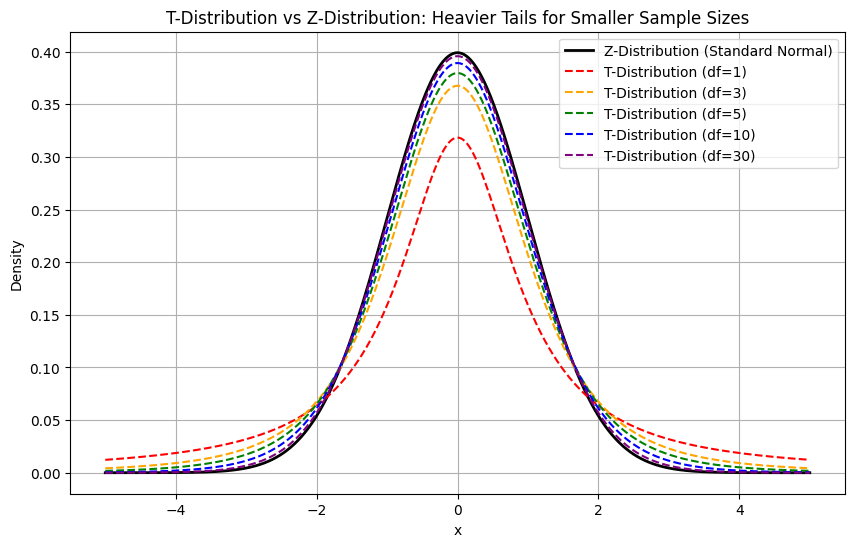
Kasus Khusus dan Distribusi Terkait
Distribusi t berkaitan erat dengan beberapa distribusi probabilitas lainnya:
- Distribusi normal baku (saat df → ∞): Distribusi t berkonvergensi ke distribusi normal seiring meningkatnya derajat kebebasan.
- Distribusi Cauchy (df = 1): Distribusi t dengan 1 derajat kebebasan setara dengan distribusi Cauchy, yang dikenal memiliki rerata dan varians yang tidak terdefinisi, sehingga secara praktis distribusi t dengan satu derajat kebebasan jarang digunakan.
- Distribusi F: Kuadrat dari peubah berdistrbusi t dengan derajat kebebasan ν mengikuti distribusi F dengan derajat kebebasan (1, ν).
- Distribusi t non-sentral: Digunakan dalam analisis daya dan aplikasi statistik lanjut, versi ini memasukkan parameter non-sentralitas, yang muncul ketika hipotesis nol tidak benar.
Keterbatasan Distribusi T
Distribusi t mengasumsikan data dasar berdistribusi mendekati normal. Dalam kasus data yang sangat miring atau tidak normal, distribusi ini mungkin tidak sesuai. Teknik statistik robust atau metode nonparametrik mungkin lebih tepat untuk skenario tersebut.
Sekarang mari bandingkan bagaimana uji t berperilaku pada data normal versus data miring, keduanya memiliki rerata yang sama.
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate data
normal_data = np.random.normal(loc=0, scale=1, size=30)
skewed_data = np.random.exponential(scale=1.0, size=30) - 1  # Shift to mean ≈ 0

# Perform one-sample t-tests (test if mean == 0)
t_stat_normal, p_normal = stats.ttest_1samp(normal_data, popmean=0)
t_stat_skewed, p_skewed = stats.ttest_1samp(skewed_data, popmean=0)

# Plot histograms
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.hist(normal_data, bins=15, color='skyblue', edgecolor='black')
plt.title(f'Normal Data\np-value = {p_normal:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.subplot(1, 2, 2)
plt.hist(skewed_data, bins=15, color='salmon', edgecolor='black')
plt.title(f'Skewed Data\np-value = {p_skewed:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.suptitle("Impact of Data Shape on t-test")
plt.tight_layout()
plt.show()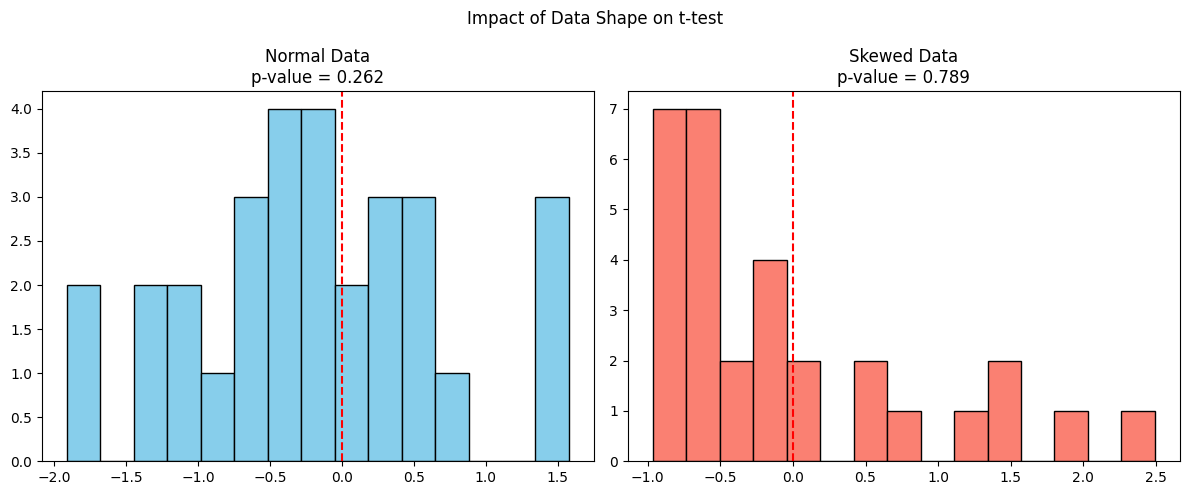
Plot kiri menampilkan data dari distribusi normal di mana uji t valid, dan nilai p dapat dipercaya. Sementara itu, plot kanan menampilkan data miring dari distribusi eksponensial; meskipun rerata sampel mungkin serupa, uji t mengasumsikan simetri dan tidak memperhitungkan kemencengan, sehingga berpotensi menghasilkan nilai p yang tidak akurat.
Properti Matematis Distribusi T
Distribusi t didefinisikan sebagai:
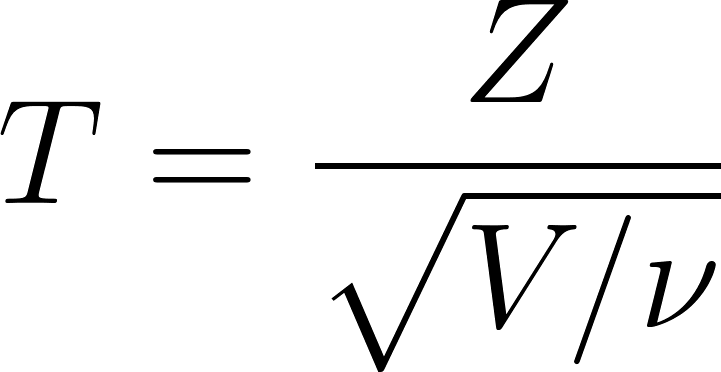
Di mana:
- T adalah nilai hasil yang mengikuti Student’s t-distribution dengan derajat kebebasan ν
- Z adalah peubah acak normal baku Z∼N(0,1)
- V adalah peubah acak yang berdistrbusi chi-kuadrat dengan derajat kebebasan ν, V∼χ2(ν)
- v adalah parameter derajat kebebasan, sering kali sama dengan n−1, di mana adalah ukuran sampel.
Fungsi kerapatan peluang (PDF)
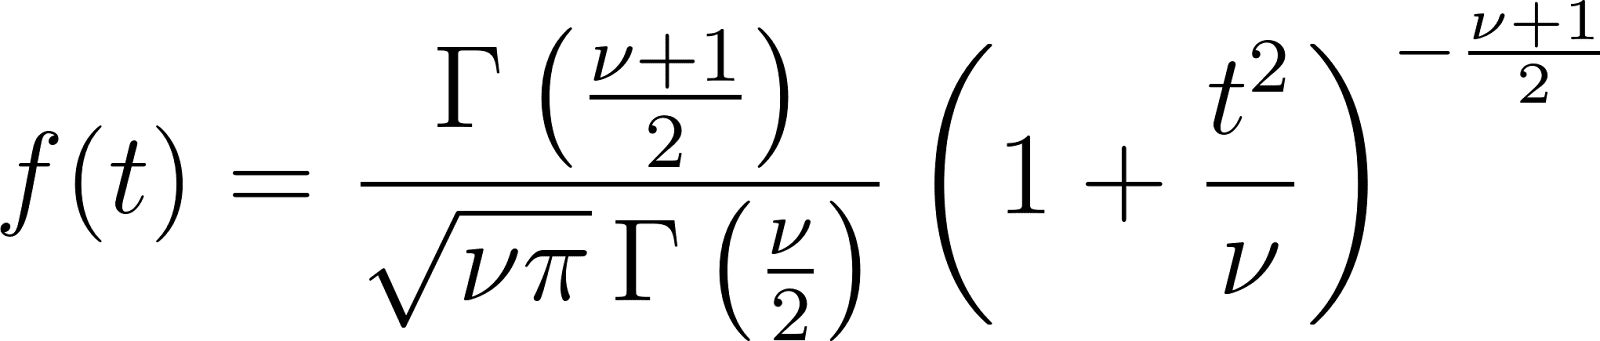
Properti kunci
- Rerata: 0 (untuk v > 1)
- Varians: v / (v - 2) (untuk v > 2)
- Skewness: 0 (distribusi simetris)
- Kurtosis: Lebih tinggi daripada distribusi normal (leptokurtik)
Simulasi
Metode Monte Carlo sering digunakan untuk mensimulasikan peubah acak yang berdistrbusi t, khususnya saat menilai signifikansi statistik atau membuat data sintetis.
Mari kita simulasikan ini menggunakan Python.
Di sini, tujuan kita adalah mensimulasikan sejumlah besar eksperimen bersampel kecil (ukuran sampel = 10), menghitung statistik t untuk masing-masing, dan membandingkan distribusi yang dihasilkan dengan distribusi t teoretis.
Untuk melakukan ini, kita harus mengikuti pendekatan berikut:
- Hasilkan banyak sampel dari distribusi normal (rerata = 0, std = 1).
- Untuk setiap sampel, hitung statistik t: (Kurangkan rerata populasi μ dari rerata sampel xˉ, lalu bagi hasilnya dengan galat baku rerata, yaitu simpangan baku sampel dibagi akar kuadrat ukuran sampel n)
- Plot histogram nilai t yang disimulasikan.
- Tumpangtindihkan distribusi t teoretis untuk perbandingan.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t

# Simulation parameters
n = 10                      # sample size
mu = 0                      # population mean
sigma = 1                   # population std deviation (not used directly)
df = n - 1                  # degrees of freedom
num_simulations = 10000     # number of Monte Carlo simulations

# Monte Carlo simulation
t_stats = []
for _ in range(num_simulations):
    sample = np.random.normal(loc=mu, scale=sigma, size=n)
    sample_mean = np.mean(sample)
    sample_std = np.std(sample, ddof=1)  # sample std dev with Bessel's correction
    t_stat = (sample_mean - mu) / (sample_std / np.sqrt(n))
    t_stats.append(t_stat)

# Plot histogram of simulated t-statistics
x = np.linspace(-5, 5, 1000)
plt.figure(figsize=(10, 6))
plt.hist(t_stats, bins=50, density=True, alpha=0.6, label='Simulated t-Statistics')

# Overlay theoretical t-distribution
plt.plot(x, t.pdf(x, df), label=f'Theoretical t-Distribution (df={df})', color='red', linewidth=2)

plt.title('Monte Carlo Simulation of t-Distribution (n=10)')
plt.xlabel('t-value')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()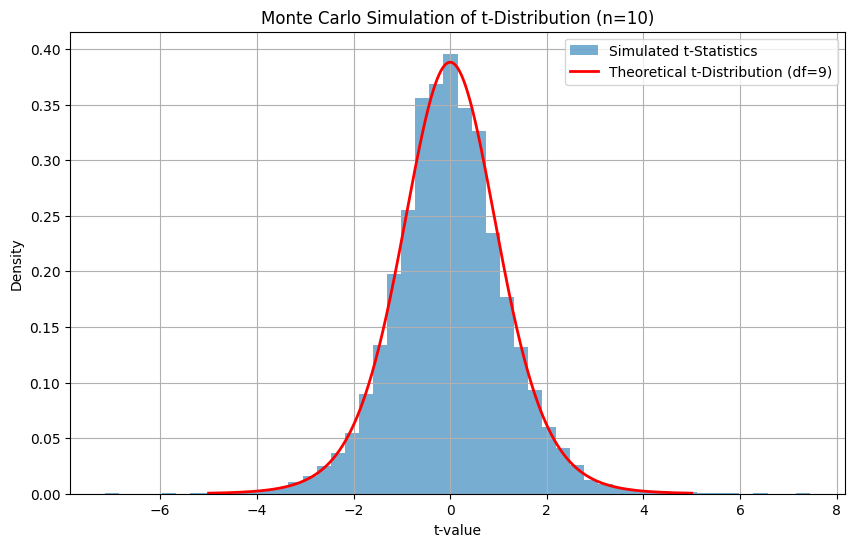
Nilai t hasil simulasi membentuk distribusi yang sangat mirip dengan distribusi t teoretis dengan df = 9. Ini adalah cara praktis untuk memahami dan memvalidasi distribusi t melalui pengambilan sampel acak. Ini juga merupakan konsep dasar di balik bootstrapping dan inferensi berbasis resampling.
Kapan Menggunakan Distribusi T
Distribusi t menjadi dasar di banyak aplikasi statistik:
- Mengestimasi rerata populasi ketika simpangan baku tidak diketahui
- Pengujian hipotesis menggunakan uji t
- Interval kepercayaan untuk sampel kecil
- Analisis regresi, di mana koefisien mengikuti distribusi t
- Inferensi Bayesian, khususnya saat parameter varians dimarginalkan
Interval kepercayaan dengan distribusi t
Interval kepercayaan untuk rerata dihitung sebagai:
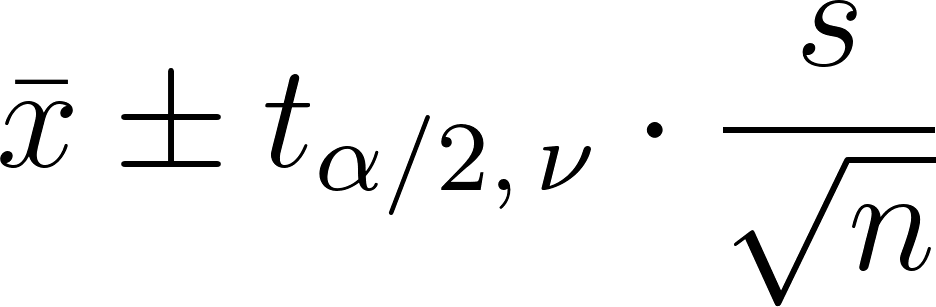
Di mana:
- x adalah rerata sampel
- s adalah simpangan baku sampel
- n adalah ukuran sampel
- Dan bagian tengah adalah nilai kritis dari distribusi t. (alpha adalah tingkat signifikansi, dan alpha dibagi dua karena uji dua ekor.)
Gunakan tabel atau kalkulator distribusi t untuk menemukan nilai kritis.
Pengujian hipotesis dengan distribusi t
Dalam uji t, statistik uji adalah:
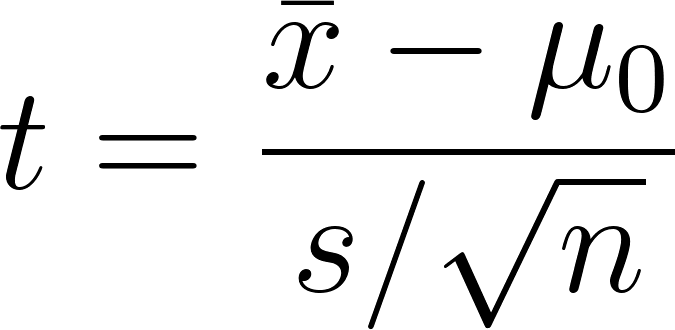
Anda membandingkannya dengan nilai t kritis untuk menerima atau menolak hipotesis nol. Uji t dapat berupa:
- Satu sampel
- Dua sampel
- Bersampel berpasangan
Ilustrasi grafis membantu memvisualisasikan wilayah kritis pada uji satu ekor dan dua ekor.
Tabel Distribusi T
Tabel distribusi t mencantumkan nilai kritis distribusi t untuk berbagai tingkat kepercayaan dan derajat kebebasan. Ini penting untuk:
- Menentukan interval kepercayaan
- Melakukan uji t
- Memverifikasi signifikansi dalam regresi
Jika bermanfaat, saya telah menyertakan versi ringkas dari tabel distribusi t yang dapat Anda rujuk di sini:
| df | 80% (1-tailed) | 90% (2-tailed) | 95% (2-tailed) | 98% (2-tailed) | 99% (2-tailed) |
|---|---|---|---|---|---|
| 1 | 3.078 | 6.314 | 12.706 | 31.821 | 63.657 |
| 2 | 1.886 | 2.920 | 4.303 | 6.965 | 9.925 |
| 5 | 1.476 | 2.015 | 2.571 | 3.365 | 4.032 |
| 10 | 1.372 | 1.812 | 2.228 | 2.764 | 3.169 |
| 20 | 1.325 | 1.725 | 2.086 | 2.528 | 2.845 |
| 30 | 1.310 | 1.697 | 2.042 | 2.457 | 2.750 |
| 60 | 1.296 | 1.671 | 2.000 | 2.390 | 2.660 |
| ∞ | 1.282 | 1.645 | 1.960 | 2.326 | 2.576 |
Kesimpulan
Saya harap artikel ini memberikan pemahaman yang kuat tentang distribusi t dan membantu menjembatani kesenjangan antara teori dan praktik. Ini adalah konsep inti dalam statistik yang berurusan dengan ketidakpastian, khususnya pada ukuran sampel kecil atau parameter populasi yang tidak diketahui.
Selain itu, distribusi t akan terus muncul saat kita mengerjakan analisis data yang lebih lanjut, seperti yang melibatkan statistik robust dan metode Bayesian. Saya merekomendasikan Anda mendaftar di jalur karier Statistician in R kami untuk benar-benar menjadi ahli.



